

[链接器的世界-原理篇02] 拆开目标文件:一份等待组装的程序
分开编译留下了一个文件格式问题:main.c 可以在没有 add.c 的情况下生成 main.o,但 main 调用 add 时需要的地址还不存在。只保存机器码不够,文件里还得记下这个名字、等待修改的位置,以及修改的方法。
这些信息也不能混成一串字节。指令需要执行权限,变量需要可写存储,符号名只供工具查询;尚未初始化的数组甚至没有必要在磁盘上存满零。目标文件因此既是编译结果,也是一份交接记录。在 Linux 的 ELF1 格式里,这份记录从汇编器开始建立。
本章从汇编指令与数据声明出发,说明 ELF 如何保存代码、数据、名称和待完成的地址计算。例子采用 ELF64 小端 x86-64;通用文件结构与架构相关编码分别讨论。
从整个文件找到一个节的内容
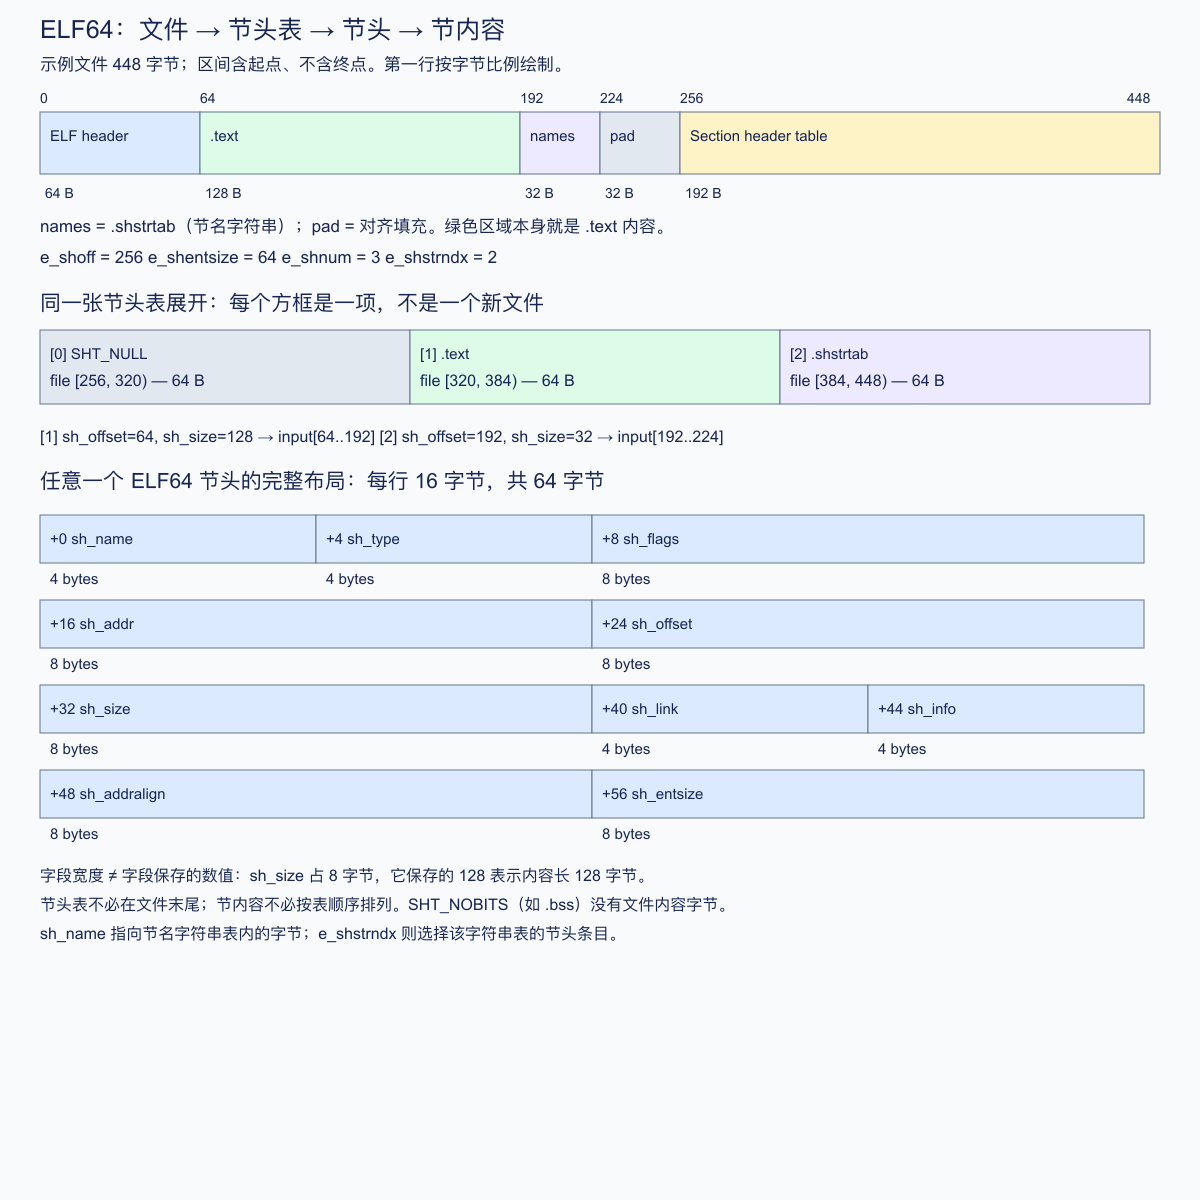
这张图的第一行是一个文件的连续字节。ELF 头中的 e_shoff 指定整张节头表的文件偏移,e_shnum 给出项数,e_shstrndx 选出描述节名字符串表的那一项。图中这三个值分别是 256、3、2;e_shentsize=64 表示每项占 64 字节。
下标 1 的节头位于 e_shoff + 1 × e_shentsize = 256 + 64 = 320,所以这项描述记录占据文件区间 [320,384)。读取其中的 sh_offset=64 和 sh_size=128,才得到 .text 内容的区间 [64,192)。sh_offset、sh_size 本身各占 8 字节;它们保存的数值描述另一区域。每个节头采用相同的 64 字节布局,第 0 项具有 SHT_NULL 的特殊语义。
节的名字不直接存在节头里。e_shstrndx 先选中描述 .shstrtab 的节头;从那个节头找到字符串内容,再用各项的 sh_name 作为字符串表内偏移查名字。这里有两种坐标:sh_offset 从文件开头算,sh_name 从字符串表开头算。
节头表不必在文件末尾,节内容也不必按节头顺序排列。SHT_NOBITS(常见于 .bss)只描述内存所需大小,没有对应的文件内容字节。这个小例子里三个节头占 192 字节,比两个节的内容之和还大,完全可能;不是所有文件都按这个比例组织。
从 C 到 .o,中间还有一份 .s
先准备两个文件。main.c 在第 1 章那个例子的基础上多了几种全局变量,里面有一个初始化过的全局变量、一个没初始化的数组、一个只读数组、一个指向字符串的指针,main 调用另一个文件里的 add:
// main.cint add(int a, int b);
int counter = 42;int zeros[64];const int table[4] = {1, 2, 3, 4};const char *msg = "hello";
int main(void) { return add(counter, table[2]) * 2;}// add.cint add(int a, int b) { return a + b;}同样是 cc -c add.c,实际步骤取决于 cc2 指向哪套工具链。这里明确使用 Clang;它的 -ccc-print-phases 能显示这次编译经过哪些阶段:
$ clang -O1 -ccc-print-phases -c add.c +- 0: input, "add.c", c +- 1: preprocessor, {0}, cpp-output +- 2: compiler, {1}, ir+- 3: backend, {2}, assembler4: assembler, {3}, object预处理展开 #include 和宏。随后,Clang 把 C 程序转换为 LLVM 的中间表示(IR3):它保留计算和控制流,供编译器分析与优化,还不是某种 CPU 最终执行的机器码。后端负责面向具体 CPU 选择指令;汇编阶段再形成目标文件。下面用 -save-temps 把各阶段的中间产物保存下来,逐一观察:
$ clang -O1 -save-temps -c add.c$ ls add.*add.bc add.c add.i add.o add.sadd.i 是预处理后的 C,add.bc 是 LLVM IR 的二进制编码,add.s 是汇编文本,add.o 是目标文件。Clang 默认使用集成汇编器时,不必先写出 .s 文件再读回来。GCC4 通常调用独立的 as5,可以通过临时汇编文件交接,也可以用 -pipe 通过管道传递。这里保存 .s 是为了观察内部交接内容,不代表每次编译都会在磁盘上经过同样的文件。
链接器读的是 .o,可 .o 里每个字节的去向,在 .s 里已经写得明明白白。打开 add.s(去掉了几行编译器注释):
.file "add.c" .text .globl add .p2align 4 .type add,@functionadd: .cfi_startproc leal (%rdi,%rsi), %eax retq.Lfunc_end0: .size add, .Lfunc_end0-add .cfi_endproc .ident "Ubuntu clang version 21.1.8 (6ubuntu1)" .section ".note.GNU-stack","",@progbits .addrsig真正的 CPU 指令只有 leal 和 retq 两行。这里用的是 AT&T 语法,目的操作数写在右边;按 x86-64 的调用约定,前两个整数参数放在 %rdi、%rsi,返回值放在 %eax,所以 leal (%rdi,%rsi), %eax 就是把两个参数相加作为返回值。其余以点号开头的行叫伪指令(directive):它们不对应任何机器指令,是写给汇编器的"摆放说明"。add: 这样以冒号结尾的是标号,给当前位置起个名字。
这几行伪指令里,.file 记下源文件名(后面会在符号表里见到它),.ident 记下编译器版本,.addrsig 让汇编器生成 LLVM 的地址显著性表,说明哪些符号的地址身份必须保留,例如地址参与比较或传出了当前翻译单元;链接器以后合并相同代码时,要尊重这些限制,.cfi_startproc、.cfi_endproc 这类 .cfi_* 伪指令描述栈展开信息,汇编器据此生成 .eh_frame 节,这是第 8 章的内容。下面重点看与"摆字节"直接相关的那些。
所以要读懂目标文件,先得知道汇编器拿到这些伪指令后做了什么。
伪指令:汇编器是怎么摆字节的
汇编器的工作模型很朴素。它手里维护着若干个"节",每个节是一块不断变长的字节缓冲区;任何时刻都有一个"当前节",以及当前节里的写入位置(叫位置计数器,在汇编里用一个点 . 表示)。遇到一条指令,就把编码后的机器码追加到当前节;遇到 .long 42 这样的数据伪指令,就追加 4 个字节;遇到标号,就记下"这个名字等于当前节的当前偏移"。最后把所有节、所有记下的名字,连同那些暂时填不了的地方,一起写进目标文件。
为了把每条伪指令都看清楚,我们自己手写一份汇编,不经过 C:
# hand.S:手写一个目标文件 .section .text,"ax",@progbits .globl add .type add,@functionadd: leal (%rdi,%rsi), %eax ret .size add, . - add
.section .data,"aw",@progbits .balign 4 .globl answer .type answer,@objectanswer: .long 42 .size answer, 4
.section .rodata,"a",@progbitsgreeting: .asciz "hi" .byte 0xff .balign 8 .uleb128 624485 .sleb128 -123456
# 宏:\name 和 \value 是参数,展开时被替换 .macro CONST name, value .globl \name\name: .long \value .endm
#ifdef BIG CONST limit, 100000#else CONST limit, 100#endif
.section .note.GNU-stack,"",@progbits文件后缀是大写的 .S,原因等讲完这些伪指令再说。先逐条看。
.section .text,"ax",@progbits 切换当前节,如果这个节还不存在就新建。它带三部分信息:节名 .text;引号里的标志字母,a 表示这个节在程序运行时要占内存(allocatable),w 表示可写,x 表示里面是可执行的代码;最后的 @progbits 是节的类型,意思是"节里有实际内容,要原样存进文件",与之相对的 @nobits 表示"只占运行时内存、文件里不存内容"。这些字母和类型的完整列表在 GNU as 手册的 .section 一页。编译器生成的 .s 里常见的 .text、.data、.bss 是这几种常用节的简写,等价于带上默认标志的 .section。
.globl add 声明 add 这个名字要对其他文件可见。不写它,add 就只在本文件内部有意义。
.type add,@function 和 .size add, . - add 给符号补充两项属性:它是函数还是数据对象,以及占多少字节。. - add 用当前位置减去 add 的位置,正好是函数长度,汇编器在走到这一行时就能算出来。CPU 不直接读取这两项元数据来执行指令;它们供链接器、调试器和动态链接器使用,后面会看到它们落在符号表的哪个字段。
.long 42 追加一个 4 字节整数,.byte 0xff 追加 1 个字节,.asciz "hi" 追加字符串并在末尾补一个 0 字节(z 就是 zero),.quad 追加 8 字节,.zero 256 追加 256 个零字节。
.balign 8 让位置计数器向上对齐到 8 的倍数,中间空出来的字节用 0 填(代码节里则填 NOP,即什么也不做的空操作指令)。编译器输出里的 .p2align 4 是同一件事的另一种写法,参数是 2 的幂次,.p2align 4 即 16 字节对齐。
.macro CONST name, value 到 .endm 定义一个宏,宏体里用反斜杠引用参数:\name、\value 在展开时被替换成调用处给出的实参。CONST limit, 100 展开后就是三行:.globl limit、limit:、.long 100。手写汇编里大量重复的模式,比如一组结构相同的函数入口、一张查找表,常用宏来写。
先记住:节负责分组,标号给出节内位置,对齐可能插入填充。示例中的 .uleb128、.sleb128 和 #ifdef 是进阶内容,放在文末一起解释;它们不是读懂下面 ELF 头的前提。
汇编器自己能填的,和只能留给链接器的
去读 .o 之前,还有一件事要弄清。伪指令一节开头描述汇编器的工作模型时,最后说它会把"那些暂时填不了的地方"一起写进目标文件。哪些地方填不了,汇编器又是怎么判断的?用一个小文件做实验:caller 调用一个 static 函数和一个普通的全局函数,再读一个全局变量。
// calls.cstatic __attribute__((noinline)) int helper(int x) { return x * 3; }__attribute__((noinline)) int pub(int x) { return x + 1; }int count;
int caller(int x) { return helper(x) + pub(x) + count;}noinline 不让编译器把两个小函数直接展开进 caller,否则就看不到调用了。编译后反汇编,-r 让 llvm-objdump 把需要链接器修补的地方标在对应指令的下面(开头的 pub 和函数之间的填充略去):
$ clang -O1 -c calls.c -o calls.o$ llvm-objdump -dr calls.o(省略)0000000000000010 <caller>: 10: 55 pushq %rbp 11: 53 pushq %rbx 12: 50 pushq %rax 13: 89 fb movl %edi, %ebx 15: e8 26 00 00 00 callq 0x40 <helper> 1a: 89 c5 movl %eax, %ebp 1c: 89 df movl %ebx, %edi 1e: e8 00 00 00 00 callq 0x23 <caller+0x13> 000000000000001f: R_X86_64_PLT32 pub-0x4 23: 01 e8 addl %ebp, %eax 25: 03 05 00 00 00 00 addl (%rip), %eax # 0x2b <caller+0x1b> 0000000000000027: R_X86_64_PC32 count-0x4(省略)0000000000000040 <helper>: 40: 8d 04 7f leal (%rdi,%rdi,2), %eax 43: c3 retq两条 callq 的待遇不一样。callq 的机器码是 e8 加 4 字节偏移,CPU 跳到"下一条指令的地址加这个偏移"。调用 helper 的那条,偏移已经填好了,是 26 00 00 00,即 0x26:下一条指令在 0x1a,0x1a + 0x26 = 0x40,正是 helper 的位置。调用 pub 的那条却是 4 个零,下面挂着一行 R_X86_64_PLT32 pub-0x4。这种"这几个字节以后按某个公式、用某个符号的地址填上"的记录叫重定位记录(relocation entry)。读 count 的 addl 也留了一条。它们在文件里怎么存,本章最后一节会拆开看;链接器按什么公式填,是第 4 章的事。
为什么要走两遍
helper 定义在 caller 后面。汇编器从上往下读到 callq helper 时还没见过这个名字,不知道它在哪,偏移无从算起。这种先使用、后定义的引用叫前向引用。传统的解法是把源文件过两遍:第一遍只算每条指令、每段数据占多少字节,把每个标号在节内的偏移记进符号表;第二遍才编码,这时本文件里所有标号的位置都已知。这就是两遍汇编器(two-pass assembler)。
x86 让第一遍也不轻松,因为同一条跳转指令有长短两种编码:
$ cat jmp100.s .text jmp .Ldone .fill 100, 1, 0x90.Ldone: ret$ clang -c jmp100.s -o jmp100.o$ llvm-objdump -d jmp100.o | grep -E 'jmp|ret' 0: eb 64 jmp 0x66 <.text+0x66> 66: c3 retq.fill 100, 1, 0x90 填入 100 个值为 0x90(NOP)的字节。跳过 100 字节,汇编器选了 2 字节的 eb 64,偏移只占 1 字节。把 100 改成 200,偏移超出了 1 字节有符号数的范围(−128 到 127),只能换成 5 字节的 e9 c8 00 00 00,ret 也从 0x66 挪到了 0xcd。麻烦在于,一条跳转选长还是选短,取决于它和目标之间隔了多少字节;这段距离里要是还有别的跳转,它们的长短又会改变这个距离。所以 GNU as 和 LLVM 的汇编器在定位置这一步会反复调整各条指令的长度,直到不再变化,再去填内容。道理仍是两遍的道理:先把位置定下来,再写字节。两个文件里的跳转目标都在本节,llvm-objdump -r 查不到任何重定位记录。
位置都知道了,为什么还要留给链接器
位置定下来以后,汇编器已经知道本文件里每个标号在哪个节、哪个偏移。pub 就在同一个 .text 里,偏移 0,为什么调用它还是留了空?
MaskRay 的 Relocation generation in assemblers 对照 GNU as 和 LLVM 的实现梳理了这个判断。汇编器解析指令时,把每个暂时算不出值的操作数记成一个 fixup(待定的修补项):它在哪个节的哪个偏移,值是一个什么表达式,比如"pub 减去当前位置"。布局确定后逐个检查,结局有三种:算出一个常数,直接写进字节;表达式本身不合法,报错;算不出,转成一条重定位记录留给链接器。对这里的 x86-64 call,指令中的位移以下一条指令的地址为基准。若目标是同一节中的局部符号,而且这段距离不会再变化,汇编器就可以直接算出位移。
第一种情形就是 helper。偏移只取决于这一个节内部的排布,链接器以后会把整个节搬到某个地址上,两头一起搬,差值不变,所以汇编器可以放心写死。
第二种情形是目标在另一个节,哪怕它是本文件的 static 函数。加上 -ffunction-sections(让每个函数单独占一个节)重新编译,helper 进了 .text.helper,调用它也留下了重定位:
$ clang -O1 -ffunction-sections -c calls.c -o calls-fs.o$ llvm-objdump -dr calls-fs.o | grep -A1 'callq' 5: e8 00 00 00 00 callq 0xa <caller+0xa> 0000000000000006: R_X86_64_PLT32 .text.helper-0x4-- e: e8 00 00 00 00 callq 0x13 <caller+0x13> 000000000000000f: R_X86_64_PLT32 pub-0x4两个节将来各放在哪里、相隔多远,要等链接器看到全部输入才能定(第 5 章)。记录里写的是节名 .text.helper 而不是 helper,这是汇编器把对局部符号的引用改写成了"节符号加偏移",讲符号表时会看到这样做的理由。
第三种情形是全局符号或弱符号,哪怕它就在同一个节。ELF 允许符号插入(interposition):同一个名字最后可能绑定到另一个文件或共享库里的定义,第 7 章细讲。汇编器若把到 pub 的偏移写死,就替链接器做了一个本该由链接器做的决定。用 GCC(它调用 GNU as)编同一个文件,结果相同:调用 helper 的偏移直接填好,调用 pub 留下 R_X86_64_PLT32 pub-0x4。
有一类表达式即使涉及全局符号也能算出:同一节里两个标号相减。hand.S 的 .size add, . - add 就是,add 是全局符号,可两头都在 .text 里,差值同样不随搬动而变,汇编器直接算出了函数长度。
对这里的地址引用而言,同一节内、绑定已确定的相对距离可以由汇编器算定;纯常量等表达式也不必等到链接。凡是牵涉到节的最终地址、牵涉到别的文件、或者名字将来可能另有归属的地方,它都写成一条重定位记录,连同符号表一起交给链接器。第 4 章的重定位计算,处理的就是这份清单。现在可以去读这个 .o 了。
看目标文件的三件工具
回到 main.c,编译出 main.o 和 add.o:
$ clang -O1 -c main.c -o main.o$ clang -O1 -c add.c -o add.o$ file main.o add.omain.o: ELF 64-bit LSB relocatable, x86-64, version 1 (SYSV), not strippedadd.o: ELF 64-bit LSB relocatable, x86-64, version 1 (SYSV), not strippedfile 的一行输出已经透露了不少:64 位、LSB(最低有效字节在前,即小端序)、relocatable(可重定位文件,也就是还要经过链接、地址尚未确定的目标文件)、x86-64。这些信息全部来自文件开头的几十个字节。
在 Linux 上查看 ELF 文件,常用三件工具。readelf 属于 GNU binutils6,只认 ELF,按格式规范把各个结构逐字段打印出来,readelf -a 会一次性打印 ELF 头、节头表、程序头表、符号表、重定位表等全部内容;按 binutils 手册的说法,它不依赖 BFD 库(上一章提过的 binutils 通用目标文件读写库),所以 BFD 有 bug 时它不受影响,适合拿来交叉核对。llvm-objdump 能处理多种格式,长处是反汇编。nm7 只列符号。LLVM 各有一个对应实现:llvm-readelf、llvm-objdump、llvm-nm。
下文主要使用 Linux 上的 llvm-objdump。它没有直接显示的字段,用 Python 按偏移解析,再与本机 GNU readelf 交叉核对。完整字段与命令已在本章逐项给出。
ELF 头:文件的前 64 个字节
先记住这张导航图:ELF 头给出节头表的位置;节头表给出每个节的类型与字节范围;.symtab 通过 .strtab 找名字,重定位节再用符号编号引用 .symtab。接下来每读一个字段,都先问它是在描述字节范围、名称,还是两张表之间的关联。
$ xxd -l 64 main.o00000000: 7f45 4c46 0201 0100 0000 0000 0000 0000 .ELF............00000010: 0100 3e00 0100 0000 0000 0000 0000 0000 ..>.............00000020: 0000 0000 0000 0000 e002 0000 0000 0000 ................00000030: 0000 0000 4000 0000 0000 4000 0f00 0100 ....@.....@.....ELF64 定义的头结构 Elf64_Ehdr 占 64 字节,完整字段见 ELF Header 规范。gABI8 规定通用文件结构;重定位、寄存器与处理器相关标志等约定由 psABI9 补充。文件的位宽与字节序先从 e_ident 读取,不能根据解析器所在机器的类型猜测。
前 16 个字节叫 e_ident,是一组与字长、字节序都无关的标识,读文件的程序先看它,才知道后面该怎么读:
7f 45 4c 46:魔数(magic number,文件格式约定写在开头的固定字节,读文件的程序靠它快速认出格式),即 0x7f 后跟 ASCII 的ELF。02:EI_CLASS,2 表示 64 位(ELFCLASS64),1 是 32 位。01:EI_DATA,1 表示小端(ELFDATA2LSB)。01:EI_VERSION,ELF 版本,至今只有 1。00:EI_OSABI,0 表示没有特定操作系统扩展(System V)。00:EI_ABIVERSION,上一项所指 ABI 的版本号,这里为 0。其余 7 个字节是填充。
下面列出全部 64 字节。偏移相对于文件开头;“宽度”是字段自身占用的字节数,“值”是解码后的数。该文件的 EI_DATA=1,因此多字节字段按小端读取。
| 偏移:十进制/十六进制 | 宽度 | 字段 | 示例值 | 含义 |
|---|---|---|---|---|
| 0/0x00 | 4 | EI_MAG0..EI_MAG3 | 7f 45 4c 46 | ELF 标识 |
| 4/0x04 | 1 | EI_CLASS | 2 | ELF64 格式 |
| 5/0x05 | 1 | EI_DATA | 1 | 小端编码 |
| 6/0x06 | 1 | EI_VERSION | 1 | 标识数组中的格式版本 |
| 7/0x07 | 1 | EI_OSABI | 0 | OS/ABI 扩展标识 |
| 8/0x08 | 1 | EI_ABIVERSION | 0 | 上一项所指定 ABI 的版本 |
| 9/0x09 | 7 | EI_PAD 起的保留区域 | 全 0 | 保留字节 |
| 16/0x10 | 2 | e_type | 1 | ET_REL,可重定位文件 |
| 18/0x12 | 2 | e_machine | 62 | EM_X86_64,目标架构 |
| 20/0x14 | 4 | e_version | 1 | 头结构中的格式版本 |
| 24/0x18 | 8 | e_entry | 0 | 入口虚拟地址;无入口时为 0 |
| 32/0x20 | 8 | e_phoff | 0 | 程序头表的文件偏移;无表时为 0 |
| 40/0x28 | 8 | e_shoff | 736 | 节头表的文件偏移 |
| 48/0x30 | 4 | e_flags | 0 | 处理器相关标志 |
| 52/0x34 | 2 | e_ehsize | 64 | ELF 头自身的字节数 |
| 54/0x36 | 2 | e_phentsize | 0 | 每个程序头的字节数 |
| 56/0x38 | 2 | e_phnum | 0 | 程序头的项数 |
| 58/0x3a | 2 | e_shentsize | 64 | 每个节头的字节数 |
| 60/0x3c | 2 | e_shnum | 15 | 节头表的项数 |
| 62/0x3e | 2 | e_shstrndx | 1 | 节名字符串表的节头下标 |
两个版本字段不能互相代替:偏移 6 的 EI_VERSION 占 1 字节,偏移 20 的 e_version 占 4 字节;这里均为 EV_CURRENT=1。同样,e_ehsize=64 描述整个文件头,e_shentsize=64 描述一个节头,二者数值相等但对象不同。节头下标从 0 开始,因此普通编号中合法下标必须小于 e_shnum。
普通节头数量必须小于 SHN_LORESERVE=0xff00。数量达到这个阈值时,e_shnum 改存 0,真实数量放在第 0 项的 sh_size;不是把大数量直接塞进这个 16 位字段。节名表下标达到同一阈值时,e_shstrndx 改存 SHN_XINDEX=0xffff,真实下标放在第 0 项的 sh_link。gABI 的 ELF 头定义规定了这两种扩展表示。
ELF 还允许无节头表、无节名字符串表和扩展编号。e_shnum=0 可能表示无表,也可能需要从第 0 项的 sh_size 读取真实项数;e_shstrndx=SHN_XINDEX 时,真实下标来自第 0 项的 sh_link。这些是格式中的编码方式,解析器可以明确只支持其中一部分,但不应把不支持的情形说成格式本身非法。
e_type 的另外两个常见取值是 2 ET_EXEC 和 3 ET_DYN;共享库和 PIE10 可执行文件使用后者。表位置、表项数量与表中所描述的内容,始终是不同概念。
可以算一笔账:节头表从 736 开始,15 项,每项 64 字节,到 736 + 15 × 64 = 1696 结束。
$ wc -c main.o1696 main.o文件恰好 1696 字节,节头表是这个文件的最后一块。llvm-objdump -f 打印的就是这个头的摘要:
$ llvm-objdump -f main.o
main.o: file format elf64-x86-64architecture: x86_64start address: 0x0000000000000000从字段值到可读取的区间
知道表的位置,不等于已经证明那里的字节存在。将文件看作长度为 L 的字节序列,区域采用半开区间 [offset, end):包含 offset,不包含 end,长度为 end − offset。从偏移 o 读取 s 字节,需要先计算 end = o + s,再证明 end ≤ L。长度非负且加法不溢出时,这也保证起点不超过文件尾。空区间 [L,L) 合法;[L+1,L+1) 虽然没有内容,却不在文件范围内。
节头表的长度是 项数 × 每项宽度,不是项数本身。本例 15 × 64 = 960 字节;从偏移 736 开始,区间为 [736,1696)。只检查 736 + 15 ≤ L,最多证明开头 15 个字节存在,无法证明 15 个节头存在。
定位下标 i 的节头要证明两件独立的事:
i < e_shnum:它属于这张表。即使后面还有文件字节,下标越界也不能借用下一块内容冒充表项。[e_shoff + i × e_shentsize, e_shoff + (i+1) × e_shentsize)完整落在文件内:即使下标合法,输入也可能被截断。
如果调用者另传了一份较短输入,或者自行构造了表位置,先前对其他字节序列做过的检查不能替代当前检查。每一步算术都应在能够表达文件坐标的整数类型中完成。e_shnum 和普通下标的字段各占 2 字节,但这不表示乘法也应使用 16 位整数:1024 × 64 = 65536 在 u16 中不能表达,转成更宽类型后再乘才不会把合法数量误判为溢出。
算术溢出与文件越界也不是同一件事。假设偏移为 u64::MAX − 63,表长为 128:它的数学终点超过 u64::MAX,应在加法处识别为不可表达的区间。偏移为 160、长度为 64、文件长为 192 时,终点 224 可正常表达,只是超出文件尾。先将巨大文件偏移强制转为宿主 usize,可能在较窄机器上截断高位,把原本无效的位置变成一个看似可读的小下标;应先证明范围,再进行有检查的转换。
这些检查只建立读取边界,不证明记录含义正确。节名下标、符号表关联和重定位所属节仍需分别验证;下文继续解释这些关系。
ELF 头里给了两张表的位置:节头表(section header table)和程序头表(program header table)。main.o 的节头表有 15 项,程序头表却是空的,e_phoff 和 e_phnum 都是 0。用 llvm-objdump -p 打印程序头,确实什么也没有:
$ llvm-objdump -p main.o
main.o: file format elf64-x86-64
Program Header:
Dynamic Section:这个目标文件还没有供加载器使用的程序头表。沿着已有的节头表,先能找出代码、数据和它们的交接记录;等这些输入都看清楚,再对照链接后的文件看另一张表的作用。
llvm-objdump -h 打印节头表,这里所有节的 VMA(虚拟内存地址)一栏都是 0,正是"还没有地址"的直观体现:
$ llvm-objdump -h main.o
main.o: file format elf64-x86-64
Sections:Idx Name Size VMA Type 0 00000000 0000000000000000 1 .strtab 000000a1 0000000000000000 2 .text 00000015 0000000000000000 TEXT 3 .rela.text 00000030 0000000000000000 4 .data 00000010 0000000000000000 DATA 5 .rela.data 00000018 0000000000000000 6 .rodata 00000010 0000000000000000 DATA 7 .rodata.str1.1 00000006 0000000000000000 DATA 8 .bss 00000100 0000000000000000 BSS 9 .comment 00000028 0000000000000000 10 .note.GNU-stack 00000000 0000000000000000 11 .eh_frame 00000030 0000000000000000 DATA 12 .rela.eh_frame 00000018 0000000000000000 13 .llvm_addrsig 00000000 0000000000000000 14 .symtab 000000f0 0000000000000000一个只有十行的 main.c 生成了 15 个节。这张表只给了名字、大小和粗略的类别,节头里更重要的类型、标志、文件偏移都没显示。readelf -S 会显示它们,这里用自己写的脚本来读,顺便看清每个字段在结构体里的位置。
节头表:每个节的类型、标志和位置
每个节头采用 Elf64_Shdr 的 64 字节布局。下面的偏移相对于该节头起点,和上一张表的文件偏移不同。
| 节头内偏移:十进制/十六进制 | 宽度 | 字段 | 作用 |
|---|---|---|---|
| 0/0x00 | 4 | sh_name | 节名字符串表内的字节偏移 |
| 4/0x04 | 4 | sh_type | 节类型 |
| 8/0x08 | 8 | sh_flags | 节属性位 |
| 16/0x10 | 8 | sh_addr | 内存地址;可重定位输入通常尚未分配 |
| 24/0x18 | 8 | sh_offset | 内容相对于文件开头的位置 |
| 32/0x20 | 8 | sh_size | 内容字节数;NOBITS 描述所需内存大小 |
| 40/0x28 | 4 | sh_link | 与另一节的关联,含义由节类型规定 |
| 44/0x2c | 4 | sh_info | 附加信息,含义由节类型规定 |
| 48/0x30 | 8 | sh_addralign | 地址对齐要求;0、1 不要求额外对齐 |
| 56/0x38 | 8 | sh_entsize | 定长记录节中每条记录的字节数 |
读取第 i 项的路径是:先计算 e_shoff + i × e_shentsize,取得描述记录,再依据其 sh_offset 和 sh_size 定位内容。对于 NOBITS,只得到内存需求,不能把 sh_size 个字节从文件里取出来。对于符号表和重定位表,还要根据 sh_link 等关联找到另一张表;下面将分别说明。
这段 Python 用于解释已知有效的 ELF64 小端输入,不是任意文件的安全解析器。它未完整验证表范围、扩展编号、字符串终止与关联下标。通用解析器需要先验证这些条件,才能执行同样的查找:
import struct, sys
data = open(sys.argv[1], "rb").read()# ELF64 头:e_shoff 在偏移 0x28,e_shentsize/e_shnum/e_shstrndx 在 0x3a 起shoff = struct.unpack_from("<Q", data, 0x28)[0]shentsize, shnum, shstrndx = struct.unpack_from("<HHH", data, 0x3a)
TYPES = {0: "NULL", 1: "PROGBITS", 2: "SYMTAB", 3: "STRTAB", 4: "RELA", 8: "NOBITS", 0x70000001: "X86_64_UNWIND", 0x6fff4c03: "LLVM_ADDRSIG"}FLAGS = [(0x1, "W"), (0x2, "A"), (0x4, "X"), (0x10, "M"), (0x20, "S"), (0x40, "I")]
def shdr(i): # sh_name, sh_type, sh_flags, sh_addr, sh_offset, sh_size, # sh_link, sh_info, sh_addralign, sh_entsize return struct.unpack_from("<IIQQQQIIQQ", data, shoff + i * shentsize)
names_off = shdr(shstrndx)[4]def name(off): end = data.index(b"\0", names_off + off) return data[names_off + off:end].decode()
print("Nr Name Type Flg Off Size Lk Inf Al ES")for i in range(shnum): n, t, f, _, off, size, link, info, align, es = shdr(i) flg = "".join(c for bit, c in FLAGS if f & bit) print(f"{i:2} {name(n):16} {TYPES.get(t, hex(t)):13} {flg:3} " f"{off:06x} {size:06x} {link:2} {info:3} {align:2} {es:2}")"<IIQQQQIIQQ" 里的 < 表示小端,I 是 4 字节无符号整数,Q 是 8 字节,正好对应结构体的十个字段。运行结果:
$ python3 shdr.py main.oNr Name Type Flg Off Size Lk Inf Al ES 0 NULL 000000 000000 0 0 0 0 1 .strtab STRTAB 000238 0000a1 0 0 1 0 2 .text PROGBITS AX 000040 000015 0 0 16 0 3 .rela.text RELA I 0001d8 000030 14 2 8 24 4 .data PROGBITS WA 000058 000010 0 0 8 0 5 .rela.data RELA I 000208 000018 14 4 8 24 6 .rodata PROGBITS A 000070 000010 0 0 16 0 7 .rodata.str1.1 PROGBITS AMS 000080 000006 0 0 1 1 8 .bss NOBITS WA 000090 000100 0 0 16 0 9 .comment PROGBITS MS 000090 000028 0 0 1 110 .note.GNU-stack PROGBITS 0000b8 000000 0 0 1 011 .eh_frame X86_64_UNWIND A 0000b8 000030 0 0 8 012 .rela.eh_frame RELA I 000220 000018 14 11 8 2413 .llvm_addrsig LLVM_ADDRSIG 000238 000000 14 0 1 014 .symtab SYMTAB 0000e8 0000f0 1 4 8 24先看类型。PROGBITS 就是汇编里写的 @progbits:内容由程序定义,原样存在文件里。NOBITS 对应 @nobits,只有 .bss 一个。SYMTAB 是符号表,STRTAB 是字符串表,RELA 是重定位表。X86_64_UNWIND(值 0x70000001)落在 gABI 留给处理器自定义的区间里,由 x86-64 psABI9 规定用于 .eh_frame 这类栈展开信息。LLVM_ADDRSIG 是 LLVM 自己的扩展(记录哪些符号被取过地址,供链接器做相同代码折叠(ICF11,把内容完全相同的函数只保留一份)时参考,这是第 12 章的话题),GNU 工具链生成的文件里没有它。
再看标志位,它们和汇编里引号里的字母一一对应:
SHF_WRITE(0x1,脚本里记作 W):运行时可写,对应"w"。SHF_ALLOC(0x2,A):运行时要占内存,对应"a"。SHF_EXECINSTR(0x4,X):包含可执行的机器指令,对应"x"。SHF_MERGE(0x10,M)和SHF_STRINGS(0x20,S):内容可以和别处相同的内容合并,S 进一步说明内容是以 0 结尾的字符串,对应"M"和"S"。SHF_INFO_LINK(0x40,I):sh_info字段存的是另一个节的编号。
于是 .text 是 AX(占内存、可执行,不可写),.data 和 .bss 是 WA,.rodata 只有 A。将来链接器归拢段时,依据的就是这些标志:A 决定一个节进不进内存,W 和 X 决定它该放进什么权限的段。没有 A 的节,比如 .symtab、.strtab、.comment、各个 .rela.*,运行时根本不会被映射,它们只给链接器、调试器这类工具读。
.bss 一行很能说明 NOBITS 的意思。它的大小是 0x100,也就是 zeros 数组的 256 字节,可文件偏移 0x90 和下一个节 .comment 完全相同:这 256 字节的存储需求记录在节头中,不占用文件中的内容字节。
这个目标文件先交给链接器。链接器为 .bss 分配输出存储,并在可执行文件的程序头中描述相应的内存范围;加载器依据程序头建立映射,将加载段中超出文件内容的尾部置零。它不需要逐个读取输入文件的 .bss 节头。这样,零初始化存储既能在运行时存在,又不必在文件中保存一串零。(这里 Clang 和 GCC 的 -fno-common 行为使 zeros 这样的暂定定义直接属于 .bss;另一种表示方式 COMMON 符号见第 3 章。)
sh_link 和 sh_info 把节和节连了起来。.rela.text 的 Lk 是 14、Inf 是 2:它里面的重定位记录引用的符号在第 14 节 .symtab 里,要修补的是第 2 节 .text。.rela.data 的 Inf 是 4,修补 .data;.rela.eh_frame 的 Inf 是 11,修补 .eh_frame。命名上也有约定,.rela 加被修补的节名。.symtab 的 Lk 是 1,表示符号名字存在第 1 节 .strtab 里;它的 Inf 是 4,下面讲符号表时再解释。Al 是对齐要求,.text 要 16 字节对齐,来自汇编里的 .p2align 4;ES 是条目大小,符号表和重定位表都是每条 24 字节。
本例第 0 项是全零的空节头。gABI 将它的节类型保留为 SHT_NULL,这样"节编号为 0"就可以用来表示"不属于任何节",后面在符号表里会用到。第 0 项并非在所有 ELF 文件里都全零:节数或索引超过普通字段的容量时,它还承担扩展编号的存储。这个例子不需要扩展编号。另外,ELF 头的 e_shstrndx 指向第 1 节 .strtab,也就是说这个文件里节名和符号名共用一张字符串表,这是 LLVM 的做法;GNU as 生成的目标文件通常会单独有一个 .shstrtab 专门存节名。规范只要求 e_shstrndx 指向一个字符串表,两种做法都合法。
字符串表本身很简单,就是一串以 0 结尾的字符串首尾相连,别处用"从第几个字节开始"来引用其中一个名字:
$ llvm-objdump -s -j .strtab main.o
main.o: file format elf64-x86-64Contents of section .strtab: 0000 002e7265 6c612e74 65787400 2e636f6d ..rela.text..com 0010 6d656e74 002e6273 73007a65 726f7300 ment..bss.zeros. 0020 636f756e 74657200 6d61696e 002e6e6f counter.main..no 0030 74652e47 4e552d73 7461636b 006d7367 te.GNU-stack.msg 0040 002e6c6c 766d5f61 64647273 6967002e ..llvm_addrsig.. 0050 72656c61 2e65685f 6672616d 65007461 rela.eh_frame.ta 0060 626c6500 61646400 6d61696e 2e63002e ble.add.main.c.. 0070 73747274 6162002e 73796d74 6162002e strtab..symtab.. 0080 726f6461 7461002e 72656c61 2e646174 rodata..rela.dat 0090 61002e72 6f646174 612e7374 72312e31 a..rodata.str1.1 00a0 00 .偏移 0 是一个空字符串,偏移 0x20 是 counter,0x28 是 main,0x64 是 add,0x68 是 main.c。仔细看还会发现 .text 并不单独出现,它藏在 .rela.text 的尾巴里:引用 .text 只要指向偏移 6 即可。汇编器在生成字符串表时做了后缀共享,.rela.data 和 .data 同理。
各个节里装了什么
有了节头表里的偏移和大小,就可以逐个看内容了。对照着 main.s 看最清楚,每一段伪指令都能在某个节里找到它摆下的字节。用 clang -O1 -S main.c 生成它,数据部分如下(去掉了行尾注释和空行):
.type counter,@object .data .globl counter .p2align 2, 0x0counter: .long 42 .size counter, 4 .type table,@object .section .rodata,"a",@progbits .globl table .p2align 4, 0x0table: .long 1 .long 2 .long 3 .long 4 .size table, 16 .type .L.str,@object .section .rodata.str1.1,"aMS",@progbits,1.L.str: .asciz "hello" .size .L.str, 6 .type msg,@object .data .globl msg .p2align 3, 0x0msg: .quad .L.str .size msg, 8 .type zeros,@object .bss .globl zeros .p2align 4, 0x0zeros: .zero 256 .size zeros, 256注意 .data 出现了两次:汇编器先把 counter 写进 .data,切到别的节写完 table 和字符串后,再切回 .data 接着往后写 msg。同名的节只有一个,切回来就是继续追加。
.text 是代码。llvm-objdump -d 把它反汇编出来:
$ llvm-objdump -d main.o
main.o: file format elf64-x86-64
Disassembly of section .text:
0000000000000000 <main>: 0: 50 pushq %rax 1: 8b 3d 00 00 00 00 movl (%rip), %edi # 0x7 <main+0x7> 7: be 03 00 00 00 movl $0x3, %esi c: e8 00 00 00 00 callq 0x11 <main+0x11> 11: 01 c0 addl %eax, %eax 13: 59 popq %rcx 14: c3 retq一共 0x15 字节,和节头里的大小一致。第二个参数 table[2] 已经变成了立即数 3(直接编码在指令里的常量):table 是 const,值在编译期已知,编译器直接折叠掉了这次读内存。开头的 pushq %rax 和结尾的 popq %rcx 并没有保存什么有用的值,作用是让调用 add 时栈指针保持 16 字节对齐,这是 x86-64 psABI 对函数调用的要求。movl (%rip), %edi 用的是 RIP 相对寻址:以下一条指令的地址为基准,加上指令里编码的 32 位偏移,得到要读的内存地址。另外两条指令要多看一眼:读 counter 的 movl 和调用 add 的 callq,后面都跟着 4 个零字节。这一点留到本章最后。
.data 是有初始值、可写的全局变量:
$ llvm-objdump -s -j .data main.o
main.o: file format elf64-x86-64Contents of section .data: 0000 2a000000 00000000 00000000 00000000 *...............偏移 0 是 counter,2a 00 00 00 按小端序读就是 42。接着 4 字节是 .p2align 3 补的对齐填充。偏移 8 是 msg,它是一个 8 字节指针,应该存字符串 "hello" 的地址,可这里是 8 个 0。又是零字节,和 .text 里的情况一样,原因也一样:字符串最终放在哪里,现在还不知道。
.rodata 是只读数据,装着 table 的四个整数 01000000 02000000 03000000 04000000。字符串 "hello" 则单独放进了 .rodata.str1.1。回头看 main.s,编译器为它写的是 .section .rodata.str1.1,"aMS",@progbits,1:M 和 S 表示这是可合并的字符串,最后的 1 是条目大小(每个字符 1 字节),节名里的 str1.1 也是这个意思。这样做是为了让链接器把所有输入文件里相同的字符串只留一份,具体怎么合并是第 5 章的话题。
.bss 就是前面说的不占文件空间的那 256 字节,llvm-objdump -s 遇到它会直接跳过:
$ llvm-objdump -s -j .bss main.o(省略文件头)Contents of section .bss:<skipping contents of bss section at [0000, 0100)>.comment 是编译器写进去的版本字符串,来自 .s 里的 .ident 伪指令,没有 A 标志,不会被加载,链接器通常把所有输入的 .comment 合并去重后保留在输出里,于是用 readelf -p .comment 可以查到一个可执行文件是哪些编译器编出来的:
$ llvm-objdump -s -j .comment main.o
main.o: file format elf64-x86-64Contents of section .comment: 0000 00556275 6e747520 636c616e 67207665 .Ubuntu clang ve 0010 7273696f 6e203231 2e312e38 20283675 rsion 21.1.8 (6u 0020 62756e74 75312900 buntu1)..note.GNU-stack 大小为 0,标志为空。上一章讲过它:一个空节,只靠"存在、并且没有 x 标志"来声明这个文件不需要可执行栈。编译器生成的 .s 末尾总会带上它;手写汇编需要作者自己记得写,hand.S 的最后一行就是。
.eh_frame 存放栈展开信息,告诉运行时如何从任意一条指令所在的函数退回到调用者,它来自 .s 里那些 .cfi_* 伪指令。它的字节布局是第 8 章的主题,这里只需要注意它也有一个配套的 .rela.eh_frame。
剩下 .symtab 和三个 .rela.*。前者回答"文件里有哪些名字",后者回答"哪些字节要等名字有了地址再填"。先看符号表。
符号表:一个符号表项的 24 字节
$ llvm-objdump -t main.o
main.o: file format elf64-x86-64
SYMBOL TABLE:0000000000000000 l df *ABS* 0000000000000000 main.c0000000000000000 l d .text 0000000000000000 .text0000000000000000 l d .rodata.str1.1 0000000000000000 .rodata.str1.10000000000000000 g F .text 0000000000000015 main0000000000000000 g O .data 0000000000000004 counter0000000000000000 *UND* 0000000000000000 add0000000000000000 g O .rodata 0000000000000010 table0000000000000008 g O .data 0000000000000008 msg0000000000000000 g O .bss 0000000000000100 zerosllvm-objdump -t 每行依次是:值、一组标志字符、所在节、大小、名字。在文件里,每个符号是一个 24 字节的 Elf64_Sym(gABI 第 4 章 Symbol Table):
typedef struct { Elf64_Word st_name; /* 4 字节:名字在 .strtab 中的偏移 */ unsigned char st_info; /* 1 字节:高 4 位是绑定,低 4 位是类型 */ unsigned char st_other; /* 1 字节:可见性(第 3 章) */ Elf64_Half st_shndx; /* 2 字节:所属节的编号 */ Elf64_Addr st_value; /* 8 字节:值,在目标文件里是节内偏移 */ Elf64_Xword st_size; /* 8 字节:大小 */} Elf64_Sym;.symtab 的大小是 0xf0 = 240 字节,正好 10 个符号,比 llvm-objdump 列出的多一个,因为第 0 项和节头表一样是保留的全零项。把原始字节打印出来,挑几项手工解码:
$ llvm-objdump -s -j .symtab main.o
main.o: file format elf64-x86-64Contents of section .symtab: 0000 00000000 00000000 00000000 00000000 ................ 0010 00000000 00000000 68000000 0400f1ff ........h....... 0020 00000000 00000000 00000000 00000000 ................ 0030 00000000 03000200 00000000 00000000 ................ 0040 00000000 00000000 00000000 03000700 ................ (中间省略) 0060 28000000 12000200 00000000 00000000 (............... 0070 15000000 00000000 20000000 11000400 ........ ....... 0080 00000000 00000000 04000000 00000000 ................ 0090 64000000 10000000 00000000 00000000 d............... 00a0 00000000 00000000 5e000000 11000600 ........^....... (后面省略)第 4 项从偏移 0x60 开始:st_name 是 0x28,在上面的字符串表里查到 main;st_info 是 0x12;st_other 是 0;st_shndx 是 2,即 .text;st_value 是 0,main 从 .text 的开头开始;st_size 是 0x15,就是汇编里 .size main, .Lfunc_end0-main 算出来的那个数。
st_info 的 0x12 拆成两半:高 4 位 1 是绑定(binding)STB_GLOBAL,低 4 位 2 是类型 STT_FUNC。llvm-objdump 里的 g 和 F 就是这两个字段。
绑定回答"这个名字在多大范围内有效"。STB_LOCAL(0,显示为 l)只在本文件内有效,两个文件里各有一个同名的局部符号,互不相干;STB_GLOBAL(1,g)对所有参与链接的文件可见,链接器要用它把引用和定义配对;STB_WEAK(2,w)也是全局可见,但按 gABI 的说法 "their definitions have lower precedence",优先级低于普通全局定义。main.c 里恰好没有局部变量和弱符号,换一个例子:
// bind.cstatic int hits; /* 只在本文件可见 */__attribute__((weak)) int hook(void) { /* 弱定义:别人可以覆盖 */ return 0;}extern int maybe(void) __attribute__((weak)); /* 弱引用 */
int poke(void) { hits++; return hook() + (maybe ? maybe() : 0) + hits;}$ clang -O1 -c bind.c -o bind.o$ llvm-objdump -t bind.o
bind.o: file format elf64-x86-64
SYMBOL TABLE:0000000000000000 l df *ABS* 0000000000000000 bind.c0000000000000000 l d .text 0000000000000000 .text0000000000000000 l O .bss 0000000000000004 hits0000000000000000 l d .bss 0000000000000000 .bss0000000000000000 w F .text 0000000000000003 hook0000000000000010 g F .text 000000000000002b poke0000000000000000 w *UND* 0000000000000000 maybeC 的 static 变成了 l,__attribute__((weak)) 的定义和引用都变成了 w。在汇编层面,它们分别对应"不写 .globl"和 .weak 伪指令:编译器为 bind.c 生成的 .s 里,hook 前面写的是 .weak hook,而不是 .globl hook。回头看 hand.S 生成的符号表,没写 .globl 的 greeting 也是 l:
$ llvm-objdump -t hand-small.o
hand-small.o: file format elf64-x86-64
SYMBOL TABLE:0000000000000000 l .rodata 0000000000000000 greeting0000000000000000 g F .text 0000000000000004 add0000000000000000 g O .data 0000000000000004 answer000000000000000e g .rodata 0000000000000000 limit一个弱定义和一个普通定义同时出现时谁赢、一个弱引用最终找不到定义时会怎样,这些规则是第 3 章的内容。这里只要记住绑定这个字段的存在,它是链接器做配对时首先要看的东西。
类型回答"这个名字指的是什么"。STT_FUNC(F)是函数,STT_OBJECT(O)是数据对象,都来自 .type 伪指令。hand.S 里的 greeting 和 limit 没有写 .type,类型就是 STT_NOTYPE,标志栏那一位是空的;大小也是 0,因为没有写 .size。这样的符号照样能被链接,只是调试器和 perf(Linux 的性能分析工具)这类工具从地址反查函数名时,没有大小信息就只能猜一个函数到哪里结束。
另外两种类型由汇编器自动生成。STT_FILE(df 里的 f)记录源文件名,就是第 1 项的 main.c。它的 st_info 是 0x04(LOCAL、FILE),st_shndx 是 0xfff1:这是一个保留的特殊编号 SHN_ABS,表示这个符号不属于任何节,值是绝对的,不随节的搬动而改变,llvm-objdump 显示为 *ABS*。STT_SECTION 代表一个节本身,值为 0。它的 st_name 其实是 0,也就是没有名字:上面原始字节里偏移 0x30 开始的第 2 项是 00000000 03000200,名字偏移 0,st_info 为 0x03(LOCAL、SECTION),所属节为 2;llvm-objdump 显示的 .text 是从所属节借来的节名。llvm-objdump 标志栏里的 d 表示"调试类符号",文件符号和节符号都算在内,所以文件符号显示为 df,节符号显示为 d。gABI 说这类符号 "exist primarily for relocation",主要给重定位用。为什么需要它?看 bind.o 的重定位就明白了:
$ llvm-objdump -dr bind.o(省略)0000000000000010 <poke>: 10: 53 pushq %rbx 11: ff 05 00 00 00 00 incl (%rip) # 0x17 <poke+0x7> 0000000000000013: R_X86_64_PC32 .bss-0x4(后面省略)hits++ 要修改 hits,可重定位记录引用的是 .bss 而不是 hits。局部符号对外不可见,链接器没有必要按名字找它,只要知道".bss 节开头往后多少字节"就够了。于是汇编器通常改用节符号加偏移来表达对局部数据的引用。main.o 里的 .rodata.str1.1 节符号也是这个用途:字符串 "hello" 的标号 .L.str 以 .L 开头,是汇编器的"私有标号",一般连符号表都不进(练习一会遇到例外),对它的引用只能借助节符号。
最后是 add 那一行,所属节写着 *UND*。偏移 0x90 处是它的原始字节:st_name 0x64 在字符串表里是 add,st_info 0x10 即 GLOBAL、NOTYPE,st_shndx 是 0。前面说过节编号 0 是保留的,它在这里的名字叫 SHN_UNDEF:这个文件引用了 add,但没有定义它。值和大小都是 0,这个未定义表项没有提供它的位置和尺寸。NOTYPE 表示符号表未指定类别,不表示 C 编译器不知道声明的是函数。用 nm 看会更直观,普通已定义符号通常以大写表示全局、小写表示局部(弱符号等另有约定),T、D、R、B 分别是在代码、数据、只读数据、bss 里定义,U 是未定义:
$ nm main.o U add0000000000000000 D counter0000000000000000 T main0000000000000008 D msg0000000000000000 R table0000000000000000 B zeros再看 add.o,add 在那里是一个有节、有大小的全局函数:
$ llvm-objdump -t add.o
add.o: file format elf64-x86-64
SYMBOL TABLE:0000000000000000 l df *ABS* 0000000000000000 add.c0000000000000000 l d .text 0000000000000000 .text0000000000000000 g F .text 0000000000000004 addllvm-objdump 的输出里,所有 l 都排在 g 和 w 前面。这是文件本身的规定,gABI 要求 "all symbols with STB_LOCAL binding precede the weak and global symbols",并且符号表节头的 sh_info 存放第一个非局部符号的编号。main.o 的 .symtab 的 Inf 是 4,正是 main 的编号(0 号保留,1 到 3 是局部符号)。链接器做符号配对时只关心全局和弱符号,有了这个编号,它可以直接跳过前面所有局部符号。
那些零字节:重定位表
现在回到 .text 和 .data 里那几处零。给 llvm-objdump -d 加上 -r,每条重定位记录会紧跟在它要修补的指令下面:
$ llvm-objdump -dr main.o(省略文件头)0000000000000000 <main>: 0: 50 pushq %rax 1: 8b 3d 00 00 00 00 movl (%rip), %edi # 0x7 <main+0x7> 0000000000000003: R_X86_64_PC32 counter-0x4 7: be 03 00 00 00 movl $0x3, %esi c: e8 00 00 00 00 callq 0x11 <main+0x11> 000000000000000d: R_X86_64_PLT32 add-0x4 11: 01 c0 addl %eax, %eax 13: 59 popq %rcx 14: c3 retqcallq 的机器码是 e8 加一个 4 字节的有符号偏移,CPU 执行时跳到"下一条指令地址加这个偏移"。编译 main.c 时,汇编器不知道 add 会落在哪里,于是先写 4 个零占位,再在 .rela.text 里留一条记录:.text 偏移 0xd 处的 4 个字节,将来用 add 的地址、加数 -4 和这个位置本身的地址,按 R_X86_64_PLT32 规定的公式算出一个值填上。读 counter 的 movl 同理,修补位置是偏移 3。llvm-objdump -r 能单独列出全部重定位记录:
$ llvm-objdump -r main.o
main.o: file format elf64-x86-64
RELOCATION RECORDS FOR [.text]:OFFSET TYPE VALUE0000000000000003 R_X86_64_PC32 counter-0x4000000000000000d R_X86_64_PLT32 add-0x4
RELOCATION RECORDS FOR [.data]:OFFSET TYPE VALUE0000000000000008 R_X86_64_64 .rodata.str1.1
RELOCATION RECORDS FOR [.eh_frame]:OFFSET TYPE VALUE0000000000000020 R_X86_64_PC32 .text.data 偏移 8 的那 8 个零就是 msg,它将被填上 .rodata.str1.1 节的绝对地址,"hello" 正好在那个节的开头。.eh_frame 里也有一处需要指向 .text。
重定位记录在文件里同样是定长结构,Elf64_Rela,每条 24 字节(gABI 第 4 章 Relocation):8 字节 r_offset、8 字节 r_info、8 字节有符号的 r_addend。用原始字节验证一下前两条:
$ llvm-objdump -s -j .rela.text main.o
main.o: file format elf64-x86-64Contents of section .rela.text: 0000 03000000 00000000 02000000 05000000 ................ 0010 fcffffff ffffffff 0d000000 00000000 ................ 0020 04000000 06000000 fcffffff ffffffff ................第一条:r_offset 为 3;r_info 的 8 个字节 02000000 05000000 按小端序读是 0x0000000500000002,高 32 位 5 是符号表里的编号,第 5 项正是 counter,低 32 位 2 是重定位类型 R_X86_64_PC32 的编号(x86-64 psABI 定义);r_addend 是 fcffffff ffffffff,即 -4。第二条:偏移 0xd,r_info 是 0x0000000600000004,第 6 项符号是 add,类型 4 是 R_X86_64_PLT32,加数同样是 -4。llvm-objdump 显示的 counter-0x4、add-0x4,就是从这些字节里解出来的。
字段拆完了,再换一种读法:把每条重定位记录读成汇编器写给链接器的一封短信。第一条是:"请在 .text 偏移 3 处的 4 个字节里,填上 counter 的地址减去这个位置,再减 4。"第二条是:"请在 .text 偏移 0xd 处,填上 add 的地址减去这个位置,再减 4。".data 那条是:"请在 .data 偏移 8 处的 8 个字节里,填上 .rodata.str1.1 节的地址,加 0。"每封信都说清了四件事:改哪里(r_offset,节由 .rela.text 的 sh_info 给出),按什么规则算(r_info 的低 32 位),用谁的地址(r_info 的高 32 位),加数多少(r_addend)。PLT32 在不涉及共享库时就是这样算的,涉及时有什么不同,留到第 4 章。拿到一个陌生的目标文件时,逐条这样念一遍,比盯着字段更容易看出它在等什么。
为什么加数是 -4,PC32 和 PLT32 有什么区别,链接器到底用什么公式把这几个零变成实际的偏移,是第 4 章要一个字节一个字节算的东西。这些记录说明,目标文件里仍有等待链接决定的地址字段。上面的字段恰好写成零;重定位并不是扫描零字节来找空位,原字段也不必为零。要修改的位置和方法由记录指定,第 4 章的 REL 格式还会直接从原字段读取加数。每条记录引用的是符号表里的一个编号,链接器得先弄清这个编号背后的名字对应哪个定义,才谈得上填地址。
两种视图:节给链接器看,段给加载器看
节头、符号和重定位把这份输入描述完整了。把它与 add.o 链接起来后,输出还要满足另一种需求:让操作系统能够建立进程的内存映像。于是同一份 ELF 又多了一种组织方式:节(section)按内容划分,段(segment)按加载方式划分。gABI 第 4 章开头把这件事称为同一份文件的两种平行视图:"the object file format provides parallel views of a file's contents"。链接视图(linking view)以节为单位,用节头表描述;执行视图(execution view)以段为单位,用程序头表描述。规范接着规定了谁必须有哪张表:
Files used to build a process image (execute a program) must have a program header table; relocatable files do not need one.
Files used during linking must have a section header table; other object files may or may not have one.
链接器要做的是把许多输入文件里的内容分门别类地合并、为每块内容决定地址、修补对其他文件的引用。为此它需要知道的粒度很细:这块是代码还是数据,能不能合并,引用了哪些符号,哪些字节需要修补。节正好是这个粒度。一个目标文件里可以有几十上百个节,第 5 章会讲到,用 -ffunction-sections 编译时甚至每个函数单独一个节。
加载器(内核里负责启动程序的那部分,以及上一章提到的动态链接器 ld.so)要做的是把文件映射进内存、设置好权限然后跳转到入口。建立映射时,它需要的是"文件里从哪到哪、映射到哪个虚拟地址、可读可写还是可执行";程序头还会提供解释器、TLS12 等其他启动信息。几十个节对它来说太碎了,内存映射以页为单位,权限也只有读、写、执行几种组合。于是链接器在输出可执行文件时,会把权限相同的节归拢成几个段,每个段在程序头表里占一项,类型为 PT_LOAD 的段就是要映射进内存的那些(程序头表的格式见 gABI 第 5 章)。在 Linux 上对一个可执行文件执行 readelf -l,能看到每个段的文件偏移、虚拟地址、大小、权限,以及每个段里装了哪些节,下面马上会实际看一次。
现在可以回答为什么 main.o 没有段了。段描述的是"放在哪个虚拟地址",而这里的代码和数据尚未取得最终运行地址:main.o 的 .text 将来和 add.o 的 .text、C 库的 .text 拼在一起,拼在第几个、从哪里开始,取决于还有哪些文件参与链接。这件事只有链接器在看到全部输入后才能决定。普通用户态程序的 exec 加载路径不直接执行这种可重定位文件。所以它只需要节头表。
对比一下链接之后的样子会更清楚。不用 C 库,自己写一个最小的程序入口:
# start.S:没有 C 库时的程序入口 .text .globl _start_start: call main movl %eax, %edi # main 的返回值作为退出码 movl $60, %eax # 60 是 x86-64 Linux 的 exit 系统调用号 syscall .section .note.GNU-stack,"",@progbits_start 是链接器默认的程序入口符号,第 5 章会细讲。用本机 ld.lld(21.1.8)把三个目标文件链接成可执行文件,再用 GNU readelf(2.46)查看;这个文件可直接由本机 Linux 加载运行:
$ clang -c start.S -o start.o$ ld.lld -o prog start.o main.o add.o$ readelf -lW prog
Elf file type is EXEC (Executable file)Entry point 0x2011d0There are 5 program headers, starting at offset 64
Program Headers: Type Offset VirtAddr PhysAddr FileSiz MemSiz Flg Align PHDR 0x000040 0x0000000000200040 0x0000000000200040 0x000118 0x000118 R 0x8 LOAD 0x000000 0x0000000000200000 0x0000000000200000 0x0001c4 0x0001c4 R 0x1000 LOAD 0x0001d0 0x00000000002011d0 0x00000000002011d0 0x000034 0x000034 R E 0x1000 LOAD 0x000208 0x0000000000202208 0x0000000000202208 0x000010 0x000118 RW 0x1000 GNU_STACK 0x000000 0x0000000000000000 0x0000000000000000 0x000000 0x000000 RW 0
Section to Segment mapping: Segment Sections... 00 01 .rodata .eh_frame 02 .text 03 .data .bss 04-l 打印程序头表,-W 让长行不折行。文件类型变成了 EXEC,入口地址也有了值 0x2011d0,正是 .text 的起点、_start 所在的位置。程序头表就在 ELF 头后面(偏移 64),每一项是一个 56 字节的 Elf64_Phdr。下表的偏移相对于当前表项起点,宽度是字段本身占用的字节数:
| 表项内偏移 | 宽度 | 字段 | 表示什么 |
|---|---|---|---|
| 0 | 4 | p_type | 程序头的用途 |
| 4 | 4 | p_flags | 权限位:X=1、W=2、R=4 |
| 8 | 8 | p_offset | 段内容相对于文件开头的偏移 |
| 16 | 8 | p_vaddr | 段的虚拟地址 |
| 24 | 8 | p_paddr | 物理地址;普通用户程序不使用 |
| 32 | 8 | p_filesz | 段内容在文件里的字节数 |
| 40 | 8 | p_memsz | 段内容在内存里的字节数 |
| 48 | 8 | p_align | 对齐要求 |
例如 p_filesz 字段总是占 8 字节;它的值可以是 16,表示段有 16 个文件内容字节,不能把字段宽度和所描述内容的长度混为一谈。第 i 个程序头从 e_phoff + i × e_phentsize 开始;其 p_offset 再指向内容,表项本身不是段内容。权限位与节头的 SHF_* 不同:RX 段的 flags=5,代码节的 ALLOC|EXECINSTR=6。
各字段在加载时的作用是:
p_type:段的类型。PT_LOAD(上表的 LOAD)是要映射进内存的段;PT_PHDR描述程序头表自己的位置;PT_GNU_STACK不对应任何内容,只用它的权限位声明栈的权限,这里是 RW,没有 E,就是.note.GNU-stack在链接后的归宿。p_flags:段的权限,R 可读、W 可写、E 可执行(Flg 一栏)。p_offset:段的内容从文件哪里开始(Offset 一栏)。p_vaddr:映射到哪个虚拟地址(VirtAddr);p_paddr是物理地址(PhysAddr),普通程序里不使用,通常与虚拟地址相同。p_filesz:段在文件里占多少字节(FileSiz)。p_memsz:段在内存里占多少字节(MemSiz)。p_align:对齐要求(Align),本例 LOAD 段是 0x1000,即 4 KB;这是该链接结果的对齐选择,不是所有 ELF 文件的固定值。
最下面的 Section to Segment mapping 列出每个段里装了哪些节。节按权限归拢了:只读的 .rodata 和 .eh_frame 进第 1 个段(R),代码 .text 进第 2 个段(R E),可写的 .data 和 .bss 进第 3 个段(RW)。第 3 个段的 FileSiz 是 0x10,MemSiz 却是 0x118。前者正好是 .data 的 16 个字节;.bss 位于 0x202220、长 0x100,结束于 0x202320,减去段起点 0x202208 正是 0x118。加载器从文件映射 16 字节,余下的部分在内存里补零。前面在目标文件里看到 .bss 不占文件空间,到了可执行文件里就体现为这一行 FileSiz 小于 MemSiz。
链接器还做了别的事:这次链接的 .rela.* 输入表没有保留在输出中,因为相应修改已经完成;这不是可执行文件的必然性质,动态链接或 --emit-relocs 等选项会留下重定位信息;main.o 里的 .rodata 和 .rodata.str1.1 被合并成了同一个输出节;每个段的虚拟地址和文件偏移的低 12 位相同(0x1d0 对 0x2011d0,0x208 对 0x202208)。这些安排的道理都在第 5 章。
进阶:变长整数与汇编预处理
到这里,ELF 头、节、符号和重定位的主线已经走通。下面回到 hand.S,解释尚未展开的整数编码与预处理;初读时可以直接继续练习。
LEB128:用多少字节,看数有多大
.long 永远占 4 个字节,哪怕要存的数是 3。在调试信息、栈展开信息这类数据里,绝大多数整数都很小,却偶尔有大的,固定宽度就很浪费。LEB12813(Little Endian Base 128)的思路是把整数切成 7 位一组,每组装进一个字节的低 7 位,最高位当作"后面还有没有"的标记:1 表示还有,0 表示这是最后一个字节。低位的组先放。
以 .uleb128 624485 为例,u 表示无符号:
- 624485 除以 128 余 101(0x65),商 4878;还没完,这一字节写 0x65 | 0x80 = 0xe5。
- 4878 除以 128 余 14(0x0e),商 38;还没完,写 0x8e。
- 38(0x26)小于 128,是最后一组,最高位为 0,写 0x26。
结果是 e5 8e 26 三个字节。有符号版本 .sleb128 处理负数,规则相同,只是用二进制补码按 7 位一组切,结束条件变成两条同时满足:剩下的高位已经全是符号位(对负数来说就是剩下 -1,即全 1),并且刚写出的这个字节的第 6 位(0x40)也等于符号位。第二条保证解码时可以根据第 6 位做符号扩展,也就是用这一位的值填满更高的所有位,还原出负数。-123456 按这个规则得到 c0 bb 78:第一组是 0x40,剩下 -965;第二组是 0x3b,剩下 -8,高位还不全是 1,继续;第三组是 0x78,剩下 -1,而且 0x78 的第 6 位也是 1,两个条件都满足,到此为止。前两组还有后续,最高位置 1,变成 0xc0 和 0xbb,所以最终写出的是 c0 bb 78。
这两个数正是 Wikipedia 上 LEB128 词条用的例子,可以对照验证。编码的正式定义在 DWARF 5 标准第 7.6 节。DWARF14 调试信息和第 8 章要讲的 .eh_frame 都大量使用它,WebAssembly 的二进制格式和 Android 的 DEX 文件也用它存整数,所以值得在这里先认识一下。
汇编一下,看看 .rodata 里实际摆了什么:
$ clang -c hand.S -o hand-small.o$ llvm-objdump -s -j .rodata hand-small.o
hand-small.o: file format elf64-x86-64Contents of section .rodata: 0000 686900ff 00000000 e58e26c0 bb786400 hi........&..xd. 0010 0000 ..-s 以十六进制打印节的内容,-j 选定一个节。逐字节对一下:68 69 00 是 "hi" 加结尾的 0;ff 是 .byte;此时位置是 4,.balign 8 补了 4 个 0;偏移 8 开始是 e5 8e 26,接着是 c0 bb 78;偏移 0xe 开始的 64 00 00 00 是宏展开出来的 .long 100。一共 0x12 个字节,和手算完全一致。
注意 100 被写成了 64 00 00 00,低位字节在前。这就是第 0 章说过的小端序,低位字节放在低地址,文件里也一样。后面读 ELF 头、符号表、重定位表时,每个整数都要这样倒着读。
预处理:同一份 .S,两个不同的目标文件
hand.S 末尾有一段 C 风格的 #ifdef。汇编器自己不认识它,这一段是交给 C 预处理器的。clang 和 GCC 的约定是:后缀为大写 .S 的文件先预处理再汇编,小写 .s 直接汇编(见 GCC 手册 Overall Options)。如果文件后缀是小写,又想要预处理,就用 -x assembler-with-cpp 显式指定语言类型。
用 -DBIG 定义宏 BIG,就能从同一份源码得到两个不同的目标文件:
$ clang -DBIG -c hand.S -o hand-big.o$ llvm-objdump -s -j .rodata hand-big.o
hand-big.o: file format elf64-x86-64Contents of section .rodata: 0000 686900ff 00000000 e58e26c0 bb78a086 hi........&..x.. 0010 0100 ..最后 4 个字节从 64 00 00 00(100)变成了 a0 86 01 00,按小端序读是 0x000186a0,也就是 100000。
如果把同一份内容存成小写的 plain.s,不加 -x assembler-with-cpp 直接汇编,会怎样?
$ cp hand.S plain.s$ clang -DBIG -c plain.s -o plain.oclang: warning: argument unused during compilation: '-D BIG' [-Wunused-command-line-argument]<instantiation>:2:1: error: symbol 'limit' is already definedlimit:^先是一条警告:-DBIG 没被用到,因为根本没有预处理这一步。接着是错误:limit 被定义了两次。在 x86 的 GNU 汇编语法里,# 是行注释符(见 GNU as 手册的 i386 语法一节),于是 #ifdef、#else、#endif 三行都成了注释,两个 CONST 都被展开,产生了两个 limit: 标号。加上 -x assembler-with-cpp 就恢复正常:
$ clang -x assembler-with-cpp -DBIG -c plain.s -o plain.o$ llvm-objdump -s -j .rodata plain.o | tail -2 0000 686900ff 00000000 e58e26c0 bb78a086 hi........&..x.. 0010 0100 ..Linux 内核、glibc15 这类项目的手写汇编大多是 .S 文件,靠预处理在同一份源码里区分不同的 CPU 特性、不同的 ABI16,再用 #include 共享常量定义。不管源码经过了几层预处理和宏,最后落到文件里的只有字节。要知道链接器实际拿到了什么,只能去读 .o 本身。
一个名字,两个文件
把两个目标文件放在一起看。main.o 的符号表里有一个 add,所属节是 *UND*,.text 偏移 0xd 处有 4 个零字节在等它。add.o 的符号表里也有一个 add,是 GLOBAL、FUNC,定义在它自己的 .text 偏移 0 处,长 4 字节。两个文件彼此并不知道对方存在,把它们连起来的只有这个名字。
链接器拿到这两个文件,第一步就要做这次配对:为每个未定义的引用找到一个定义。在这个例子里只有一个候选,配对是显然的。可真实的程序里,一个名字可能有好几个定义:两个文件各定义了一个 counter;一个定义是 w、另一个是 g;定义藏在静态库里几百个目标文件中的某一个,要不要把它拉进来、什么时候拉;还有像 maybe 这样的弱引用,找不到定义也不报错。undefined reference to 'add' 和 multiple definition of 'counter' 这两条最常见的链接错误,都发生在这一步。链接器按什么规则在这些候选里选出一个,就是下一章要讲的符号解析。
练习
练习一,观察。下面是 quiz.c:
// quiz.cint printf(const char *fmt, ...);extern int limit;extern int unused;int total = 0;__attribute__((weak)) int verbose = 1;static int square(int v) { return v * v; }
int report(int n) { static int calls; int sum = square(n) + total + limit; if (verbose) printf("%d: %d\n", ++calls, sum); return sum;}用 clang -O0 -c quiz.c 编译。先不看输出,回答:printf、limit、unused、total、verbose、square、v、report、n、calls、sum 和字符串 "%d: %d\n",这 12 个名字里哪些会进 .symtab?进去的,绑定是 LOCAL、GLOBAL 还是 WEAK,在哪个节,还是 *UND*?然后用 readelf -s quiz.o核对。附加一问:换成 -O1,哪个名字会消失?
练习二,预测。下面是 predict.s:
# predict.s .text .globl entry .type entry,@functionentry: movl counter(%rip), %eax call bump call ext_func leaq .Lmsg(%rip), %rdi jmp .Lout.Lout: ret .size entry, . - entry
.section .text.cold,"ax",@progbitsbump: ret
.data .globl countercounter: .long 7 .long .Lout - entryslot: .quad counter + 8 .quad slot
.section .rodata.str1.1,"aMS",@progbits,1.Lmsg: .asciz "ok" .section .note.GNU-stack,"",@progbits不运行汇编器,写出:会生成哪些节;符号表里有哪些符号,各自的绑定、类型、所在节;每条重定位记录的所在节、偏移、类型、符号和加数(提示:movl 的 RIP 相对形式 8b 05 占 2 字节,call 的 e8 占 1 字节,leaq 的 48 8d 3d 占 3 字节);哪些引用不需要重定位,汇编器会直接写下什么字节。然后用 clang -c 汇编,用 llvm-objdump -t -dr 核对;再用 GNU as(as)汇编一次,找出两个汇编器结果不同的那一条。
练习三,改坏。下面的 flag.s 不用 C 库,直接用 exit 系统调用以退出码 42 结束:
.section .boot,"ax",@progbits .globl _start_start: movl $60, %eax movl $42, %edi syscall .section .note.GNU-stack,"",@progbits用 ld.lld -o prog flag.o 和 GNU ld(ld17)各链接一次,直接在本机 x86-64 Linux 上运行:
$ ./prog; echo $?确认能得到 42 之后,把标志 "ax" 分别改成 "a"(去掉 x)和 "x"(去掉 a),重新汇编、链接、运行。每种改法先预测:链接器会不会报错?readelf -lW 里 .boot 进了什么权限的段,入口地址是多少?运行结果是什么?最后把标志改回 "ax"。
答案
练习一
实测:
$ clang -O0 -c quiz.c -o quiz.o$ readelf -sW quiz.o
Symbol table '.symtab' contains 12 entries: Num: Value Size Type Bind Vis Ndx Name 0: 0000000000000000 0 NOTYPE LOCAL DEFAULT UND 1: 0000000000000000 0 FILE LOCAL DEFAULT ABS quiz.c 2: 0000000000000000 0 SECTION LOCAL DEFAULT 2 .text 3: 0000000000000060 16 FUNC LOCAL DEFAULT 2 square 4: 0000000000000004 4 OBJECT LOCAL DEFAULT 4 report.calls 5: 0000000000000000 8 OBJECT LOCAL DEFAULT 6 .L.str 6: 0000000000000000 0 SECTION LOCAL DEFAULT 4 .bss 7: 0000000000000000 87 FUNC GLOBAL DEFAULT 2 report 8: 0000000000000000 4 OBJECT GLOBAL DEFAULT 4 total 9: 0000000000000000 0 NOTYPE GLOBAL DEFAULT UND limit 10: 0000000000000000 4 OBJECT WEAK DEFAULT 5 verbose 11: 0000000000000000 0 NOTYPE GLOBAL DEFAULT UND printf这个文件的节编号是:2 .text,4 .bss,5 .data,6 .rodata.str1.1。逐个对照:
printf、limit:GLOBAL,UND。文件引用了它们,定义在别处。unused:不进符号表。它只被声明、从未被使用,汇编器根本没见到这个名字。total:GLOBAL OBJECT,在.bss。初值是 0,和没写初值一样放进.bss。verbose:WEAK OBJECT,在.data,因为初值是 1。square:LOCAL FUNC,在.text。static函数只是变成了局部符号,并没有消失。report:GLOBAL FUNC,在.text。calls:LOCAL OBJECT,在.bss,名字变成了report.calls。函数内的static变量和全局变量一样有固定地址,所以要进符号表;不同函数可能各有一个calls,编译器得给它们起不同的名字。GCC 的写法是calls.0。v、n、sum:不进符号表。参数和局部变量在寄存器或栈上,地址每次调用都不同,链接器不需要知道它们。15-213 的原话是 "Local linker symbols are not local program variables"。- 字符串:这里出现了一个名为
.L.str的 LOCAL OBJECT。正文说以.L开头的私有标号一般不进符号表,main.o里的"hello"也确实没进,那里对它的引用是一条R_X86_64_64,加数为 0,被改写成了节符号.rodata.str1.1。这里的引用是leaq .L.str(%rip), %rdi,llvm-objdump -r显示为R_X86_64_PC32 .L.str-0x4,加数是 -4。.rodata.str1.1带SHF_MERGE标志,链接器合并重复字符串时会挪动其中的片段;MaskRay 那篇文章指出,对这种节,只有加数为 0 的引用才能安全地改写成"节符号加偏移",否则合并之后偏移可能落进别的字符串。汇编器于是保留了这个符号。用 GCC 编译(musl-gcc -O0 -c),字符串进的是普通的.rodata,引用写成.rodata节符号,符号表里就没有它。15-213 那道小测验的备注里也说,字符串常量"算不算符号"可以讨论。
附加一问:-O1 下 square 被内联进 report,符号表少了 square 这一项,其余不变。
练习二
$ clang -c predict.s -o predict.o$ readelf -sW predict.o
Symbol table '.symtab' contains 9 entries: Num: Value Size Type Bind Vis Ndx Name 0: 0000000000000000 0 NOTYPE LOCAL DEFAULT UND 1: 0000000000000000 0 NOTYPE LOCAL DEFAULT 4 bump 2: 0000000000000000 0 NOTYPE LOCAL DEFAULT 7 .Lmsg 3: 0000000000000000 0 SECTION LOCAL DEFAULT 4 .text.cold 4: 0000000000000000 0 SECTION LOCAL DEFAULT 5 .data 5: 0000000000000008 0 NOTYPE LOCAL DEFAULT 5 slot 6: 0000000000000000 26 FUNC GLOBAL DEFAULT 2 entry 7: 0000000000000000 0 NOTYPE GLOBAL DEFAULT 5 counter 8: 0000000000000000 0 NOTYPE GLOBAL DEFAULT UND ext_func$ llvm-objdump -dr predict.o(省略文件头)0000000000000000 <entry>: 0: 8b 05 00 00 00 00 movl (%rip), %eax # 0x6 <entry+0x6> 0000000000000002: R_X86_64_PC32 counter-0x4 6: e8 00 00 00 00 callq 0xb <entry+0xb> 0000000000000007: R_X86_64_PLT32 .text.cold-0x4 b: e8 00 00 00 00 callq 0x10 <entry+0x10> 000000000000000c: R_X86_64_PLT32 ext_func-0x4 10: 48 8d 3d 00 00 00 00 leaq (%rip), %rdi # 0x17 <entry+0x17> 0000000000000013: R_X86_64_PC32 .Lmsg-0x4 17: eb 00 jmp 0x19 <entry+0x19> 19: c3 retq(省略)$ llvm-objdump -r predict.o | tail -4RELOCATION RECORDS FOR [.data]:OFFSET TYPE VALUE0000000000000008 R_X86_64_64 counter+0x80000000000000010 R_X86_64_64 .data+0x8$ llvm-objdump -s -j .data predict.o | tail -2 0000 07000000 19000000 00000000 00000000 ................ 0010 00000000 00000000 ........节:.text(0x1a 字节)、.text.cold(1 字节)、.data(0x18 字节)、.rodata.str1.1(3 字节)、.note.GNU-stack,加上汇编器生成的 .rela.text、.rela.data、.symtab、.strtab。clang 没有生成空的 .bss,GNU as 会生成一个,还会多一个 .note.gnu.property 和单独的 .shstrtab。
符号:entry 是 GLOBAL FUNC,大小 26 来自 .size;counter 是 GLOBAL,但没写 .type 和 .size,所以是 NOTYPE、大小 0;ext_func 是 UND;bump、slot 没写 .globl,是 LOCAL;.Lmsg 是私有标号,却留在了符号表里,原因和练习一的 .L.str 相同(SHF_MERGE 节加非零加数)。.Lout 没进符号表。两个节符号 .text.cold、.data 是为了给重定位记录引用才生成的;没有任何重定位引用 .text 本身,所以没有 .text 节符号。
重定位,加数都已列在 llvm-objdump 输出里:
.text+0x2,R_X86_64_PC32 counter-4:counter在另一个节,而且是全局符号,保留名字。.text+0x7,R_X86_64_PLT32 .text.cold-4:bump是局部符号但在另一个节,引用被改写成节符号加偏移(bump恰好在节的开头,偏移为 0)。.text+0xc,R_X86_64_PLT32 ext_func-4:未定义的外部函数。.text+0x13,R_X86_64_PC32 .Lmsg-4。.data+0x8,R_X86_64_64 counter+8:8 字节绝对地址,引用全局符号,加数 8 照抄自counter + 8。.data+0x10,R_X86_64_64 .data+8:slot是局部符号,改写成.data节符号,加数就是slot在节内的偏移 8。
不需要重定位的有两处。jmp .Lout 的目标在同一节,就是下一条指令,汇编器写下 eb 00。.long .Lout - entry 是同一节两个标号之差,汇编器算出 0x19,.data 偏移 4 处是 19 00 00 00。
和 GNU as 的差别在 call bump 那一条:
$ as predict.s -o predict-gas.o$ llvm-objdump -dr predict-gas.o | grep -A1 'callq' 6: e8 00 00 00 00 callq 0xb <entry+0xb> 0000000000000007: R_X86_64_PC32 .text.cold-0x4-- b: e8 00 00 00 00 callq 0x10 <entry+0x10> 000000000000000c: R_X86_64_PLT32 ext_func-0x4GNU as 对局部函数的调用用 R_X86_64_PC32,LLVM 用 R_X86_64_PLT32。局部符号不会被插入,也不会落在共享库里,两种类型在链接时算出的结果相同,区别留到第 4 章再看。其余五条两者一致。
练习三
实测的三种标志:
$ ld.lld -o lld-ax flag-ax.o; ld -o gnu-ax flag-ax.o$ readelf -lW lld-ax | grep -E 'Entry|LOAD'Entry point 0x201120 LOAD 0x000000 0x0000000000200000 0x0000000000200000 0x000120 0x000120 R 0x1000 LOAD 0x000120 0x0000000000201120 0x0000000000201120 0x00000c 0x00000c R E 0x1000$ readelf -lW lld-a | grep -E 'Entry|LOAD'Entry point 0x200120 LOAD 0x000000 0x0000000000200000 0x0000000000200000 0x00012c 0x00012c R 0x1000$ readelf -lW lld-x | grep -E 'Entry|LOAD'Entry point 0x0 LOAD 0x000000 0x0000000000200000 0x0000000000200000 0x000120 0x000120 R 0x1000$ readelf -lW gnu-x | grep -E 'Entry|LOAD'Entry point 0x0这三个输入分别检验分配属性和执行属性。SHF_ALLOC 表示节需要在运行时占有内存,SHF_EXECINSTR 表示其中包含可执行指令;二者不能互相替代。链接器把输入节组织为段,Linux 按程序头中的 p_flags 建立映射权限,CPU 才在取指时检查该页是否可执行。
"ax"同时声明分配和执行。本例两个链接器都把.boot放进 R E 加载段,入口指向_start,程序返回 42。"a"只声明分配。.boot在文件和加载映像中都存在,入口也指向它,但它所在的段只有 R 权限。链接成功并不能赋予执行权限;从这个非执行页取指时,进程收到 SIGSEGV。示例中 shell 报告 139,即128 + 11。"x"只声明执行。缺少 A 属性的输入节没有进入本例的加载段;磁盘上存在指令字节,不意味着它们已进入进程地址空间。这里 LLD 保留一个只装头部的 R 段,GNU ld 不生成加载段,两者的入口均为 0,运行失败。具体回退入口由链接器和选项决定,缺少有效可执行入口才是共同的问题。
链接器依照声明的属性组织节,不靠识别指令字节来推断程序意图。因此,检查应沿“输入节标志 → 输出段范围与权限 → 入口 → 实际执行”逐层进行,不能以链接命令返回成功作为权限正确的证据。
参考
- ELF gABI:Sections 与 Symbol Table:节索引、扩展编号、符号字段与绑定规则。
- CMU 15-213:Linking,Fall 2026:其中的 Symbol Identification 小测验是本章符号分类练习的题型来源;本章源码和逐字节分析另行编写。
- Princeton COS 217:Assemblers and Linkers,Spring 2026:汇编、符号表与重定位的教学材料;将重定位读成修补请求的讲法参考此讲义。
附录:术语与工具
-
ELF — ELF(Executable and Linkable Format)规定目标文件、可执行文件与共享对象的结构。通用规则见 gABI,架构相关的调用约定和重定位规则见对应 psABI。 官方文档。 ↩
-
cc —
cc是系统约定的 C 编译命令入口,具体实现可能是 GCC 或 Clang。检查cc --version可以确认当前环境;复现实验时,显式指定实现更容易对齐行为。 官方文档。 ↩ -
IR — IR(intermediate representation)是编译器使用的中间表示。它处于源码与最终机器码之间,便于分析和优化;LLVM IR 的文本形式与 bitcode 二进制编码表达同一套中间语言。 官方文档。 ↩
-
GCC — GCC(GNU Compiler Collection)是一组语言编译器。命令
gcc是驱动入口,会组织编译、汇编和链接;在终端调用它,并不意味着后续工作都在同一个进程里完成。 官方文档。 ↩ -
as — GNU
as将汇编输入编码为目标文件。汇编指令描述机器操作,.section、.globl等伪指令则指导汇编器组织节和符号。 官方文档。 ↩ -
binutils — GNU binutils 是一组处理目标文件的工具,包含汇编器
as、链接器ld,以及readelf、nm、objdump、ar等检查与归档工具。 官方文档。 ↩ -
nm —
nm列出目标文件的符号。字母标记概括符号所在节或绑定等属性;需要判断准确语义时,应继续对照 ELF 符号表字段。 官方文档。 ↩ -
gABI — gABI 是通用 System V ABI,规定 ELF 等跨架构规则;psABI 是处理器相关补充,进一步规定寄存器约定、重定位编号与 TLS 等细节。 官方文档。 ↩
-
psABI — psABI(processor-specific ABI)是特定处理器架构的二进制接口约定。不同架构可以共用 ELF 文件结构,同时拥有不同的指令、调用约定和重定位公式。 官方文档。 ↩ ↩2
-
PIE — PIE(position-independent executable)是可以在不同加载基址运行的可执行文件。生成 PIE 需要编译与链接选项配合;static-PIE 还需要自身的启动路径完成必要重定位。 官方文档。 ↩
-
ICF — ICF(Identical Code Folding)合并被判定为等价的代码。字节相同不一定足以证明可合并,还需要考虑重定位目标、函数地址是否可观察以及关联的运行时元数据。 官方文档。 ↩
-
TLS — TLS(Thread-Local Storage)让不同线程拥有同一变量的独立实例。链接器描述初始化模板并处理寻址模型,运行时负责为线程建立实例。这里不是网络协议 Transport Layer Security。 官方文档。 ↩
-
LEB128 — LEB128(Little Endian Base 128)逐组保存整数的七个有效位,常用于 DWARF 与 WebAssembly。它有无符号和有符号两种形式,不是固定宽度的小端整数。 官方文档。 ↩
-
DWARF — DWARF 是调试信息格式,描述源码行、类型、变量与机器位置的关系。它可以随 ELF 保存,但不是 ELF 符号表的别名。 官方文档。 ↩
-
glibc — glibc(GNU C Library)是许多 Linux 发行版默认使用的 C 库。库的启动文件、共享库和动态链接器共同参与程序构建与运行。 官方文档。 ↩
-
ABI — ABI(Application Binary Interface)规定二进制组件如何协作,包括调用约定、数据布局和文件格式等。它约束编译结果之间的交接,比源码层面的 API 更靠近机器。 官方文档。 ↩
-
ld —
ld是常见的链接器命令名;本系列写 GNU ld 时特指 GNU binutils 的链接器。它读取目标文件、库与链接选项,完成符号解析、布局和重定位。 官方文档。 ↩