

[链接器的世界-原理篇12] 链接期优化:看见更多代码之后
分开编译既是构建系统的便利,也是优化器的信息边界。编译 main.c 时,声明足以让它调用 util.c 中的函数,却没有提供那个函数的实现。链接器收到两个文件时,实现通常已经成为机器码:符号和重定位可以把调用接通,但函数体中的数据流与控制流不再以编译器原有的形式保存。跨文件内联因此需要一种比“接通调用”更深入的协作。
链接期优化(Link-Time Optimization,LTO1)将这条边界后移。编译阶段保留编译器仍能分析的程序表示,即 IR;链接器确定每个名字对应的定义及其对外可见性,编译器再依据这些约束优化程序并生成机器码。源文件仍然分开组织,优化器却可以利用跨文件的信息。
LTO、GC 与 ICF 都可能减少输出中的代码,但依据不同:LTO 改写程序表示,GC 删除不可达的节,ICF 合并可以共享存储的等价节。理解它们,需要区分定义选择、引用关系与输出布局;这些基础分别见原理篇 03和原理篇 05。本章从一个跨文件调用出发,解释这种分工,再讨论 ThinLTO 的可扩展性、ICF 的正确性条件,以及函数布局对局部性的影响。
一次跨文件调用怎样消失
下面的 main.c 在循环中调用 scale,util.c 定义 scale,以及两个没有被本程序调用的函数。它们让两种变化可以分别观察:调用能否被展开,未使用的定义能否被删除。
// main.cint scale(int x);
int main(int argc, char **argv) { unsigned s = 0; for (int i = 0; i < 400000000; i++) s += scale(i ^ argc); return s >> 24;}// util.cint scale(int x) { return 3 * x + 1; }
int twice(int x) { return 2 * x; }
unsigned checksum(const unsigned char *p, int n) { unsigned h = 2166136261u; for (int i = 0; i < n; i++) h = (h ^ p[i]) * 16777619u; return h;}分开编译、各自 -O2 的时候,编译器在 main.c 里只看到 scale 的声明,看不到函数体,在这个例子中会保留一次函数调用;它也没法把 scale 内联(inline,把被调函数的函数体直接抄进调用处,省掉调用本身,还让两边的代码可以合在一起继续优化)。在 util.c 里,它不知道别的文件会不会调用 twice 和 checksum,只好都留着。
给两次编译加上启用链接期优化的 -flto,再把产物交给支持这种输入的 ld.lld,可以对照四个符号的去留与 main 的指令变化。
以下结果来自 x86-64 Linux:Ubuntu 26.04,Clang/LLD 21.1.8、GCC2 15.2、GNU3 binutils4 2.46。link_musl 表示一个已经配置好的 shell 辅助函数:它把输入交给本机 Linux 的 musl 启动对象、libc 和 ld.lld,等价于 ld.lld -static crt1.o crti.o 输入… -lc crtn.o。启动对象和库的具体安装位置属于系统配置,不影响下面对 IR、符号可见性和输出的分析;编译器、链接器和产物都直接在这台 Linux 上运行。下面只使用这个辅助函数的输入输出契约:
$ # set the variables required by the commands below$ mkdir -p "$W/puzzle"$ # 将两份源文件复制到临时目录$ cd "$W/puzzle"$ clang -fno-pie -O2 -c main.c -o main.o$ clang -fno-pie -O2 -c util.c -o util.o$ link_musl plain main.o util.o$ clang -fno-pie -O2 -flto -c main.c -o main.lto.o$ clang -fno-pie -O2 -flto -c util.c -o util.lto.o$ link_musl lto main.lto.o util.lto.o$ llvm-nm -S plain | grep -E ' (main|scale|twice|checksum)$'0000000000201330 0000000000000095 T checksum00000000002012d0 0000000000000032 T main0000000000201310 0000000000000006 T scale0000000000201320 0000000000000004 T twice$ llvm-nm -S lto | grep -E ' (main|scale|twice|checksum)$'0000000000201a30 00000000000000a0 T main$ llvm-size plain lto text data bss dec hex filename 2408 40 1768 4216 1078 plain 2282 40 1896 4218 107a lto开了 LTO 的产物里只剩 main。scale 被内联进了 main,自己的函数体随即没了用处;twice 和 checksum 从头到尾没人调用,也被删掉了。main 本身从 0x32 字节涨到 0xa0 字节,因为内联之后循环体里没有了调用,编译器可以对它做向量化(vectorization,将多个相同操作合并处理)。这里用到 x86 的 SSE 指令族:SIMD 是“单条指令处理多个数据”的执行方式,示例中的 128 位向量寄存器可容纳四个 32 位整数,因而一次加法能同时处理四项:
$ llvm-objdump -d --no-show-raw-insn --disassemble-symbols=main plain00000000002012d0 <main>: ... 2012e0: movl %r14d, %edi 2012e3: xorl %ebp, %edi 2012e5: callq 0x201310 <scale> 2012ea: addl %eax, %ebx ...$ llvm-objdump -d --no-show-raw-insn --disassemble-symbols=main lto0000000000201a30 <main>: 201a30: movd %edi, %xmm0 201a34: pshufd $0x0, %xmm0, %xmm1 # xmm1 = xmm0[0,0,0,0] ... 201a70: movdqa %xmm2, %xmm7 201a74: paddd %xmm3, %xmm7 ... 201aad: addl $-0x8, %eax 201ab0: jne 0x201a70 <main+0x40>llvm-size 的 text 一栏减少了 126 字节。它统计的不只是 .text,还包含其他可分配、不可写的节;同时,bss 从 1768 增到 1896,不能只看 text 就断言全部内存占用一定减少。
两份 ELF5 直接在 Linux 上执行,返回码均为 110,即 s >> 24 的结果。本次两次 Clang6 对照为普通版本 0.83、0.77 秒,LTO 版本 0.09、0.06 秒。同机 GCC 的三次对照为 0.722、0.897、0.968 秒与 0.321、0.309、0.312 秒。具体时间受同机负载和编译器生成的循环影响,适合说明这个例子的优化效果,不能当成 LTO 的固定提速比例。
GCC 的 size 对照为:
text data bss dec hex filename 1494 544 8 2046 7fe a_plain 1265 544 8 1817 719 a_lto这也不是“LTO 总让程序变小”。. 其他包含更激进内联的输入可能让 text 增长,因为内联会复制代码。开头的问题仍然是:.o 中装了什么,为什么链接时能做跨文件优化,以及哪些全局定义确实可以删掉?
把机器码生成推迟到链接阶段
在本例的 Clang 配置中,打开 -flto 后,-c 产生的 .o 已不再是第 2 章拆开过的普通 ELF 目标文件。扩展名仍是 .o,内容却变了:
$ file main.o main.lto.omain.o: ELF 64-bit LSB relocatable, x86-64, version 1 (SYSV), not strippedmain.lto.o: LLVM IR bitcode$ xxd main.lto.o | head -100000000: 4243 c0de 3514 0000 0500 0000 620c 3024 BC..5.......b.0$$ readelf -h main.lto.oreadelf: Error: This is a LLVM bitcode file - try using llvm-bcanalyzer$ stat -c '%n: %s bytes' main.o main.lto.omain.lto.o: 2768 bytesmain.o: 1144 bytesIR7(intermediate representation,中间表示)是编译器内部介于源码和机器码之间的那层代码,编译器可以在这一层表达数据流和控制流,执行内联、常量传播等优化;生成目标指令之后仍可能有其他优化,不能把所有优化都归到同一层。LLVM8 的 IR 有文本和二进制两种写法,二进制的那种叫 bitcode,文件以 BC 加 0xC0DE 四个字节开头。GNU readelf 认得这个魔数,直接让你去用 llvm-bcanalyzer。用 llvm-dis 把它还原成文本,能看到 scale 还是一条乘法加一条加法,没有任何 x86 指令:
$ llvm-dis util.lto.o -o - | grep -A4 '@scale'define dso_local range(i32 -2147483647, -2147483648) i32 @scale(i32 noundef %0) local_unnamed_addr #0 { %2 = mul nsw i32 %0, 3 %3 = add nsw i32 %2, 1 ret i32 %3}机器码要等到链接时才生成,这就回答了开头的例子的第一问:编译器在 -c 阶段仍会做一部分优化,但没有把这份程序表示彻底降成机器码;本例使用完整 LTO,链接时参与这次优化的 IR 模块合到一起,scale 的函数体就在 main 旁边,内联成了一次普通的模块内优化。
链接器要拿这份文件做符号解析,就得知道它定义和引用了哪些名字。llvm-bcanalyzer 能列出 bitcode 里的各个块(block,bitcode 的基本组织单位,类似 ELF 的节):
$ llvm-bcanalyzer -dump main.lto.o | grep -oE '^ *<[A-Z_]+BLOCK' | sort | uniq -c... 1 <FULL_LTO_GLOBALVAL_SUMMARY_BLOCK 1 <FUNCTION_BLOCK ... 1 <IDENTIFICATION_BLOCK 1 <MODULE_BLOCK 1 <STRTAB_BLOCK 1 <SYMTAB_BLOCK$ llvm-bcanalyzer -dump util.lto.o | grep -A1 -m1 IDENTIFICATION_BLOCK<IDENTIFICATION_BLOCK_ID NumWords=5 BlockCodeSize=5> <STRING abbrevid=4 op0=76 op1=76 op2=86 ... /> record string = 'LLVM21.1.8'$ llvm-nm main.lto.o util.lto.omain.lto.o:---------------- T main U scale
util.lto.o:---------------- T checksum---------------- T scale---------------- T twiceSYMTAB_BLOCK 是一张预先算好的符号表,链接器不必解析整个模块就能读到符号的名字和属性,llvm-nm 读的就是它,地址一栏是一排横线,因为这时还没有地址。
GCC 的做法:.gnu.lto_ 节与 slim、fat 两种对象
GCC 走了另一条路:LTO 对象仍然是 ELF,IR 放在一组以 .gnu.lto_ 开头的节里。GCC 的 IR 叫 GIMPLE,它和 LLVM IR 一样介于源码和机器码之间。用 Linux 本机 GCC 15.2 编 util.c:
$ gcc -O2 -flto -c util.c -o util.slim.o$ gcc -O2 -flto -c main.c -o main.slim.o$ gcc -O2 -flto -ffat-lto-objects -c util.c -o util.fat.o$ gcc -O2 -c util.c -o util.gcc.o$ stat -c '%n: %s bytes' util.fat.o util.gcc.o util.slim.outil.fat.o: 5664 bytesutil.gcc.o: 1440 bytesutil.slim.o: 5168 bytes$ readelf -SW util.slim.o(节选) [Nr] Name Type Address Off Size ES Flg Lk Inf Al [ 1] .text PROGBITS 0000000000000000 000040 000000 00 AX 0 0 1 [ 7] .gnu.lto_.inline.ce6e4b4d6bbe9a11 PROGBITS 0000000000000000 0000a3 000063 00 E 0 0 1 [12] .gnu.lto_scale.0.ce6e4b4d6bbe9a11 PROGBITS 0000000000000000 000199 0000fb 00 E 0 0 1 [13] .gnu.lto_twice.1.ce6e4b4d6bbe9a11 PROGBITS 0000000000000000 000294 0000ea 00 E 0 0 1 [14] .gnu.lto_checksum.2.ce6e4b4d6bbe9a11 PROGBITS 0000000000000000 00037e 000230 00 E 0 0 1 [18] .gnu.lto_.symtab.ce6e4b4d6bbe9a11 PROGBITS 0000000000000000 000905 000042 00 E 0 0 1$ readelf -sW util.slim.o | tail -12: 0000000000000001 1 OBJECT GLOBAL DEFAULT COM __gnu_lto_slim$ readelf -SW util.fat.o | grep ' .text'[ 1] .text PROGBITS 0000000000000000 000040 00005e 00 AX 0 0 32每个函数的 GIMPLE 占一个节(.gnu.lto_scale.0.…),另有内联摘要、符号表、编译选项等节;节名末尾那串十六进制数,本次 slim 对象是 ce6e4b4d6bbe9a11;同一个文件连续编译两次,也会生成不同的后缀;加上 -frandom-seed=x 再编两次,产物逐字节相同(GCC 文档的 Developer Options 说这个种子用于生成"每个编译出的文件都必须不同"的名字)。这些节都带 E 标志,也就是第 5 章见过的 SHF_EXCLUDE,不进最终输出。
默认的 slim(瘦)对象里 .text 长度为 0,ELF 符号表里除了文件名只有一个 common 符号 __gnu_lto_slim,作用是做个记号,scale、twice、checksum 都不在 ELF 符号表里。所以不认识 GCC LTO 的工具读它会扑空。-ffat-lto-objects 生成 fat(胖)对象,GIMPLE 之外还带一份完整的机器码(.text 有 0x5e 字节),不做 LTO 的链接器也能用它,代价是同时保留两种表示,增加编译工作和文件大小,耗时并不保证恰好翻倍。GCC 4.9 的发布说明写的是"When using a linker plugin, compiling with the -flto option now generates slim object files",也就是说,在用链接器插件的前提下,从这一版起默认生成 slim 对象(GCC 4.9 Release Notes,GCC: Optimize Options 的 -ffat-lto-objects 一项)。
GNU nm 能读出 slim 对象里的符号,是因为它会自动从 lib/bfd-plugins/ 目录加载 GCC 的插件(plugin,一个由编译器提供、在运行时被 binutils 工具加载的共享库,替它们读懂 IR);不让它加载,就读不出来:
$ nm util.slim.o00000000 T checksum00000000 T scale00000000 T twice$ nm --plugin /dev/null util.slim.onm: util.slim.o: plugin needed to handle lto object0000000000000001 C __gnu_lto_slim链接器在 LTO 里做什么
先把三个角色分开:编译器前端从源码生成 IR;链接器决定全局名字由谁提供、哪些引用必须保留;编译器的 LTO 后端在这些约束下优化 IR 并生成机器码。IR 是还保留函数体和运算关系的程序表示,bitcode 是 LLVM 保存这种表示的文件编码;它不是一个尚未填写地址的机器码节。
普通链接收到的函数已经是机器码,只能依据符号与重定位连接它们。本例的 LTO 输入还保留 scale 的计算,后端因此可以把它放进 main 的循环,再删除没有外部使用者的独立定义。这个删除需要全局选择提供依据,不能仅凭“当前 IR 中没人调用”就判断一个公开接口无用。
| 阶段 | 输入 | 本例中可以确定什么 | 交给下一阶段什么 |
|---|---|---|---|
| 符号选择 | IR 符号与普通对象中的引用 | main 被启动代码使用;scale 的定义来自 util.lto.o | 每个名字的选择和对外可见性 |
| 优化与代码生成 | IR 函数体及上述选择 | 哪些调用可以内联、哪些定义可以内部化或移除 | 普通 ELF 可重定位对象 lto.lto.o |
| 常规链接 | 新对象与其余输入 | 输出位置、最终地址和待填写字段 | 可执行 ELF |
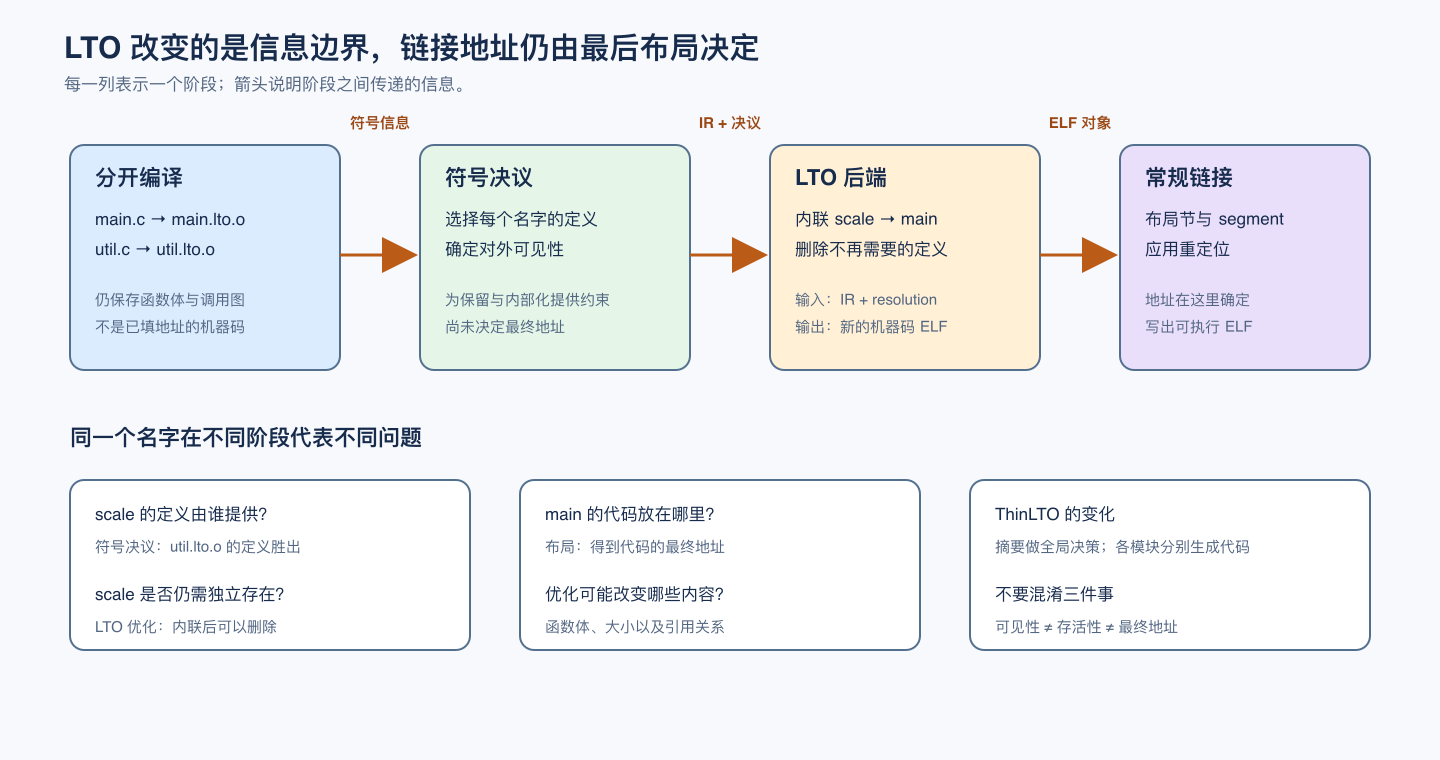
符号的选择身份先确定,不表示最终地址已经确定。优化可能改变函数大小、生成新引用;输出地址需要后续布局。下面的 resolution 文件记录第一行的选择,中间 bitcode 文件展示第二行的变化,链接 map 展示第三行的布局。依照这三个观察点读输出,就能区分“谁选择定义”和“谁改写函数”。LLVM 的 LTO 协作设计描述了这种分工。
具体流程分成三步。
第一步照常做符号解析。bitcode 文件和普通目标文件一起参加第 3 章那套规则:强弱定义、COMDAT9、静态库按需拉取,全都一样。区别只在于 bitcode 文件的符号表来自上一节的 SYMTAB_BLOCK,链接器不懂它的代码,只知道名字和属性。
第二步,链接器把解析结果告诉 LTO 后端。LTO 后端就是编译器的优化器加代码生成器,lld 里它是同一个进程里的 LLVM 库。对 bitcode 里的每个符号,链接器要回答几个问题:这个定义是不是被选中的那一个;它在运行时会不会被别的模块替换掉;除了 bitcode 内部,还有没有别人看得到它。lld 的 --save-temps 会把这些回答写进一个文本文件:
$ link_musl lto main.lto.o util.lto.o --save-temps$ cat lto.resolution.txtmain.lto.o-r=main.lto.o,main,plx-r=main.lto.o,scale,lutil.lto.o-r=util.lto.o,scale,pl-r=util.lto.o,twice,pl-r=util.lto.o,checksum,pl每行是"文件,符号,标志"。llvm-lto2 run --help 对三个字母的解释是:p 是 prevailing,链接器选中了这个定义,同名的其他定义(比如第 3 章的 COMDAT 副本、被强定义压住的弱定义)都要丢弃;l 是 local,这个定义在运行时不会被替换,并且就在这次链接的产物里,对应第 3 章讲可见性时说的"不会被顶替";x 是 externally visible,bitcode 以外还有人看得见它。main 有 x,因为引用它的是 crt1.o,一个普通的 ELF 目标文件。main.lto.o 里的 scale 只是一个引用,没有 p;它带 l,是说这个引用最终配上的定义就在本次链接里,不会跑到共享库去。
twice、checksum 和 util.lto.o 里的 scale 都是 pl,没有 x,这就回答了开头的例子的第二问:它们虽然是全局符号,但除了 bitcode 内部谁也看不到,LTO 后端可以把它们内部化(internalize),也就是改成相当于 C 里的 static,之后有没有人用、要不要保留,就和一个文件内的 static 函数一样由优化器自己决定。LLVM 21.1.8 的 LTO.cpp 里,标了"对外可见"或者带 used 属性的符号会被放进 External 一组,其余符号在 runRegularLTO 里被设成 InternalLinkage。在这之前,LTO::run 还会借助摘要先算一遍存活性,从根出发标记,和第 5 章的 --gc-sections 是同一个思路,只是粒度从节变成了函数和全局变量。--save-temps 留下的几个中间文件正好对应这几步:
$ lslto lto.0.0.preopt.bc lto.0.2.internalize.bc lto.0.4.opt.bc lto.0.5.precodegen.bclto.lto.o lto.resolution.txt main.lto.o util.lto.o$ llvm-dis lto.0.0.preopt.bc -o - | grep -E '^define'define dso_local range(i32 0, 256) i32 @main(i32 noundef %0, ptr noundef readnone captures(none) %1) local_unnamed_addr #0 {define dso_local range(i32 -2147483647, -2147483648) i32 @scale(i32 noundef %0) local_unnamed_addr #1 {$ llvm-dis lto.0.2.internalize.bc -o - | grep -E '^define'define dso_local range(i32 0, 256) i32 @main(i32 noundef %0, ptr noundef readnone captures(none) %1) #0 {define internal range(i32 -2147483647, -2147483648) i32 @scale(i32 noundef %0) #1 {$ llvm-dis lto.0.4.opt.bc -o - | grep -E '^define'define dso_local range(i32 0, 256) i32 @main(i32 noundef %0, ptr noundef readnone captures(none) %1) local_unnamed_addr #0 {$ file lto.lto.olto.lto.o: ELF 64-bit LSB relocatable, x86-64, version 1 (SYSV), not stripped读这段 IR 输出,先看 define 后的函数名和 internal 标记:define 表示函数体在这里有定义,internal 将名字限制在该 IR 模块内。参数属性与 range 等优化提示不是判断本次函数去留的必要条件。
preopt 是两个模块合并之后、优化之前的样子,twice 和 checksum 已经不在了,存活性分析在合并时就把它们挡在了外面。internalize 里 scale 变成 internal,但函数体仍存在;这一步改变可见性,不等于已经删除。opt 是优化之后,scale 内联完才不再有独立定义。最后的 lto.lto.o 是普通的可重定位 ELF 文件,后续才对它进行布局与重定位。
第三步,链接器接收 LTO 生成的本机目标文件,处理其中的定义和引用,再进行布局、重定位、写文件。代码生成也可能新增运行库函数引用,所以“优化前已做符号解析”不表示后面永远不再处理符号;LLVM 的 LTO 设计文档把生成本机代码后的再次符号处理列为协作过程的一部分。这也是开头的例子里 main 的地址从 0x2012d0 挪到 0x201a30 的原因。用 -Map(第 5 章)看,普通链接时 main.o 的 .text 排在 libc 成员前面,LTO 链接时 lto.lto.o:(.text.main) 排在了 libc 的所有成员后面:lld 是在处理完全部输入之后才把 LTO 的产物加进来的。开头的例子的第三问也有了答案。删掉 scale 是安全的,因为链接器确认过没有普通目标文件、没有动态符号表在看它;如果这个判断错了,显式引用可能报 undefined symbol,仅在运行时按名字查找的接口也可能直到运行时才失败。
插件接口与内嵌
lld 是 LLVM 项目的一部分,直接把 LLVM 库链接进自己,bitcode 只是它能识别的一种输入文件。GNU ld 和 gold 通过插件接口与编译器协作:链接器在运行时用 dlopen 加载编译器提供的插件,双方通过一组约定的回调交换信息(GCC wiki: LTO plugin API)。这套接口先在 gold 里实现,ChangeLog 记着 Cary Coutant 在 2008 年 9 月加入了 plugin.cc(gold/ChangeLog-0815);GNU ld 的 plugin.c 是 Dave Korn 在 2010 年 10 月加的(ld/ChangeLog-2010)。交互的顺序是:链接器加载插件后先调用它的 onload,插件借机登记自己的回调;链接器每打开一个输入文件,就调用插件的 claim_file 问"这个文件你要不要",插件认领 LTO 对象,用 add_symbols 报告其中的符号;所有输入读完以后,链接器调用插件的 all_symbols_read,插件通过 get_symbols 取回每个符号的解析结果,运行编译器后端,再用 add_input_file 把生成的目标文件交还链接器。
GCC 的插件叫 liblto_plugin.so,LLVM 的叫 LLVMgold.so。用 GCC 驱动链接时加 -v 能看到它是怎么把插件传给链接器的:
$ gcc -O2 -flto -static main.slim.o util.slim.o -o g_lto -v...collect2 -plugin /usr/libexec/gcc/x86_64-linux-gnu/15/liblto_plugin.so -plugin-opt=/usr/libexec/gcc/x86_64-linux-gnu/15/lto-wrapper -plugin-opt=-fresolution=$TMPDIR/cc-resolution.res -plugin-opt=-pass-through=-lgcc ...$ file /usr/libexec/gcc/x86_64-linux-gnu/15/liblto_plugin.so...liblto_plugin.so: ELF 64-bit LSB shared object, x86-64$ nm g_lto | grep -E ' (main|scale|twice|checksum)$'00000000004016e0 T maincollect210 是 GCC 包在链接器外面的一层,这里最终调用本机 GNU ld 2.46。插件位于 /usr/libexec/gcc/x86_64-linux-gnu/15/liblto_plugin.so,本身也是 x86-64 ELF 共享对象,因为它要被运行中的链接器加载。lto-wrapper 是插件调起的下一个程序,它再去调用 GCC 做 LTO 的那个编译器本体 lto1。结果和 lld 一样,只剩 main。-fresolution 指向的那个文件就是 GCC 版的解析结果,加 -save-temps 可以把它留下来:
$ gcc -O2 -flto -static -save-temps main.slim.o util.slim.o -o g$ cat g.res2main.slim.o 2204 6e2bab631856fa31 PREVAILING_DEF main208 6e2bab631856fa31 RESOLVED_IR scaleutil.slim.o 3202 20956cafc9f8deba PREVAILING_DEF_IRONLY scale204 20956cafc9f8deba PREVAILING_DEF_IRONLY twice209 20956cafc9f8deba PREVAILING_DEF_IRONLY checksumPREVAILING_DEF_IRONLY 是"选中的定义,并且只有 IR 在用",相当于 lld 的 pl 不带 x;main 被 crt1.o 引用,所以是不带 IRONLY 的 PREVAILING_DEF。名字不同,问的是同一件事。同一份 GCC 插件也能交给 gold;本机使用 -fuse-ld=gold 的对照同样只留下 main。/usr/lib/bfd-plugins/ 中可见 liblto_plugin.so 与 LLVMgold-21.so,自动加载插件的能力会影响 ar11、nm12 能否识别 bitcode,所以必须查看实际安装环境。
看中间产物
用 clang 当驱动时写 -Wl,--save-temps(lld 也接受兼容 gold 插件的写法 -plugin-opt=save-temps),用 GCC 当驱动时写 -save-temps,后者会留下 .res 和 GCC 后端输出的汇编。排查只在 LTO 下出现的问题,第一件事通常是看 resolution 文件:一个本该保留的符号如果没有 x(在 GCC 里标成了 IRONLY),优化器删掉它就是合规的。
第 11 章结尾说过,调试信息在 LTO 里还会再出现一次。给开头的例子加上 -g 再编一次,bitcode 里的调试信息只是 IR 元数据,没有任何 .debug_* 节,DWARF13 要等后端生成代码时才写出来(示例):
$ clang -fno-pie -O2 -g -flto -c main.c -o main.o$ clang -fno-pie -O2 -g -flto -c util.c -o util.o$ llvm-dis main.o -o - | grep -E '^!.* = distinct !DICompileUnit|^!.* = distinct !DISubprogram'!0 = distinct !DICompileUnit(language: DW_LANG_C11, file: !1, producer: "Ubuntu clang version 21.1.8 (6ubuntu1)", isOptimized: true, ...)!9 = distinct !DISubprogram(name: "main", scope: !1, file: !1, line: 4, ...)$ link_musl prog main.o util.o --save-temps$ llvm-readelf -SW prog.lto.o | grep -E '\.debug_'[ 6] .debug_abbrev PROGBITS 0000000000000000 000110 0000cd 00 0 0 1 [ 7] .debug_info PROGBITS 0000000000000000 0001dd 0000b4 00 0 0 1 [ 8] .rela.debug_info RELA 0000000000000000 0006a0 000120 18 I 22 7 8 [ 9] .debug_str_offsets PROGBITS 0000000000000000 000291 000040 00 0 0 1 [10] .rela.debug_str_offsets RELA 0000000000000000 0007c0 000150 18 I 22 9 8 [11] .debug_str PROGBITS 0000000000000000 0002d1 000084 01 MS 0 0 1 [12] .debug_addr PROGBITS 0000000000000000 000355 000020 00 0 0 1 [13] .rela.debug_addr RELA 0000000000000000 000910 000048 18 I 22 12 8 [18] .debug_line PROGBITS 0000000000000000 0003f8 0000dd 00 0 0 1 [19] .rela.debug_line RELA 0000000000000000 000970 000090 18 I 22 18 8 [20] .debug_line_str PROGBITS 0000000000000000 0004d5 00002c 01 MS 0 0 1$ llvm-dwarfdump --debug-info prog.lto.o | grep -E 'DW_TAG_(compile_unit|subprogram|inlined_subroutine)|DW_AT_abstract_origin|DW_AT_name\t\("(main|util)\.c"\)|DW_AT_name\t\("(main|scale)"\)'0x0000000c: DW_TAG_compile_unit DW_AT_name ("main.c")0x00000023: DW_TAG_subprogram DW_AT_name ("main")0x0000005e: DW_TAG_inlined_subroutine DW_AT_abstract_origin (0x000000000000009e "scale")0x0000008c: DW_TAG_compile_unit DW_AT_name ("util.c")0x0000009e: DW_TAG_subprogram DW_AT_name ("scale")DICompileUnit、DISubprogram 是 LLVM 用来记录编译单元和函数的元数据节点,到了 prog.lto.o 里才变成 DWARF。合并后的模块仍然保留两个编译单元,main.c 的 main 下面挂着一个 DW_TAG_inlined_subroutine,表示这里内联了一份 scale,它的 DW_AT_abstract_origin 指向 util.c 那个编译单元里的 scale:这是由这次跨文件内联产生的跨编译单元引用;普通分开编译时看不到 scale 的函数体,也就不会为这个调用生成相同的内联记录。
哪些符号必须保留
符号决议给优化提供了边界:哪些定义在 bitcode 之外仍有人使用,哪些引用已经确定绑定到当前定义。只在优化范围内部使用的实体可能被内部化,进而更自由地删除或改变调用方式;内联本身则不一定要求内部化,保留外部定义的同时也可以优化已知调用。判断偏保守,优化就打折扣;判断错了,程序就链接不上,或者链接上了运行时找不到符号。下面几种情况都会改变这个判断。
动态导出与版本脚本
开头的例子生成的是静态可执行文件,没有动态符号表,"bitcode 之外"只剩下普通目标文件。程序一旦是动态链接的,就多了一类看客:运行时加载进来的共享库和 dlopen 打开的插件,它们可能按名字找主程序里的函数。可执行文件的动态符号表(第 7 章的 .dynsym)默认只收录被链接进来的共享库引用到的符号,--export-dynamic 扩大导出集合,把符合导出条件的全局符号放进去;hidden 可见性和其他导出约束仍需遵守(ld 手册:Options 的 --export-dynamic 一项)。
// app.cint plugin_hook(int x) { return x + 100; } // 程序里没人调用int helper(int x) { return x * 2; }
int main(void) { return helper(21); }$ clang -fno-pie -O2 -flto -c app.c -o app.o$ link_musl_dyn app_dyn app.o$ llvm-nm app_dyn | grep -E ' (main|helper|plugin_hook)$'00000000000013d0 T main$ link_musl_dyn app_ed app.o --export-dynamic --save-temps$ cat app_ed.resolution.txtapp.o-r=app.o,plugin_hook,plx-r=app.o,helper,plx-r=app.o,main,plx$ llvm-nm -D --defined-only app_ed0000000000001509 T _fini0000000000001506 T _init0000000000001490 T _start00000000000014b0 T _start_c00000000000014f0 T helper0000000000001500 T main00000000000014e0 T plugin_hooklink_musl_dyn 链接的是动态链接 musl14 的 PIE15。不加 --export-dynamic 时,plugin_hook 和 helper 都没有 x,一个被删,一个内联完也被删。加上以后,链接器知道它们会出现在动态符号表里,三个符号全部带上 x,优化器只能留着。helper 仍然被内联进了 main,但它自己的定义也必须保留,因为外面可能有人通过动态符号表调用它。所以一个用 -flto 编译、却又带着 --export-dynamic(或者 -rdynamic)的程序,LTO 能删掉的东西会少很多。
共享库是同一个问题的反面。-shared 的默认行为是导出所有默认可见性的符号,这对 LTO 来说等于"全部有人看"。版本脚本(第 7 章)的 local: * 能把不在名单里的符号收回来:
$ cat lib.map{ global: api_get; local: *; };$ clang -fno-pie -O2 -fPIC -flto -c lib.c -o lib.o$ ld.lld -shared lib.o -o lib_all.so$ llvm-nm -D --defined-only lib_all.so00000000000012c0 T api_get00000000000012d0 T impl_detail$ ld.lld -shared --version-script=lib.map lib.o -o lib_map.so$ llvm-nm -D --defined-only lib_map.so0000000000001280 T api_get$ llvm-nm lib_map.so | grep -E 'api_get|impl_detail'0000000000001280 T api_get没有 LTO 的时候,local: * 只是把 impl_detail 从动态符号表里拿掉,代码还在;有了 LTO,链接器在符号解析阶段就已经知道 impl_detail 不会被导出,告诉了后端,后端把它内部化,没人调用就删了,连 .symtab 里都找不到。第 3 章的 hidden 可见性有类似的效果,而且编译阶段就生效。
内联汇编里的符号
LLVM 不解析函数体里的内联汇编字符串。编译器眼里,asm volatile("call helper2") 就是一段不透明的文本,它不知道这段文本引用了 helper2:
// asm_main.c:只在内联汇编里调用 helper2int main(void) { int r; __asm__ volatile("call helper2" : "=a"(r) : : "rdi", "rsi", "rdx", "rcx", "r8", "r9", "r10", "r11", "memory"); return r;}// asm_util.cint helper2(void) { return 7; }$ link_musl asm_plain asm_main.o asm_util.o # 不开 LTO$ link_musl asm_lto asm_main.lto.o asm_util.lto.o --save-tempsld.lld: error: undefined symbol: helper2>>> referenced by ld-temp.o>>> asm_lto.lto.o:(main)$ cat asm_lto.resolution.txtasm_main.lto.o-r=asm_main.lto.o,main,plxasm_util.lto.o-r=asm_util.lto.o,helper2,pl不开 LTO 时,asm_main.o 由汇编器生成,汇编器读懂了 call helper2,在 ELF 符号表里留下一个未定义的 helper2,链接毫无问题,运行退出码是 7。开了 LTO,asm_main.lto.o 的符号表里根本没有 helper2,helper2 只有 pl,被内部化后删掉。等 LTO 后端生成机器码,汇编器终于在 lto.lto.o 里看到了 call helper2,这时定义已经没了,于是报告"引用来自 ld-temp.o"。ld-temp.o 是 lld 给 LTO 合并模块起的名字,看到它就知道问题出在 LTO 里面。
这里的 helper2 只返回整数,例子用于观察符号引用何时进入链接器。把普通函数调用藏在内联汇编字符串里,还会绕过编译器对调用约定的处理:栈对齐、寄存器破坏和 red zone 等条件都需要另行满足。实际代码应优先使用 C 调用,或把汇编封装在独立汇编文件中,通过明确的函数接口与 C 连接;保留一个符号并不能自动修复这些调用约定问题。
文件级的汇编,也就是写在函数外面的 __asm__(...),处理方式不同。LLVM 构建 bitcode 符号表时会把它交给汇编器的解析器过一遍,收集其中定义和引用的符号:
// toplevel.c:文件级的汇编里定义一个函数__asm__(".text\n.globl asm_seven\n.type asm_seven,@function\nasm_seven:\n movl $7, %eax\n ret\n");$ llvm-nm toplevel.lto.o---------------- T asm_seven$ link_musl top top_main.lto.o toplevel.lto.o && llvm-nm top | grep -E ' (main|asm_seven)$'00000000002019ec T asm_seven0000000000201a00 T main函数体里的内联汇编则只有等到 LTO 后端生成代码时才被汇编器读到,那时符号解析早已结束。
__attribute__((used))
修好上面那个错误,最直接的办法是告诉编译器"这个函数有人用,只是你看不出来":
// asm_util_used.c__attribute__((used)) int helper2(void) { return 7; }$ link_musl asm_used asm_main.lto.o asm_util_used.lto.o && llvm-nm asm_used | grep -E ' (main|helper2)$'0000000000201a00 T helper200000000002019f0 T mainused 在 IR 里对应把这个函数放进 @llvm.used 列表。LTO.cpp 判断符号归属时,带 used 的符号和 x 一样被归到 External 一组,不参与内部化,名字也保留下来,汇编里的 call helper2 就能配上。Linux 上直接运行退出码是 7。used 只管编译器和 LTO 这一层:第 5 章的 --gc-sections 是另一回事,要让链接器的 GC16 也留下它,在 ELF 上对应的是 retain 属性(SHF_GNU_RETAIN)或者链接器脚本里的 KEEP。
静态库里的 bitcode 成员
归档工具和链接器是两个独立的读取者。一个示例把 LLVM bitcode 的 mul3.o、other.o 分别交给 GNU ar 和 llvm-ar。
ar rcs libm3_gnu.a mul3.o other.ollvm-ar rcs libm3_llvm.a mul3.o other.onm -s libm3_gnu.allvm-nm --print-armap libm3_llvm.a本机安装了 LLVM 的 BFD 插件,两份归档都包含 mul3 和 other 的索引。不能把“GNU ar 永远读不懂 LLVM bitcode”当成规则;是否有插件会改变结果。LLD17 链接两份库都成功,并将 mul3 内联,最终只剩 main。它的解析记录显示,按需使用的是 mul3.o,other.o 没有成为最终定义来源。
把这两份库交给默认的 gcc -static,本次都报 file format not recognized。建立归档索引成功,不代表 GCC 驱动所选择的链接流程就能处理 LLVM IR。这里应使用与 bitcode 配套的 Clang/LLD,或者明确配置匹配的 LLVM LTO 插件。
GCC slim 对象是另一种情况:
$ ar rcs libm3_slim.a mul3.gcc.o other.gcc.o$ nm -s libm3_slim.aArchive index:mul3 in mul3.gcc.oother in other.gcc.o$ readelf -sW mul3.gcc.o | tail -1 2: 0000000000000001 1 OBJECT GLOBAL DEFAULT COM __gnu_lto_slimGNU ar 的 GCC 插件能读懂 GIMPLE,索引里有 mul3;LLD 却不运行 GCC 的优化器,它直接检查成员的 ELF 符号表,只看到 __gnu_lto_slim,结果仍是 undefined symbol: mul3。修法有两种:库作者用 -ffat-lto-objects 保留机器码,让 LLD 退回普通链接;或者用配套的 gcc -flto 驱动 GCC 插件。前者的 mul3 留作普通函数,后者将它内联。带两个命令行参数执行,相关成功构建的程序返回码都为 9。
这些实验区分了三层能力:归档有没有索引,工具能否读出某种 IR 的符号,以及最终链接流程能否把该 IR 生成机器码。
ThinLTO:把全程序优化拆开
开头的例子里的做法叫 full LTO(完整 LTO):所有 bitcode 模块合并成一个大模块,在它上面跑一遍优化器和代码生成器。程序一大,问题就来了。合并后的模块要整个放在内存里,本例默认完整 LTO 路径的全局优化成为集中阶段,改动一个参与其中的文件往往会使这一大块工作重做。其他实现可以采用分区或并行代码生成,不能把 full LTO 等同于所有阶段永远只有一个线程。
ThinLTO 是 Teresa Johnson 等人在 LLVM 里实现的另一种做法,论文发表在 CGO 2017(Johnson, Amini, Li: ThinLTO: Scalable and Incremental LTO,用法见 Clang ThinLTO 文档)。它的关键是摘要(summary):编译每个文件时,除了 IR,再写一份很小的描述,记下这个模块定义了哪些函数和变量、每个函数有多少条指令、调用了谁、引用了谁。前面检查 bitcode 时 bcanalyzer 列出的 GLOBALVAL_SUMMARY_BLOCK 就是它,用 -flto=thin 编译时,每个函数在里面占一条 PERMODULE_PROFILE 记录:
$ clang -fno-pie -O2 -flto=thin -c main.c -o main.thin.o$ clang -fno-pie -O2 -flto=thin -c util.c -o util.thin.o$ llvm-bcanalyzer -dump main.thin.o | sed -n '/<GLOBALVAL_SUMMARY_BLOCK/,/<\/GLOBALVAL_SUMMARY_BLOCK/p' <GLOBALVAL_SUMMARY_BLOCK NumWords=22 BlockCodeSize=4> <VERSION op0=12/> <FLAGS op0=0/> <PERMODULE_PROFILE abbrevid=5 op0=0 op1=64 op2=11 op3=64 op4=0 op5=0 op6=0 op7=1 op8=8/> </GLOBALVAL_SUMMARY_BLOCK>链接时分两段。第一段叫 thin link,链接器做完符号解析以后,只把所有模块的摘要读进来,合成一份全局索引,在索引上做全程序分析:哪些函数活着,哪些可以内部化,每个模块应该从别的模块导入(import)哪些函数的函数体以便内联。这一段是串行的,但只碰摘要,数据量很小。--save-temps 会把索引存成 thin.index.bc,再附一份 Graphviz 格式的 thin.index.dot:
$ link_musl thin main.thin.o util.thin.o --save-temps$ cat thin.index.dot ... M0_15822663052811949562 [shape="record",label="main|extern (inst: 11, ffl: 0000001000)}"]; // function, dsoLocal, definition, preserved ... M1_2563497542905672716 [shape="record",label="scale|extern (inst: 3, ffl: 1010001000)}"]; // function, dsoLocal, definition M1_12741001430464225570 [shape="record",label="checksum|extern (inst: 16, ffl: 0110001000)}",fillcolor="red"]; // function, dsoLocal, definition, dead M1_13517681653245979564 [shape="record",label="twice|extern (inst: 2, ffl: 1010001000)}",fillcolor="red"]; // function, dsoLocal, definition, dead ... // Cross-module edges: M0_15822663052811949562 -> M1_2563497542905672716 // call (hotness : Unknown)main 有 11 条指令,被标为 preserved(链接器说它对外可见);scale 只有 3 条;twice 和 checksum 被标成 dead。节点名里的长数字是 GUID,由符号名算出的 64 位哈希,索引里用它代替名字。唯一一条跨模块的边是 main 调用 scale。scale 足够小,thin link 决定让 main.thin.o 导入它。
第二段是后端,每个模块各自优化、各自生成代码,彼此独立,可以开多个线程并行跑。导入的函数以 available_externally 的形式出现在调用方的模块里,意思是"函数体给你内联用,定义在别的模块,不要为它生成代码":
$ llvm-dis main.thin.o.3.import.bc -o - | grep -E '^define'define dso_local range(i32 0, 256) i32 @main(...) local_unnamed_addr #0 {define available_externally dso_local range(i32 -2147483647, -2147483648) i32 @scale(...) local_unnamed_addr #1 {$ llvm-dis util.thin.o.2.internalize.bc -o - | grep -E '^define'define dso_local range(i32 -2147483647, -2147483648) i32 @scale(...) local_unnamed_addr #0 {$ llvm-nm thin | grep -E ' (main|scale|twice|checksum)$'0000000000201a30 T main0000000000201ad0 T scale和 full LTO 对照,这里多出了一个 scale。main 照样内联了它,但 util.thin.o 的后端是独立运行的,它只知道 scale 被别的模块导入过,必须把原来的定义留着,以防导入方最后没有内联、还要调用它。这是"每个模块单独处理"要付的代价之一:全局视野只在摘要那一层,后端看不到别的模块最终做了什么。
后端彼此独立,还让缓存成为可能。每个后端任务的输入是确定的,包括本模块的 IR、导入的函数、解析结果和编译选项,把它们一起算一个哈希,作为缓存的键,下次链接时键没变,就直接取出上次生成的目标文件。lld 用 --thinlto-cache-dir=目录 打开这个缓存(clang -Wl,--thinlto-cache-dir=…),缓存的淘汰策略由 --thinlto-cache-policy 控制。
并行与缓存分别减少什么工作
LTO 将一部分优化和机器码生成推迟到了链接阶段,所以“链接耗时”已经包含两类工作:编译器的后端处理,以及链接器的布局、重定位和文件写出。普通链接只包含后者。仅比较链接时间,不能直接推断整个构建过程的成本。
ThinLTO 的并行性来自模块后端之间的独立性。摘要分析先确定导入关系与全局约束,各模块随后可以同时优化、生成代码;最终仍需链接生成的对象。增加并发主要缩短后端阶段,无法消除摘要分析和常规链接的工作,也不能让较慢模块的耗时归零。串行运行时,每个模块分别启动后端的成本仍然存在,因此 ThinLTO 并不必然比 full LTO 更快。
缓存解决的是另一件事:避免重复执行输入没有变化的后端任务。未修改的模块只有在本身的 IR、导入内容、解析结果和相关选项仍满足缓存键时才能复用;修改一个函数,也可能影响导入它的其他模块。因而缓存收益取决于依赖关系,不能简单等同于“只重新处理改过的源文件”。ThinLTO 文档将并行后端与增量缓存作为两种独立机制介绍。
Lua 5.4.7 提供了一个具体对照:除 luac.c 外共 33 个 C 文件,约 2.4 万行。使用 Clang/LLD 21.1.8 与 musl 构建,只记录链接阶段,每种模式取五次样本。单位为秒:
| 模式 | 五次链接耗时 |
|---|---|
| 不开 LTO | 0.0790、0.0625、0.0791、0.0689、0.0751 |
| full LTO | 5.6501、5.4255、5.5877、5.4128、5.2574 |
| ThinLTO,1 个后端任务 | 7.9491、7.8608、8.0087、8.2340、8.1808 |
| ThinLTO,默认并行 | 4.0241、4.3280、4.1268、4.1030、4.1526 |
串行 ThinLTO 的耗时中位数为 8.0087 秒,默认并行时为 4.1268 秒;full LTO 为 5.4255 秒。这个对照体现的是并行后端减少等待的作用,并未建立各模式之间固定的速度关系。
缓存实验第一次链接为 4.2566 秒,重复两次为 0.0743、0.0651 秒;修改一个 lcorolib.c 实现细节并重新编译后为 0.2210 秒。缓存文件数由 34 变成 35,旧条目仍在,其他模块的结果可以复用。这里节省的是重复的后端工作,与第一次构建中的并行加速属于不同机制。
text data bss dec hex filename 350224 1152 5360 356736 57180 lua-none 412705 1160 4280 418145 66161 lua-full 436170 1160 5432 442762 6c18a lua-thin两种 LTO 的 text 比普通版本分别大约增加 18% 和 25%;内联、复制和其他优化使体积变化不能只凭选项名预测。三个产物直接在 Linux 上执行同一段 Lua 循环,均输出 Lua 5.4 89999997。脚本还用 GNU /usr/bin/time -f 'max_rss_kib=%M' 单独记录链接进程的最大常驻内存:不开 LTO 67152 KiB,full LTO 112648 KiB,ThinLTO 单任务 91972 KiB、两任务 98140 KiB、默认并行 97996 KiB。并行任务会同时持有多个模块,内存与耗时应一起比较;这些数值是该主机上另一轮内存测量,不与前面的计时样本混作同一次运行。
ICF:内容相同的函数只留一份
LTO 在函数内部动刀,链接器自己也有一种不需要编译器参与的优化:ICF(Identical Code Folding,相同代码折叠),把内容完全相同的函数合并成一份。C++ 模板是常见的来源,std::vector<int*> 和 std::vector<long*> 的很多成员函数生成的机器码一模一样,只是名字不同。第 3 章的 COMDAT 按名字去重,管不到这种名字不同、内容相同的情况。
这里的 ELF ICF 以输入节为折叠单位。用 -ffunction-sections 让函数单独占节,才能逐个函数判断和合并;多个函数已经挤在同一节中时,不能凭这个选项把其中一个单独折走。lld 折叠的对象不限于代码,ICF.cpp 的 isEligible 会考虑符合条件的可分配、不可写节,随后还要排除地址身份或运行时记录不允许合并的情况;.rodata 里的常量、.gcc_except_table 里的异常表都在其中,.data.rel.ro 虽然带写标志也算(它在重定位完成后就是只读的)。本章先看代码节。
// icf.cint add_i(int a, int b) { return a + b; }int add_j(int a, int b) { return a + b; }int (*pick(void))(int, int) { return add_j; }$ clang -fno-pie -O2 -ffunction-sections -c icf.c -o icf.o$ llvm-objdump -d icf.oicf.o: file format elf64-x86-64
Disassembly of section .text.add_i:
0000000000000000 <add_i>: 0: 8d 04 37 leal (%rdi,%rsi), %eax 3: c3 retq
Disassembly of section .text.add_j:
0000000000000000 <add_j>: 0: 8d 04 37 leal (%rdi,%rsi), %eax 3: c3 retq
Disassembly of section .text.pick:
0000000000000000 <pick>: 0: b8 00 00 00 00 movl $0x0, %eax 5: c3 retq$ ld.lld -e pick --icf=all --print-icf-sections icf.o -o icf_allselected section icf.o:(.text.add_i) removing identical section icf.o:(.text.add_j)$ nm icf_all | grep -E 'add_|pick'0000000000201170 T add_i0000000000201170 T add_j0000000000201180 T pick.text.add_i 和 .text.add_j 逐字节相同,--icf=all 只留下前者,两个符号落在同一个地址 0x201170。-e pick 指定入口,只是为了不带 libc 也能得到一个可执行文件,看符号地址。
比字节不够
判断两个节相同,只比字节是不够的。第 4 章说过,尚待重定位的位置可能带有相同的占位字节或加数,两个函数逐字节相同,调用的却可能是两个不同的函数。折叠还要比较重定位字段的位置、类型和目标值,并判断所引用的节是否也能折叠。先看引用偏移与加数都相同的情况:目标节等价,调用者才可能等价。这个关系是递归的,于是有了下面这种例子:
// chain.c:字节相同,调用的对象不同int g1(int x) { return x * 5 + 1; }int g2(int x) { return x * 5 + 1; } // 与 g1 相同int g3(int x) { return x * 7 + 1; } // 与 g1 不同int f1(int x) { return g1(x) + 2; }int f2(int x) { return g2(x) + 2; }int f3(int x) { return g3(x) + 2; }int main(int argc, char **argv) { return f1(argc) + f2(argc) + f3(argc); }$ clang -fno-pie -O2 -ffunction-sections -fno-inline -c chain.c -o chain.o$ llvm-readelf -r chain.o | grep -E 'Relocation section|g[123]'Relocation section '.rela.text.f1' at offset 0x340 contains 1 entries:0000000000000002 0000000900000004 R_X86_64_PLT32 0000000000000000 g1 - 4Relocation section '.rela.text.f2' at offset 0x358 contains 1 entries:0000000000000002 0000000a00000004 R_X86_64_PLT32 0000000000000000 g2 - 4Relocation section '.rela.text.f3' at offset 0x370 contains 1 entries:0000000000000002 0000000b00000004 R_X86_64_PLT32 0000000000000000 g3 - 4Relocation section '.rela.text.main' at offset 0x388 contains 3 entries:Relocation section '.rela.eh_frame' at offset 0x3d0 contains 7 entries:0000000000000020 0000000200000002 R_X86_64_PC32 0000000000000000 .text.g1 + 00000000000000034 0000000300000002 R_X86_64_PC32 0000000000000000 .text.g2 + 00000000000000048 0000000400000002 R_X86_64_PC32 0000000000000000 .text.g3 + 0$ link_musl chain chain.o --icf=all --print-icf-sections 2>&1 | grep -A1 'chain.o:(.text.[fg]'selected section chain.o:(.text.f1) removing identical section chain.o:(.text.f2)selected section chain.o:(.text.g1) removing identical section chain.o:(.text.g2)$ llvm-nm chain | grep -E ' [fg][123]$' | sort00000000002012d0 T g100000000002012d0 T g200000000002012e0 T g300000000002012f0 T f100000000002012f0 T f20000000000201300 T f3f1、f2、f3 三个节的字节完全相同,都是 push、call 0、add $2,区别只在重定位指向谁。g1 和 g2 相同,所以 f1 和 f2 也相同;g3 不同,f3 就留了下来。运行退出码是 26,等于 8 + 8 + 10,结果没变。
为什么要反复细分
直接要求目标节编号相同,会漏掉 f1 与 f2:它们分别引用 g1 和 g2,编号不同,但最终可以共享同一份内容。反过来,只比较调用者的字节,又会错误地把 f3 合进来。需要比较的是目标所属的等价类。
等价类就是“目前尚未发现不能合并的这一组节”。先按内容与重定位的固定部分分组,再用目标所属的组细分;组只拆分、不重新合并,直到一次检查不再拆出新组。哈希可以加速寻找候选,但哈希相同后仍要精确比较,不能以碰撞概率很低代替正确性。
增加一层调用,更容易看出为什么一轮不够。设六个代码节形成两条链 f1 → g1 → h1、f2 → g2 → h2。四个调用者的原始字节相同,各有一条位置、类型、加数和目标节内偏移都相同的重定位;两个叶子 h1、h2 的字节不同。它们都已通过折叠资格检查。下面按“每轮读取上一轮分组”演算:
| 阶段 | 仍可能合并的组 | 分开的原因 |
|---|---|---|
| 初始 | {f1,f2,g1,g2}、{h1}、{h2} | 叶子的字节不同,先分开 |
| 第 1 轮 | {f1,f2}、{g1}、{g2}、两个叶子单独成组 | g1、g2 引用不同叶子;f1、f2 的目标在上一轮仍同组 |
| 第 2 轮 | 六个节各自成组 | g1、g2 已分开,这个区别传播到 f1、f2 |
| 第 3 轮 | 分组不变,停止 | 每组成员的目标关系已经一致 |
实际实现可以更早利用本轮刚得到的拆分,因此轮数不必相同;最终分组必须符合相同的关系。终止的理由是有限个节只能被拆成有限个非空组。循环引用也不要求递归遍历到一个叶子才开始判断:若两个互相调用的节具有相同内容,并且每个引用都仍指向同一个等价类,这组关系可以保持不变。算法寻找的是满足约束的最大等价关系,而不是必须证明两段任意程序在所有输入上都相等。
LLD 21.1.8 的 ICF 实现采用这种乐观细分,另以目标哈希传播减少精确比较的工作量。资格检查与等价比较分开:不可写性、地址身份、动态符号绑定等约束,不能仅由字节相同推出。
比较目标值时,还要记住加数属于地址计算。对同一目标节,st_value=4、A=-4 与 st_value=0、A=0 可以得到同一个有效节内位置;LLD 的相应比较会考虑 st_value + A。因此“符号名字不同”或“加数不同”都不自动等于结果不同。是否允许这样的归一化,取决于重定位类型与实现的支持规则;可能被动态插入的两个不同符号更不能仅凭当前定义相同而合并。
函数指针还相等吗
折叠以后 add_i 和 add_j 的地址相同,这在 C 语言里是可以观察到的。C11 标准 6.5.9 节第 6 段规定,两个函数指针相等,当且仅当它们指向同一个函数(N1570,C11 的最后一版委员会草案);add_i 和 add_j 是两个不同的函数,比较结果必须为假。写一个能运行的版本:
// ptr.c:折叠以后,两个不同函数的地址还不相等吗?int add_i(int a, int b);int (*pick(void))(int, int);
int main(void) { int (*p)(int, int) = pick(); // pick 返回 add_j return (p == add_i) * 10 + p(1, 2); // 不折叠应得 3}$ link_musl ptr_none icf.o ptr.o$ link_musl ptr_safe icf.o ptr.o --icf=safe$ link_musl ptr_all icf.o ptr.o --icf=all$ for p in ptr_none ptr_safe ptr_all; do ./$p; echo "$p=$?"; doneptr_none=3ptr_safe=3ptr_all=13--icf=all 下比较结果从假变成了真,退出码多出来的 10 就是 p == add_i 的那个 1。这是 --icf=all 接受的代价,它假设程序不依赖函数地址各不相同。程序里只要有一处依赖了,比如用函数指针当哈希表的键、用来区分回调的种类,行为就可能变,而编译器和链接器都不会提示。
--icf=safe 不折叠地址"有意义"的函数。链接器怎么知道哪些地址区别可能被程序观察到?第 2 章见过的 .llvm_addrsig 节就是为此准备的,它是 clang 默认生成的(选项 -faddrsig),内容是一串 ULEB12818,每个数是一个地址身份显著的符号在符号表里的下标:例如地址参与比较,或传出了编译器能完整分析的范围。仅发生过取地址,不必然意味着函数地址必须保持独一无二(LLVM Extensions 的 SHT_LLVM_ADDRSIG 一节):
$ llvm-objdump -s -j .llvm_addrsig icf.oContents of section .llvm_addrsig: 0000 06 .$ readelf -sW icf.oSymbol table '.symtab' contains 8 entries: Num: Value Size Type Bind Vis Ndx Name 0: 0000000000000000 0 NOTYPE LOCAL DEFAULT UND 1: 0000000000000000 0 FILE LOCAL DEFAULT ABS icf.c 2: 0000000000000000 0 SECTION LOCAL DEFAULT 3 .text.add_i 3: 0000000000000000 0 SECTION LOCAL DEFAULT 4 .text.add_j 4: 0000000000000000 0 SECTION LOCAL DEFAULT 5 .text.pick 5: 0000000000000000 4 FUNC GLOBAL DEFAULT 3 add_i 6: 0000000000000000 4 FUNC GLOBAL DEFAULT 4 add_j 7: 0000000000000000 6 FUNC GLOBAL DEFAULT 5 pick$ ld.lld -e pick --icf=safe --print-icf-sections icf.o -o icf_safe$ nm icf_safe | grep -E 'add_|pick'0000000000201180 T add_i0000000000201190 T add_j00000000002011a0 T pick只有一个字节 06,第 6 号符号是 add_j,pick 取过它的地址。lld 读到它,就把 add_j 所在的节标成"必须独占一个地址"(源码里是 keepUnique),isEligible 直接把它排除在 ICF 之外,add_i 再没有可以合并的对象,--print-icf-sections 什么也没打印。ptr.c 编出的 ptr.o 又把 add_i 记进了自己的地址表,链接两者时两边都受保护,ptr_safe 的退出码仍是 3。
如果一个目标文件没有这个节,比如 GCC 编译的,或者 clang 加了 -fno-addrsig,lld 只能把这个文件里的所有符号都当成取过地址,--icf=safe 对它什么也不做。Driver.cpp 的注释原话是 "If an object file does not have an address-significance table, conservatively mark all of its symbols as address-significant"。缺表对象中的未定义符号也可能指向其他对象里的定义,这些引用会让实际定义同样需要保守保护;不能只排除缺表文件自己的代码节,却继续折叠它可能观察地址的外部函数。同一段代码还说明了两件事:动态符号表里导出的符号一律当作取过地址,因为别的模块可能比较它;--icf=all 也照样读地址表,只是只对不可执行的节生效。safe 和 all 在只读数据上的区别就在这里:地址表里列出的常量,两种模式都不合并;地址表没提到的常量和异常表,两种模式都会合并。示例中的 C++ 模板程序 tmpl.o 上,lld 在 safe 和 all 两种模式下都折叠了 8 个 .gcc_except_table.* 节,再加上代码节,才是 --print-icf-sections 的完整输出;该独立候选识别器只处理代码节,对拍时只比以 .text. 开头的节。
代码相同,展开规则也必须兼容
ICF 让多个输入函数共享一个输出地址范围。此时,运行时展开器面对某个 PC,必须得到适用于这份代码的恢复规则。两个输入节即使有相同指令和引用,也不能仅凭这个事实选择任意一份 FDE:原理篇 08中的 CFA 规则、寄存器恢复方式,以及异常处理所需的信息,都可能不同。
比较记录时又不能直接比较所有原始字节。FDE 的 CIE 指针依赖记录之间的距离,初始位置依赖代码和字段的位置;两份相同描述放在不同输入位置时,这些数字可以不同。它们表达的是“这条记录连接到哪里”,不是“怎样恢复调用者”。因此,要把位置差异和描述差异分开。
考虑一个明确受限的模型:32 位记录长度,初始位置为四字节 PC-relative 编码,地址范围占四字节,不含 personality 和 LSDA。对于从 FDE 起点计算的字段:
| FDE 内范围 | 保存什么 | 比较时如何处理 |
|---|---|---|
[0,4) | 记录长度 | 保留;决定记录边界 |
[4,8) | 回指 CIE 的距离 | 单独找到实际 CIE;距离本身可归一化 |
[8,12) | 初始代码位置的相对值 | 单独解析它描述的输入代码位置;编码值可归一化 |
[12,16) | 覆盖的代码范围长度 | 保留;覆盖范围必须兼容 |
| 后续字节 | augmentation、CFI 指令、填充 | 保留并比较;不能仅因代码相同而忽略 |
在这个模型中,可把 FDE 的 [4,12) 清零用于比较,同时另存它描述的代码节内起点,并比较实际 CIE 的内容。两个函数各从节内偏移 0 开始,拥有相同 CIE、覆盖长度和 CFI 时,不会仅因两条记录的距离不同而被判为不兼容。若一个描述使用 CFA = rsp + 8,另一个使用 CFA = rsp + 16,它们的恢复规则不同,便不能沿用一份记录代表两者。没有 FDE 的函数也不能自动视为与有 FDE 的函数展开等价。
这种精确字节比较是一种保守关系:两种不同编码可能描述相同行为,但实现可以选择不折叠。相反,遇到模型以外的 pointer encoding、personality 或 LSDA,应解释其语义后再建立兼容关系,或保守拒绝折叠;不能先删掉未知信息,再宣称比较通过。安全 ICF 的资格检查、引用等价和展开兼容性是共同成立的条件。
折叠完成后,布局只保留代表代码,引用与符号入口重定向到代表;展开表重建为适用于保留代码的记录。调试记录则还要表达哪些源级函数失去了独立地址,见原理篇 11。输入比较、输出布局和元数据重建是三个不同步骤,不能只验证最终代码变小。
gold 与 GNU ld
GNU 工具链里,ICF 是 gold 带来的,lld 的 --icf=all、--icf=safe 沿用了它的选项名。Google 的 Sriraman Tallam 等人 2010 年的论文《Safe ICF: Pointer Safe and Unwinding Aware Identical Code Folding in the Gold Linker》(PDF)描述了它的安全模式。那时还没有 .llvm_addrsig,gold 的办法是看重定位类型:call 指令用的重定位只表示调用,取地址用的是另一类重定位,一个函数如果只被前一类引用过,它的地址就没有被拿去比较的机会。这种判断要每个架构的后端各自实现(do_can_check_for_function_pointers,binutils 2.40 里 SPARC 和 MIPS 没有实现),没实现的架构上 safe 模式只折叠 C++ 的构造和析构函数,因为 C++ 不允许取它们的地址(gold/icf.cc 的 is_function_ctor_or_dtor,gold/options.h 对 safe 的说明是 "Folds ctors, dtors and functions whose pointers are definitely not taken")。论文标题的后半句"unwinding aware"说的是第 8 章的内容:两个函数合并后只剩一份代码,它的 .eh_frame 记录必须对两个函数都成立。lld 在这一点上直接放弃折叠,ICF::run 开头的注释写着:"Two text sections may have identical content and relocations but different LSDA19, e.g. the two functions may have catch blocks of different types",所以被带 LSDA(第 8 章讲过的语言相关数据区,.gcc_except_table 里那份记录 catch 类型和清理动作的表)的 FDE20 引用的代码节,一律不参与折叠。
在同一台 Linux 上用 GCC 15.2 和发行版提供的 GNU gold 重复 ptr.c 的实验:
$ gcc -O2 -ffunction-sections -c icf.c -o icf_gcc.o$ gcc -O2 -ffunction-sections -c ptr.c -o ptr_gcc.o$ gcc -fuse-ld=gold -Wl,--icf=all -Wl,--print-icf-sections icf_gcc.o ptr_gcc.o -o gptr_all/usr/bin/ld.gold: ICF Converged after 2 iteration(s)/usr/bin/ld.gold: ICF folding section '.text.add_i' in file 'icf_gcc.o' into '.text.add_j' in file 'icf_gcc.o'$ gcc -fuse-ld=gold -Wl,--icf=safe -Wl,--print-icf-sections icf_gcc.o ptr_gcc.o -o gptr_safe/usr/bin/ld.gold: ICF Converged after 1 iteration(s)$ ./gptr_all; echo "gptr_all=$?"gptr_all=13$ ./gptr_safe; echo "gptr_safe=$?"gptr_safe=3$ gcc -fuse-ld=bfd -Wl,--icf=all icf_gcc.o ptr_gcc.o -o gptr_bfd/usr/bin/ld.bfd: unrecognized option '--icf=all'/usr/bin/ld.bfd: use the --help option for usage informationcollect2: error: ld returned 1 exit status结果和 lld 一致,只是 gold 保留的是 add_j,把 add_i 折了进去,选谁留下没有规定。这组目标文件由 GCC 生成,没有 .llvm_addrsig,gold 的 safe 模式靠 x86-64 的重定位类型认出了 pick 和 main 都取过地址,于是什么也没折叠。GNU ld(BFD)没有 ICF,直接拒绝这个选项。gold 本身也在退场,binutils 2.44 已经弃用了它(第 1 章),新项目要用 ICF,实际的选择是 lld 和 mold。
调试信息指向谁
第 11 章讲墓碑值时提过,ICF 还有一处要留到这一章。把 icf.c 加上 -g 再折叠一次:
$ clang -fno-pie -O2 -g -ffunction-sections -c icf.c -o icf_g.o$ ld.lld -e pick --icf=all icf_g.o -o icf_g_all$ llvm-dwarfdump --debug-info icf_g_all | grep -E 'DW_AT_(name|low_pc)' DW_AT_name ("icf.c") DW_AT_low_pc (0x0000000000000000) DW_AT_low_pc (0x0000000000201170) DW_AT_name ("add_i") ... DW_AT_low_pc (0x0000000000000000) DW_AT_name ("add_j") ... DW_AT_low_pc (0x0000000000201180) DW_AT_name ("pick")$ llvm-dwarfdump --debug-addr icf_g_allicf_g_all: file format elf64-x86-64
.debug_addr contents:Address table header: length = 0x0000001c, format = DWARF32, version = 0x0005, addr_size = 0x08, seg_size = 0x00Addrs: [0x00000000002011700x00000000000000000x0000000000201180]$ llvm-dwarfdump --debug-line icf_g_all | sed -n '/^Address/,$p'Address Line Column File ISA Discriminator OpIndex Flags------------------ ------ ------ ------ --- ------------- ------- -------------0x0000000000201170 2 36 0 0 0 0 is_stmt prologue_end0x0000000000201173 2 27 0 0 0 00x0000000000201174 2 27 0 0 0 0 end_sequence0x0000000000201170 3 36 0 0 0 0 is_stmt prologue_end0x0000000000201173 3 27 0 0 0 00x0000000000201174 3 27 0 0 0 0 end_sequence0x0000000000201180 4 31 0 0 0 0 is_stmt prologue_end0x0000000000201186 4 31 0 0 0 0 is_stmt end_sequence被折叠的 add_j 在 .debug_info 和 .debug_addr 里的起始地址都填成了墓碑值 0,.debug_line 里它的序列(第 3 行)却指向留下的那份代码 0x201170,和 add_i 的序列重叠,这是 InputSection.cpp 的 relocateNonAlloc 有意为之,注释说把 .debug_line 也填成墓碑"would stop debugger users from setting breakpoints on the folded-in function"。代价是反查时说不清:llvm-symbolizer --obj=icf_g_all 0x201170 给出的函数名是 add_j,行号却是 add_i 所在的 icf.c:2:36。
节顺序与性能
LTO 可以改变生成的指令,ICF 可以让等价节共用一份存储。还有一种变化不需要改变函数的实现:调整函数的放置顺序。机器执行相同的指令序列,访问的缓存行和页面却可能不同。MIT 的性能工程课在讨论测量误差时,以代码对齐和目标文件顺序说明这种影响:看似无关的布局变化,也可能改变性能测量结果。这里需要解释的机制是代码局部性,而不是某个固定的提速比例。6.172 讲义
排列影响性能,主要通过两层硬件。第一层是指令缓存(icache):CPU 取指令以缓存行为单位,常见的行大小是 64 字节,一个 24 字节的热函数如果和两个冷函数挤在同一行,那一行里大半是用不上的字节。第二层是页和 iTLB:第 5 章讲过,内存按页(常见 4 KiB)映射,CPU 用 TLB(translation lookaside buffer,缓存"虚拟页对应哪个物理页"的小表)加速地址翻译,取指令用的那一份叫 iTLB,条目数有限。热代码散落在几百个页里,iTLB 就装不下;访问尚未建立有效映射的页还可能触发缺页异常,但页可能已经被预取或由相邻缺页一并映射,不能按访问的不同页数直接计算缺页次数。把常用函数集中排列有机会减少这两层的压力,实际收益仍需测量。
覆盖页数、代码总长度与地址跨度是三个不同的量。对于地址为 a、长度为 n > 0 的函数,覆盖的页号从 floor(a / 4096) 到 floor((a + n - 1) / 4096);多个函数的覆盖页数取这些页号的并集大小。代码总长度是各函数长度之和,地址跨度则从最小起始地址到最大结束地址,包含函数之间的其他内容和空隙。
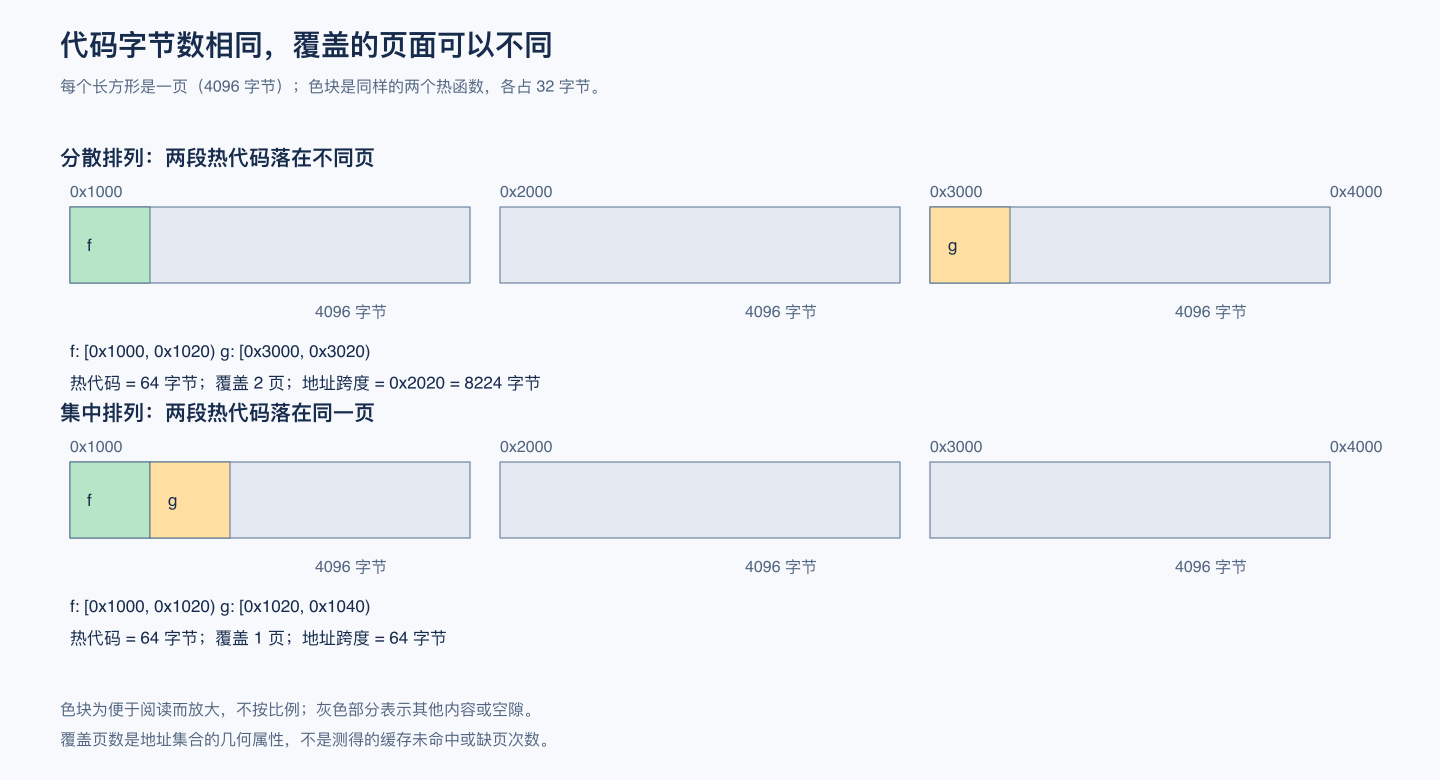
图中两个函数始终只含 64 字节代码。分散时覆盖两页,但中间那一页不包含热代码;不能用地址跨度除以页大小代替覆盖页数。集中时覆盖一页。真实函数的对齐要求会留下空隙;因此即使排序成功,覆盖页数也未必达到 ceil(代码总长度 / 页大小) 这个容量下界。缓存行的覆盖统计使用相同方法,只需将 4096 换成所选行大小。
链接器提供的手段有这样几种:
- lld 的
--symbol-ordering-file=文件:文件里每行一个符号名,包含这些符号的输入节按文件里的顺序排在输出节的最前面。前提是每个函数单独一节,即-ffunction-sections。gold 有按节名排序的--section-ordering-file,GNU ld 从 binutils 2.43 起也有了同名选项(ld/NEWS)。 - 编译器按冷热给节名加前缀,链接器据此分组。
__attribute__((hot))和__attribute__((cold))会让函数进入.text.hot.和.text.unlikely.开头的节;有了 PGO(profile-guided optimization,收集程序运行的剖析数据,再用它指导编译;数据可来自插桩,也可来自采样)的数据,编译器会自动这样做。GCC 还会做热冷拆分(hot/cold splitting),把一个函数里不太可能执行的分支拆出去,放进.text.unlikely,成为一个名叫函数名.cold的局部符号。 - 链接器怎么对待这些前缀,GNU ld 和 lld 的默认行为不同。
// hotcold.c:用属性标出冷热__attribute__((cold, noinline)) int report_error(int x) { return -x; }__attribute__((hot, noinline)) int fast_path(int x) { return x + 1; }__attribute__((noinline)) int normal(int x) { return x * 2; }
int main(int argc, char **argv) { if (argc > 5) return report_error(argc); return fast_path(argc) + normal(argc);}$ clang -fno-pie -O2 -ffunction-sections -c hotcold.c -o hc_clang.o$ llvm-readelf -SW hc_clang.o | grep -E '\.text' [ 3] .text.unlikely.report_error PROGBITS 0000000000000000 000040 000005 00 AX 0 0 1 [ 4] .text.hot.fast_path PROGBITS 0000000000000000 000050 000004 00 AX 0 0 16 [ 5] .text.normal PROGBITS 0000000000000000 000060 000004 00 AX 0 0 16 [ 6] .text.main PROGBITS 0000000000000000 000070 000025 00 AX 0 0 16$ gcc -O2 -c hotcold.c -o hc_gcc.o$ llvm-readelf -SW hc_gcc.o | grep -E '\.text'[ 1] .text PROGBITS 0000000000000000 000040 000008 00 AX 0 0 16 [ 4] .text.unlikely PROGBITS 0000000000000000 000048 00000b 00 AX 0 0 1 [ 5] .text.hot PROGBITS 0000000000000000 000058 000008 00 AX 0 0 16 [ 6] .text.startup PROGBITS 0000000000000000 000060 00001c 00 AX 0 0 16 [ 7] .rela.text.startup RELA 0000000000000000 000288 000048 18 I 13 6 8GCC 不加 -ffunction-sections 也会按冷热分节,main 还被放进了 .text.startup。这个名字是编译器的分类提示,不是“必须只执行一次”的文件格式约束。.text.unlikely 的实际长度是 0x0b,即 11 字节。用 objdump -dr -j .text.unlikely hc_gcc.o 可以逐项核算本次结果:
| 节内范围 | 字节数 | 所属内容 |
|---|---|---|
| [0,4) | 4 | report_error 的 endbr64,间接分支入口标记 |
| [4,6) | 2 | mov %edi,%eax |
| [6,8) | 2 | neg %eax |
| [8,9) | 1 | ret |
| [9,11) | 2 | main.cold:跳到 report_error 的短 jmp |
report_error 因而占 9 字节,拆出的冷分支占 2 字节。本机 GCC 默认生成了 endbr64;上面的 Clang 结果没有这四个字节,所以它的 report_error 是 5 字节。不能把一个编译器的函数长度代入另一个对象的节表。把 GCC 的目标文件交给三种链接方式:
$ ld.lld -e main hc_gcc.o -o hc_gcc.o.out$ llvm-readelf -SW hc_gcc.o.out | grep -E '\.text'[ 3] .text PROGBITS 0000000000201270 000270 00004c 00 AX 0 0 16$ ld.lld -e main -z keep-text-section-prefix hc_gcc.o -o hc_gcc.o.keep.out$ llvm-readelf -SW hc_gcc.o.keep.out | grep -E '\.text'[ 3] .text PROGBITS 0000000000201270 000270 000008 00 AX 0 0 16 [ 4] .text.unlikely PROGBITS 0000000000201278 000278 00000b 00 AX 0 0 1 [ 5] .text.hot PROGBITS 0000000000201290 000290 000008 00 AX 0 0 16 [ 6] .text.startup PROGBITS 00000000002012a0 0002a0 00001c 00 AX 0 0 16$ llvm-nm -n hc_gcc.o.keep.out0000000000201270 T normal0000000000201278 T report_error0000000000201281 t main.cold0000000000201290 T fast_path00000000002012a0 T main$ ld.bfd -e main hc_gcc.o -o bfd.out$ llvm-nm -n bfd.out | grep -E ' [Tt] '0000000000401000 T report_error0000000000401009 t main.cold0000000000401010 T main0000000000401030 T fast_path0000000000401040 T normal$ ld.bfd --verbose | grep -E 'text\.(unlikely|hot|startup)' *(.text.unlikely .text.*_unlikely .text.unlikely.*) *(.text.startup .text.startup.*) *(.text.hot .text.hot.*)lld 默认把所有 .text.* 合进一个 .text,冷热前缀不起作用;加了 -z keep-text-section-prefix,.text.hot、.text.unlikely、.text.startup 各自成为单独的输出节,同类的函数聚在一起。GNU ld 不需要选项,它的默认链接脚本(第 5 章)把 .text.unlikely、.text.startup、.text.hot 依次排在普通 .text 前面,仍然只输出一个 .text 节。clang 的目标文件结果类似,只是 clang 不生成 .text.startup,main 留在普通的 .text.main 里。
从布局集合到运行成本
一个生成器生成 65536 个函数,每 16 个选一个热函数,共 4096 个,run 依次调用它们;main 循环执行 run,其余函数保留为冷路径。生成器还写出 hot.txt,把 main、run 和热函数列在一起。Linux 上用同一份目标文件链接两种排列:
clang -O2 -fno-pie -ffunction-sections -DITER=4000 -c prog.c -o prog.oclang -fuse-ld=lld -static prog.o -o p_defaultclang -fuse-ld=lld -static prog.o -Wl,--symbol-ordering-file=hot.txt -o p_orderedpython3 pages.py p_default p_orderedp_default 热代码 106516 字节,跨度 2555913 字节,521 页,4546 条缓存行p_ordered 热代码 106516 字节,跨度 159763 字节,40 页,2497 条缓存行pages.py 从 llvm-nm -S 读取地址和大小,统计热函数覆盖的 4 KiB 页和 64 字节缓存行。两份文件的热代码总字节数相同,差别来自函数之间夹着的冷代码和对齐间隙。x86-64 指令长度不固定,不能沿用其他 ISA 的“每个函数固定若干字节”。
脚本按相反顺序交错运行八轮,检查两个产物每次都返回 79,再用 time.perf_counter 记录耗时。此轮中位数为默认排列 0.3340 秒、聚拢后 0.1085 秒。它说明在这份刻意构造的程序中,仅改变布局便能影响实际运行时间;没有硬件计数器证据,不能把全部差额归因于指令缓存、iTLB 或分支预测中的某一项。
静态的“覆盖页数”不等于实际缺页次数:Linux 可能把邻近页一起建立映射,页缓存和预取也会影响结果。若用 perf 或 Cachegrind 追踪,应分别报告硬件事件、内核软件事件和模拟计数。布局统计证明地址集合发生了变化,运行计时证明这份程序的耗时发生了变化;二者尚不足以确定每种微架构效应各贡献多少。
真实程序中的冷热分布不会像本例这样整齐,布局收益可能小得多,也可能被负载噪声淹没。因此性能结论应同时给出输入、构建选项、机器环境和重复测量方式。
Propeller 与 BOLT
--symbol-ordering-file 要求先知道哪些函数是热的。实际做法是先收集剖析数据,再由工具生成排序文件,或者走得更远:BOLT 在链接完成之后,按 perf 采集的剖析数据直接重写可执行文件,在基本块(第 0 章讲 QEMU21 时提过)的粒度上重新排列代码,它最早由 Meta 开发,现在是 LLVM 的一个子项目(llvm-project/bolt,Panchenko 等,CGO 2019);Propeller 是 Google 的方案,它不改写二进制,而是让编译器把每个基本块放进单独的节,再根据剖析数据生成排列,交给链接器重新链接一次(google/llvm-propeller)。
从相同候选到可安全合并的输出
等价类确定以后,保留的代码承担各个符号的入口,折叠节退出布局,展开记录和调试记录也必须与选择结果协调。候选比较正确,不等于产物正确;仍需检查函数地址、调用结果和元数据。
共享库这一边,本章只用到了导出名单的一个后果:版本脚本没列出的符号,LTO 可以删掉。soname、版本脚本、符号版本这些机制,第 7 章已经讲过它们各自是什么;可一个库发布以后,导出名单就成了和使用者之间的约定,下一版想改 api_get 的参数、想删一个看上去没人用的函数,都可能让已经编译好的程序在运行时出错。怎样用这些机制让库逐版演进而不破坏旧程序,GLIBC_2.34 这样的版本号是怎么维护起来的,又有什么工具能在发布前检查出 ABI22 被改坏了,这是第 13 章的内容。
练习
本章前三组练习沿用正文给出的输入与命令;候选识别器只用于观察候选分组与引用关系。
练习一,观察。
(1) 用开头的例子的 main.lto.o 和 util.lto.o 再链接一次,这次加上 lld 的 --lto-O0,即 LTO 后端不做优化。先预测:llvm-nm -S 里 main、scale、twice、checksum 各是什么状态,main 里还有没有 call?再运行核对。
(2) 用本机 GCC 加 -flto -ffat-lto-objects 编出开头的例子的两个文件,交给 ld.lld 链接(不是 GCC 驱动的 GNU ld)。产物里有几个符号?这次链接做了 LTO 吗?从哪一处输出可以判断?
练习二,手算或预测。
(1) 下面是 taken.c 和它的目标文件的一部分(clang -O2 -ffunction-sections):
// taken.ctypedef int (*fn)(int);int h1(int x) { return x ^ 0x55; }int h2(int x) { return x ^ 0x55; }int h3(int x) { return x ^ 0x55; }int h4(int x) { return x ^ 0x55; }fn table[] = { h2, h4 };int main(int argc, char **argv) { return h1(argc) + h3(argc) + table[argc & 1](argc); }Contents of section .llvm_addrsig: 0000 080a .. 7: 0000000000000000 6 FUNC GLOBAL DEFAULT 3 h1 8: 0000000000000000 6 FUNC GLOBAL DEFAULT 4 h2 9: 0000000000000000 6 FUNC GLOBAL DEFAULT 5 h3 10: 0000000000000000 6 FUNC GLOBAL DEFAULT 6 h4 11: 0000000000000000 24 FUNC GLOBAL DEFAULT 7 main 12: 0000000000000000 16 OBJECT GLOBAL DEFAULT 9 table按 ULEB128 解出地址表里的符号,写出 --icf=safe 和 --icf=all 下 --print-icf-sections 里名字以 .text. 开头的那些节的输出。提示:lld 先把节按哈希排序再分组,用的是 stable_sort,所以一个等价类里保留的是输入顺序中最靠前的节;节在文件里的顺序与符号表里 Ndx 一列的顺序相同。再算出 ./taken_all a 的退出码(退出码是返回值的低 8 位)。
(2) 用 -O0 -ffunction-sections 编译下面的文件,-O0 不做内联,四个函数各成一节,其中 a、b、c 的机器码逐字节相同,d 的乘数不同:
// mutual.cint b(int x);int a(int x) { return x ? b(x - 1) * 3 : 1; }int b(int x) { return x ? a(x - 1) * 3 : 1; }int c(int x) { return x ? c(x - 1) * 3 : 1; }int d(int x) { return x ? a(x - 1) * 5 : 1; }int main(int argc, char **argv) { return a(argc) + b(argc) + c(argc) + d(argc); }a 的重定位指向 b,b 的指向 a,c 的指向自己,d 的指向 a。按本章讲的 lld 算法,一轮一轮地写出等价类的变化,预测 --icf=all 会折叠哪些节。如果把"重定位目标"简单地取成目标符号的名字算进哈希,结果会怎样?--icf=safe 呢?已知这个文件的 .llvm_addrsig 内容是 07 08 09 0a,符号 7 到 10 依次是 a、b、c、d。
练习三,改坏。主程序提供一个函数,插件在运行时按名字找它:
// host.c:主程序提供 plugin_hook,插件在运行时按名字找它#include <dlfcn.h>#include <stdio.h>
int plugin_hook(int x) { return x + 100; }
int main(void) { void *h = dlopen("./plugin.so", RTLD_NOW); if (!h) { printf("dlopen: %s\n", dlerror()); return 1; } int (*run)(int) = (int (*)(int))dlsym(h, "plugin_run"); printf("plugin_run(1) = %d\n", run(1)); return 0;}// plugin.c:编成 plugin.soint plugin_hook(int x);int plugin_run(int x) { return plugin_hook(x) * 2; }host.c 用 -flto 编译,link_musl_dyn 链接成动态链接 musl 的 PIE,不加任何额外选项。在本章同一台 x86-64 Linux 上运行,前提是输出的 PT_INTERP 所指定的 musl 加载器可用;不需要切换到 Alpine。先预测输出。有人说“给 plugin_hook 加上 attribute((used)),LTO 就不会删它了”,加上以后程序能正常运行吗?给出两种能修好的链接选项。不开 LTO 时,这个程序能直接运行吗?
独立候选识别器只是用于观察候选分组与引用关系;实现时应把候选分组和引用关系作为独立的分析结果。本章前三组练习可用参考工具完成。
参考
- Clang ThinLTO 文档
- Teresa Johnson, Mehdi Amini, Xinliang David Li: ThinLTO: Scalable and Incremental LTO,CGO 2017
- LLVM Developer Policy: IR Backwards Compatibility
- LLVM Extensions:SHT_LLVM_ADDRSIG
- LLVM 21.1.8 源码:llvm/lib/LTO/LTO.cpp、llvm/Object/IRSymtab.h、lld/ELF/Driver.cpp、lld/ELF/ICF.cpp、lld/ELF/InputSection.cpp
- GCC wiki: LTO plugin API、GCC 4.9 Release Notes、GCC: Optimize Options、GCC: Developer Options
- ld 手册:Options、ld/NEWS
- binutils 2.40 的 gold 源码:gold/icf.cc、gold/options.h
- Sriraman Tallam 等: Safe ICF: Pointer Safe and Unwinding Aware Identical Code Folding in the Gold Linker,2010
- MIT 6.172 Performance Engineering of Software Systems(Fall 2018)讲义,第 9 讲 LTO 备用幻灯片、第 10 讲 Measurement and Timing
- Maksim Panchenko 等: BOLT: A Practical Binary Optimizer for Data Centers and Beyond,CGO 2019;llvm-project/bolt
- google/llvm-propeller
- Lua 5.4.7 源码
答案
每题的答案都折叠着,先自己做再展开。
练习一答案
(1) 实测:
$ link_musl lto_o0 main.lto.o util.lto.o --lto-O0$ llvm-nm -S lto_o0 | grep -E ' (main|scale|twice|checksum)$'0000000000201a10 0000000000000032 T main0000000000201a50 0000000000000006 t scale$ llvm-objdump -d --no-show-raw-insn --disassemble-symbols=main lto_o0 | grep call201a25: callq 0x201a50 <scale>twice 和 checksum 照样没了:它们在合并模块时就被存活性分析挡在外面,那一步不属于优化流水线,--lto-O0 关不掉它。scale 还在,但符号类型从 T 变成了小写的 t,也就是局部符号,说明内部化做了;没有优化,内联就没发生,main 里还是一条 call,大小 0x32,和不开 LTO 时一样。这说明开头的例子里的三件事分属三个阶段:删除靠存活性分析,变成局部靠内部化,内联靠优化器。
(2) 实测四个符号都在,main 里还有 callq 0x201320 <scale>:
$ link_musl fat main.fat.o util.fat.o$ llvm-nm -S fat | grep -E ' (main|scale|twice|checksum)$'0000000000201340 000000000000003e T checksum00000000002012d0 0000000000000031 T main0000000000201320 0000000000000009 T scale0000000000201330 0000000000000008 T twice没有做 LTO。lld 读不懂 .gnu.lto_* 节里的 GIMPLE,这些节又带 SHF_EXCLUDE,它就当作普通目标文件,用 fat 对象里那份 .text 链接。判断依据有两处:twice、checksum 没被删;main 的大小是 0x31,里面有 call。另外,lld 会对 LLVM 的 fat LTO 对象(.llvm.lto 节)做 LTO,前提是加 --fat-lto-objects,Driver.cpp 里的 tryAddFatLTOFile 处理的就是这种情况,GCC 的 fat 对象不在此列。
练习二答案
(1) 08 和 0a 都小于 0x80,各是一个单字节的 ULEB128,值为 8 和 10,即 h2 和 h4,它们的地址被放进了 table。四个函数的节内容相同,没有重定位。
safe 模式下 h2、h4 被排除,只剩 h1、h3 可以合并;all 模式不管代码节的地址表,四个全合并:
$ link_musl taken_safe taken.o --icf=safe --print-icf-sections 2>&1 | grep -A3 'taken.o:(.text.'selected section taken.o:(.text.h1) removing identical section taken.o:(.text.h3)$ link_musl taken_all taken.o --icf=all --print-icf-sections 2>&1 | grep -A3 'taken.o:(.text.'selected section taken.o:(.text.h1) removing identical section taken.o:(.text.h2) removing identical section taken.o:(.text.h3) removing identical section taken.o:(.text.h4)两种模式下保留的都是 h1:四个节内容相同,第一轮就在同一个类里,stable_sort 不改变它们的相对顺序,h1 的节号最小。(输出里还有 libc 和 crt 文件那些空的 .text 被折叠的行,与本题无关。)./taken_all a 时 argc 为 2,三次调用都是 2 ^ 0x55 = 0x57 = 87,合计 261,低 8 位是 5。两个版本实测退出码都是 5,这个程序不比较函数指针,折叠不改变结果。
(2) 第一轮只看内容和重定位条数:a、b、c 进同一类,记作 X;d 内容不同,单独一类;main 一类。第二轮看重定位目标所在的类:a 指向 b(X),b 指向 a(X),c 指向 c(X),三者的键相同,仍在一类;d 指向 a(X),但它本来就和 X 不同类。等价类个数没有增加,算法结束,a、b、c 折叠成一个:
selected section mutual0.o:(.text.a) removing identical section mutual0.o:(.text.b) removing identical section mutual0.o:(.text.c)$ llvm-nm mutual0 | grep -E ' [abcd]$' | sort00000000002012b0 T a00000000002012b0 T b00000000002012b0 T c00000000002012f0 T d如果拿目标符号的名字算哈希,a 的键里有 b,b 的键里有 a,c 的键里有 c,三者互不相同,一个也折叠不了。算法先乐观地假设它们相同,再看这个假设能不能自洽,所以能折叠互相递归的函数,这就是注释里说的 optimistic algorithm。运行 ./mutual0 退出码 14(argc 为 1 时是 3 + 3 + 3 + 5),./mutual0 a 是 42,折叠前后相同。
safe 模式什么也不折叠。地址表 07 08 09 0a 把四个函数全列进去了,-O0 下 clang 不给函数加 unnamed_addr("地址不重要"的标记),只要被引用就当作地址有意义。同一个文件用 -O2 编译时,函数都带上了 local_unnamed_addr,.llvm_addrsig 是空的,可优化器又把这几个函数改写了(a 里已经没有 call),字节不再相同,题目才改用 -O0。
练习三答案
实测输出(symtab、dynsym 两列是 plugin_hook 在 .symtab 和 .dynsym 里出现的次数):
h_plain symtab=1 dynsym=0h_lto symtab=0 dynsym=0h_lto_used symtab=1 dynsym=0h_lto_E symtab=1 dynsym=1h_lto_dl symtab=1 dynsym=1== h_ltodlopen: Error relocating ./plugin.so: plugin_hook: symbol not found== h_lto_useddlopen: Error relocating ./plugin.so: plugin_hook: symbol not found== h_lto_Eplugin_run(1) = 202== h_lto_dlplugin_run(1) = 202== h_plaindlopen: Error relocating ./plugin.so: plugin_hook: symbol not found== h_plain_Eplugin_run(1) = 202报错来自 musl 的动态链接器:dlopen 加载 plugin.so 时要为它的 plugin_hook 引用做重定位(RTLD_NOW),在主程序的动态符号表里找不到这个名字。开了 LTO 的 h_lto 里,plugin_hook 连 .symtab 都没有了,链接时没有任何共享库引用它,resolution 里它只有 pl,被内部化后删掉。
加 used 以后符号回到了 .symtab,可程序照样失败:used 只阻止编译器和 LTO 删除它,不会把它放进 .dynsym,动态链接器只看后者。能修好的是 --export-dynamic(导出全部全局符号),或者 --dynamic-list=dyn.list,文件内容是 { plugin_hook; };,只导出这一个。这两个选项也会让 lld 在 resolution 里给它标上 x,LTO 自然就保留了它。
不开 LTO 的 h_plain 同样失败,函数虽然在 .symtab 里,但没进 .dynsym。所以这个错误的根源在动态导出,LTO 只是让它多了一层:不开 LTO 时可以用 nm 看到函数"还在",容易误以为问题出在别处;开了 LTO 以后函数整个消失,正确的修法却还是同一个。
附录:术语与工具
-
LTO — LTO(link-time optimization)在链接阶段协调编译器优化。它利用保留下来的中间表示跨文件分析,能力不同于仅处理本机目标文件的普通链接。 官方文档。 ↩
-
GCC — GCC(GNU Compiler Collection)是一组语言编译器。命令
gcc是驱动入口,会组织编译、汇编和链接;在终端调用它,并不意味着后续工作都在同一个进程里完成。 官方文档。 ↩ -
GNU — GNU 是 “GNU’s Not Unix” 的递归缩写,指自由软件操作系统项目。GCC、binutils 和 glibc 都属于 GNU 项目,但分别承担编译、二进制处理和 C 运行库职责。 官方文档。 ↩
-
binutils — GNU binutils 是一组处理目标文件的工具,包含汇编器
as、链接器ld,以及readelf、nm、objdump、ar等检查与归档工具。 官方文档。 ↩ -
ELF — ELF(Executable and Linkable Format)规定目标文件、可执行文件与共享对象的结构。通用规则见 gABI,架构相关的调用约定和重定位规则见对应 psABI。 官方文档。 ↩
-
Clang — Clang 是 LLVM 项目中的 C、C++ 等语言前端及驱动程序。它通常使用集成汇编器,但仍需调用链接器;最终使用哪个链接器取决于目标平台和配置。 官方文档。 ↩
-
IR — IR(intermediate representation)是编译器使用的中间表示。它处于源码与最终机器码之间,便于分析和优化;LLVM IR 的文本形式与 bitcode 二进制编码表达同一套中间语言。 官方文档。 ↩
-
LLVM — LLVM 是一组编译器与工具链项目的名称,包括优化基础设施、目标代码生成和相关工具。Clang、LLD 与 LLVM IR 各有职责,不能互作同义词。 官方文档。 ↩
-
COMDAT — COMDAT 让工具链表示可供择一保留的重复定义组。ELF 通过 section group 与签名表达相关关系;选择副本时,组内关联内容需要一致处理。 官方文档。 ↩
-
collect2 —
collect2是 GCC 调用链接器时可能经过的辅助程序。它属于驱动调用链;诊断中出现这个名字,不代表又多了一种目标文件格式。 官方文档。 ↩ -
ar —
ar建立和查看归档文件。静态库.a通常由多个目标文件成员组成,链接器根据未解析符号按需抽取成员。 官方文档。 ↩ -
nm —
nm列出目标文件的符号。字母标记概括符号所在节或绑定等属性;需要判断准确语义时,应继续对照 ELF 符号表字段。 官方文档。 ↩ -
DWARF — DWARF 是调试信息格式,描述源码行、类型、变量与机器位置的关系。它可以随 ELF 保存,但不是 ELF 符号表的别名。 官方文档。 ↩
-
musl — musl 是 Linux 的一种 C 标准库实现,提供
printf等库函数及运行时支持。本系列在需要分析或链接较小的静态运行库时使用它;普通 Linux 服务器不一定预装 musl。 官方文档。 ↩ -
PIE — PIE(position-independent executable)是可以在不同加载基址运行的可执行文件。生成 PIE 需要编译与链接选项配合;static-PIE 还需要自身的启动路径完成必要重定位。 官方文档。 ↩
-
GC — 本文 GC 指 section garbage collection,即链接器从入口和其他根出发保留可达节、删除无用节。它发生在构建阶段,与运行时堆内存的垃圾回收不同。 官方文档。 ↩
-
LLD — LLD 是 LLVM 项目的链接器。ELF 平台通常通过
ld.lld调用;lld-link则提供兼容 Windows 工具链的接口。它与负责处理源码的 Clang 是不同组件。 官方文档。 ↩ -
ULEB128 — ULEB128 是无符号整数的变长编码:每字节低七位承载数值,最高位表示是否继续。SLEB128 是相应的有符号形式;解析时需要限制长度并检查溢出。 官方文档。 ↩
-
LSDA — LSDA(Language-Specific Data Area)保存语言异常处理所需的额外信息,例如异常区域和处理动作。展开器与语言 personality 函数分工使用这些数据。 官方文档。 ↩
-
FDE — FDE(Frame Description Entry)关联一段代码的地址范围与栈展开指令。移动代码或重新组织
.eh_frame时,链接器必须同步更新相关地址和记录间的引用。 官方文档。 ↩ -
QEMU — QEMU 可模拟处理器和系统。用户态模式运行另一架构的用户程序,系统模式则连同机器设备一起模拟;本系列 xv6 实验使用后者启动完整内核。 官方文档。 ↩
-
ABI — ABI(Application Binary Interface)规定二进制组件如何协作,包括调用约定、数据布局和文件格式等。它约束编译结果之间的交接,比源码层面的 API 更靠近机器。 官方文档。 ↩