

[链接器的世界-原理篇11] 调试信息:让机器码认回源代码
下文命令中的文件名只表示本次观察产生的输入和输出;目录位置可以由读者自行选择。
调试信息是描述程序的数据:它把机器地址与函数名、类型、源码行对应起来,CPU 通常不执行这些记录。先理解原理篇 04的地址修补和原理篇 05的节删除,再看本章的核心问题:代码移动或消失后,描述它的记录应怎样变化?
先读被删除函数的例子和调试节的重定位,建立“记录描述谁、地址指向谁”的关系。DWARF 的类型树、行号程序是这种描述的不同组织方式;压缩、独立 debug 文件与 split DWARF 则解决体积和分发问题,可在理解地址关系后分别阅读,不必先掌握整个 DWARF 标准。
一个函数从可执行文件里消失以后,调试器是否还应该看见它?代码已经被 --gc-sections 删除,描述它的函数名、源码行号和地址范围却可能仍在 .debug_* 节里。程序不再调用它,运行测试未必能发现问题;调试器一旦把残留地址解释为有效代码位置,给出的线索就可能是错的。
链接器已经会沿引用关系保留或删除代码,但调试信息描述的对象比“这几个字节是否还存在”复杂得多。它可能要保留一个函数的名字和类型,同时表示该函数没有可执行地址;另一些记录则仍要跟随存活的代码搬到新位置。
一个被删掉的函数,在调试信息里还剩什么
第 5 章讲 GC1 时,-ffunction-sections 让每个函数单独占一个节,--gc-sections 从入口出发沿着重定位标记,没人引用的节被删掉。下面这个文件里,unused 没有任何调用者:
// gc.cint counter = 1;
__attribute__((noinline)) int used(int x) { return x + counter;}
__attribute__((noinline)) int unused(int x) { return x * 3 + counter;}
void _start(void) { int r = used(41); __asm__ volatile("mov %0, %%edi; mov $60, %%eax; syscall" :: "r"(r) : "rdi", "rax");}下面分别用 Clang2 + LLD3 和 GCC4 + GNU5 ld 编译并链接这个程序:
$ clang -O1 -g -ffunction-sections -fno-pic \ -fno-asynchronous-unwind-tables -c gc.c -o gc_clang.o$ gcc -O1 -g -ffunction-sections -fno-pic \ -fno-asynchronous-unwind-tables -c gc.c -o gc_gcc.o$ ld.lld --gc-sections gc_clang.o -o lld.out$ ld --gc-sections gc_gcc.o -o bfd.out为了减少构建目录差异,可以给两个编译器加上 -fdebug-prefix-map=构建目录=/w,把匹配的调试路径改写为 /w。路径映射不会固定所有文件字节和节偏移;编译器版本、选项及其他元数据仍会影响产物。下面列出一组代表性输出;逐步执行上述简化命令时应比较记录关系,而非要求偏移逐项相同。
GC 删除了 unused 的代码节。接下来要检查的对象是另外两类记录:描述这个函数的调试条目,以及把它的指令地址关联到源码的行号表。代码消失,不意味着这两类记录也按相同粒度被删除。
DWARF6 同时保存源码实体之间的关系和它们与机器地址之间的关系。下面的输入采用 DWARF 5;它支持把地址集中到独立表中,而不是要求每个使用者都保存完整地址。先看源码实体怎样组织:一个函数有参数和局部变量,每个变量又有类型。它将一次编译产生的相关信息组织成编译单元(CU,compilation unit),通常对应一个源码翻译单元。CU 中的实体按树组织,每个节点称为 DIE7,可描述函数、变量或类型;DIE 的标签(tag)说明它是什么,比如 DW_TAG_subprogram 表示函数;它的属性(attribute)记录具体信息,比如 DW_AT_name 是名字,DW_AT_low_pc 是起始地址,DW_AT_high_pc 是结束地址或长度。每个属性值用哪种编码存放,由形式(form)决定,后面会看到形式对链接器的影响。用 llvm-dwarfdump 看 lld 的产物:
$ llvm-dwarfdump --debug-info lld.out | grep -E 'DW_TAG_subprogram|DW_AT_(name|low_pc|high_pc)'0x0000003e: DW_TAG_subprogram DW_AT_low_pc (0x0000000000201160) DW_AT_high_pc (0x0000000000201169) DW_AT_name ("used")0x00000058: DW_TAG_subprogram DW_AT_low_pc (0x0000000000000000) DW_AT_high_pc (0x000000000000000a) DW_AT_name ("unused")0x00000072: DW_TAG_subprogram DW_AT_low_pc (0x0000000000201170) DW_AT_high_pc (0x0000000000201188) DW_AT_name ("_start")记录还在,起始地址是 0。DW_AT_high_pc 在文件里存的是长度 0xa,工具把它加到起始地址上显示,于是 unused 声称自己占据 [0, 0xa)。GNU ld 的产物里 unused 的起点同样是 0,但本机 GCC 默认生成 CET 的 endbr64,函数长 0xe,所以 DW_AT_high_pc 显示 0xe。墓碑相同,不代表两套编译器的指令长度相同。
DWARF 5 的这个 0 写在哪里,Clang 和 GCC 不同。GCC 用 DW_FORM_addr 形式,地址直接写在 .debug_info 的 DIE 里;Clang 用 DW_FORM_addrx,DIE 里只存一个下标,地址集中放在 .debug_addr 节的一张表里。
下面输出中的三个数描述不同维度:version=5 是 DWARF 格式版本;DWARF32 表示这组记录使用 32 位的长度/节偏移编码;addr_size=8 表示地址项占 8 字节。DWARF32 完全可以描述 64 位程序,不意味着地址只能占 4 字节。长度字段控制记录怎样划界,地址宽度控制表项怎样读,两者分别由记录头说明:
$ llvm-dwarfdump --debug-addr lld.outAddress table header: length = 0x0000002c, format = DWARF32, version = 0x0005, addr_size = 0x08, seg_size = 0x00Addrs: [0x00000000002021880x00000000002011600x00000000000000000x00000000002011700x000000000020117b]五项依次是 counter、used、unused、_start 和 _start 里的一个位置,第三项就是 unused 的那个 0。
行号表在 .debug_line。第 8 章说过,它是一段状态机程序,解出来是一张"从哪个地址起对应第几行"的表。每个连续的代码区间是一个序列(sequence),以 DW_LNE_set_address 设定起点,以 end_sequence 结束:
$ llvm-dwarfdump --debug-line lld.outAddress Line Column File ISA Discriminator OpIndex Flags------------------ ------ ------ ------ --- ------------- ------- -------------0x0000000000201160 3 0 0 0 0 0 is_stmt0x0000000000201162 4 14 0 0 0 0 is_stmt prologue_end0x0000000000201168 4 5 0 0 0 00x0000000000201169 4 5 0 0 0 0 end_sequence0x0000000000000000 8 14 0 0 0 0 is_stmt prologue_end0x0000000000000003 8 18 0 0 0 00x0000000000000009 8 5 0 0 0 00x000000000000000a 8 5 0 0 0 0 end_sequence0x0000000000201170 11 0 0 0 0 0 is_stmt...中间那个序列属于 unused,起点同样是 0,第 8 行"对应"着地址 0 到 9。三个问题的答案是:记录还在,地址填成 0,行号表也还在,只是挪到了地址 0。
原因第 5 章讲过:调试节不加载,默认全部保留,它们引用 .text.unused 的那些重定位没有了目标,链接器只好填一个约定的值。这个值叫墓碑值(tombstone),意思是"这里原来有东西,现在作废了"。
0、1、−1,还有短暂存在过的 −2
这次 DWARF 5 的结果里,.debug_addr、.debug_info 和 .debug_line 的墓碑全是 0。换回 DWARF 4,地址范围列表在 .debug_ranges 节里,每一项是一对"起点、终点":
$ gcc -O1 -g -gdwarf-4 -ffunction-sections -fno-pic \ -fno-asynchronous-unwind-tables -c gc.c -o gc4.o$ ld.lld --gc-sections gc4.o -o lld4.out$ ld --gc-sections gc4.o -o bfd4.out$ readelf -x .debug_ranges bfd4.out 0x00000000 00104000 00000000 0d104000 00000000 ..@.......@..... 0x00000010 01000000 00000000 01000000 00000000 ................ 0x00000020 0d104000 00000000 27104000 00000000 ..@.......@..... 0x00000030 00000000 00000000 00000000 00000000 ................第二对是 unused 的,两边都是 1,lld4.out 里也一样。原因第 5 章讲过:DWARF 4 的范围列表用一对 0 表示结束,填 0 会把后面 _start 的范围截掉,起点为 −1 的一项又表示基地址选择项,只好用 1,[1, 1) 是一个空区间。
第 5 章引过 lld 的规则(lld/ELF/InputSection.cpp 的 relocateNonAlloc):大多数节填 0,.debug_loc、.debug_ranges 填 1,DWARF 5 的名字索引 .debug_names 填 −1;GNU ld 是 .debug_ranges 填 1、其余填 0(MaskRay: Linker garbage collection),上面的实测都与之一致。
这套规则是 2020 年才定下来的。lld 11 之前填的是"0 加上加数",和 gold 一样:重定位 .text.unused + 8 会填成 8,一个函数中间的地址就成了一个小的正数。2020 年 6 月 23 日的提交 e618ccbf(D81784)改成大多数节填 −1,.debug_loc 和 .debug_ranges 因为 −1 有特殊含义,填 −2。−1 随即在几个使用调试信息的工具里出了问题:lldb、Chrome 用的崩溃收集库 breakpad、二进制体积分析工具 bloaty。8 月 6 日的提交 004be4037e1e(D84825)改成 0 和 1,并把 1 推广到 .debug_loc,说明里写的是不回到 gold 的老办法,"we're going to the GNU ld strategy";这个提交随后挑进了 11.x 发布分支(279922f)。提交说明还解释了 −2 被放弃的原因:{−1, −2} 这一对后面再跟一项 {0, 长度},会出现起点大于终点的范围。源码里至今留着一句 TODO:"Enable -1 in a future release"。
还有一类墓碑出现在相同代码折叠(ICF8,第 12 章细讲)之后:被折叠掉的函数,调试记录也要填墓碑,只有 .debug_line 例外,否则在这些函数上下不了断点。上面那段源码注释讲的就是这件事。
调试器为什么怕地址 0
0 能当墓碑,前提是没有真实代码放在地址 0。普通的 Linux 可执行文件满足这一点,lld.out 的代码从 0x201160 开始。gdb 正是这样认定的。它读入一个文件时,会检查有没有哪个要加载的节恰好从地址 0 开始,结果记在 has_section_at_zero 里;读到起始地址为 0 的函数、起点为 0 的范围列表项、地址为 0 的静态变量时,只要没有节在地址 0,就当作被链接器丢弃的东西忽略掉。读函数地址那一处的注释写的是 GNU ld 的老做法:被丢弃的 .gnu.linkonce 节(COMDAT9 之前的去重办法)里的标号,重定位后"get a value of 0","mark the pc bounds as invalid, so that GDB will ignore it"。读行号表时,如果一个序列的起点为 0 且低于所在 CU 的起始地址,或者起点为 −1,gdb 认为"This line table is for a function which has been GCd by the linker",整个序列不记录(gdb 13.1 的 gdb/dwarf2/read.c,check_line_address 等函数)。check_line_address 开头的注释自己也承认,只看地址是否为 0,"will err if the text section is located at 0x0",所以才加了"低于 CU 起始地址"这个条件。
用本机 GDB 17.1 读取同一架构的 bfd.out:
$ gdb -q -batch -ex "info line used" -ex "info line unused" ./bfd.outLine 3 of "gc.c" starts at address 0x401000 <used> and ends at 0x401004 <used+4>.Function "unused" not defined.unused 的 DIE 和行号序列都在文件里,gdb 把它们当作被 GC 的残留丢掉了,用户看不到这个函数。
这套推断在代码真从 0 开始时就失效了。不少单片机固件和引导程序就链接在地址 0,第 10 章讲过,没有加载器的程序地址由链接器脚本说了算。用 -Ttext=0 模拟一下:
$ ld --gc-sections -Ttext=0 gc_gcc.o -o bfd0.out$ nm bfd0.out | grep ' T '000000000000000d T _start0000000000000000 T used$ addr2line -f -e bfd0.out 0x4used/w/gc.c:80x4 在 used 里,函数名是对的,行号却是第 8 行,那是 unused 的函数体。行号表里现在有两个序列都从 0 开始:
$ llvm-dwarfdump --debug-line bfd0.outAddress Line Column File ISA Discriminator OpIndex Flags------------------ ------ ------ ------ --- ------------- ------- -------------0x0000000000000000 3 43 1 0 0 0 is_stmt0x0000000000000000 3 43 1 0 0 00x0000000000000004 4 5 1 0 0 0 is_stmt0x0000000000000004 4 14 1 0 0 00x000000000000000c 5 1 1 0 0 00x000000000000000d 5 1 1 0 0 0 end_sequence0x0000000000000000 7 45 1 0 0 0 is_stmt0x0000000000000000 7 45 1 0 0 00x0000000000000004 8 5 1 0 0 0 is_stmt0x0000000000000004 8 14 1 0 0 00x0000000000000007 8 18 1 0 0 00x000000000000000d 9 1 1 0 0 00x000000000000000e 9 1 1 0 0 0 end_sequence0x000000000000000d 11 19 1 0 0 0 is_stmt0x0000000000000011 12 5 1 0 0 0 is_stmt0x0000000000000011 12 13 1 0 0 00x000000000000001d 13 5 1 0 0 0 is_stmt0x0000000000000026 14 1 1 0 0 00x0000000000000027 14 1 1 0 0 0 end_sequence第一个是 used 的真实代码,第二个是 unused 的墓碑,两者都覆盖 0x4,addr2line 选中了后者。gdb 也一样上当。.text 就在地址 0,has_section_at_zero 为真;CU 的起始地址也是 0,行号序列的起点并不"低于"它。两道检查都不起作用:
$ gdb -q -batch -ex "info line used" -ex "info line unused" -ex "info line *0x4" ./bfd0.outLine 7 of "gc.c" starts at address 0x0 <unused> and ends at 0x4 <unused+4>.Line 7 of "gc.c" starts at address 0x0 <unused> and ends at 0x4 <unused+4>.Line 8 of "gc.c" starts at address 0x4 <unused+4> and ends at 0xc <unused+12>.问 used 在哪一行,gdb 答第 7 行,还把地址 0 标成了 <unused>。break used 也一样,gdb 回答 Breakpoint 1 at 0x0: file gc.c, line 7.,而对 bfd.out 是 Breakpoint 1 at 0x401000: file gc.c, line 3.。同一个目标文件交给 ld.lld 链接(加 --image-base=0,否则 lld 拒绝把节放在默认基址 0x200000 之下),用 addr2line 查询地址 0x4,同样错误地返回第 8 行。换成 −1:
$ ld.lld --gc-sections --image-base=0 -Ttext=0 \ -z dead-reloc-in-nonalloc='.debug_*=0xffffffffffffffff' gc_gcc.o -o lldm1.out$ addr2line -f -e lldm1.out 0x4used/w/gc.c:4答案回到了第 4 行。llvm-dwarfdump --debug-line lldm1.out 干脆不再列出 unused 的序列,LLVM10 的 DWARF 解析器认得这个墓碑;gdb 对 lldm1.out 也答出 Line 3 of "gc.c" starts at address 0x0 <used>,unused 则是"not defined",这正是 check_line_address 里"或者起点为 −1"那个条件的作用。0 的问题在于它可能是一个合法地址,−1 几乎不可能是。lld 11 之前的"0 加加数"更糟,墓碑会散落在 [0, 函数长度) 里的各个位置,低地址程序的行号表因此可能出现好几个互相重叠的假序列。
整个输入文件被删除时
前面的 unused 与仍然存活的函数来自同一个输入文件,LLD 保留了这个文件的调试节。如果整个输入文件都没有活着的代码和数据,情况会有所不同。GNU ld 还有一条规则:如果一个输入文件里所有加载的节(SHT_NOTE 除外)都被删了,它的调试节也一并删掉(MaskRay: Linker garbage collection)。加一个只含 orphan 函数的 dead.c 试一下:
$ ld --gc-sections --print-gc-sections gc_gcc.o dead_gcc.o -o bfd2.outld: removing unused section '.text.unused' in file 'gc_gcc.o'ld: removing unused section '.text.orphan' in file 'dead_gcc.o'ld: removing unused section '.debug_info' in file 'dead_gcc.o'ld: removing unused section '.debug_abbrev' in file 'dead_gcc.o'...ld: removing unused section '.debug_frame' in file 'dead_gcc.o'$ ld.lld --gc-sections gc_gcc.o dead_gcc.o -o lld2.outbfd2.out 的 .debug_info 里只有 gc.c 一个 CU,234 字节;lld2.out 里还有 dead.c 的 CU 和 orphan 的 DIE,336 字节。gc.c 里的 unused 两边都留着墓碑,这条规则只管整个文件都死了的情况。若要把这些残留的调试记录也清掉,需要理解并重写 DWARF 的结构。本例通用链接器没有执行这项语义级清理,可以在链接之后用 llvm-dwarfutil 这类工具解析整个 DWARF 再重写,它的 --garbage-collection 选项删除的就是地址为墓碑值的那些调试信息。这类处理要理解 DIE 之间的引用并重建相关偏移,增加的工作不再只是应用 ELF11 重定位;MaskRay 说这符合"smart format, dumb linker"的分工。
调试节在链接器眼里是什么
lld.out 的节头表和程序头:
$ readelf -SW lld.out [Nr] Name Type Address Off Size ES Flg Lk Inf Al [ 0] NULL 0000000000000000 000000 000000 00 0 0 0 [ 1] .text PROGBITS 0000000000201160 000160 000028 00 AX 0 0 16 [ 2] .data PROGBITS 0000000000202188 000188 000004 00 WA 0 0 4 [ 3] .debug_loclists PROGBITS 0000000000000000 00018c 00001d 00 0 0 1 [ 4] .debug_abbrev PROGBITS 0000000000000000 0001a9 000099 00 0 0 1 [ 5] .debug_info PROGBITS 0000000000000000 000242 000095 00 0 0 1 [ 6] .debug_rnglists PROGBITS 0000000000000000 0002d7 00001a 00 0 0 1 [ 7] .debug_str_offsets PROGBITS 0000000000000000 0002f1 000030 00 0 0 1 [ 8] .debug_str PROGBITS 0000000000000000 000321 000052 01 MS 0 0 1 [ 9] .debug_addr PROGBITS 0000000000000000 000373 000030 00 0 0 1 [10] .comment PROGBITS 0000000000000000 0003a3 000042 01 MS 0 0 1 [11] .debug_frame PROGBITS 0000000000000000 0003e8 000068 00 0 0 8 [12] .debug_line PROGBITS 0000000000000000 000450 00009b 00 0 0 1 [13] .debug_line_str PROGBITS 0000000000000000 0004eb 000008 01 MS 0 0 1 [14] .symtab SYMTAB 0000000000000000 0004f8 000078 18 16 2 8 [15] .shstrtab STRTAB 0000000000000000 000570 0000bd 00 0 0 1 [16] .strtab STRTAB 0000000000000000 00062d 00001a 00 0 0 1$ readelf -lW lld.out Section to Segment mapping: Segment Sections... 00 01 02 .text 03 .data 04这份产物中的 .debug_* 都是 PROGBITS 节,Flg 列没有 A,也就是没有第 2 章讲的 SHF_ALLOC,Address 列一律是 0,段映射里一个也没出现。这些非加载节不参与进程映射,调试器则可以从磁盘上的文件读取它们。.debug_str 和 .debug_line_str 带 MS,即第 2、5 章讲过的 SHF_MERGE 加 SHF_STRINGS,是可以合并重复字符串的节。
各节的分工大致如下。.debug_info 是 DIE 树本身;.debug_abbrev 是缩写表,每个 DIE 只存一个缩写编号,"这种 DIE 有哪些属性、各用什么形式"写在缩写表里共用;.debug_str 存属性里的字符串;.debug_line 是行号表,它引用的文件名、目录名在 .debug_line_str 里;.debug_rnglists 和 .debug_loclists 是 DWARF 5 的地址范围列表和位置列表,后者描述"变量在这段代码里放在哪个寄存器、那段代码里放在栈上哪里",DWARF 4 里对应 .debug_ranges 和 .debug_loc;.debug_frame 是第 8 章讲过的调试用调用帧信息;.debug_addr 和 .debug_str_offsets 是 DWARF 5 新增的两张间接表,下面细说。
文件增长与加载范围是两件事
程序头和节头表是同一个 ELF 文件的两套目录。原理篇 02中的节头按节描述文件内容;原理篇 06中的 PT_LOAD 则规定装载范围和权限。一个节可以占有真实文件字节,却不属于任何加载段。
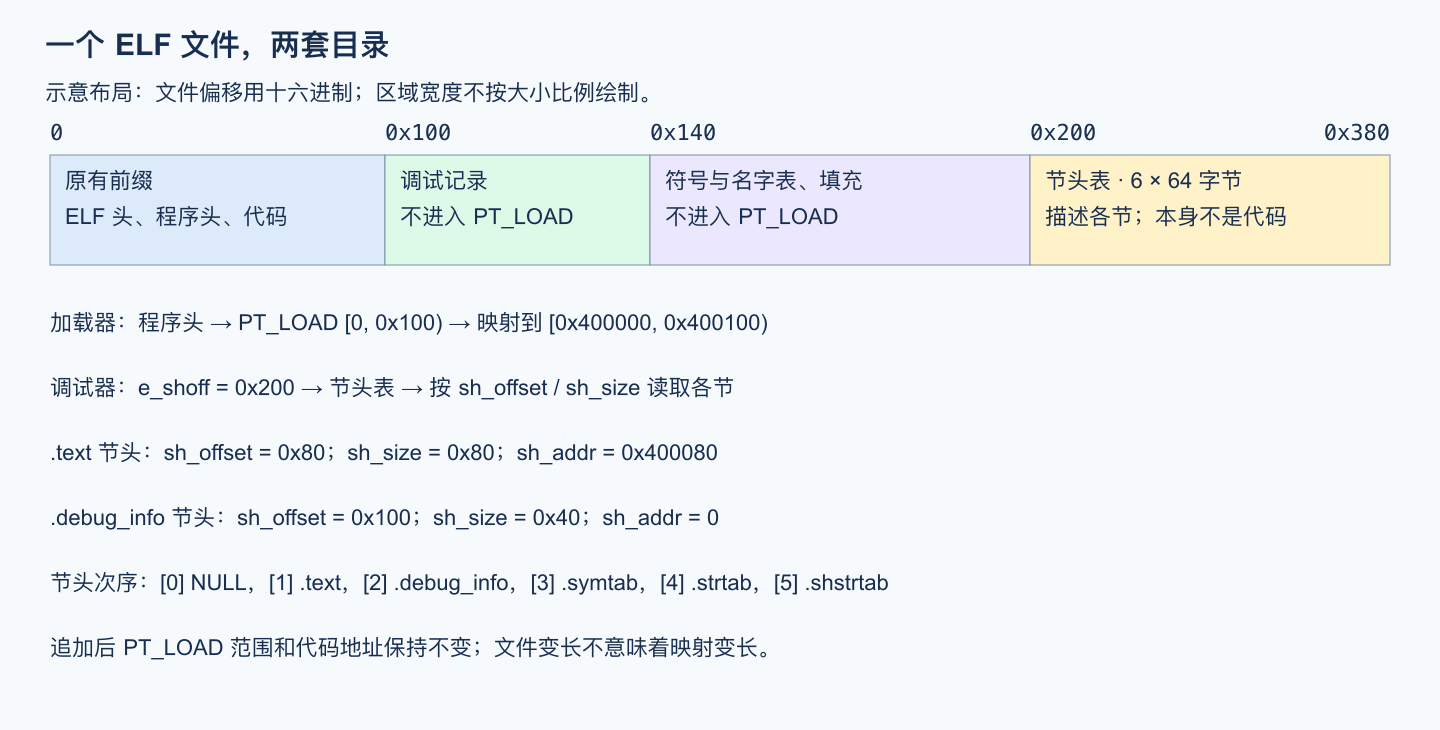
图中原文件前缀结束于 0x100,一个 RX 加载段把 [0, 0x100) 映射到 [0x400000, 0x400100)。.text 已经位于文件 [0x80, 0x100),地址为 0x400080。在前缀之后添加 .debug_info、符号与名字表,再添加六项节头,不需要移动这些代码字节。节头表位于 [0x200, 0x380);e_shoff=0x200 指向这张表,.text 的节头仍指向原来的 [0x80, 0x100),.debug_info 的节头则指向新写入的 [0x100, 0x140)。
这个示意布局把每个调试节的 sh_addr 设为 0,并让新增内容全部位于加载段之外。调试器读取 .debug_info 的位置由 sh_offset 和 sh_size 决定;其中的代码地址描述已有代码,并不表示这些调试字节也要放到该地址上。.symtab 的 sh_link 指向保存符号名的 .strtab;节头中的 sh_name 则引用另一张表 .shstrtab。这两种名字不能用同一组字符串偏移解释。
一般链接器可以在最初布局时同时安排加载节和非加载节;在已完成布局的映像后追加元数据,是另一种可行的组织方式。后者的前提是保留已有程序头、入口、代码与数据,并且不把新增调试字节计入 p_filesz 或 p_memsz。更新节表目录不会自动扩大映射;反过来,文件在磁盘上变长也不会改变这些程序头字段。因此,“仍能执行”与“调试器能正确解释”必须分别验证。
先分开两个问题:在哪里写,写入什么
一条调试重定位同时涉及源字段与目标对象。r_offset 指定待修补字段在当前输入节中的位置;符号与加数指定该字段要引用的目标。二者分别跟随自己的输入片段移动,不能共用一个基址。
考虑一个只拼接、不去重的示意布局。a.o 与 b.o 各提供 32 字节 .debug_info,于是 b.o 的记录从输出节偏移 32 开始。a.o 的 .debug_str 是四字节 a\0b\0,b.o 的 .debug_str 是八字节 cat\0dog\0;两者对齐均为 1,后者从输出字符串节偏移 4 开始。b.o 的一个代码节最终放在虚拟地址 0x401020。在 b.o 的 .debug_info 中假设有两个待修补字段:
| 输入字段位置 | 重定位 | 目标在输出中的坐标 | 最终值及小端字节 |
|---|---|---|---|
| 8,宽 4 字节 | R_X86_64_32,目标为 .debug_str 节符号,st_value=0, A=4 | 字符串片段起点 4,再前进 4 字节找到 dog | 8 → 08 00 00 00 |
| 12,宽 8 字节 | R_X86_64_64,目标为代码节符号,st_value=0, A=4 | 代码起点 0x401020,再前进 4 字节 | 0x401024 → 24 10 40 00 00 00 00 00 |
第一个字段写在输出 .debug_info[40..44],因为 32 + 8 = 40;第二个写在 [44..52],因为 32 + 12 = 44。若处理的是第二个输入对应的独立可变切片,仍使用原始 r_offset=8 和 12;若处理整个输出节,才把片段起点 32 加到写入位置上。两种实现都可以,混用会重复加偏移。
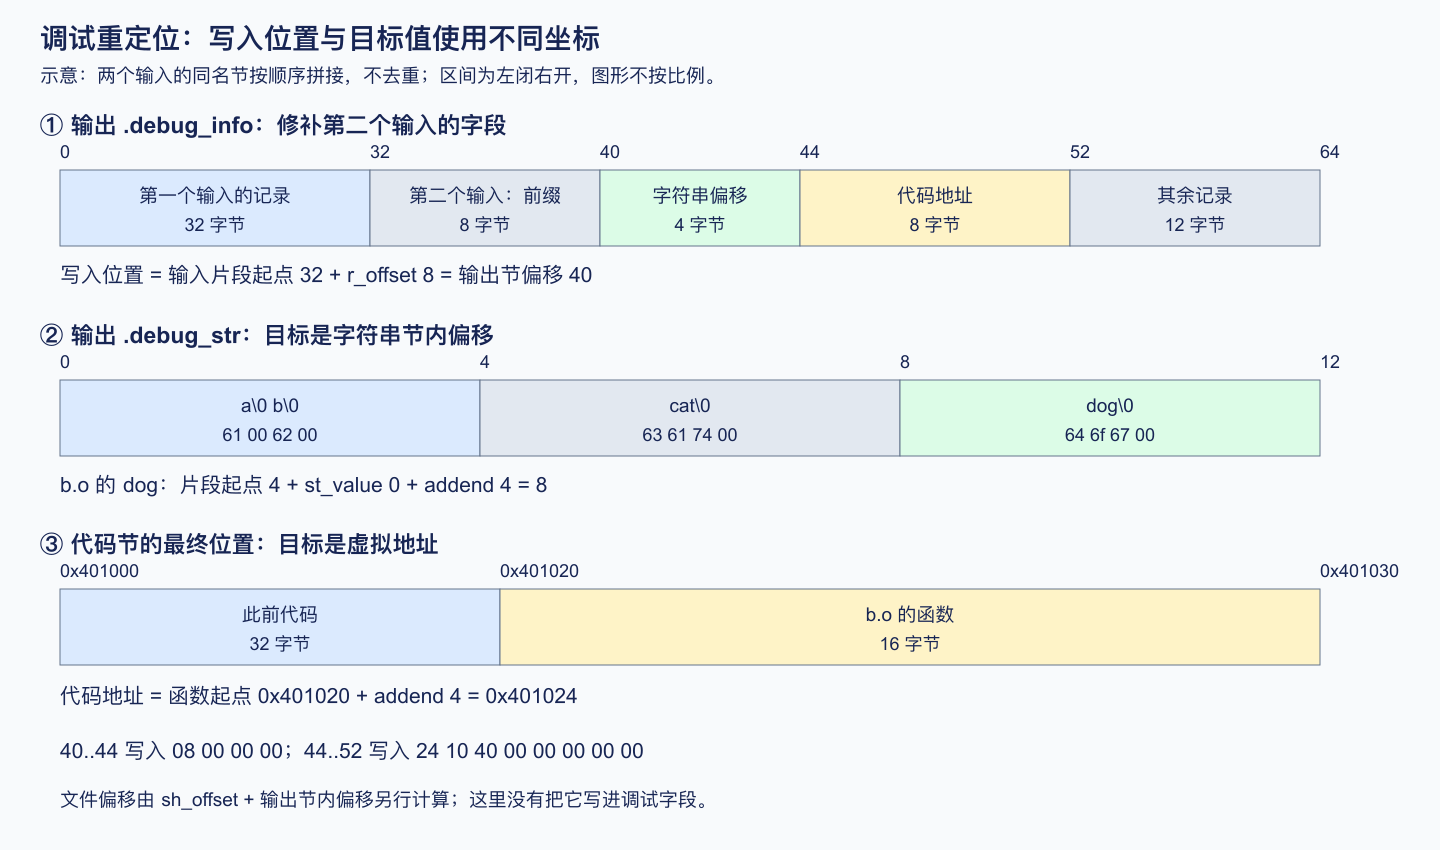
这几个数字还不是 ELF 文件偏移。若输出 .debug_info 的 sh_offset 是 F,第一个字段在文件中的位置才是 F + 40;它保存的仍是字符串偏移 8。调试器先从节头找到 .debug_str 的文件范围,再从其起点前进 8 字节。代码地址字段则描述程序地址空间中的位置。
字段宽度与目标含义是两个维度:这里四字节字段保存字符串偏移、八字节字段保存地址,但不能仅凭 R_X86_64_32 或 R_X86_64_64 判断含义。重定位类型规定计算与表示范围,目标节和 DWARF 的 form 决定结果如何被解释。若目标字符串经过去重,前面的 4 + 4 必须替换为输入字符串位置到输出位置的映射;若代码被删除,则按对应记录的 tombstone 约定处理,不能继续套用一个不存在的代码基址。DWARF 5 标准第 7 章规定这些引用形式。
PIE 的地址字段还要区分链接时与运行时。若图像按从零开始的地址布局链接,代码坐标 0x1024 写入调试信息;加载偏移为 0x55550000 时,调试器把它换算成运行时地址 0x55551024。这个偏移只适用于属于该图像的地址,不能加到 .debug_str 的节内偏移上。ELF 加载偏移是运行时地址与链接时虚拟地址之差,并不要求每一种 ET_DYN 图像都采用从零开始的布局。
不加载,却一样要重定位。看目标文件里的重定位表(只列出与调试节有关的几张,省略号处略去重复的项):
$ llvm-readelf -rW gc_clang.oRelocation section '.rela.debug_info' at offset 0x5c8 contains 6 entries:0000000000000008 000000060000000a R_X86_64_32 0000000000000000 .debug_abbrev + 00000000000000011 000000080000000a R_X86_64_32 0000000000000000 .debug_str_offsets + 80000000000000015 0000000c0000000a R_X86_64_32 0000000000000000 .debug_line + 00000000000000023 0000000a0000000a R_X86_64_32 0000000000000000 .debug_addr + 80000000000000027 000000070000000a R_X86_64_32 0000000000000000 .debug_rnglists + c000000000000002b 000000050000000a R_X86_64_32 0000000000000000 .debug_loclists + cRelocation section '.rela.debug_str_offsets' at offset 0x658 contains 10 entries:0000000000000008 000000090000000a R_X86_64_32 0000000000000000 .debug_str + 0000000000000000c 000000090000000a R_X86_64_32 0000000000000000 .debug_str + 27...Relocation section '.rela.debug_addr' at offset 0x748 contains 5 entries:0000000000000008 0000000f00000001 R_X86_64_64 0000000000000000 counter + 00000000000000010 0000000200000001 R_X86_64_64 0000000000000000 .text.used + 00000000000000018 0000000300000001 R_X86_64_64 0000000000000000 .text.unused + 00000000000000020 0000000400000001 R_X86_64_64 0000000000000000 .text._start + 00000000000000028 0000000400000001 R_X86_64_64 0000000000000000 .text._start + bRelocation section '.rela.debug_frame' at offset 0x7c0 contains 6 entries:000000000000001c 0000000b0000000a R_X86_64_32 0000000000000000 .debug_frame + 00000000000000020 0000000200000001 R_X86_64_64 0000000000000000 .text.used + 00000000000000034 0000000b0000000a R_X86_64_32 0000000000000000 .debug_frame + 00000000000000038 0000000300000001 R_X86_64_64 0000000000000000 .text.unused + 0...Relocation section '.rela.debug_line' at offset 0x850 contains 5 entries:0000000000000022 0000000d0000000a R_X86_64_32 0000000000000000 .debug_line_str + 0000000000000002e 0000000d0000000a R_X86_64_32 0000000000000000 .debug_line_str + 30000000000000048 0000000200000001 R_X86_64_64 0000000000000000 .text.used + 00000000000000066 0000000300000001 R_X86_64_64 0000000000000000 .text.unused + 00000000000000080 0000000400000001 R_X86_64_64 0000000000000000 .text._start + 0这组输入使用两种重定位,公式都是第 4 章的 S + A,没有 P。下文分别按目标坐标解释;这不是所有 DWARF 输入可使用的重定位类型的完整列表。
R_X86_64_64 指向代码和数据:.debug_addr 的每一项、.debug_line 每个序列开头 DW_LNE_set_address 的 8 字节操作数、.debug_frame 里每条 FDE12 的起始地址,最终要填成虚拟地址。这一类和代码里的重定位没有区别,S 是 .text.used 在输出里的地址。.text.unused + 0 那三条(偏移 0x18、0x38、0x66)就是墓碑的来源:目标节被 GC 删掉了,S 没有定义。
R_X86_64_32 指向别的调试节,填的是节内偏移:CU 头部记录它的缩写表从 .debug_abbrev 的哪里开始,.debug_str_offsets 记录每个字符串在 .debug_str 里的位置。多个目标文件的同名调试节被拼成一个输出节以后,第二个文件的 .debug_abbrev 不再从偏移 0 开始,这些偏移都要跟着改。这里的 S 是一个节符号的值。调试节的输出地址是 0,节符号的值就等于这块输入节在输出节里的起始偏移,S + A 算出的正好是输出里的偏移。目标若是 .debug_str 这样的 SHF_MERGE 节,事情多一步:重复的字符串被合并掉以后,.debug_str + 27 原来指向的字符串可能挪到了别处,链接器要按加数找到它属于哪一段字符串,再查这段字符串在输出里的新位置。
lld.out 里能直接看到这一步。gc_clang.o 的 .debug_str 里,"gc.c" 在偏移 0x27,.debug_str_offsets 的第二项重定位是 .debug_str + 27。输出里的 .debug_str 仍是 82 字节,字符串一个没少,顺序却变了:
$ llvm-readelf -x .debug_str_offsets lld.out0x00000000 2c000000 05000000 1d000000 08000000 ,...............0x00000010 0d000000 00000000 10000000 4d000000 ............M...0x00000020 46000000 16000000 14000000 44000000 F...........D...前 8 字节是这张表的头部(长度 0x2c、版本 5),第二项填的是 0x8,不再是输入偏移 0x27。导出输出的 .debug_str 逐个数,counter 在 0,gc.c 在 0x8,编译器版本串从 0x1d 开始。lld 默认用 MergeNoTailSection 处理这类节,按字符串的哈希值分成若干片,各片并行去重,再依次拼接(lld/ELF/SyntheticSections.cpp 的 MergeNoTailSection::finalizeContents),输出顺序因此与输入不同。这是允许的,只要每条重定位都换算到新位置。如果链接器偷懒按"输入节起点 + 加数"计算,gc.c 这个 CU 的文件名就会落到版本串中间。
这些重定位不能省:编译器生成目标文件时不知道它会和谁拼在一起,也不知道函数最后放在哪里。调试信息又描述程序里的几乎每个函数、变量、类型和每一段指令,所以重定位条数远比代码多。
TLS 变量的位置为什么不是一个固定地址
普通全局变量在一个进程中有一个存储位置;TLS 变量则在每个线程中各有一份。链接器能确定变量在所属模块的 TLS 布局中占第几个字节,却不能给所有线程写同一个运行时地址。原理篇 09中的模板与线程副本区分,在调试信息中同样成立。
设变量在模块 TLS 块内的偏移为 12,某线程的块起点为 B_thread。调试器要得到的是 B_thread + 12。若该 ABI 把 TP 放在块起点后 16 字节,机器指令可用 TP-relative 偏移 12 − 16 = −4 访问变量;调试表达式中的模块偏移仍然是 12。PIE 的加载偏移既不能替代 B_thread,也不参与这两个 TLS 偏移之间的换算。
在 ELF x86-64 的常见表达方式中,先用 DW_OP_const8u 压入模块偏移,再由 DW_OP_form_tls_address 转成当前线程的地址。以下是地址大小为 8、小端编码时的一段十字节位置表达式,不含外围 DWARF 属性的长度或 form:
| 表达式内字节 | 内容 | 含义 |
|---|---|---|
0 | 0e | DW_OP_const8u:读取后面的八字节常量并压栈 |
1..8 | 0c 00 00 00 00 00 00 00 | 模块内 TLS 偏移 12 |
9 | 9b | DW_OP_form_tls_address:借助运行时信息得到当前线程的实际地址 |
目标文件中的常量字段可由 DTPOFF 重定位修补。最终 ELF 中 STT_TLS 符号的 st_value 也保存 TLS 偏移,而不是普通符号使用的图像地址。调试器依据表达式所属的可执行文件或共享库选择 TLS 模块,再依据当前线程找到对应的存储块。
DWARF 并不统一规定所有平台如何找到这个块:DW_OP_form_tls_address 的输入解释和地址计算依赖运行时环境。因此,正确的模块偏移是必要条件;调试器还需要适用的运行时 TLS 发现机制,不能简单把数值加到 ELF 的加载基址上。DWARF 5 标准§2.5.1.4 规定了这个操作的语义与模块选择。
DWARF 5 少了多少重定位
以本例为准,DWARF32 的节偏移占 4 字节,地址占 8 字节。先区分属性的语义与 form:名字属性要得到字符串,地址属性要得到机器地址;form 决定记录里直接保存值,还是保存找到该值的索引。
| 编码形式 | DIE 中保存的内容 | 最终怎样得到值 |
|---|---|---|
| DW_FORM_strp | 4 字节的 .debug_str 节偏移 | 在字符串节的该位置读到 NUL 为止 |
| DW_FORM_addr | 8 字节地址 | 直接使用重定位后的地址 |
| DW_FORM_strx | 字符串表项的索引,宽度取决于具体 form | 从 .debug_str_offsets 读偏移,再访问 .debug_str |
| DW_FORM_addrx | 地址表项的索引,宽度取决于具体 form | 从 .debug_addr 读地址 |
DWARF 4 的 strp 和 addr 把要修补的字段放在每个使用它们的 DIE 中。DWARF 5 的索引形式让多个 DIE 共用表项,重定位集中在表中;索引本身不是地址,也不是字符串字节偏移。DW_AT_str_offsets_base 和 DW_AT_addr_base 指定该 CU 的表项区域起点。这里两者都是相应表头之后的 +8,不是整个 ELF 文件的偏移。
以上面的输出 .debug_str_offsets 为例,跟踪索引 1:
| 步骤 | 数值 | 相对于谁 |
|---|---|---|
| CU 的字符串表项起点 | 8 | .debug_str_offsets 开头 |
| 第 1 项的位置 | 8 + 1 × 4 = 12 | .debug_str_offsets 开头 |
| 该项四字节 08 00 00 00 | 8 | .debug_str 开头 |
| 读取字符串 | gc.c | 从 .debug_str[8] 读到 NUL |
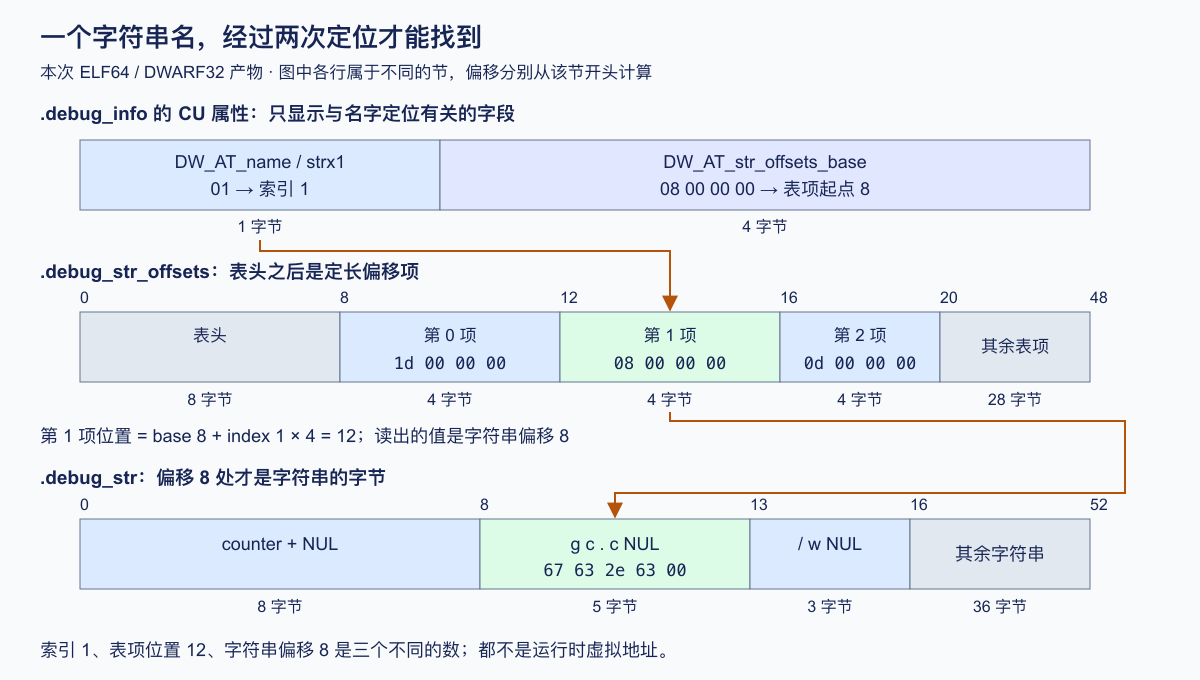
输入中该字符串在 0x27,合并后在 0x8,链接器改的是表项中的字符串偏移;使用它的 DIE 仍可保存索引 1。地址索引同样多走一层,但这里每项宽度是 8 而非 4。DWARF64 会改变节偏移宽度,不能把本例的 4 写成所有记录的固定规则。DWARF 5 标准第 7.4、7.5.5 节给出格式与 form 的精确定义。
范围列表也能引用共享地址表,例如 DW_RLE_startx_length 保存地址表索引与范围长度。这解释了重定位条数为何可能减少:同一个值被复用时,可以只修补公共表项;具体节省量仍取决于编译器选择与程序内容。
拿一个真实一点的程序比较。下面在同一台 Linux 上用 Clang 21,显式选择 RISC-V13 目标,把 xv614 内核(与第 10 章同一个提交 06aad25)的 27 个源文件各编译一遍,选项照抄 xv6 Makefile 里与代码生成有关的那些,只把 -ggdb -gdwarf-2 换成 -gdwarf-4 或 -gdwarf-5,另加 -mno-relax 和 -mabi=lp64d,与第 10 章一致,再加上同样的 -fdebug-prefix-map;链接用 ld.lld 和 kernel.ld;统计 27 个目标文件里的重定位:
$ sh analyze.sh--- 目标文件里的重定位条数(全部 27 个 .o 合计)g0 共 1471 条,其中 .rela.debug_* 0 条dw4 共 9322 条,其中 .rela.debug_* 7851 条dw5 共 7895 条,其中 .rela.debug_* 6424 条--- 按节细分(dw4 / dw5)[dw4]5375 .rela.debug_info2120 .rela.debug_line 350 .rela.debug_frame 6 .rela.debug_aranges[dw5]2319 .rela.debug_line2278 .rela.debug_str_offsets1329 .rela.debug_addr 350 .rela.debug_frame 142 .rela.debug_info 6 .rela.debug_arangesxv6 是 RISC-V 程序,前面的 R_X86_64_32、R_X86_64_64 在这里叫 R_RISCV_32、R_RISCV_64,含义相同。不带 -g 时整个内核只有 1471 条重定位。DWARF 4 下调试节的重定位是它的 5 倍多,其中 .debug_info 的 5375 条按类型分是 3890 条 R_RISCV_32(几乎都是 DW_FORM_strp)和 1485 条 R_RISCV_64(地址)。到了 DWARF 5,.debug_info 自己只剩 142 条,字符串和地址的重定位搬进了两张表,分别是 2278 和 1329 条,三者合计 3749 条,比 5375 少了三成。调试节总共少了 1427 条,约 18%。
.debug_line 反而多了。DWARF 5 的行号表头部也改用 DW_FORM_line_strp 引用 .debug_line_str 里的文件名,多出 199 条 R_RISCV_32。另外两千多条是 RISC-V 特有的:1047 对 R_RISCV_ADD16 和 R_RISCV_SUB16。第 4 章讲过,RISC-V 的链接器松弛会删掉指令字节,两个标号之间的距离要到链接时才确定,行号表里"地址前进多少"这样的差值就得写成一对重定位,链接器算出 S(甲) − S(乙) 再填进去。Clang 21 在 -mno-relax 下照样这么生成(用 kernel/string.c 按同样的选项单独试过,-mno-relax 和 -mrelax 都是 38 对)。本章 x86-64 工具链的常见松弛保持指令序列长度,因此这里的行号表每个序列只在开头带一条 R_X86_64_64;不能把这个例子推广为所有架构或所有代码变换都不改变长度。
在这批输入中,间接表明显减少了 .debug_info 的重定位,而行号差值仍占据较大份额,因此总降幅是 18%。收益取决于生成了哪些 DWARF 形式及目标架构需要哪些修补,不能只凭版本号推断。
多份字符串怎样共用存储
前面的单个输入已经展示了字符串位置变化;在刚才构建的 xv6 多文件产物中,链接还会消除重复内容。xv6 的 27 个 DWARF 5 目标文件里,.debug_str 合计 16131 字节,输出里只有 4706 字节:
--- .debug_str 合并:输入合计 / 输出输入合计 16131输出 4706-O2 输出 4248每个 CU 都带着自己的一份 "int"、"char"、编译器版本串 "Ubuntu clang version 21.1.8 (6ubuntu1)"、编译目录,以及公共头文件里的类型名和结构体成员名,合并以后各剩一份,省掉了七成。lld 加 -O2 还会做尾部合并:如果一个字符串恰好是另一个字符串的结尾,比如 "lock" 之于 "spinlock",前者就不必单独存放,直接指向后者的后半段。-O2 的输出里已经找不到单独的 "lock\0",DW_AT_name ("lock") 照样读得出来,总共又省下 458 字节。只有 -O2 时 lld 才为这类节选用 MergeTailSection(lld/ELF/OutputSections.cpp 第 192 行),它把所有字符串交给 StringTableBuilder,单线程地做一次多键排序(multikeySort),排完序才能找出谁是谁的结尾;默认的 MergeNoTailSection 按哈希分片并行去重,快得多。合并是这一节和前面重定位那一节的交汇点:.debug_str_offsets 里每条 R_X86_64_32 .debug_str + 加数,链接器都要按加数在原输入节里找到它属于哪个字符串,再换成这个字符串在输出里的新位置。
体积:比代码大几倍的数据
重定位多,是因为数据多。还是用上面那几个 xv6 内核,llvm-size -A 列出每个节的大小,analyze.sh 把 .debug_* 加起来:
$ sh analyze.shbuild-g0/kernel 文件 64792 字节;0 个 .debug_* 节,合计 0 字节build-dw4/kernel 文件 360792 字节;8 个 .debug_* 节,合计 168795 字节build-dw5/kernel 文件 313312 字节;11 个 .debug_* 节,合计 139890 字节...$ llvm-size -A build-g0/kernelsection size addr.text 36864 2147483648.rodata 1776 2147520512.data 4 2147522288.bss 103256 2147522304要从文件装进内存的只有 .text、.rodata、.data,合计 38644 字节(.bss 在文件里不占空间)。DWARF 5 的调试节是它的 3.6 倍,DWARF 4 是 4.4 倍。第 10 章 GNU 工具链构建的内核用的是 GCC 和 -gdwarf-2,调试节是装载内容的 7.5 倍。
两个版本逐节比较:
[dw4] [dw5] .debug_info 66815 .debug_info 45562 .debug_abbrev 12074 .debug_abbrev 12182 .debug_aranges 144 .debug_aranges 144 .debug_line 25263 .debug_line 26874 .debug_loc 44865 .debug_line_str 674 .debug_str 4650 .debug_loclists 17037 .debug_frame 11352 .debug_str_offsets 9296 .debug_ranges 3632 .debug_str 4706 .debug_addr 10816 .debug_frame 11352 .debug_rnglists 1247DWARF 5 少掉的 28905 字节主要来自位置列表和 .debug_info。.debug_loc 每一项都写两个 8 字节的地址值,这批 Clang 生成的 DWARF 4 文件里它们是相对 CU 基地址的偏移(所以目标文件里没有 .rela.debug_loc 和 .rela.debug_ranges),.debug_loclists 可以写成"相对基地址的 ULEB12815 偏移"或".debug_addr 的下标加长度";.debug_info 里 4 字节的 strp 偏移和 8 字节的地址换成了一两个字节的下标,代价是多出 .debug_str_offsets 和 .debug_addr 两张表。
文件大小还有一处差别和调试节有关。build-dw5/kernel 的 .symtab 有 104448 字节,不带 -g 的只有 15192 字节,多出的三千七百多个符号是编译器为上一节那些 ADD16/SUB16 重定位生成的本地标号,名字大部分是 .L0 ,lld 默认把它们留在了符号表里。链接时加 -X(--discard-locals)可以丢掉这些本地标号。
压缩调试节
调试信息经常需要长期存放和分发,压缩可以减少磁盘占用和传输量;代价是写入时压缩、读取时解压,以及工具必须支持所选格式。这件事经过两代格式。按 MaskRay 的整理(Compressed debug sections),2007 年 gold 的开发者之一 Craig Silverstein 先加了压缩选项,2008 年定成把节改名为 .zdebug_* 的格式,2010 年 Cary Coutant 给 gas 加上 --compress-debug-sections。改节名的办法有个毛病:每个读调试信息的工具都要认识另一套节名,而且压缩与否和节的类型、标志无关,只能靠名字猜。2012 年 gABI16 加入了一种通用的格式,用节标志 SHF_COMPRESSED(0x800)表示"这个节的内容是压缩过的",节名不变;binutils17 2.26 起 --compress-debug-sections=zlib 指的就是这种格式。2022 年 gABI 又接受了 zstd。它提供另一组压缩率、速度与内存占用的取舍,实际效果需要结合数据和压缩级别测量,lld 16 开始支持 --compress-debug-sections=zstd(zstd compressed debug sections)。
gABI 第 4 章 规定,带 SHF_COMPRESSED 的节以一个压缩头开头,后面紧跟压缩数据:
typedef struct { Elf64_Word ch_type; // 算法:ELFCOMPRESS_ZLIB = 1,ELFCOMPRESS_ZSTD = 2(见正文) Elf64_Word ch_reserved; Elf64_Xword ch_size; // 解压后的大小 Elf64_Xword ch_addralign; // 解压后的对齐} Elf64_Chdr;ELFCOMPRESS_ZLIB 的值 1 写在上面这个 gABI 页面里;那个页面停在 2013 年的版本,ELFCOMPRESS_ZSTD 的值 2 见 MaskRay 的 zstd 那篇文章和 generic-abi 邮件组的讨论,下面的实测也是 2。节头里的 sh_size 和 sh_addralign 描述的是压缩后的样子,解压后的大小和对齐由压缩头提供。gABI 还规定它只能用于不加载的节,不能和 SHF_ALLOC 同时出现,也不能用于 SHT_NOBITS。
用同一批 DWARF 5 目标文件,只在链接命令上加一个选项:
$ ld.lld -z max-page-size=4096 -T kernel/kernel.ld --compress-debug-sections=zlib -o kernel-zlib build-dw5/*.o$ ld.lld -z max-page-size=4096 -T kernel/kernel.ld --compress-debug-sections=zstd -o kernel-zstd build-dw5/*.o$ llvm-readelf -SW kernel-zlib | grep ' \.debug_info ' [ 6] .debug_info PROGBITS 0000000000000000 00a768 0066c1 00 C 0 0 1$ llvm-readelf -x .debug_info kernel-zlib | head -4Hex dump of section '.debug_info':0x00000000 01000000 00000000 fab10000 00000000 ................0x00000010 01000000 00000000 78019cbd 797c1c57 ........x...y|.W$ llvm-readelf -x .debug_info kernel-zstd | head -4Hex dump of section '.debug_info':0x00000000 02000000 00000000 fab10000 00000000 ................0x00000010 01000000 00000000 28b52ffd 60fab05d ........(./.`..](这里和后面的 build-dw5/*.o 是简写,脚本里按 Makefile 的 OBJS 顺序逐个列出。)Flg 列的 C 就是 SHF_COMPRESSED。按小端序读压缩头:ch_type 为 1 和 2,ch_size 都是 0xb1fa,即 45562 字节,和未压缩的 .debug_info 一样大,ch_addralign 为 1。从第 24 字节起是压缩数据本身:zlib 流的开头两字节 78 01,第二个字节的高两位为 0,表示用的是最快的压缩级别,与 MaskRay 文中"lld 19 起默认用 Z_BEST_SPEED"一致;zstd 帧以魔数 28 b5 2f fd 开头。
整体效果:
kernel-zlib 文件 238320 字节;11 个 .debug_* 节,合计 64902 字节kernel-zstd 文件 234896 字节;11 个 .debug_* 节,合计 61472 字节调试节从 139890 字节压到 46% 和 44%。各节差别很大(按节头里的大小算,含 24 字节的压缩头)。zstd 下压得最狠的是 .debug_addr,10816 字节压到 2310 字节,21%;其次是 .debug_abbrev 23%、.debug_frame 24%、.debug_str_offsets 30%。这几个节的内容高度重复:.debug_addr 里的地址都在 0x80000000 附近,每 8 字节里有好几个字节相同;缩写表反复描述同几种 DIE;每条 FDE 的结构也大同小异。.debug_info 只压到 53%。.debug_str 也只压到 50.6%,zlib 下是 51.8%,和 .debug_info 的 57.7% 相近,因为链接器已经把重复的字符串去掉了,剩下的都只出现一次。
压缩也会出现在链接器的输入端。本机 as --help 明确显示 Default: none,开头的 gc_gcc.o 没有压缩。为了测试压缩输入,沿用同一编译选项,额外加 -gz=zlib 生成 gc_gcc_z.o。gas 仍会在压缩无收益时保留原样,不能假设每个调试节都带 C:
$ gcc -O1 -g -ffunction-sections -fno-pic -fno-asynchronous-unwind-tables \ -fdebug-prefix-map="$PWD"=/w -gz=zlib -c gc.c -o gc_gcc_z.o$ readelf -SW gc_gcc_z.o | grep -E '\.debug_.*[[:space:]][A-Z]*C[A-Z]*[[:space:]]' [10] .debug_info PROGBITS 0000000000000000 000080 000091 00 C 0 0 8 [12] .debug_abbrev PROGBITS 0000000000000000 000118 0000a2 00 C 0 0 8 [15] .debug_aranges PROGBITS 0000000000000000 0001e0 000035 00 C 0 0 8 [19] .debug_line PROGBITS 0000000000000000 000240 00007b 00 C 0 0 8 [21] .debug_str PROGBITS 0000000000000000 0002c0 0000e3 01 MSC 0 0 8 [26] .debug_frame PROGBITS 0000000000000000 000400 000040 00 C 0 0 8这里 .debug_str 的标志是 MSC,它同时可合并、装字符串且已压缩;只匹配独立的 C 会漏掉它。把 gc_gcc_z.o 分别交给 ld --gc-sections 与 ld.lld --gc-sections,输出里一个 C 都没有。gABI 那一节写明,指向压缩节的重定位给出的都是未压缩数据里的偏移,"It is therefore necessary to decompress the section data before relocations can be applied"。链接器先解压所有输入,重定位、合并,再按自己的选项决定输出压不压;GNU ld 的 --compress-debug-sections 默认是 none。MaskRay 提醒过这里的一个浪费:编译和链接一步完成时给 -gz,汇编器刚压缩完的节马上又被链接器解压。
压缩后的文件,读的工具都要会解压。objcopy --decompress-debug-sections 能把它还原。这里的输入是 RISC-V ELF,因此明确使用支持该格式的本机 llvm-objcopy:
$ llvm-objcopy --decompress-debug-sections kernel-zlib kernel-unzkernel-unz 文件 291560 字节;11 个 .debug_* 节,合计 139890 字节调试节总量回到 139890 字节,.debug_info、.debug_line、.debug_str、.debug_addr 四个节用 --dump-section 导出来和 build-dw5/kernel 逐字节比较,完全相同。文件比原来小 21752 字节,那是 llvm-objcopy 重建 .strtab 时合并了重复的符号名,和调试节无关:.strtab 从 0x5f92 字节变成 0xa9a 字节,前面那些本地标号里有 3458 个都叫 .L0 。代价落在读的一方:MaskRay 文中说 gdb 和 lldb 解压调试节都不是并行的,大程序第一次加载调试信息会慢一些。
链接时直接丢弃调试信息
如果产物根本不需要源码级调试信息,还可以在链接时直接舍弃它。GNU ld 和 lld 都有 -S(--strip-debug)。它和第 8 章事后运行的 strip --strip-debug 结果相近,过程不同:lld 在读完输入、开始布局之前,就把所有调试节和指向它们的重定位节从输入列表里删掉(lld/ELF/Driver.cpp,注释是"We do not want to emit debug sections if --strip-all or --strip-debug are given"),后面的解压、合并、重定位都不必做。对 xv6 的 dw5 目标文件:
--- 链接时 -S172568 字节,.debug 节 0 个比 313312 字节小了 140744 字节,即 139890 字节的调试节,加上它们的节头和节名。.symtab 还在,-s(--strip-all)才会连它一起去掉。
把调试信息挪出去
压缩能省一半,可调试信息依旧和程序一起发到每台机器上,而绝大多数机器从来不调试。第 8 章"从地址到函数名和行号"一节末尾提到了发行版的办法:程序和调试信息分开存放,需要时再配对。这一节仍在同一台 x86-64 Linux 上进行,使用 GCC 15.2、GNU binutils 2.46 和 GDB 17.1。程序是两个文件:
// main.c#include <stdio.h>
int add(int a, int b);
int main(void) { int s = add(40, 2); printf("%d\n", s); return 0;}// util.cint add(int a, int b) { int s = a + b; return s;}objcopy --only-keep-debug 产生调试文件,--strip-debug 产生去掉调试信息的程序,--add-gnu-debuglink 在程序里记下调试文件的名字:
$ gcc -O0 -g main.c util.c -o prog$ mkdir -p dbg$ objcopy --only-keep-debug prog dbg/prog.debug$ objcopy --strip-debug --strip-unneeded prog dbg/prog$ objcopy --add-gnu-debuglink=dbg/prog.debug dbg/prog$ ls -l prog dbg/prog dbg/prog.debug-rwxr-xr-x 1 root root 14568 Oct 6 14:18 dbg/prog-rwxr-xr-x 1 root root 9848 Oct 6 14:18 dbg/prog.debug-rwxr-xr-x 1 root root 17696 Oct 6 14:18 prog$ readelf -SW dbg/prog.debug | grep -E '\.text|\.data |\.debug_info' [14] .text NOBITS 0000000000001060 001000 000145 00 AX 0 0 16 [25] .data NOBITS 0000000000004000 001db8 000010 00 WA 0 0 8 [29] .debug_info PROGBITS 0000000000000000 0011ee 00015e 00 0 0 1--strip-unneeded 还去掉了 .symtab 里重定位用不到的符号,效果和第 8 章的默认 strip 接近。调试文件里保留了所有节头,.text、.data 的地址和大小都在,类型却改成了 NOBITS,不占文件空间。调试器靠这些节头知道每个地址属于哪个节,内容去原程序里读。
.gnu_debuglink
$ readelf -x .gnu_debuglink dbg/prog 0x00000000 70726f67 2e646562 75670000 43ddf805 prog.debug..C...这个节不加载,内容是不带目录的文件名 prog.debug、一个结尾的 0、补齐到 4 字节的填充,最后是 4 字节的 CRC 校验值(循环冗余校验,对一段数据算出的 4 字节摘要,用来发现内容有没有被改过),按程序本身的字节序存放(gdb 手册:Separate Debug Files)。CRC 是 IEEE 802.3 定义的 CRC-32,对整个调试文件计算,和 zlib 的 crc32 是同一个函数。在主机上算一下:
$ python3 -c "import zlib; print(hex(zlib.crc32(open('dbg/prog.debug','rb').read())))"0x05f8dd43小端序写下来就是 43 dd f8 05。进入 dbg/ 目录,用 gdb 打开那里的 prog(set verbose on 让它报告读了哪个文件):
$ cd dbg$ gdb -q -batch -iex "set verbose on" -ex "info line add" ./progReading symbols from ./prog...Reading symbols from <work>/gdb/dbg/prog.debug...Line 1 of "util.c" starts at address 0x1187 <add> and ends at 0x1195 <add+14>.$ gdb -q -batch -ex "break add" -ex run -ex bt ./progBreakpoint 1 at 0x1195: file util.c, line 2.
Breakpoint 1, add (a=40, b=2) at util.c:22 int s = a + b;#0 add (a=40, b=2) at util.c:2#1 0x0000555555555164 in main () at main.c:6dbg/prog 自己没有一个 .debug_* 节,gdb 却拿到了行号和参数。CRC 的作用是确认找到的文件确实配得上:在 prog.debug 末尾追加一个字节,gdb 就拒绝使用它(见练习三);反过来,CRC 对得上并不能证明调试文件来自同一次构建,练习三的答案里有一个反例。debuglink 只有文件名,gdb 按手册的顺序在三处找:程序所在目录、该目录下的 .debug 子目录、全局调试目录(Debian 上是 /usr/lib/debug)下与程序绝对路径同名的子目录。
build-id
文件名可能重复,CRC 要把候选文件整个读一遍才算得出来。更直接的办法是给每次链接的产物一个标识。第 6 章提过 build-id:链接器按所选策略生成一串标识字节,写进一个 SHT_NOTE 类型的附注节 .note.gnu.build-id。附注的格式是三个 4 字节字段(名字长度、内容长度、类型)后跟名字和内容,各自补齐到 4 字节;build-id 的名字是 "GNU\0",类型是 3(NT_GNU_BUILD_ID)。Debian 的 GCC 驱动程序默认给链接器传 --build-id:
$ readelf -n prog | grep -A1 'Build ID' Build ID: 2495a430d7ed99859a8031169dc0c57b36a5d18f本例的标识在链接时生成,随后的 strip、objcopy 操作保留它,dbg/prog 和 dbg/prog.debug 里是同一个值。gdb 先按 build-id 找,再按 debuglink 找。路径规则是“全局调试目录/.build-id/前两个十六进制位/其余位.debug”。仍在刚才的 dbg 目录中执行下列命令:从本次 prog 提取标识,建立自己的 debug-root,再移动配套文件,不需要使用示例里的临时路径或哈希。若 test 报告标识为空,先停止后面的操作;没有 build ID 的输入可以在构建时给 GCC 增加 -Wl,--build-id=sha1。
$ DEBUG_ROOT="$PWD/debug-root"$ BUILD_ID=$(LC_ALL=C readelf -n ./prog | sed -n 's/.*Build ID: //p')$ test -n "$BUILD_ID"$ ID_PREFIX=$(printf '%s' "$BUILD_ID" | cut -c1-2)$ ID_REST=$(printf '%s' "$BUILD_ID" | cut -c3-)$ mkdir -p "$DEBUG_ROOT/.build-id/$ID_PREFIX"$ mv prog.debug "$DEBUG_ROOT/.build-id/$ID_PREFIX/$ID_REST.debug"$ gdb -q -batch -iex "set debug-file-directory $DEBUG_ROOT" -iex "set verbose on" -ex "info line add" ./progReading symbols from ./prog...Reading symbols from <work>/gdb/debug-root/.build-id/24/95a430d7ed99859a8031169dc0c57b36a5d18f.debug...Line 1 of "util.c" starts at address 0x1187 <add> and ends at 0x1195 <add+14>.dbg/ 下已经没有 prog.debug,gdb 是靠 build-id 找到的。发行版的调试包装的就是这样一棵目录树,apt install 一个 -dbgsym 包,文件落在 /usr/lib/debug/.build-id/ 下。按前两位分子目录,几万个调试文件就分散到 256 个目录里。
示例源码生成独立临时产物,检查程序输出、debuglink 字节与 CRC、三个文件的 build ID,以及移动前后的 GDB 行号查找。在仓库根目录运行:
前述命令它验证这两条查找路径,不验证所有 DWARF 记录或压缩格式。图表中的地址和哈希是一份输出的示例;实际验证读取当前产物的值。
build-id 怎么算,各链接器不同。GNU ld 手册列出的方式有 uuid(128 位随机数)、md5、sha1 和 0x十六进制串,不写时用 sha1,并说明哈希只覆盖输出内容中"normative parts"(ld 选项)。binutils 2.44 又加了 xx,128 位的 xxhash,前提是构建 binutils 时带了 xxhash 库(ld/NEWS);本机 GNU ld 2.46 构建时没带,给 --build-id=xx 只得到警告"unrecognized --build-id style ignored"。fast 是 lld 独有的,GNU ld 同样不认。lld 的四种:
$ ld.lld --build-id=fast gc_clang.o -o bid_fast # 其余三种同理Build ID: 3766c4b8eafacf85Build ID: 45b90fa2462c4cef8a8bf744513a273fBuild ID: 2eaa355b447f5014608cb56f62da3e3670a58cf4Build ID: ac6f01e4aa68b7d753769193717cd1fe四行依次是 fast、md5、sha1、uuid,长度分别是 8、16、20、16 字节;uuid 每次链接都不同,读者重跑会得到另一个值。查 lld 21.1.8 的 Writer.cpp 的 writeBuildId:fast 用的是 64 位的 xxh3(xxh3_64bits,一种不追求密码学强度、只求快的哈希);md5 和 sha1 这两个名字只决定长度,实际都用 BLAKE3(一种比 SHA-1 快得多的密码学哈希)计算,注释说 build-id 不需要抗碰撞之类的密码学性质,"In practice people use 'md5' and 'sha1' just for different lengths"。所以 lld 的"sha1"值和对文件算 SHA-1 的结果对不上,这不影响它的用途。lld 还把输出切成 1 MiB 的块并行计算,第 16 章会讲这种做法。
还有一种折中做法:只想让崩溃时的调用栈有函数名,不需要行号和变量。gdb 手册的 MiniDebugInfo 一节描述了它:从完整的符号表里挑出 .dynsym 没有的那些函数符号,做成一个小 ELF 文件,用 LZMA(xz)压缩后塞进程序的 .gnu_debugdata 节,gdb 在找不到其他调试信息时会用它。它仍是一个不加载的节,只装函数符号,比完整的调试信息小得多,却足以让 gdb 给一个去掉了 .symtab 的程序的调用栈补上函数名。
两种找法各有用处。debuglink 不依赖链接器,任何时候都能用 objcopy 补上;build-id 不依赖文件名,崩溃收集系统只要从内存里的程序头找到 PT_NOTE 段(程序头里标记"这里是附注"的那一项;附注节本身带 SHF_ALLOC,落在某个 PT_LOAD 里,运行时就在内存中)读出 build-id,就能去服务器上取对应的调试文件。elfutils 在 2019 年推出的 debuginfod 就是这样一种服务器,按 build-id 通过 HTTP 提供调试文件和源码,gdb 用 set debuginfod enabled on 打开(MaskRay: Distribution of debug information)。
split DWARF:让链接器根本不读
分离调试文件解决的是发布的问题,构建时的负担一点没少:链接器照样要读进全部调试节,解压、拼接、合并字符串、做几千条重定位,最后才由 objcopy 把它们挪走。MaskRay 在压缩调试节那篇文章里统计过一个大型项目的目标文件:合计 1464767464 字节,其中 .debug_* 占 631069751 字节,.rela.debug_* 又占 78448968 字节,两者加起来接近一半。能不能让它们一开始就不经过链接器?
split DWARF 就是这样做的。它最早作为 GCC 的 debug fission 提出,后来在 DWARF 5 里标准化为"split DWARF object files"(MaskRay: Distribution of debug information)。加上 -gsplit-dwarf,编译器把调试信息的大部分写进与目标文件同名的 .dwo 文件,目标文件里只留一个骨架单元(skeleton CU),它是一个只有寥寥几个属性的 CU,作用是告诉调试器去哪里找其余的调试信息。仍在本机 Linux 上执行:
$ gcc -O0 -g -gsplit-dwarf -c ../main.c ../util.c$ ls -l *.o *.dwo-rw-r--r-- 1 root root 1648 Oct 6 14:18 main.dwo-rw-r--r-- 1 root root 3808 Oct 6 14:18 main.o-rw-r--r-- 1 root root 1352 Oct 6 14:18 util.dwo-rw-r--r-- 1 root root 3256 Oct 6 14:18 util.o$ readelf -SW util.dwo | grep debug[ 1] .debug_info.dwo PROGBITS 0000000000000000 000040 000065 00 E 0 0 1 [ 2] .debug_abbrev.dwo PROGBITS 0000000000000000 0000a5 000060 00 E 0 0 1 [ 3] .debug_line.dwo PROGBITS 0000000000000000 000105 00005d 00 E 0 0 1 [ 4] .debug_str_offsets.dwo PROGBITS 0000000000000000 000162 000014 00 E 0 0 1 [ 5] .debug_str.dwo PROGBITS 0000000000000000 000176 0000e6 00 E 0 0 1.dwo 也是 ELF 文件,节名多了 .dwo 后缀,Flg 列的 E 是第 5 章见过的 SHF_EXCLUDE,交给链接器也不放进输出。它没有任何 .rela 节。这正是上一节那两张间接表的用处:.dwo 里的 DIE 引用字符串用 strx,指向 .dwo 自己的 .debug_str_offsets.dwo,偏移在编译时就定了;引用地址用 addrx,下标指向的 .debug_addr 却留在目标文件里。凡是需要链接器填的东西,都留在目标文件这一边:
$ readelf -SW util.o | grep debug [ 4] .debug_addr PROGBITS 0000000000000000 00005e 000010 00 0 0 1 [ 5] .rela.debug_addr RELA 0000000000000000 000350 000018 18 I 24 4 8 [ 6] .debug_info PROGBITS 0000000000000000 00006e 000035 00 0 0 1 [ 7] .rela.debug_info RELA 0000000000000000 000368 000090 18 I 24 6 8 [ 8] .debug_abbrev PROGBITS 0000000000000000 0000a3 000015 00 0 0 1 [ 9] .debug_gnu_pubnames PROGBITS 0000000000000000 0000b8 00001b 00 0 0 1 [10] .rela.debug_gnu_pubnames RELA 0000000000000000 0003f8 000018 18 I 24 9 8 [11] .debug_gnu_pubtypes PROGBITS 0000000000000000 0000d3 00001b 00 0 0 1 [12] .rela.debug_gnu_pubtypes RELA 0000000000000000 000410 000018 18 I 24 11 8 [13] .debug_aranges PROGBITS 0000000000000000 0000ee 000030 00 0 0 1 [14] .rela.debug_aranges RELA 0000000000000000 000428 000030 18 I 24 13 8 [15] .debug_line PROGBITS 0000000000000000 00011e 000056 00 0 0 1 [16] .rela.debug_line RELA 0000000000000000 000458 000078 18 I 24 15 8 [17] .debug_str PROGBITS 0000000000000000 000174 000028 01 MS 0 0 1 [21] .debug_line_str PROGBITS 0000000000000000 0001e8 000030 01 MS 0 0 1骨架单元的 .debug_info 里只有一个 DIE,标签是 DW_TAG_skeleton_unit。链接以后看:
$ gcc main.o util.o -o sp$ readelf --debug-dump=info sp | grep -E 'skeleton|dwo_name|comp_dir' | head -6 <0><14>: Abbrev Number: 1 (DW_TAG_skeleton_unit) <29> DW_AT_dwo_name : (indirect string, offset: 0): main.dwo <2d> DW_AT_comp_dir : (indirect string, offset: 0x9): <work>/gdb/sp <0><49>: Abbrev Number: 1 (DW_TAG_skeleton_unit) <5e> DW_AT_dwo_name : (indirect string, offset: 0x28): util.dwo <62> DW_AT_comp_dir : (indirect string, offset: 0x9): <work>/gdb/spDW_AT_dwo_name 加上编译目录 DW_AT_comp_dir,告诉调试器去哪里找 .dwo;CU 头部还有一个 8 字节的 dwo_id,两边各存一份,用来核对配对。.debug_line 留在骨架里,因为它要装最终地址。gdb 按这条线索找到 .dwo,断点、回溯和单个文件时完全一样。把两个 .dwo 挪走再试:
$ mv *.dwo ../hide/$ gdb -q -batch -ex "break add" -ex run -ex bt ./sp...warning: Could not find DWO CU util.dwo(0xddb1cdcd594bf238) referenced by CU at offset 0x35 [in module <work>/gdb/sp/sp]...42[Inferior 1 (process 1645606) exited normally]No stack.括号里的 0xddb1cdcd594bf238 就是 dwo_id。断点没设上,程序直接跑完了。骨架记录了定位 .dwo 的文件名与目录线索;移动构建产物时,需要一并安排这些文件或提供调试器可用的查找方式。MaskRay 的建议是不要把编译和链接放在一条命令里做,原话是"the DWO files' location may be surprising";练习一第 (3) 题实测了 GCC 15 在这种情况下给 .dwo 起的名字。
回到链接器。xv6 内核的 split 变体用 -gdwarf-5 -gsplit-dwarf 编译,和 dw5 比:
--- 目标文件里的重定位条数(全部 27 个 .o 合计)dw5 共 7895 条,其中 .rela.debug_* 6424 条split 共 5362 条,其中 .rela.debug_* 3891 条--- 链接输入字节数dw5 .o 合计 607840 字节split .o 合计 399248 字节split .dwo 合计 119576 字节要说明链接器"根本不读".dwo,最直接的办法是把它们挪走再链接一次:
--- 把 .dwo 挪走再链接一次 split 变体与有 .dwo 时的产物逐字节相同ld.lld 的命令行上本来就没有 .dwo,它也不会按骨架里的名字去找。链接器读的字节少了三分之一,调试节的重定位少了四成,输出从 313312 字节变成 224216 字节。时间上的差别在这个规模下测不出什么意义。MaskRay 的描述是链接器省掉了这部分合并和重定位的工作,用的内存也更少,并且"smaller input has advantages for a distributed build farm",输入小了,分布式构建要传给链接机器的数据也少了。
剩下的调试节合计 59856 字节,里面最大的是 26874 字节的 .debug_line,和 dw5 一模一样,因为它装的是地址;.debug_addr 8312 字节;另有 .debug_gnu_pubnames 5405 字节和 .debug_gnu_pubtypes 4503 字节,-gsplit-dwarf 默认带上这两个名字索引,gold、lld、mold 的 --gdb-index 可以用它们生成 .gdb_index,让 gdb 不必打开所有 .dwo 就知道某个名字在哪个 CU 里。
dwp
几千个 .dwo 散在构建目录里,不方便分发。dwp 工具把它们打包成一个 .dwp 文件,放在可执行文件旁边,gdb 会自动找 程序名.dwp。xv6 的 27 个 .dwo 用 llvm-dwp 打包:
$ cd build-split && llvm-dwp -o kernel.dwp *.dwosplit .dwo 合计 119576 字节split .dwp 94632 字节打包时合并了各文件中重复的字符串,比原来小了两成。dwp 做的事很像一个专门处理调试节的小链接器:拼接同名节,合并字符串,改写 .debug_str_offsets.dwo 里的偏移,再生成一张按 dwo_id 查找的哈希索引。回到前面 GCC 生成的 sp:本机 GNU dwp --version 是 2.44,它与 GNU ld/readelf 的版本不同。GCC 15 默认 DWARF 5 的这组输入,dwp -e sp -o sp.dwp 已不会段错误;直接列出 .dwo 文件也能生成 1624 字节的包。但移走 .dwo 后,GDB 17.1 读取该包仍报 DWARF Error: bad DWP hash table, lookup didn't terminate,不能设置源码断点。不能把“打包命令退出成功”当作“调试器能读取”。换成 -gdwarf-4 -gsplit-dwarf 重新编译,dwp -e sp -o sp.dwp 生成 2136 字节的包;删除 .dwo 后,GDB 能在 add 上停住并回溯到 main。这些是具体版本和输入的兼容性结果。
验证调试信息仍然描述正确的程序
调试节对链接器来说是一批不加载的普通节,要和代码一样拼接、去重、逐条重定位,又因为不参与 GC、体积大、可以拆出去,多出了墓碑、压缩和分离这几件事。
程序能运行只证明了执行路径的一部分。让输出同时能够被 gdb 正确调试,还需要把调试节及其引用关系留下来:
- 识别这些没有
SHF_ALLOC的调试节,按兼容的类型、标志和名字合并,排在所有段的后面,地址填 0,只写节头,不放进任何PT_LOAD。 - 处理它们的
.rela节。R_X86_64_64与R_X86_64_32都按 S+A 求值,区别首先来自目标所在的输出节:目标位于非加载调试节时,该输出节地址为 0,S 包含输入片段在输出中的偏移;目标位于代码或数据时,S 包含最终虚拟地址。不论哪一种,再按具体重定位检查结果是否能装入字段。目标位于可合并字符串节时,还要通过输入片段到输出位置的映射换算,不能只平移输入节起点;节符号的加数用于选择片段,普通符号则先映射符号位置,再保留原加数。 - 目标节被 GC 删掉时填墓碑,若选择与这里的 ld.lld 21.1.8 兼容,其取值为:
.debug_ranges、.debug_loc填 1,.debug_names填 −1,其余(包括.debug_info、.debug_addr、.debug_line和.debug_frame里 FDE 的起始地址)填 0。 - 输入节带
SHF_COMPRESSED时先读Elf64_Chdr,按ch_size解压,再应用以未压缩数据为坐标的引用。压缩与未压缩输入都应独立检查,不能仅凭文件尺寸变化判断解压与重定位正确。
调试信息的验证需要同时覆盖文件结构与调试器行为。能够解码 .debug_info,只证明记录可读;断点停在正确源码行、变量值与调用关系符合实际执行,才能证明记录描述了正确的程序。跨架构的格式或体积比较不具备后一层证据。
用被测链接器链接一个带 -g 的多文件 C 程序,对第二个文件里的函数设置断点,检查它是否停在正确文件和行号上,再用 bt 检查调用关系及可恢复的参数。优化可能消除变量或改变执行顺序,初始验证可以使用 -O0;随后再检查优化构建是否如实标记无法恢复的值。最后用 llvm-dwarfdump --debug-line 对照被测链接器和 LLD 的输出:地址允许因布局不同而变化,但它们与相应指令、源码行之间的关系必须一致。
链接器删除 unused 的依据是节引用关系。这个判断无需恢复 C 语句,但也不足以推导 used 中的 x + counter 是否能简化。普通分开编译时,编译器掌握函数体,却可能看不到其他文件里的实现;链接器汇集了各个文件,常规输入又已经降成机器码。若把编译器仍能分析的中间表示保留到链接阶段,就有机会跨文件继续优化,这便引出了链接期优化(LTO18)。代码在此阶段发生变化,描述它的调试信息也必须随之生成或调整。
练习
本章练习沿用正文中的输入与命令;所有命令在 Linux 上执行,并应在独立临时目录保留产物。
练习一,观察。使用正文显式加 -gz=zlib 得到的 gc_gcc_z.o,不要误用未压缩的 gc_gcc.o:
$ readelf -tW gc_gcc_z.o [10] .debug_info PROGBITS 0000000000000000 000080 000091 00 0 0 8 [0000000000000800]: COMPRESSED ZLIB, 00000000000000ea, 1$ readelf -rW gc_gcc_z.o | sed -n "/'.rela.debug_info'/,/^$/p" | tail -200000000000000cb 0000000200000001 R_X86_64_64 0000000000000000 .text.used + 0(1) .debug_info 在文件里占多少字节(第二行依次是类型、地址、偏移、大小、ES、Lk、Inf、对齐),解压后多少字节?(2) 最后一条重定位的偏移 0xcb 已经超出了节在文件里的大小,这是工具出错了吗?链接器拿到这个节以后,第一步必须做什么?(3) 在本机 Linux 上用一条命令同时编译和链接 split DWARF 程序:gcc -O0 -g -gsplit-dwarf ../main.c ../util.c -o sp2。先猜一猜会生成哪些 .dwo 文件、叫什么名字,再用 ls 和 readelf --debug-dump=info sp2 | grep dwo_name 核对。
练习二,手算。
(1) 下面是 gc_clang.o 里 .debug_line 从偏移 0x7b 起的 32 个字节,属于 _start 的那个序列:
04 00 00 09 02 00 00 00 00 00 00 00 00 03 0a 0105 0d 0a 21 05 05 bb 05 01 0b 91 02 02 00 01 01已知:行号表头部的 minimum_instruction_length 为 1,default_is_stmt 为 1,line_base 为 −5,line_range 为 14,opcode_base 为 13;序列开始时状态机的地址为 0、行号为 1。标准操作码里,01 是 copy(用当前状态输出一行),02 是 advance_pc(后跟 ULEB128,地址加上它乘以最小指令长度),03 是 advance_line(后跟 SLEB128),04 是 set_file、05 是 set_column,这两个各带一个 ULEB128 操作数,0a 是 set_prologue_end、0b 是 set_epilogue_begin,这两个不带操作数,这四个都不输出行;00 开头的是扩展操作码,后跟长度和子操作码,子操作码 01 是 end_sequence(输出一行并结束序列),02 是 set_address(后跟 8 字节地址)。大于等于 opcode_base 的字节是特殊操作码,设 adj = 操作码 − opcode_base,它让地址加上 (adj / line_range) × minimum_instruction_length(这里的除法是整除),行号加上 line_base + (adj mod line_range),然后输出一行。set_address 的 8 个字节在目标文件里是 0,偏移 0x80 处有一条重定位 R_X86_64_64 .text._start + 0,链接后 _start 的地址是 0x201170。算出这个序列输出的每一行(地址、行号)。
(2) 下面是 kernel-zlib 里 .debug_info 的前 24 字节,节头的 sh_size 是 0x66c1:
01000000 00000000 fab10000 00000000 01000000 00000000按 Elf64_Chdr 的定义读出算法、解压后的大小和对齐,再算压缩后(不算这 24 字节的头)是原来的百分之几。
练习三,改坏。在本机 Linux 上生成去掉调试信息的 prog.stripped 和调试文件 prog.debug:
$ gcc -O0 -g ../main.c ../util.c -o prog$ objcopy --only-keep-debug prog prog.debug$ objcopy --strip-debug --add-gnu-debuglink=prog.debug prog prog.stripped$ printf x >> prog.debug最后一行在调试文件末尾追加了一个字节。先预测 gdb -q -batch -iex "set verbose on" -ex "info line add" ./prog.stripped 的输出,再运行核对。然后只修改 prog.stripped,让 gdb 重新接受这个调试文件。最后想一想:如果调试文件来自另一次构建,按同样办法重加 debuglink,gdb 能发现吗?
build-id 的查找规则可以直接从上一节给出的 objcopy 产物推导:先读取 .note.gnu.build-id,再按前两位和剩余字节拼出调试文件路径。
答案
每题的答案都折叠着,先自己做再展开。
练习一答案
(1) 第二行的第四个字段是 sh_size,0x91 = 145 字节;下面的压缩头说明算法为 zlib,解压后大小 0xea = 234 字节,对齐 1。压缩节的存储大小与解压后的引用范围是不同的数值。
(2) 不是出错。gABI 规定指向压缩节的重定位,偏移一律按解压后的数据计算,0xcb 落在 [0, 234) 之内。链接器必须先按压缩头把节解压成 234 字节,才能在偏移 0xcb 处写入 .text.used 的地址;readelf -x .debug_info gc_gcc_z.o 也提示"This section is compressed, but its contents have NOT been expanded for this dump"。这也是 GNU ld 和 lld 的产物里没有 C 标志的原因:它们解压了输入,输出时默认不再压缩。
(3) 实测生成的是 sp2-main.dwo 和 sp2-util.dwo,没有 main.o、util.o(目标文件是临时文件,链接完就删了):
$ lssp2sp2-main.dwosp2-util.dwo$ readelf --debug-dump=info sp2 | grep -E "dwo_name" <29> DW_AT_dwo_name : (indirect string, offset: 0): sp2-main.dwo <5e> DW_AT_dwo_name : (indirect string, offset: 0x2d): sp2-util.dwo实测的结论:GCC 15 用输出文件名加源文件名给 .dwo 命名,和分两步编译时的 main.dwo、util.dwo 不同。由此推想,构建脚本如果按"源文件名.dwo"去收集或打包,就会漏掉它们。MaskRay 那边只说了一句 "don't perform compiling and linking in one action: the DWO files' location may be surprising",没有给出具体的命名规则。
练习二答案
(1) 变量清单:min_inst = 1,line_base = −5,line_range = 14,opcode_base = 13;初始 address = 0,line = 1。逐条执行:
04 00:set_file 0,不输出。00 09 02加 8 字节:扩展操作码,长度 9,set_address。目标文件里是 0,链接时按R_X86_64_64填 S + A = 0x201170 + 0,address = 0x201170。03 0a:advance_line,SLEB128 的 0x0a 是 +10,line = 11。01:copy,输出 (0x201170, 11)。05 0d:列号 13;0a:prologue_end。21:adj = 0x21 − 13 = 20,地址 + 20 / 14 = 1,行号 + (−5 + 20 mod 14) = +1,输出 (0x201171, 12)。05 05:列号 5。bb:adj = 187 − 13 = 174,地址 + 12,行号 + (−5 + 6) = +1,输出 (0x20117d, 13)。05 01:列号 1;0b:epilogue_begin。91:adj = 145 − 13 = 132,地址 + 9,行号 +1,输出 (0x201186, 14)。02 02:advance_pc 2,address = 0x201188。00 01 01:end_sequence,输出 (0x201188, 14) 并结束。
和正文 llvm-dwarfdump --debug-line lld.out 的最后一个序列逐行一致:
0x0000000000201170 11 0 0 0 0 0 is_stmt0x0000000000201171 12 13 0 0 0 0 is_stmt prologue_end0x000000000020117d 13 5 0 0 0 0 is_stmt0x0000000000201186 14 1 0 0 0 0 is_stmt epilogue_begin0x0000000000201188 14 1 0 0 0 0 is_stmt end_sequencellvm-dwarfdump --debug-line -v lld.out 会把每个字节的解释打印出来,例如 0x0000008e: 21 address += 1, line += 1,可以逐条对照。
(2) 小端序读:ch_type = 1,即 ELFCOMPRESS_ZLIB;ch_reserved = 0;ch_size = 0xb1fa = 45562 字节;ch_addralign = 1。压缩数据是 0x66c1 − 24 = 26305 − 24 = 26281 字节,是原来的 26281 / 45562 ≈ 57.7%。.debug_info 压得不如整体(46%)狠,拉低整体比例的是 .debug_addr、.debug_abbrev、.debug_frame、.debug_str_offsets 这几个重复度高的节,zlib 下它们都在 25% 到 32% 之间。
练习三答案
追加一个字节后,CRC 变了,gdb 找到了文件但拒绝使用:
$ gdb -q -batch -iex "set verbose on" -ex "info line add" ./prog.strippedReading symbols from ./prog.stripped...
warning: the debug information found in "<work>/gdb/ex/prog.debug" does not match "<work>/gdb/ex/prog.stripped" (CRC mismatch).
(No debugging symbols found in ./prog.stripped)No line number information available for address 0x1187 <add>add 这个名字还能显示,是因为 --strip-debug 留下了 .symtab。只改 prog.stripped 的办法是删掉旧的 debuglink,按调试文件现在的内容重新加一个:
$ objcopy --remove-section=.gnu_debuglink prog.stripped$ objcopy --add-gnu-debuglink=prog.debug prog.stripped$ gdb -q -batch -iex "set verbose on" -ex "info line add" ./prog.strippedReading symbols from ./prog.stripped...Reading symbols from <work>/gdb/ex/prog.debug...Line 1 of "../util.c" starts at address 0x1187 <add> and ends at 0x1195 <add+14>.这样修好以后,gdb 就发现不了不配套了:CRC 只证明"调试文件还是记下 CRC 那一刻的样子",不证明它和程序来自同一次构建。最后一问也实测了:把 util.c 改一处另编一个 other,用它的调试文件冒充 prog.debug,再给 prog.stripped 重新加 debuglink:
$ readelf -n prog.stripped other | grep "Build ID" Build ID: eb34c618b304e7bb6e1a92866e1040e6c6855b0c Build ID: 4b9a607eb14d7dd3d457ab5051cbc16e4ca4a56f$ gdb -q -batch -iex "set verbose on" -ex "info line add" ./prog.strippedReading symbols from ./prog.stripped...Reading symbols from <work>/gdb/mm/prog.debug...Line 1 of "util2.c" starts at address 0x1187 <add> and ends at 0x1195 <add+14>.两边的 build-id 明明不同,GDB 17.1 走 debuglink 这条路时只核对 CRC,照样读入,连源文件名都报成了 util2.c。要防这种错配,得靠 build-id 查找:路径本身就由程序的 build-id 拼成,objcopy 也不会改它。
参考
附录:术语与工具
-
GC — 本文 GC 指 section garbage collection,即链接器从入口和其他根出发保留可达节、删除无用节。它发生在构建阶段,与运行时堆内存的垃圾回收不同。 官方文档。 ↩
-
Clang — Clang 是 LLVM 项目中的 C、C++ 等语言前端及驱动程序。它通常使用集成汇编器,但仍需调用链接器;最终使用哪个链接器取决于目标平台和配置。 官方文档。 ↩
-
LLD — LLD 是 LLVM 项目的链接器。ELF 平台通常通过
ld.lld调用;lld-link则提供兼容 Windows 工具链的接口。它与负责处理源码的 Clang 是不同组件。 官方文档。 ↩ -
GCC — GCC(GNU Compiler Collection)是一组语言编译器。命令
gcc是驱动入口,会组织编译、汇编和链接;在终端调用它,并不意味着后续工作都在同一个进程里完成。 官方文档。 ↩ -
GNU — GNU 是 “GNU’s Not Unix” 的递归缩写,指自由软件操作系统项目。GCC、binutils 和 glibc 都属于 GNU 项目,但分别承担编译、二进制处理和 C 运行库职责。 官方文档。 ↩
-
DWARF — DWARF 是调试信息格式,描述源码行、类型、变量与机器位置的关系。它可以随 ELF 保存,但不是 ELF 符号表的别名。 官方文档。 ↩
-
DIE — DIE(Debugging Information Entry)是 DWARF 的基本条目,可描述编译单元、函数、类型和变量,并通过属性与引用组织成调试信息。 官方文档。 ↩
-
ICF — ICF(Identical Code Folding)合并被判定为等价的代码。字节相同不一定足以证明可合并,还需要考虑重定位目标、函数地址是否可观察以及关联的运行时元数据。 官方文档。 ↩
-
COMDAT — COMDAT 让工具链表示可供择一保留的重复定义组。ELF 通过 section group 与签名表达相关关系;选择副本时,组内关联内容需要一致处理。 官方文档。 ↩
-
LLVM — LLVM 是一组编译器与工具链项目的名称,包括优化基础设施、目标代码生成和相关工具。Clang、LLD 与 LLVM IR 各有职责,不能互作同义词。 官方文档。 ↩
-
ELF — ELF(Executable and Linkable Format)规定目标文件、可执行文件与共享对象的结构。通用规则见 gABI,架构相关的调用约定和重定位规则见对应 psABI。 官方文档。 ↩
-
FDE — FDE(Frame Description Entry)关联一段代码的地址范围与栈展开指令。移动代码或重新组织
.eh_frame时,链接器必须同步更新相关地址和记录间的引用。 官方文档。 ↩ -
RISC-V — RISC-V 是开放的指令集架构。本系列主线是在原生 x86-64 Linux 上构建链接器;RV64 用于架构对照与内核案例。相关例子的编码、寄存器约定和重定位规则见 RISC-V psABI,不能直接套用 x86-64 的规则。 ↩
-
xv6 — xv6 是 MIT 用于操作系统教学的小型 Unix 风格内核。本系列采用 RISC-V 版本,借助较小的加载器与链接脚本观察 ELF 到进程的交接。 官方文档。 ↩
-
ULEB128 — ULEB128 是无符号整数的变长编码:每字节低七位承载数值,最高位表示是否继续。SLEB128 是相应的有符号形式;解析时需要限制长度并检查溢出。 官方文档。 ↩
-
gABI — gABI 是通用 System V ABI,规定 ELF 等跨架构规则;psABI 是处理器相关补充,进一步规定寄存器约定、重定位编号与 TLS 等细节。 官方文档。 ↩
-
binutils — GNU binutils 是一组处理目标文件的工具,包含汇编器
as、链接器ld,以及readelf、nm、objdump、ar等检查与归档工具。 官方文档。 ↩ -
LTO — LTO(link-time optimization)在链接阶段协调编译器优化。它利用保留下来的中间表示跨文件分析,能力不同于仅处理本机目标文件的普通链接。 官方文档。 ↩