

[链接器的世界-原理篇10] 链接器脚本:当程序需要自己安排内存
链接器脚本规定输出怎样排布,本身不负责把文件装进内存。原理篇 05中的节布局和原理篇 06中的加载映射,是这里的两个前提。接下来会反复区分文件偏移、链接时计算引用所用的地址,以及启动时实际放置数据的地址;它们数值相同是一种安排,不能当作定义。
主线是读懂脚本如何收集输入节、分配地址和定义符号,再判断启动代码是否遵守这份安排。RISC-V/QEMU 是观察裸机启动的具体案例,寄存器和串口细节可以第二遍再读;首次阅读不要求已有内核开发经验。
普通应用开始运行以前,内核已经映射了代码和数据,启动代码也会建立栈、线程局部存储等运行条件。链接器生成的地址是在这些条件下使用的。换成操作系统内核,准备环境的责任并没有消失:固件、引导程序或模拟器先完成一部分,内核的启动代码接着完成其余部分。
其中最基本的约定是地址。文件被装到哪里,处理器从哪里开始取指,机器码中的引用按哪个地址计算,这三件事必须配合。Linux 应用通常把这种配合交给默认链接规则和 execve;面向一台具体机器的程序则经常通过链接器脚本把约定写出来。
三种地址:VMA、LMA 与运行地址
链接器规定引用所依据的地址,装载方把字节放入存储,启动代码建立访问这些字节所需的条件。这三个职责共同决定程序是否能按预期运行。
链接地址描述代码或数据在运行地址空间中的预期位置,GNU ld 称它为 VMA(virtual memory address)。脚本中的位置计数器 . 通常跟随 VMA,符号和重定位也以相应的布局计算。在这里使用固定布局的 ELF 文件中,节的 VMA 体现在 sh_addr,段的 VMA 体现在 p_vaddr;PIE1 或共享库则还需要加上加载基址,不能把文件里的数值直接当作最终指针。未启用地址转换时,这些运行地址可以直接对应物理地址。
加载地址是程序映像最初应放入的位置,GNU ld 称它为 LMA(load memory address)。一个典型用途是把可写变量的初值存进 ROM,启动时再复制到 RAM:初值在 ROM 中的位置是 LMA,程序访问变量时使用的 RAM 地址是 VMA。GNU ld 的 Basic Script Concepts用的正是这个例子。
在本章面向裸机的 ELF 装载约定中,LMA 由程序头的 p_paddr 传递给 QEMU 或引导程序。这不是 ELF 在所有平台上的通用加载规则。System V gABI把它留给需要物理地址的系统;第 6 章的 Linux load_elf_binary 和 xv6 的用户程序加载器 kexec 不用它决定映射。普通 Linux 进程的虚拟地址与实际物理页也不必相同。
文件偏移则属于另一套坐标。对于一个有文件内容的节,节内偏移为 d 的字节在 ELF 文件中位于 sh_offset + d,其预期运行地址为 sh_addr + d。在采用本章裸机装载约定的 PT_LOAD 中,该字节先由文件位置 p_offset + d 装到 p_paddr + d;如果 VMA 与 LMA 不同,还需要启动代码复制数据,或建立相应地址映射。这里的 d 分别相对于节和段,只有节恰好从段起点开始时才能直接共用。
例如,下文的 .data 从文件偏移 0x2000 开始,占 0x10 字节;LMA 为 0x80000188,VMA 为 0x80100000。同一组初值经历如下过程,不能把文件偏移传给内存复制指令:
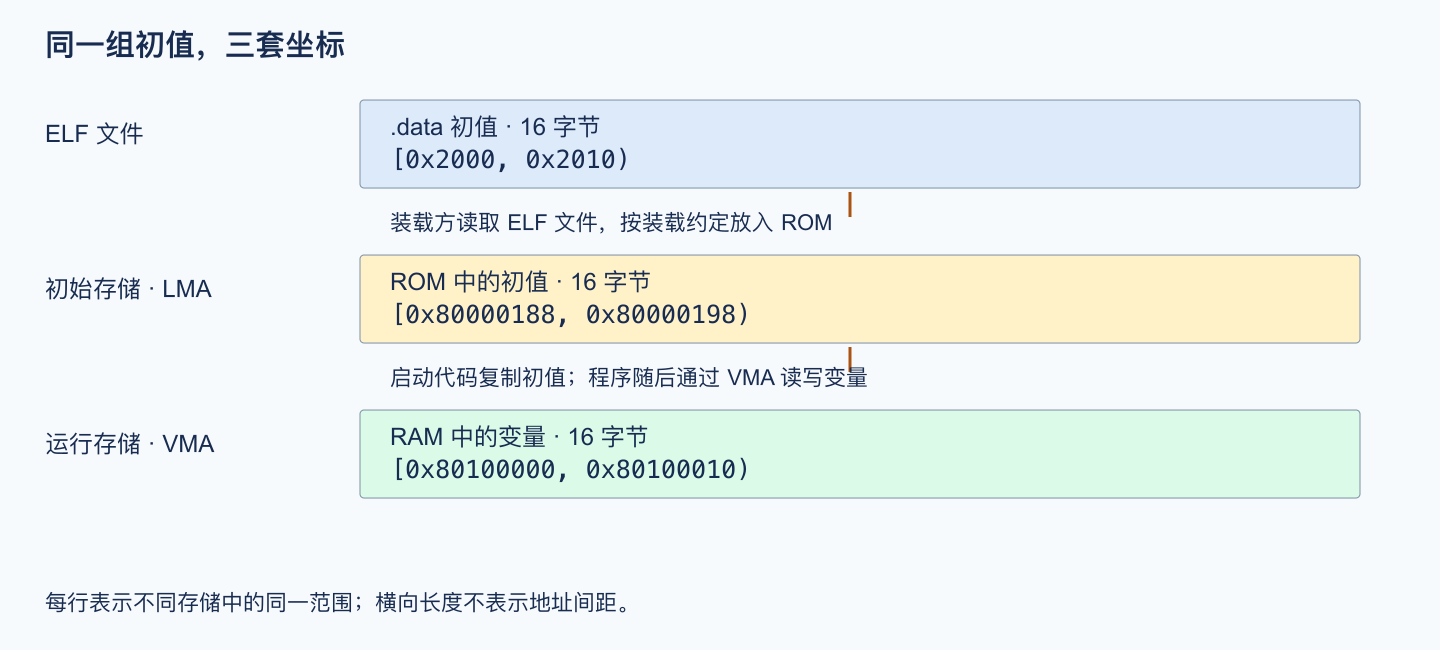
| 坐标 | 第 8 个字节(节内偏移 7)的位置 | 谁使用它 |
|---|---|---|
| ELF 文件偏移 | 0x2000 + 7 = 0x2007 | 装载方读取文件 |
| LMA | 0x80000188 + 7 = 0x8000018f | 启动代码读取初值 |
| VMA | 0x80100000 + 7 = 0x80100007 | 程序访问变量 |
代码当前真正执行的位置由已装入的字节、地址映射和控制转移共同决定,不是 ELF 里第三个名为“运行地址”的字段。整体移动代码和数据可能保持 PC 相对引用的距离,却不会自动更新其中保存的绝对指针。下面分别考察地址约定失配、高地址内核映射与 ROM/RAM 数据复制。
把操作系统和 C 库暂时拿掉,可以直接观察这份约定。下面的 RISC-V2 程序在 QEMU3 模拟的 virt 机器上运行,自己准备栈并访问串口。这类不依靠操作系统服务的程序称为裸机(bare-metal)程序。程序依次用直接引用、数据指针和函数指针打印消息,三种访问方式在地址变化后会表现不同。
/* main.c */#define UART 0x10000000ULstatic void putc(char c) { volatile unsigned char *u = (unsigned char *)UART; while ((u[5] & 0x20) == 0) ; /* LSR.THRE:发送缓冲空 */ u[0] = c;}static void puts(const char *s) { while (*s) putc(*s++); }
const char *greeting = "2: via pointer in .data\n"; /* .data 里存着一个绝对地址 */static void bye(void) { puts("3: via function pointer\n"); }void (*hook)(void) = bye; /* 同上,存的是函数地址 */
void main(void) { puts("1: via pc-relative literal\n"); puts(greeting); hook(); puts("4: done\n");}0x10000000 是 QEMU virt 机器上串口控制器的地址,这是一个兼容 16550 的 UART(通用异步收发器)。往这个地址写一个字节,字节就出现在终端上;+5 处是线路状态寄存器,第 5 位为 1 表示可以写下一个。读写某个地址就是读写设备寄存器,这种做法叫内存映射 I/O(MMIO)。
按照这里的 C 调用约定,调用 C 函数前需要先建立可用的栈。下面的汇编用 la 伪指令把 stack_top 的地址放入栈指针 sp,再调用 main。main 返回后没有操作系统可接收退出请求,程序留在 spin 循环中;wfi 是等待中断的指令,随后的跳转保证即使等待结束也不会落入未知字节:
# entry.S .section .text.entry, "ax" .globl _entry_entry: la sp, stack_top # 栈顶由链接器脚本给出 call mainspin: wfi j spin脚本把“输入里已有的字节”和“输出里要安排的位置”接在一起。下面 .text : { ... } 左侧是一个输出节,花括号里选择要收进去的输入节;*(.text .text.*) 的第一个 * 表示任意输入文件,括号里的名字匹配它们的节。. 是当前位置计数器,分配输出内容时向前移动。stack_top = . 只是定义一个数值符号,不会在文件里存放一个名为 stack_top 的指针变量。
| 脚本中的安排 | 链接后得到什么 | 谁在运行前使用它 |
|---|---|---|
. = 0x80000000,先收 .text.entry | 入口代码按这个地址计算引用,并排在代码起点 | 装载方必须把相应字节放到约定位置 |
ENTRY(_entry) | ELF 头的 e_entry 数值 | 是否读取它,由具体启动路径决定 |
. = . + 0x1000; stack_top = . | 在地址布局中留出空间,并导出栈顶符号 | _entry 把这个地址写入 sp |
脚本不会替 CPU 设置 sp,也不会保证某个启动器一定使用 e_entry。下面的代码把 _entry 所在的 .text.entry 排在最前面,起点设成 0x80000000,在 .bss 后面留 4 KiB 当栈:
/* link.ld */ENTRY(_entry)SECTIONS{ . = 0x80000000; .text : { *(.text.entry) *(.text .text.*) } .rodata : { *(.rodata .rodata.* .srodata .srodata.*) } .data : { *(.data .data.* .sdata .sdata.*) } .bss : { *(.bss .bss.* .sbss .sbss.*) } . = ALIGN(16); . = . + 0x1000; stack_top = .;}本章全部命令在 x86-64 Linux 上执行:Ubuntu 26.04 的 Clang/LLD 21.1.8 编译与链接,qemu-system-riscv64 10.2.1 运行 RISC-V 虚拟机,GNU4 对照使用 riscv64-unknown-elf-gcc 与同前缀的 binutils5。宿主工具 mkfs 由本机 GCC6 编译,直接在 Linux 上生成 fs.img。这里的目标程序是 RISC-V 内核,不能作为 x86-64 用户程序直接执行,所以只在这一架构专题使用 RISC-V 目标和 QEMU 整机;工具、构建和调试仍统一在 Linux。编译选项是 -march=rv64gc -mabi=lp64d -mcmodel=medany -mno-relax -ffreestanding -fno-builtin -nostdlib -O1,其中 -mcmodel=medany 和 -mno-relax 的作用后面会讲。-ffreestanding -fno-builtin 按独立运行环境编译,并禁止把函数调用按编译器内建库函数优化;-nostdlib 阻止驱动程序自动加入启动文件和库。-march=rv64gc 选择 64 位 RISC-V 的通用扩展组合及压缩指令,-mabi=lp64d 选择 long 和指针为 64 位、支持双精度浮点寄存器传参的调用约定。
运行命令里的 -bios none 禁用外部固件映像,QEMU 自己生成的复位 ROM 仍然存在。-machine virt 选择所模拟的机器,-m 128M 给它 128 MiB 内存,-nographic 将串口连接到终端,-kernel 指定装载的程序。下面先生成两个输入目标文件,再链接运行:
$ clang --target=riscv64-unknown-elf -march=rv64gc -mabi=lp64d -mcmodel=medany -mno-relax -ffreestanding -fno-builtin -nostdlib -O1 -c entry.S -o entry.o$ clang --target=riscv64-unknown-elf -march=rv64gc -mabi=lp64d -mcmodel=medany -mno-relax -ffreestanding -fno-builtin -nostdlib -O1 -c main.c -o main.o$ ld.lld -T link.ld -o hello.elf entry.o main.o$ qemu-system-riscv64 -machine virt -bios none -m 128M -nographic -kernel hello.elf1: via pc-relative literal2: via pointer in .data3: via function pointer4: done现在把脚本里的 0x80000000 改成 0x80200000,其他一个字都不动,重新链接得到 bad.elf。再用 llvm-objcopy -O binary bad.elf bad.bin 去掉 ELF7 的包装,只留下各段的原始字节,得到 bad.bin。两份产物来自同一次链接,差别在于交给 QEMU 时是否还带着描述装载地址的 ELF 元数据。
装入内存与移交控制权
实测结果是:bad.elf 一行也不打印,bad.bin 只打印第一行。
$ qemu-system-riscv64 -machine virt -bios none -m 128M -nographic -kernel bad.elf$ qemu-system-riscv64 -machine virt -bios none -m 128M -nographic -kernel bad.bin1: via pc-relative literal两个程序都没有退出,QEMU 一直在空转,要手动结束。要解释这两种结果,得先弄清楚一台没有操作系统的机器上电以后,第一条指令从哪里来。
复位向量
CPU 上电或复位后,会从一个硬件规定的固定地址取第一条指令,这个地址叫复位向量(reset vector)。在真实的板子上,复位向量通常指向一块 ROM(只读存储器)或 Flash,里面烧着厂商的固件(firmware),也就是机器上最先运行的那段软件,由它初始化硬件,再把控制权交给下一阶段。QEMU 的 virt 机器在 0x1000 处放了一块很小的 ROM,内容由 QEMU 自己在启动时填写。给 QEMU 加 -S(启动后先暂停)和 -monitor stdio(在终端里开监视器),就能用 xp 命令直接看物理内存:
$ qemu-system-riscv64 -machine virt -bios none -m 128M -kernel bad.elf \ -S -display none -serial none -monitor stdio(qemu) xp /6xg 0x100000001000: 0x0282861300000297 0x0202b583f140257300001010: 0x000280670182b283 0x000000008000000000001020: 0x0000000087e00000 0x000000004942534f前 24 个字节是 6 条指令,后面是数据。用 -d in_asm 让 QEMU 记录它执行的每一块指令,能看到这 6 条的反汇编,以及之后跳去的地方:
$ qemu-system-riscv64 -machine virt -bios none -m 128M -nographic -kernel bad.elf \ -d in_asm,int -D bad_elf.log$ head bad_elf.logIN:0x00001000: 00000297 auipc t0,0 # 0x10000x00001004: 02828613 addi a2,t0,400x00001008: f1402573 csrrs a0,mhartid,zeroIN:0x0000100c: 0202b583 ld a1,32(t0)0x00001010: 0182b283 ld t0,24(t0)0x00001014: 00028067 jr t0IN:0x80000000: 0000 illegalriscv_cpu_do_interrupt: hart:0, async:0, cause:0000000000000002, epc:0x80000000, tval:0x0000000000000000, desc=illegal_instructionriscv_cpu_do_interrupt: hart:0, async:0, cause:0000000000000001, epc:0x0, tval:0x0000000000000000, desc=fault_fetch这段代码让每个 hart(hardware thread,RISC-V 中具有独立执行状态的硬件线程)做三件事:a0 取本 hart 的编号 mhartid,mhartid 是一个 CSR(control and status register,控制状态寄存器,用 csrr/csrw 一类专门的指令读写);a1 取 0x1020 处的 0x87e00000,这是 QEMU 放设备树(device tree,一份描述"这台机器有哪些设备、各在什么地址"的二进制数据)的地址;最后从 0x1018 取出跳转目标,jr 过去。0x1018 处的值是 0x80000000。
这个值和 bad.elf 无关。把正常的 hello.elf 交给 QEMU,0x1000 开始的这 48 个字节一模一样。这与 QEMU v10.2.1 的 virt.c 和 boot.c 一致,版本与本机运行程序相同。hw/riscv/virt.c 的 virt_machine_done 先把跳转目标 start_addr 设为内存的起点 memmap[VIRT_DRAM].base,也就是 0x80000000;如果有固件,就把固件装到这里,-bios none 时什么都不装,start_addr 保持原值;最后调用 hw/riscv/boot.c 的 riscv_setup_rom_reset_vec,把 start_addr 写进 ROM 的 0x1018。-kernel 文件的位置只用来填 0x1028 起的一个结构 fw_dynamic_info(开头的 0x4942534f 是它的魔数,即小端的 "OSBI"),留给 OpenSBI 读,它是 QEMU 不加 -bios none 时默认加载的 RISC-V 固件。填进去的也不是 e_entry,而是文件装入的最低地址,riscv_load_kernel 里有一句注释写明了这一点:"NB: Use low address not ELF entry point"。
可以直接验证 QEMU 不看 e_entry:把 hello.elf 的 e_entry(文件偏移 24 处的 8 个字节)改成 0x80000048(main 的地址)或 0xDEAD0000,输出照样是四行,-d in_asm 里离开 ROM 后执行的第一条指令都在 0x80000000。
在本例的 virt、-bios none 启动路径中,复位 ROM 只负责传递启动参数并跳到 DRAM 的起点 0x80000000;它不解析 ELF、不设置栈,也不清零 .bss。文件装载已经由宿主侧的 QEMU 完成,不能把 ROM 中的几条指令当作全部加载过程。链接器脚本里那行 . = 0x80000000; 和 *(.text.entry) 排在最前面,都是为了让这个字节恰好是 _entry 的第一条指令。
-kernel 装进了哪里
跳转目标固定了,那 -kernel 指定的文件被装到了哪里?riscv_load_kernel 依次尝试三种格式。先当 ELF 读(load_elf_ram_sym),成功就按每个 PT_LOAD 的 p_paddr 把文件内容拷进对应的物理地址。p_memsz 比 p_filesz 多出的部分,只要不和别的段重叠就一起补零,重叠时只装 p_filesz 字节(QEMU 的 ELF 装载实现,mem_size > file_size 的重叠检查)。不是 ELF 就试 uImage 格式,这是嵌入式上常用的引导程序 U-Boot 定义的一种带头部的镜像;都不是,就当作没有任何头部的原始二进制(raw binary),整个文件原样拷到 kernel_start_addr。kernel_start_addr 是固件末尾按 2 MiB 向上取整,-bios none 时没有固件,算出来就是 0x80000000。
p_paddr 是程序头里的 PhysAddr 一列,到现在为止它总是和 p_vaddr 相同。对 bad.elf 来说两者都是 0x80200000,于是:
(qemu) xp /2xw 0x8020000080200000: 0x00001117 0x15010113(qemu) xp /2xw 0x8000000080000000: 0x00000000 0x00000000程序完好地躺在 0x80200000,0x80000000 却是空的。CPU 跳到 0x80000000,取到的是全零。RISC-V 的压缩指令集里,16 位全零被规定为非法指令,于是第一条就触发了 illegal_instruction 异常(cause 2)。异常发生时 CPU 跳到 mtvec 这个 CSR 指向的地址,没人设置过它,它还是 QEMU 给的复位值 0,0 处没有内存,取指又失败(fault_fetch,cause 1),再跳 0,如此循环。QEMU 运行两秒,日志就记了六十多万行。
bad.bin 为什么还能打印一行
bad.bin 是另一种情况。它没有 ELF 头,QEMU 只能当原始二进制装到 0x80000000,CPU 也从 0x80000000 开始执行。程序被放在了"对的位置",可它是按 0x80200000 链接的。第 4 章说过,链接器在重定位时把符号的最终地址填进机器码和数据,这些地址都按链接时的布局算出。程序运行时实际所在的地址和链接时假设的地址不同,用到地址的地方就可能出错。
第一行打印出来了,是因为访问字符串的指令用的是 PC 相对寻址。第 4 章 "RISC-V:会改变代码长度的 relaxation" 一节比较过 RISC-V 的两种代码模型(code model,编译器对"程序和数据可能放在哪里"的假设):medlow 用 lui 拼绝对地址,medany 用 auipc 相对当前 PC 计算,只要求代码和数据彼此相距不超过 ±2 GiB。本章一直用 medany,auipc 后面的立即数是链接器填的"目标离这条指令多远"。整个程序一起搬走 2 MiB,这个距离不变,指令照样算出对的地址。
第二行和第三行用的是存在 .data 里的地址。main.o 的重定位表里,.data 有两条 R_RISCV_64:
$ llvm-objdump -r main.oRELOCATION RECORDS FOR [.data]:OFFSET TYPE VALUE0000000000000000 R_RISCV_64 .L.str0000000000000008 R_RISCV_64 bye$ llvm-objdump -s -j .data bad.elfContents of section .data: 80200140 fd002080 00000000 16002080 00000000 .. ....... .....R_RISCV_64 让链接器把符号的绝对地址整个写进 8 个字节,于是 greeting 的值是 0x802000fd,hook 的值是 0x80200016。main 先用 auipc 找到 greeting 这个变量本身,这一步没错,读出来的却是链接时写死的 0x802000fd,那里没有被装入任何东西,第一个字节就是 0,puts 什么也没打印。接着读出 hook 的值,jalr 跳过去:
$ qemu-system-riscv64 -machine virt -bios none -m 128M -nographic -kernel bad.bin -d int -D bad_bin.log1: via pc-relative literal$ head -2 bad_bin.logriscv_cpu_do_interrupt: hart:0, async:0, cause:0000000000000002, epc:0x80200016, tval:0x0000000000000000, desc=illegal_instructionriscv_cpu_do_interrupt: hart:0, async:0, cause:0000000000000001, epc:0x0, tval:0x0000000000000000, desc=fault_fetchepc(异常发生时的 PC)正是 0x80200016。MIT 6.828 的 JOS Lab 1 Exercise 5 让学生找出"引导程序的链接地址写错时,第一条出问题的指令"(lab1),这里的答案是 main 里那条 jalr a0:之前的 ld8 读出了错的数据,但只有跳转让 CPU 离开了程序。
如果换成 -mcmodel=medlow,问题会提前到链接时,和第 4 章那个 524290 超出范围的例子一样,0x80000000 已经超出 lui 能拼出的范围:
$ ld.lld -T link.ld -o medlow.elf entry.o main_medlow.old.lld: error: main_medlow.o:(function bye: .text+0xa): relocation R_RISCV_HI20 out of range: 524288 is not in [-524288, 524287]; references '.L.str.3'GNU ld 报的是 relocation truncated to fit: R_RISCV_HI20 against `.L.str.3'。xv69 的 kernel/start.c 里写着 "requires gcc -mcmodel=medany",原因就在这里。
换一个固件,"错"的地址就对了
去掉 -bios none,QEMU 默认加载 OpenSBI。SBI(Supervisor Binary Interface)是 RISC-V 定义的一套接口,运行在最高特权级 machine 模式(M 态)的固件通过它向 supervisor 模式(S 态,内核平时所在的特权级)提供关机、定时器之类的服务;OpenSBI 是它的参考实现。OpenSBI 自己占用 0x80000000 起的一段内存,初始化完成后读 fw_dynamic_info 里的地址,切到 S 态跳过去:
$ qemu-system-riscv64 -machine virt -m 128M -nographic -kernel bad.elfOpenSBI v1.8.1...Firmware Base : 0x80000000Firmware Size : 321 KBDomain0 Next Address : 0x0000000080200000Domain0 Next Mode : S-mode...1: via pc-relative literal2: via pointer in .data3: via function pointer4: done刚才挂掉的 bad.elf 在这里四行全对。反过来,链接在 0x80000000 的 hello.elf 和 OpenSBI 抢同一块内存,QEMU 直接拒绝启动:
$ qemu-system-riscv64 -machine virt -m 128M -nographic -kernel hello.elfqemu-system-riscv64: Some ROM regions are overlapping... hello.elf ELF program header segment 0 (addresses 0x0000000080000000 - 0x00000000800000e4)Linux 内核在 RISC-V 上通常由 OpenSBI 引导,运行在 S 态;xv6 选择 -bios none,内核从 M 态开始,自己完成 OpenSBI 做的那部分初始化,_entry 因此要放在 0x80000000。
逐段读 xv6 的 kernel.ld
xv6 是 MIT 操作系统课 6.1810 使用的教学内核,第 5 章读过它的用户程序脚本 user/user.ld,第 6 章读过它的加载器 kexec。下面用的是 mit-pdos/xv6-riscv riscv 分支的 commit 06aad25(2026-09-26),和第 5 章引用的是同一个提交。内核的链接命令在 Makefile 第 93、94 行:
$K/kernel: $(OBJS) $K/kernel.ld $(LD) $(LDFLAGS) -T $K/kernel.ld -o $K/kernel $(OBJS)OBJS 列出 27 个目标文件,第一个是 $K/entry.o;LDFLAGS 是第 5 章讲过的 -z max-page-size=4096。Linux 上使用 riscv64-unknown-elf- 工具链,并显式写出 -mabi=lp64d 与 GNU ld 的 elf64lriscv 模式。fs.img 的宿主工具 mkfs 使用本机 gcc 和 Linux C 头文件:
$ make TOOLPREFIX=riscv64-unknown-elf- CC="riscv64-unknown-elf-gcc -mabi=lp64d" \ LD="riscv64-unknown-elf-ld -m elf64lriscv" kernel/kernel fs.imgriscv64-unknown-elf-ld: warning: kernel/kernel has a LOAD segment with RWX permissions产物拿到主机上,用 Makefile 里 QEMUOPTS 的那组参数启动,能进到 shell:
$ qemu-system-riscv64 -machine virt -bios none -kernel kernel/kernel -m 128M -smp 3 -nographic \ -global virtio-mmio.force-legacy=false -drive file=fs.img,if=none,format=raw,id=x0 \ -device virtio-blk-device,drive=x0,bus=virtio-mmio-bus.0xv6 kernel is booting
hart 1 startinghart 2 startinginit: starting sh$ echo hello xv6hello xv6$ wc README48 336 2441 READMEkernel/kernel.ld 全文 45 行:
OUTPUT_ARCH( "riscv" )ENTRY( _entry )
SECTIONS{ /* * ensure that entry.S / _entry is at 0x80000000, * where qemu's -kernel jumps. */ . = 0x80000000;
.text : { kernel/entry.o(_entry) *(.text .text.*) . = ALIGN(0x1000); _trampoline = .; *(trampsec) . = ALIGN(0x1000); ASSERT(. - _trampoline == 0x1000, "error: trampoline larger than one page"); PROVIDE(etext = .); }
.rodata : { . = ALIGN(16); *(.srodata .srodata.*) /* do not need to distinguish this from .rodata */ . = ALIGN(16); *(.rodata .rodata.*) }
.data : { . = ALIGN(16); *(.sdata .sdata.*) /* do not need to distinguish this from .data */ . = ALIGN(16); *(.data .data.*) }
.bss : { . = ALIGN(16); *(.sbss .sbss.*) /* do not need to distinguish this from .bss */ . = ALIGN(16); *(.bss .bss.*) }
PROVIDE(end = .);}和 user.ld 对照,后三个输出节几乎一样,.srodata、.sdata、.sbss 这些 RISC-V 小数据节照样并进普通节(第 5 章)。不同的地方都在开头和 .text 里面。
ENTRY 和 0x80000000
OUTPUT_ARCH("riscv") 告诉链接器输出文件的体系结构。ENTRY(_entry) 把 _entry 的地址写进 e_entry。上一节已经看到,QEMU 用 -bios none 启动时根本不看这个字段,它留给 objdump10、gdb 这些工具:gdb 连上 QEMU 调试内核时,会从 e_entry 和符号表知道代码从哪里开始。
. = 0x80000000; 上面的注释把原因写明了:"where qemu's -kernel jumps"。这个地址也不是 xv6 选的。QEMU 的 virt 机器把内存放在 0x80000000 起,下面的地址留给各种设备:0x1000 是刚才那块 ROM,0x10000000 是串口,PLIC(平台级中断控制器)和 virtio 磁盘也都在 0x80000000 以下。xv6 book 第 2.6 节也这么解释:"the address range 0x0:0x80000000 contains I/O devices"(xv6 book)。
kernel/entry.o(_entry) 其实什么也没匹配到
脚本中 . = 0x80000000; 的下一行还点名了 kernel/entry.o。这一行是 kernel/entry.o(_entry),按第 5 章的语法,括号外面是文件名,括号里面是节名,意思是"把 kernel/entry.o 里名叫 _entry 的节放在这里"。可 kernel/entry.S 第 5 行写的是 .section .text,_entry 是这个节里的一个符号,entry.o 里根本没有叫 _entry 的节。用 git log -S'section _entry' 搜整个历史,一次也没有出现过,entry.S 从 2019 年源码分进 kernel/ 目录起就用 .text。那时它开头的注释还写着 "qemu -kernel starts at 0x1000. the instructions there seem to be provided by qemu, as if it were a ROM",说的正是上一节那块复位 ROM。
这一行是 2024-10-30 的 commit d712f59 加进来的,提交说明是 "fix kernel.ld so that _entry will appear in the right place"。让 GNU ld 输出映射文件,可以看到它确实没匹配到任何节,entry.o 的 .text 是被下一行的 *(.text .text.*) 收进来的:
.text 0x0000000080000000 0x7000 kernel/entry.o(_entry) *(.text .text.*) .text 0x0000000080000000 0x1c kernel/entry.o 0x0000000080000000 _entry .text 0x000000008000001c 0xba kernel/start.o那它修好了什么?把 entry.o 挪到命令行的最后再链接,能看出这一行的作用:
$ riscv64-unknown-elf-ld -m elf64lriscv -z max-page-size=4096 -T kernel/kernel.ld -o k2 \ kernel/start.o kernel/console.o ... kernel/virtio_disk.o kernel/entry.o$ riscv64-unknown-elf-nm -n k2 | grep -w _entry0000000080000000 T _entryentry.o 排在最后,_entry 仍在 0x80000000。GNU ld 手册在 "Input Section Basics" 一节里只说,脚本里出现一个不带通配符的文件名时,如果命令行和 INPUT 命令里都没有它,链接器会"attempt to open the file as an input file, as though it appeared on the command line"(手册),没有说输入顺序怎么定。这要看实现。binutils 2.42 的 ld/ldlang.c 里,open_input_bfds(第 3528 行起)按语句表的顺序逐条处理,遇到不带通配符的文件名时(第 3543 到 3549 行)调用 lookup_name(第 2869 行)。lookup_name 找到命令行上那个同名文件的输入语句,调用 load_symbols 加载它,加载时第 3081 行调用 ldlang_add_file,把文件挂到 file_chain 的末尾(第 7560 行)。后面给通配符分配输入节的那个函数(第 984 行)用 LANG_FOR_EACH_INPUT_STATEMENT 遍历的正是 file_chain,也就是文件被加载的顺序。
所以起作用的是"最先被加载"。-T 写在目标文件前面时,脚本的语句在语句表里排在命令行文件之前,处理到 kernel/entry.o(_entry) 时 entry.o 就被加载了,比命令行上的其他文件都早,*(.text .text.*) 收集 .text 时它排在第一位;括号里的 _entry 匹配不到节,并不影响这一步。把 -T kernel/kernel.ld 挪到命令行末尾,命令行上的文件先按原顺序加载,_entry 就跑到了 0x80005b42;把这一行从脚本里删掉,结果也一样,0x80000000 处是 timerinit。
ld.lld 没有这个副作用,脚本里写了文件名也不改变输入顺序,顺序完全按命令行。同样把 entry.o 放到最后,lld 给出的也是 0x80000000 处是 timerinit、_entry 在 0x80005b42;把这一行改成 kernel/entry.o(.text),它才落到 0x80000000。正常构建时 Makefile 把 entry.o 排在第一个,两个链接器都没问题:用 clang 和 ld.lld 构建的 xv6 内核同样能启动到 shell。
trampsec:一个必须恰好占一页的节
接下来四行处理 trampsec,这个节里装的是 trampoline。trampoline 是用户态和内核之间的中转代码:用户程序发生系统调用或中断时先跳到这里,它保存寄存器,再把页表换成内核的;返回时反过来。RISC-V 用 satp 这个 CSR 指定当前页表,写 satp 的那条指令执行完,下一条指令就要按新页表取指。所以这段代码在用户页表和内核页表里必须映射在同一个虚拟地址上。xv6 选的是虚拟地址空间顶端的一页,kernel/memlayout.h 定义 TRAMPOLINE 为 MAXVA - PGSIZE,vm.c 在内核页表里映射它:
kvmmap(kpgtbl, TRAMPOLINE, (uint64)trampoline, PGSIZE, PTE_R | PTE_X);proc.c 在每个进程的页表里映射同一页。
trampsec 来自 kernel/trampoline.S,那里写的是不带任何标志的 .section trampsec:
$ riscv64-unknown-elf-readelf -SW kernel/trampoline.o | grep trampsec [ 4] trampsec PROGBITS 0000000000000000 000040 000124 00 0 0 16Flg 一栏是空的,这个输入节既不是 SHF_ALLOC 也不是可执行的。第 2 章讲过节标志;GNU as 手册说,不写标志时默认标志取决于节名,不认识的节名就什么标志都没有(as 手册 .section)。它照样能被装入内存、照样能执行,是因为脚本把它放进了 .text 这个输出节,输出节的标志由放进去的所有输入节合起来决定。
每个页表里只映射这一页,所以 trampsec 前后各有一个 . = ALIGN(0x1000);,让它从一页的开头开始、单独占满一页,不和别的代码挤在同一页里;_trampoline = .; 记下起点,ASSERT(. - _trampoline == 0x1000, ...) 在链接时检查它没有超过一页。超过了,第二页不在映射里,内核运行到那里才会出错;有了 ASSERT,链接时就会报出来。
trap.c 跳进 trampoline 时,算目标地址用的是 TRAMPOLINE + (uservec - trampoline):uservec 和 trampoline 都是 trampoline.S 里的标号,两者之差是页内偏移,加上 TRAMPOLINE 才是运行时的地址。同一条指令因此有两个地址,链接器给的 0x8000xxxx 和页表给的 0x3ffffffxxx。
PROVIDE(etext) 和 end
.text 的最后一行是 PROVIDE(etext = .);。第 5 章讲过 PROVIDE:只有程序引用了这个符号、而又没有自己定义时才生效。它前面的 ALIGN(0x1000) 保证 etext 落在页边界上,因为 vm.c 要用它在内核页表里划分权限:
extern char etext[]; // kernel.ld sets this to end of kernel code. kvmmap(kpgtbl, KERNBASE, KERNBASE, (uint64)etext - KERNBASE, PTE_R | PTE_X); kvmmap(kpgtbl, (uint64)etext, (uint64)etext, PHYSTOP - (uint64)etext, PTE_R | PTE_W);KERNBASE 是 0x80000000,PHYSTOP 是 KERNBASE + 128 * 1024 * 1024。KERNBASE 到 etext 映射成可读可执行,etext 到 PHYSTOP 映射成可读可写。页表按页设权限(第 5 章),etext 如果不在页边界,它所在的那一页只能二选一。
最后一行 PROVIDE(end = .); 给出内核映像之后的第一个地址,kalloc.c 拿它当空闲物理内存的起点:
extern char end[]; // first address after kernel. freerange(end, (void *)PHYSTOP);freerange 先把起点 PGROUNDUP 到页边界,再把到 PHYSTOP 为止的每一页交给页分配器。
C 代码把它们声明成 extern char etext[],而不是 extern char etext。链接器定义的这类符号只有地址,那个地址上并没有一个属于它的变量。写成数组,表达式 etext 本身就是地址,不会被误当成一个 char 变量去读。
实际的数字
$ riscv64-unknown-elf-readelf -lW kernel/kernel Type Offset VirtAddr PhysAddr FileSiz MemSiz Flg Align RISCV_ATTRIBUT 0x008860 0x0000000000000000 0x0000000000000000 0x000057 0x000000 R 0x1 LOAD 0x001000 0x0000000080000000 0x0000000080000000 0x007860 0x020bb0 RWE 0x1000 GNU_STACK 0x000000 0x0000000000000000 0x0000000000000000 0x000000 0x000000 RW 0x10$ riscv64-unknown-elf-nm -n kernel/kernel | grep -wE "_entry|start|main|_trampoline|trampoline|etext|stack0|end"0000000080000000 T _entry0000000080000058 T start0000000080000e02 T main0000000080006000 T _trampoline0000000080006000 T trampoline0000000080007000 T etext0000000080007890 B stack00000000080020bb0 B end整个内核只有一个 PT_LOAD,权限是 RWE,GNU ld 为此给了 RWX 警告。第 5 章用 -z max-page-size=65536 演示过同一种现象:只读部分和可写部分如果落在链接器认为的同一页里,GNU ld 就把它们并成一个段。kernel.ld 的 etext 虽然在页边界上,.rodata 之后紧接着就是 .data,中间没有对齐到页,结果四个输出节并进了一个段。对 xv6 这不是问题:QEMU 装入时不管段权限,内核运行时的权限由 vm.c 按 etext 建的页表决定。这也是一个例子:同一个程序头字段,有的加载器当真(第 6 章的 Linux),有的完全不看。
0x80006000 这个数还和链接器的一个优化有关。xv6 的 Makefile 没有加 -mno-relax,GNU ld 会做 RISC-V 的链接器松弛(relaxation)。第 4 章 "RISC-V:会改变代码长度的 relaxation" 一节讲过:带 R_RISCV_RELAX 标记的 auipc 加 jalr,目标在 ±1 MiB 以内时可以换成一条 4 字节的 jal,链接器删掉多出来的字节。映射文件里,trampoline 之前的代码结束于 0x80005b62。加上 --no-relax 重新链接同一组目标文件,结束位置变成 0x80006906,多出近三千五百字节(0xda4),跨过了一个页边界,_trampoline 变成 0x80007000,etext 变成 0x80008000,end 变成 0x80021bb0。脚本没有变,. 每一次推进的量取决于前面放进去了多少字节,松弛改变了这个字节数,后面的地址就都变了。
从 _entry 到 main
第 6 章跟着 musl11 从 _start 走到 main,那时内核已经在栈上放好了 argc、argv 和辅助向量,.bss 也由内核映射的匿名页补成了零。QEMU 跳到 xv6 的 _entry 时,代码和数据已经装入,启动参数也已放进寄存器,但尚未建立供 C 函数使用的栈。kernel/entry.S 全文只有十几行:
# qemu -kernel loads the kernel at 0x80000000 # and causes each hart (i.e. CPU) to jump there. # kernel.ld causes the following code to # be placed at 0x80000000..section .text.global _entry_entry: # set up a stack for C. # stack0 is declared in start.c, # with a 4096-byte stack per CPU. # sp = stack0 + ((hartid + 1) * 4096) la sp, stack0 li a0, 1024*4 csrr a1, mhartid addi a1, a1, 1 mul a0, a0, a1 add sp, sp, a0 # jump to start() in start.c call startspin: j spin复位 ROM 在每个 hart 上都会执行,-smp 3 时三个 hart 同时跳到 _entry,同时执行这段代码。所以栈要按 hart 分开。stack0 在 kernel/start.c 里定义:
// entry.S needs one stack per CPU.__attribute__((aligned(16))) char stack0[4096 * NCPU];NCPU 是 8,stack0 一共 32 KiB,没有初值,落在 .bss 里,上面 nm12 看到它在 0x80007890。RISC-V 的栈向低地址增长,栈指针要指向栈的顶端,所以 hart 0 的 sp 是 stack0 + 4096,hart 1 是 stack0 + 8192,依此类推,每个 hart 用自己那 4 KiB 的最高地址往下长。la sp, stack0 在 medany 下展开成 auipc 加 addi,反汇编里是:
80000000: 00008117 auipc sp,0x880000004: 89010113 addi sp,sp,-1904 # 80007890 <stack0>这里的 .bss 清零由 QEMU 承担,xv6 的这条启动路径没有另写一遍清零循环:前面说过,-kernel 装入 ELF 时会把 p_memsz 多出的部分补零(xv6 唯一的段不和别的段重叠),模拟器的内存一开始本来也全是零。换到真实硬件上,复位后的内存内容是不确定的,这件事就得由启动代码自己做。
RISC-V 的特权级区分机器管理、内核和用户代码:machine(M)权限最高,supervisor(S)供操作系统使用,user(U)供用户程序使用。本例从 M 态启动。call start 跳进 C 函数 start,这时 CPU 仍在 M 态。start 的任务是把 CPU 切到 S 态,让 main 在 S 态运行:
voidstart(){ // set M Previous Privilege mode to Supervisor, for mret. unsigned long x = r_mstatus(); x &= ~MSTATUS_MPP_MASK; x |= MSTATUS_MPP_S; w_mstatus(x);
// set M Exception Program Counter to main, for mret. // requires gcc -mcmodel=medany w_mepc((uint64)main);
// disable paging for now. w_satp(0); ... // keep each CPU's hartid in its tp register, for cpuid(). int id = r_mhartid(); w_tp(id);
// switch to supervisor mode and jump to main(). asm volatile("mret");}RISC-V 没有一条"切到 S 态"的指令,切换借用的是异常返回。mret 是从 M 态异常处理程序返回的指令,它做两件事:跳到 mepc 寄存器里的地址,把特权级设成 mstatus 寄存器 MPP 字段里记的那个级别。正常情况下这两个值是异常发生时硬件存进去的;start 自己把 MPP 写成 S,把 mepc 写成 main 的地址,mret 一执行,CPU 就"返回"到了一个从没来过的地方。中间几行把异常和中断委托给 S 态处理,并配置 PMP(physical memory protection,物理内存保护,M 态用它规定低特权级能访问哪些物理地址范围):w_pmpaddr0(0x3fffffffffffffull) 加 w_pmpcfg0(0xf) 让 S 态可以访问全部物理内存。satp 写 0 表示先不开分页,S 态里地址就是物理地址。
注释 "requires gcc -mcmodel=medany" 对应的就是上一节 medlow 的那个报错:(uint64)main 要算出 main 的地址,medlow 用 lui 拼绝对地址,拼不出 0x80000000 以上的值;medany 用 auipc,算出的是运行时的真实地址。
w_tp(id) 也揭示了它与普通应用的区别。RISC-V ABI13 通常把 tp 用作线程指针;xv6 在这里保存硬件线程编号,cpuid() 再读出它,以 cpus[cpuid()] 取得当前 CPU 的内核状态。它没有按第 9 章的 ELF TLS14 模板建立这些对象,而是由启动代码和全局数组共同实现每 CPU 一份的存储(start.c、proc.c)。
到 main 为止,这条启动路径用到的地址有三类来源。_entry 的位置由脚本里的 . = 0x80000000 决定;stack0、start、main 是普通的 C 符号,地址由链接器按布局分配,机器码里通过 PC 相对的重定位引用;etext 和 end 是脚本自己定义的符号,main 接下来调用的 kinit() 和 kvminit() 才用到它们。第 6 章里,Linux 内核通过辅助向量 AT_PHDR、AT_ENTRY 告诉用户程序"你的程序头在哪、入口在哪";xv6 内核关于自己的这些信息,全部来自链接器脚本。
VMA 与 LMA 分离的启动方式
QEMU 的 ELF 加载实现还处理了这份约定的一个边界:文件里的初值可能紧密排列,而每段运行时需要的空间更大。如果无条件按 p_paddr + p_memsz 补零,就可能覆盖后一个段的初值。因此它检查段的重叠关系,在有冲突时只装入文件提供的 p_filesz 字节;这也是前面补零规则带有限定的原因(QEMU v10.2.1,elf_ops.h.inc)。
JOS:链接在 0xF0100000,装在 0x100000
JOS 的内核需要两个地址分开。它运行在 x86 的 32 位保护模式下,内核要放在虚拟地址空间的高处,把低处留给用户程序;可是引导时还没有页表,内核只能被装到物理内存的低处。JOS 的 kern/kernel.ld 这样写(https://pdos.csail.mit.edu/6.828/2018/jos.git,lab1 分支 commit a56269d):
/* Link the kernel at this address: "." means the current address */ . = 0xF0100000;
/* AT(...) gives the load address of this section, which tells the boot loader where to load the kernel in physical memory */ .text : AT(0x100000) { *(.text .stub .text.* .gnu.linkonce.t.*) }AT(地址) 写在输出节名后面,单独指定这个节的 LMA;VMA 仍由 . 决定。后面的 .rodata、.data 没有写 AT,GNU ld 手册给出的规则是:没写 AT 也没写 AT> 的可分配节,如果能找到一个合适的内存区域、且区域里已经有节,就让"LMA 与 VMA 之差"和该区域里上一个节保持一致;没有声明 MEMORY 时,整个地址空间算一个默认区域(Output Section LMA)。于是后面的节都跟着 .text 往下平移 0xF0000000,整个内核在文件里描述成"链接在 0xF01xxxxx,装在 0x001xxxxx"。
JOS 的引导程序 boot/main.c 按 ph->p_pa(即 p_paddr)把每个段读进物理内存,然后调用 e_entry。这时还没开分页,跳到 0xF01xxxxx 会扑空,所以 kern/entry.S 把入口符号定义成物理地址:
#define RELOC(x) ((x) - KERNBASE)....globl _start_start = RELOC(entry)_start 的值是 entry 的链接地址减去 KERNBASE(0xF0000000),即 entry 的加载地址。entry 之后的几条指令在低地址上运行:它们用 RELOC(entry_pgdir) 取页目录的物理地址写进 %cr3,打开分页。kern/entrypgdir.c 里的这张临时页表把虚拟地址 [0, 4MB) 和 [KERNBASE, KERNBASE+4MB) 都映射到物理地址 [0, 4MB),所以开分页之后低地址上的指令还能接着执行。然后:
mov $relocated, %eax jmp *%eaxrelocated:$relocated 是链接地址,一条间接跳转让运行地址第一次等于链接地址,此后才进入 C 代码。
高地址 RISC-V 映像需要先建立映射
把开头的程序改成同样的结构:链接在 0xffffffff80000000,装在 0x80000000。只需要改脚本的前两行:
. = 0xffffffff80000000; .text : AT(0x80000000) { *(.text.entry) *(.text .text.*) }medany 要求代码和数据彼此相距 ±2 GiB 以内,对绝对位置没有要求,所以链接在 64 位地址空间顶端没有问题。两个链接器给出的程序头:
$ ld.lld -T high.ld -o high.elf entry.o main.o && llvm-readelf -lW high.elf Type Offset VirtAddr PhysAddr FileSiz MemSiz Flg Align LOAD 0x001000 0xffffffff80000000 0x0000000080000000 0x0000e4 0x0000e4 R E 0x1000 LOAD 0x0010e4 0xffffffff800000e4 0x00000000800000e4 0x000057 0x000057 R 0x1000 LOAD 0x001140 0xffffffff80000140 0x0000000080000140 0x000010 0x000010 RW 0x1000$ riscv64-unknown-elf-ld -m elf64lriscv -T high.ld -o high_bfd.elf entry.o main.o && riscv64-unknown-elf-readelf -lW high_bfd.elfriscv64-unknown-elf-ld: warning: high_bfd.elf has a LOAD segment with RWX permissions LOAD 0x001000 0xffffffff80000000 0x0000000080000000 0x000150 0x000150 RWE 0x1000lld 和 GNU ld 分段的方式不同,但 p_vaddr 和 p_paddr 之差都是 0xffffffff00000000,后面没写 AT 的 .rodata、.data 都跟着平移了。lld 的文档也写了同样的规则:前一个节和当前节在同一个默认 LMA 区域里时,"the difference between the LMA and the VMA is computed to be the same as the previous difference"(lld linker script 说明)。
用 -bios none 运行,QEMU 按 p_paddr 装到 0x80000000,跳到 0x80000000,情形和 bad.bin 一样:第一行靠 PC 相对寻址打印出来,读 greeting 指向的字符串时访问了 0xffffffff800000fd,那里什么都没有:
1: via pc-relative literalriscv_cpu_do_interrupt: hart:0, async:0, cause:0000000000000005, epc:0x80000088, tval:0xffffffff800000fd, desc=fault_loadcause 5 是 load access fault,tval 是出错的地址。要让它跑下去,得像 JOS 那样,在用到任何绝对地址之前先建一张页表,把 0xffffffff80000000 映射到 0x80000000,开分页,再跳到链接地址。RISC-V 上的 64 位 Linux 内核也链接在这样的高地址上,启动早期同样要先建页表。
ROM 里的 .data
另一种 VMA 和 LMA 分开的场合在单片机上,而且更常见。单片机通常有两种存储:Flash 掉电不丢失、可以执行代码,但运行时不能随便写;RAM 可读可写,但掉电就清空。程序的代码、只读数据和全局变量的初值都要烧进 Flash,可全局变量运行时要被修改,它们的地址必须在 RAM 里。于是 .data 的 LMA 在 Flash,VMA 在 RAM,上电后由启动代码把初值从 Flash 拷到 RAM。.bss 不需要初值,只占 RAM,启动代码把它清零。
链接器脚本用 MEMORY 命令声明这两块存储,第 5 章提过它的形式。下面在 QEMU 的内存里划出两块来模拟,"ROM"从 0x80000000 起,"RAM"从 0x80100000 起:
/* rom.ld */ENTRY(_entry)MEMORY{ ROM (rx) : ORIGIN = 0x80000000, LENGTH = 64K RAM (rwx) : ORIGIN = 0x80100000, LENGTH = 64K}SECTIONS{ .text : { *(.text.entry) *(.text .text.*) } > ROM .rodata : { *(.rodata .rodata.* .srodata .srodata.*) } > ROM .data : ALIGN(8) { _sdata = .; *(.data .data.* .sdata .sdata.*) . = ALIGN(8); _edata = .; } > RAM AT> ROM _sidata = LOADADDR(.data); .bss (NOLOAD) : ALIGN(8) { _sbss = .; *(.bss .bss.* .sbss .sbss.*) . = ALIGN(8); _ebss = .; } > RAM stack_top = ORIGIN(RAM) + LENGTH(RAM);}几个新写法:> 区域 指定输出节的 VMA 放在哪个区域,链接器在区域里顺序往后排;AT> 区域 指定 LMA 放在哪个区域,和 AT(地址) 只能二选一;LOADADDR(.data) 返回 .data 的 LMA,相应地 ADDR(.data) 返回 VMA;本例中的 (NOLOAD) 让 .bss 保留地址空间而不提供文件内容,但不能据此断定加载器无需处理它:ELF 下还要看它是否计入 PT_LOAD 的内存范围,后者可能要求补零;ORIGIN()、LENGTH() 取区域的起点和长度。_sdata、_edata 在 .data 里面,它们和 . 一样是 VMA;_sidata 用 LOADADDR 取出 LMA,名字里的 i 指 initial values。STM32 等 ARM Cortex-M 芯片的厂商启动文件用的就是这套名字,ST 的 startup_stm32f407xx.s 在 _sidata 前面的注释是 "start address for the initialization values of the .data section"。
启动代码在调用 main 之前做两件事:
_entry: la sp, stack_top # 把 .data 的初值从 LMA(ROM)拷到 VMA(RAM) la t0, _sidata la t1, _sdata la t2, _edata1: bgeu t1, t2, 2f ld t3, 0(t0) sd t3, 0(t1) addi t0, t0, 8 addi t1, t1, 8 j 1b # 把 .bss 清零2: la t1, _sbss la t2, _ebss3: bgeu t1, t2, 4f sd zero, 0(t1) addi t1, t1, 8 j 3b4: call main循环每次拷 8 个字节,所以脚本里给 .data 和 .bss 都写了 ALIGN(8),让起点和终点都是 8 的倍数。链接后看节和段:
$ ld.lld -T rom.ld -o rom.elf entry_rom.o main.o$ llvm-objdump -h rom.elfIdx Name Size VMA LMA Type 1 .text 0000012a 0000000080000000 0000000080000000 TEXT 2 .rodata 00000057 000000008000012a 000000008000012a DATA 3 .data 00000010 0000000080100000 0000000080000188 DATA 4 .bss 00000000 0000000080100010 0000000080100010 BSS$ llvm-readelf -lW rom.elf Type Offset VirtAddr PhysAddr FileSiz MemSiz Flg Align LOAD 0x001000 0x0000000080000000 0x0000000080000000 0x00012a 0x00012a R E 0x1000 LOAD 0x00112a 0x000000008000012a 0x000000008000012a 0x000057 0x000057 R 0x1000 LOAD 0x002000 0x0000000080100000 0x0000000080000188 0x000010 0x000010 RW 0x1000$ llvm-nm -n rom.elf | grep -E ' _s| _e|stack'0000000080000188 A _sidata0000000080100000 D _sdata0000000080100010 B _ebss0000000080100010 D _edata0000000080100010 B _sbss0000000080110000 A stack_top.data 的 VMA 是 0x80100000,LMA 是 0x80000188,紧跟在 .rodata 的末尾 0x80000181 之后、按 8 对齐。第三个 PT_LOAD 的 p_vaddr 和 p_paddr 就是这两个数。.bss 这次是空的(main.c 没有未初始化的全局变量),_sbss 等于 _ebss,清零循环一次也不执行。QEMU 按 p_paddr 把 .data 的初值放在 0x80000188,启动代码拷到 0x80100000,程序照常打印四行。
把拷贝那一段跳过去(在 la t0, _sidata 前插一条 j 2f),RAM 里的 .data 就全是零,greeting 是空指针:
$ qemu-system-riscv64 -machine virt -bios none -m 128M -nographic -kernel nocopy.elf -d int -D nc.log1: via pc-relative literal$ head -1 nc.logriscv_cpu_do_interrupt: hart:0, async:0, cause:0000000000000005, epc:0x800000d0, tval:0x0000000000000000, desc=fault_loadputs 读地址 0,触发 load access fault。在真实的单片机上 RAM 上电后的内容不确定,读到的可能是任何值,症状会更难查。
同一份脚本交给 GNU ld,结果有两处不同:
$ riscv64-unknown-elf-ld -m elf64lriscv -T rom.ld -o rom_bfd.elf entry_rom.o main.o$ riscv64-unknown-elf-objdump -h rom_bfd.elf 2 .data 00000010 0000000080100000 0000000080000188 00002000 2**3 3 .bss 00000000 0000000080100010 0000000080000198 00000000 2**3$ riscv64-unknown-elf-readelf -lW rom_bfd.elf LOAD 0x001000 0x0000000080000000 0x0000000080000000 0x000181 0x000181 R E 0x1000 LOAD 0x002000 0x0000000080100000 0x0000000080000188 0x000010 0x000010 RW 0x1000GNU ld 把 .text 和 .rodata 并进了一个段,lld 分成两个,这是两个链接器默认分段策略的差别。.bss 的 LMA,GNU ld 给的是 0x80000198,lld 给的是和 VMA 相同的 0x80100010。.bss 只写了 > RAM,没写 AT>;lld 的文档专门写了一句 "GNU ld propagates the previous LMA memory region when address is not specified",GNU ld 沿用上一个节的 LMA 区域,于是把 .bss 的 LMA 也排进了 ROM;lld 不这样做,LMA 等于 VMA。.bss 是 NOLOAD,文件里没有它的内容,这个差别不影响运行,用 objcopy -O binary 时就未必了,后面的练习会遇到另一处 LMA 的差别。
用 GNU ld 链接的 rom_bfd.elf 在 QEMU 里同样打印四行。斯坦福 CS140e 的树莓派课程用的脚本 libpi/memmap 走的是中间一种路线:树莓派的 GPU 固件把整个 kernel.img 原样读进 0x8000,代码和数据都在 RAM 里,脚本写 .text 0x8000 :,没有 AT,VMA 等于 LMA,不用拷 .data;但 .bss 依旧没人管,脚本定义 __bss_start__、__bss_end__,libpi/staff-src/cstart.c 的 _cstart 先把这一段清零再调用 notmain,注释写的是 "setting up 'the C runtime environment' involves just zeroing out the bss section"。
把数据塞进程序
启动时还不能读取文件系统,内核所需的数据可以预先嵌入内核映像,随它一起装入内存:第一个用户程序、字体、设备固件都是这样,Linux 的 initramfs(启动早期用的一个内存文件系统镜像)也可以直接编进内核。问题是怎样把一个普通文件变成链接器能处理的输入。
ld -b binary
GNU ld 的 -b(--format)选项指定其后输入文件的格式。-b binary 让链接器把文件内容原样当作一个 .data 节,并凭空生成三个符号。准备一个 12 字节的文件 data/msg-v1.txt(内容是 hello, blob 加换行),用 -r 只做部分链接,看生成了什么:
$ riscv64-unknown-elf-ld -m elf64lriscv -r -b binary -o blob_bfd.o data/msg-v1.txt$ riscv64-unknown-elf-readelf -SsW blob_bfd.o [ 1] .data PROGBITS 0000000000000000 000040 00000c 00 WA 0 0 1 2: 000000000000000c 0 NOTYPE GLOBAL DEFAULT ABS _binary_data_msg_v1_txt_size 3: 0000000000000000 0 NOTYPE GLOBAL DEFAULT 1 _binary_data_msg_v1_txt_start 4: 000000000000000c 0 NOTYPE GLOBAL DEFAULT 1 _binary_data_msg_v1_txt_end符号名是 _binary_ 加上命令行里写的路径,再加 _start、_end、_size,路径里不能出现在标识符中的字符(/、-、.)都换成了下划线。所以同一个文件换一种写法传进去,比如 ./data/msg-v1.txt,符号名也会变。_start 和 _end 定义在 .data 里,_size 是绝对符号(ABS,不属于任何节,值不随布局变化),它的值就是 12。JOS Lab 3 讲的就是这件事:"the linker has 'magically' produced a number of funny symbols with obscure names like _binary_obj_user_hello_start ... The linker generates these symbol names by mangling the file names"(lab3)。
ld.lld 也支持 -b binary(-r 时要加 -m elf64lriscv,因为没有 ELF 输入可供推断目标),符号名相同,只是节对齐是 8,符号类型是 OBJECT。
在 C 里用这三个符号,要按链接器定义的符号的规矩来,声明成数组,用地址而不用值。_size 的"地址"就是长度:
extern const char _binary_data_msg_v1_txt_start[], _binary_data_msg_v1_txt_end[];extern const char _binary_data_msg_v1_txt_size[]; /* 绝对符号:它的"地址"就是长度 */void main(void) { for (const char *p = _binary_data_msg_v1_txt_start; p < _binary_data_msg_v1_txt_end; p++) putc(*p); unsigned long n = (unsigned long)_binary_data_msg_v1_txt_size; putc('0' + n / 10); putc('0' + n % 10); putc('\n');}在最终链接时直接写 -b binary 文件 -b default(GNU ld 写 -b elf64-littleriscv 切回来),两个链接器的产物在 QEMU 里都打印出文件内容和 12。可要是先用 -r 把文件做成 blob_*.o 再拿去链接,lld 会拒绝:
$ ld.lld -T link.ld -o x.elf entry.o show.o blob_bfd.old.lld: error: blob_bfd.o: cannot link object files with different floating-point ABI from entry.o原因在 ELF 头的 e_flags。RISC-V 用这个字段记录目标文件的指令集扩展和浮点调用约定,-mabi=lp64d 编出的目标文件是 0x5,即 RVC(用了 16 位压缩指令)加 double-float ABI(浮点参数用浮点寄存器传);从原始二进制生成的目标文件没有代码,e_flags 是 0,表示 soft-float(浮点参数用整数寄存器传)。lld 要求所有输入一致。GNU ld 不报错,是因为 binutils 2.42 的 bfd/elfnn-riscv.c 在合并 e_flags 前先检查输入有没有代码节,第 4050 到 4066 行的 only_data_sections 为真时直接跳过检查(源码)。
objcopy -I binary
objcopy 也能做同样的转换,好处是能顺手改节名和标志。下面把数据放进只读的 .rodata.blob:
$ riscv64-unknown-elf-objcopy -I binary -O elf64-littleriscv -B riscv \ --rename-section .data=.rodata.blob,alloc,load,readonly,data,contents \ data/msg-v1.txt blob_objcopy.o$ riscv64-unknown-elf-readelf -SsW blob_objcopy.o [ 1] .rodata.blob PROGBITS 0000000000000000 000040 00000c 00 A 0 0 1 1: 0000000000000000 0 NOTYPE GLOBAL DEFAULT 1 _binary_data_msg_v1_txt_start符号名的规则和 ld -b binary 相同,e_flags 仍是 0,lld 照样拒绝,llvm-objcopy 的产物也一样。
objcopy 的另一个方向 -O binary 本章已经用过:它按有文件内容、需要装载的节的 LMA 把内容平铺成一个文件,最低的 LMA 对应文件的第 0 个字节,中间的空隙填零,ELF 头、节头、符号全部丢掉。bad.bin 就是这样得到的。
.incbin、#embed 和 include_bytes!
上面两种办法都绕开了编译器,e_flags 的问题也由此而来。让汇编器或编译器把字节嵌进来,生成的目标文件和其他文件一样带着正确的 e_flags,节名和符号名也由自己决定。汇编器的伪指令 .incbin 把一个文件的内容原样插入当前位置:
.section .rodata.blob, "a" .globl blob_start, blob_endblob_start: .incbin "data/msg-v1.txt"blob_end:C23 标准加入了预处理指令 #embed,把文件内容展开成逗号分隔的整数列表,clang 21 在 -std=c23 下支持:
const char blob[] = {#embed "data/msg-v1.txt"};const unsigned long blob_len = sizeof blob;$ llvm-readelf -hsW incbin.o embed.o | grep -E 'Flags:|blob' Flags: 0x5, RVC, double-float ABI 3: 0000000000000000 0 NOTYPE GLOBAL DEFAULT 3 blob_start 4: 000000000000000c 0 NOTYPE GLOBAL DEFAULT 3 blob_end Flags: 0x5, RVC, double-float ABI 5: 0000000000000000 12 OBJECT GLOBAL DEFAULT 3 blob 6: 0000000000000010 8 OBJECT GLOBAL DEFAULT 3 blob_len#embed 的结果是一个普通的 C 数组,有类型、有大小(st_size 是 12),编译器知道它多长。Rust 的 include_bytes! 是同一类做法,pub static BLOB: &[u8] = include_bytes!("data/msg-v1.txt"); 编出的目标文件里(以下字节布局以原生 x86-64 Linux 目标为例),12 个字节进了一个匿名的只读节 .rodata..Lanon.*,BLOB 是放在 .data.rel.ro.BLOB 里的 16 字节切片:前 8 字节是指针,由一条 R_X86_64_64 指向那个匿名节,后 8 字节是长度 12。
xv6 的首个进程是怎么进内核的
xv6 在历史上对"第一个用户进程的代码从哪里来"给过三种答案,正好对应上面几种办法。
x86 版的 xv6-public 用 ld -b binary。它的 Makefile 写的是 $(LD) $(LDFLAGS) -T kernel.ld -o kernel entry.o $(OBJS) -b binary initcode entryother,x86 版 xv6 book 第 1 章说:"as part of the kernel build process, the linker embeds that binary in the kernel and defines two special symbols, _binary_initcode_start and _binary_initcode_size"(book-rev11)。
RISC-V 版早期换成了手工抄字节。user/initcode.S 先按 -N -e start -Ttext 0 链接到地址 0,再用 objcopy -S -O binary 去掉 ELF 包装,然后用 od -t xC 把字节打印出来,抄进 kernel/proc.c 的 uchar initcode[]。userinit 把这个数组拷进新进程地址 0 处的一页,设 epc = 0。在 commit b698485 的父提交里,数组是这样的:
// a user program that calls exec("/init")// assembled from ../user/initcode.S// od -t xC ../user/initcodeuchar initcode[] = { 0x17, 0x05, 0x00, 0x00, 0x13, 0x05, 0x45, 0x02, 0x97, 0x05, 0x00, 0x00, 0x93, 0x85, 0x35, 0x02, 0x93, 0x08, 0x70, 0x00, 0x73, 0x00, 0x00, 0x00, 0x93, 0x08, 0x20, 0x00, 0x73, 0x00, 0x00, 0x00, 0xef, 0xf0, 0x9f, 0xff, 0x2f, 0x69, 0x6e, 0x69, 0x74, 0x00, 0x00, 0x24, 0x00, 0x00, 0x00, 0x00, 0x00, 0x00, 0x00, 0x00};2f 69 6e 69 74 是字符串 /init。紧跟在后面的 24 00 00 00 ... 是 initcode.S 里 argv 数组的第一项 .quad init,也就是字符串 init 的绝对地址 0x24。这个绝对地址只在程序装在地址 0 时才对,所以链接时要 -Ttext 0、运行时要 epc = 0,链接地址、加载地址、运行地址在这里必须一致。在 Linux 上用 RISC-V GNU 工具链按当时的 Makefile 规则重新生成,前 52 个字节与这个数组完全相同,末尾多出 8 个零字节,是 argv 的第二项 .quad 0。
2025 年的 commit b698485(作者日期 2025-06-08)删掉了这一切,提交说明是 "No need to exec init process through initcode":第一个进程在 forkret 里等文件系统初始化好以后,直接调用 exec(现在叫 kexec)执行 /init,从文件系统读取程序。这样就不用再嵌入任何东西了。三种答案的取舍在于启动时能依赖什么:文件系统还没准备好时,数据只能随内核一起装入;能读文件之后,嵌入就成了多余的耦合,改一个用户程序要重新编译内核。
内核脚本里的其他语法
xv6 的脚本只用到了链接器脚本的一小部分。规模大一些的内核会用到更多写法,Linux 把各架构共用的那部分写成宏,集中在 include/asm-generic/vmlinux.lds.h。下面挑几种内核里常见、用户程序里很少见的写法,每种都在两个链接器上实测。
KEEP 和 SORT:一张由链接器拼起来的表
内核里有一类"注册表":各个驱动、子系统在自己的源文件里声明"启动时请调用我",谁也不引用谁,由链接器把这些声明收集成一张连续的表,启动代码从头到尾调用一遍。Linux 的 initcall 就是这样做的,vmlinux.lds.h 里的 INIT_CALLS_LEVEL(level) 展开成 __initcall##level##_start = .; 和 KEEP(*(.initcall##level##.init))。下面是一个缩小的版本,三个函数分别登记在 3、1、2 三个级别:
typedef void (*initcall_t)(void);#define initcall(fn, lvl) \ static initcall_t __initcall_##fn __attribute__((used, section(".initcall" #lvl))) = fnstatic void a(void) {} initcall(a, 3);static void b(void) {} initcall(b, 1);static void c(void) {} initcall(c, 2);extern initcall_t __initcall_start[], __initcall_end[];void _entry(void) { for (initcall_t *p = __initcall_start; p < __initcall_end; p++) (*p)(); }ENTRY(_entry)SECTIONS{ . = 0x80000000; .text : { *(.text .text.*) } .data : { . = ALIGN(8); __initcall_start = .; KEEP(*(SORT(.initcall*))) __initcall_end = .; *(.data .data.* .sdata .sdata.*) } .empty : { marker = .; } /DISCARD/ : { *(.comment) *(.riscv.attributes) } ASSERT(__initcall_end - __initcall_start == 3 * 8, "expected 3 initcalls")}用 -ffunction-sections 编译,--gc-sections 链接:
$ ld.lld --gc-sections -T calls.ld -o c_lld.elf calls.o$ llvm-nm -n c_lld.elf | grep __initcall0000000080000038 d __initcall_b0000000080000038 D __initcall_start0000000080000040 d __initcall_c0000000080000048 d __initcall_a0000000080000050 D __initcall_endGNU ld 给出的地址完全相同。SORT(即 SORT_BY_NAME)让匹配到的输入节按节名排序,.initcall1、.initcall2、.initcall3 的顺序就是调用的顺序;去掉它,表项按输入文件里节出现的顺序排列,变成 a、b、c。排序是按字符串比较的,.initcall10 会排在 .initcall2 前面,级别多于 10 个时要补零。GNU ld 还有 SORT_BY_ALIGNMENT、SORT_BY_INIT_PRIORITY 等变体,后者按节名末尾的数字排序,.init_array.NNNNN 用的就是它。
KEEP 在第 5 章讲 GC15 时出现过:它让匹配到的节成为 GC 的根。这张表里的每一项都没有被任何代码按名字引用,_entry 只引用了 __initcall_start 和 __initcall_end 这两个由脚本定义的符号。__attribute__((used)) 只能阻止编译器把变量删掉,管不到链接器。去掉 KEEP,--gc-sections 就把三项全删了,表是空的,程序照样能链接,只是启动时什么也不调用。所以脚本最后加了一条 ASSERT,去掉 KEEP 后两个链接器都在链接时报错:
$ ld.lld --gc-sections -T nokeep.ld -o x calls.old.lld: error: expected 3 initcalls$ riscv64-unknown-elf-ld -m elf64lriscv --gc-sections -T nokeep.ld -o x calls.oriscv64-unknown-elf-ld: expected 3 initcallsASSERT(表达式, "消息") 可以写在输出节里面,像 xv6 那样,也可以写在 SECTIONS 的顶层。它在布局算完以后求值,表达式为 0 时链接失败,消息原样打印。
ALIGN 的两种位置
ALIGN 出现过两种写法。. = ALIGN(0x1000); 是一条赋值语句,把位置计数器推到下一个边界,可以写在输出节内外任何地方。写在输出节名和冒号之后的 .data : ALIGN(8) { ... } 是输出节的属性,要求这个节的起点按 8 对齐。没写这个属性时,输出节的对齐取它所有输入节里最大的那个对齐。两者在 VMA 上的效果经常相同,在 LMA 上却不一定。
/DISCARD/
第 5 章用过 /DISCARD/ 丢掉 .comment。内核用它丢掉整类节,比如模块的退出函数:一个模块直接编进内核时永远不会被卸载,它的退出函数也就永远不会执行,vmlinux.lds.h 的 EXIT_TEXT 收集 .exit.text 和 .text.exit.*。丢不丢它们取决于架构:没有定义 RUNTIME_DISCARD_EXIT 时,EXIT_DISCARDS 展开成 EXIT_TEXT 和 EXIT_DATA,放进 /DISCARD/;定义了它,EXIT_DISCARDS 就是空的(第 1041 到 1047 行)。x86 的 vmlinux.lds.S 第 20 行就定义了 RUNTIME_DISCARD_EXIT。丢掉的节如果还被引用,两个链接器都会报错。把一个函数放进 .init.text,在 .text 里调用它,再在脚本里丢掉 .init.text:
$ ld.lld -T disc.ld -o d disc.old.lld: error: relocation refers to a symbol in a discarded section: setup>>> defined in disc.o>>> referenced by disc.c>>> disc.o:(_entry)$ riscv64-unknown-elf-ld -m elf64lriscv -T disc.ld -o d disc.o`setup' referenced in section `.text' of disc.o: defined in discarded section `.init.text' of disc.o第 5 章讲过,GC 沿着重定位标记存活的节,被删的可加载节不可能还被存活的代码引用,只有调试信息这类不加载的节会指向它们,链接器给那些引用填墓碑值。/DISCARD/ 不看引用关系,是写脚本的人明确说"不要",存活的代码还引用它,就只能报错。
INSERT
想在普通程序里加一个自定义输出节、又不想用整份脚本替换默认布局,可以在 SECTIONS 块后面写 INSERT AFTER .text;,GNU ld 手册说它 "inserts all prior linker script statements after (or before) output_section, and also causes '-T' to not override the default linker script"(Miscellaneous Commands)。用一个只含 .mytable 的脚本实测,两个链接器都把它放在 .text 之后,其余部分沿用各自的默认布局。
GNU ld 和 lld 的差别
lld 的文档说它实现的是 GNU ld 链接器脚本的"a large subset",手册没写清的地方尽量跟随 GNU ld 的实现,有意的偏离会记录下来(lld linker script 说明)。本章遇到的差别都是这一类边缘行为,汇总如下(GNU ld 2.42,ld.lld 21.1.8):
| 情形 | GNU ld | ld.lld |
|---|---|---|
脚本里写了文件名 kernel/entry.o(...) | -T 在前时该文件最先被加载,通配符按加载顺序收集 | 不影响输入顺序 |
只含符号赋值的空输出节 .empty : { marker = .; } | 删掉这个节 | 保留,大小为 0 |
只写 > RAM、不写 AT> 的 .bss 的 LMA | 沿用上一个节的 LMA 区域 | 等于 VMA |
脚本没写 ENTRY、也没有 _start | 退到 start 等目标平台约定的符号(第 5 章) | 入口留 0 并警告 |
从 -b binary 或 objcopy 得到的目标文件 | 可以和 lp64d 文件链接 | 浮点 ABI 不符,拒绝 |
.empty 那一行用的是前面 initcall 例子里的脚本,lld 文档对它的说明是 GNU ld "will eliminate it if it only contains symbol assignments",lld "will retain such sections unless all the symbol assignments are unreferenced PROVIDED";两边的 marker 都是 0x80000050。
将机器约定落实到链接器
支持本章这类程序,首先需要能够处理 RISC-V 重定位的后端。第 4 章 "RISC-V:会改变代码长度的 relaxation" 一节已经讲过 HI20/LO12_I、成对的 PCREL_HI20/PCREL_LO12_I(低半部分指向 auipc 处的标号)、CALL_PLT,以及 RELAX 和 ALIGN 两种标记;完整处理本章输入还需覆盖几种那一节没展开的重定位:R_RISCV_LO12_S(store 指令的低 12 位,立即数在指令里分成两段)、R_RISCV_BRANCH(条件分支的 ±4 KiB 偏移)、R_RISCV_JAL(jal 的 ±1 MiB 偏移),以及压缩指令用的 R_RISCV_RVC_BRANCH、R_RISCV_RVC_JUMP。起步时关掉松弛:用本章一直带着的 -mno-relax 编译,目标文件里就没有 R_RISCV_RELAX(main.o 的重定位表里一条也没有),链接器只用填数、不用删字节;下一步再按第 4 章的方法做松弛。
然后是链接器脚本的一个子集:ENTRY、SECTIONS、.、ALIGN、PROVIDE、ASSERT。xv6 的 user.ld 只用到其中的 SECTIONS、.、ALIGN、PROVIDE,kernel.ld 六种全用到了。user.ld 没有 ENTRY,而 kexec 要用 e_entry 设置用户程序的 epc,因此若要兼容这里的 GNU ld 默认行为,需要采用第 5 章讨论的目标相关入口回退规则:命令行没有 -e、脚本没有 ENTRY 时,取目标平台约定的符号,RISC-V 上是 start。GNU ld 链接的 _cat,e_entry 就是 start 的地址 0xf6。本章遇到的其他边缘行为,比如脚本里写了文件名时输入顺序怎么定、空输出节留不留,需要明确实现选择并写入测试。可以先用实现出的链接器按 user.ld 链接 xv6 的 _cat,用 xv6 自带的 mkfs 放进 fs.img,在 QEMU 里的 xv6 shell 中运行 cat README;进阶目标是按 kernel.ld 链接整个内核,让它启动到 shell。
链接内核时还有一样东西本章一直没碰。xv6 的 Makefile 每次链接完内核都运行 objdump -S,把反汇编和 C 源码对照着写进 kernel.asm,调试时靠它查"某个地址对应哪一行"。这需要调试信息:内核用 -ggdb -gdwarf-2 编译,GNU 工具链构建的 kernel/kernel 文件有 276944 字节,其中 9 个 .debug_* 节合计 231322 字节,装进内存的 PT_LOAD 只有 0x7860 字节。这些调试节不进入可加载段,可它们引用代码地址的方式和代码一样要靠重定位:start.o 的 .rela.text 只有 6 条,.rela.debug_* 一共有 424 条。链接器如果把它们丢掉或算错,内核照样能启动,gdb 和 objdump -S 却会把地址对到错误的行上。调试信息由哪些节组成,链接器要对它们做什么,GC 删掉函数以后描述它的那条调试记录怎么办,调试信息太大时怎样压缩、拆出去,是第 11 章的内容。
练习
本章练习按前述命令在 Linux 上运行,即可编译裸机程序、构建 xv6、在 QEMU 中启动系统,并执行链接脚本求值器。脚本每次创建独立目录,检查 VMA/LMA、原始镜像尺寸、嵌入数据、initcall 顺序、断言故障和 xv6 的启动输出。这些检查分别验证脚本规定的布局、启动代码对布局的使用,以及预期的拒绝条件。
练习一,观察。下面是正文里 GNU 工具链构建的 xv6 内核的几个符号,以及 kernel/memlayout.h 和 kernel/param.h 里的常量:
0000000080000000 T _entry0000000080006000 T _trampoline0000000080007000 T etext0000000080007890 B stack00000000080020bb0 B end#define KERNBASE 0x80000000L#define PHYSTOP (KERNBASE + 128 * 1024 * 1024)#define NCPU 8不运行内核,回答:kvmmake 里用 etext 划分的那两条 kvmmap(UART、VIRTIO0、PLIC、trampoline 等其他映射不算),各把哪段物理地址映射成什么权限?kinit 之后空闲页链表里有多少页?-smp 3 启动时,hart 2 第一次进入 start 时 sp 是多少?
练习二,预测。把 xv6 内核的 27 个目标文件按 Makefile 的顺序排好,只把 kernel/entry.o 挪到最后,分别做下面四次链接。每次 _entry 的地址是多少?哪几次 0x80000000 处放的是 _entry?
- GNU ld,
-T kernel/kernel.ld写在所有目标文件之前; - GNU ld,
-T kernel/kernel.ld写在所有目标文件之后; - ld.lld,
-T kernel/kernel.ld写在前面; - ld.lld,脚本里的
kernel/entry.o(_entry)改成kernel/entry.o(.text)。
练习三,手算。一个单片机程序的脚本如下,Flash 在 0x08000000,RAM 在 0x20000000:
MEMORY{ FLASH (rx) : ORIGIN = 0x08000000, LENGTH = 256K RAM (rwx) : ORIGIN = 0x20000000, LENGTH = 64K}SECTIONS{ .vectors : { KEEP(*(.vectors)) } > FLASH .text : { *(.text .text.*) . = ALIGN(4); _etext = .; } > FLASH .rodata : { *(.rodata .rodata.*) } > FLASH .data : { _sdata = .; *(.data .data.*) . = ALIGN(4); _edata = .; } > RAM AT> FLASH _sidata = LOADADDR(.data); .bss (NOLOAD) : { _sbss = .; *(.bss .bss.*) . = ALIGN(4); _ebss = .; } > RAM _estack = ORIGIN(RAM) + LENGTH(RAM);}只有一个输入文件,各输入节的大小和对齐是:.vectors 0x40 字节、4 字节对齐;.text 0x1a2 字节、2 字节对齐;.rodata 0x31 字节、8 字节对齐;.data 0x26 字节、8 字节对齐;.bss 0x103 字节、16 字节对齐。按 lld 文档的规则(AT> 时 LMA 取区域里的下一个空闲地址,再按节的对齐取整)算出:_etext、.rodata 的 VMA、.data 的 VMA 和 LMA、_sidata、_sdata、_edata、_sbss、_ebss、_estack;启动代码要拷多少字节;objcopy -O binary 输出的文件有多大。再想一想,换成 GNU ld,哪个数可能不同。
练习四,改坏。每种先写下预测,再动手验证。
- 在
kernel/trampoline.S末尾追加两行.section trampsec和.space 4096,重新链接内核。GNU ld 和 ld.lld 各报什么?如果整个删掉trampoline.o呢? - 把正文的
rom.ld里.data后面的AT> ROM删掉,重新链接。_sidata变成多少?用-kernel rom_noat.elf和-kernel它的objcopy -O binary产物运行,各打印几行?那个二进制文件有多大?如果这是一块真的单片机,这样的固件烧进 64 KiB 的 ROM 会怎样?
独立脚本求值器只用于验证本章的地址求值。
答案
练习一
kvmmake 把 [0x80000000, 0x80007000) 映射成 R|X,即 KERNBASE 到 etext,7 页;把 [0x80007000, 0x88000000) 映射成 R|W,即 etext 到 PHYSTOP。
freerange 从 PGROUNDUP(end) = 0x80021000 开始,到 0x88000000 为止,页数是 (0x88000000 − 0x80021000) / 0x1000 = 0x7fdf = 32735。
hart 2 的 sp = stack0 + (2 + 1) × 4096 = 0x80007890 + 0x3000 = 0x8000a890。
验证页数时,在内核的一份副本里给 kinit 加了一行,数空闲链表的长度后打印(改动后 .bss 稍有变化,end 变成 0x80020bd0,取整后仍是同一页):
kinit: end=0x0000000080020bd0 first=0x0000000080021000 pages=32735验证 sp 时,用 -d cpu,nochain 让 QEMU 在每个翻译块开头打印寄存器,挑出 pc 为 0x80000058(start 的地址)的记录:
pc=0000000080000058 hart=0000000000000000 sp=0000000080008890pc=0000000080000058 hart=0000000000000001 sp=0000000080009890pc=0000000080000058 hart=0000000000000002 sp=000000008000a890练习二
- 0x80000000。
-T在前,脚本语句排在命令行文件之前,open_input_bfds处理到kernel/entry.o(_entry)时调用lookup_name加载entry.o,它最先进入file_chain,给通配符分配输入节的那一步按这个顺序收集.text(ldlang.c)。 - 0x80005b42。脚本在最后才解析,
entry.o已经按命令行排在最后。0x80000000 处是timerinit。 - 0x80005b42。lld 按命令行顺序,脚本里的文件名不影响顺序,
(_entry)又匹配不到任何节。 - 0x80000000。
kernel/entry.o(.text)匹配到了entry.o的.text,放在*(.text .text.*)之前。
只有第 1、4 次 _entry 在 0x80000000。实测:
$ riscv64-unknown-elf-ld ... -T kernel/kernel.ld -o k2 $R # $R:entry.o 在最后0000000080000000 T _entry$ riscv64-unknown-elf-ld ... -o k3 $R -T kernel/kernel.ld0000000080005b42 T _entry$ ld.lld -z max-page-size=4096 -T kernel/kernel.ld -o k5 $R0000000080000000 T timerinit0000000080005b42 T _entry$ ld.lld -z max-page-size=4096 -T fixed.ld -o k6 $R0000000080000000 T _entry000000008000001c T timerinit练习三
变量清单:FLASH 起点 0x08000000,RAM 起点 0x20000000、长度 0x10000;五个输入节的大小和对齐如题。
.vectors:VMA 0x08000000,结束于 0x08000040。.text:最大对齐 2,起点 0x08000040;放入 0x1a2 字节到 0x080001e2;ALIGN(4)推到 0x080001e4,_etext= 0x080001e4,节大小 0x1a4。.rodata:对齐 8,起点 0x080001e8,结束于 0x08000219。.data:VMA 在 RAM 的开头 0x20000000,_sdata= 0x20000000;放入 0x26 字节到 0x20000026,ALIGN(4)到 0x20000028,_edata= 0x20000028,节大小 0x28。LMA 取 FLASH 的下一个空闲地址 0x08000219,按 8 取整为 0x08000220,_sidata= 0x08000220。.bss:RAM 当前位置 0x20000028,按 16 取整,_sbss= 0x20000030;放入 0x103 字节到 0x20000133,ALIGN(4)到 0x20000134,_ebss= 0x20000134。_estack= 0x20000000 + 0x10000 = 0x20010000。
启动代码拷贝 _edata − _sdata = 0x28 = 40 字节。objcopy -O binary 从最低的 LMA 0x08000000 铺到 .data 的 LMA 末尾 0x08000220 + 0x28 = 0x08000248,.bss 是 NOLOAD,不算在内,文件是 0x248 = 584 字节。
用 .space 和 .balign 写一个汇编文件造出这五个输入节,实测 lld:
$ ld.lld -T fw.ld -o fw_lld.elf sizes.o$ llvm-objdump -h fw_lld.elf 1 .vectors 00000040 0000000008000000 0000000008000000 DATA 2 .text 000001a4 0000000008000040 0000000008000040 TEXT 3 .rodata 00000031 00000000080001e8 00000000080001e8 DATA 4 .data 00000028 0000000020000000 0000000008000220 DATA 5 .bss 00000104 0000000020000030 0000000020000030 BSS$ llvm-nm -n fw_lld.elf00000000080001e4 T _etext0000000008000220 A _sidata0000000020000000 D _sdata0000000020000028 D _edata0000000020000030 B _sbss0000000020000134 B _ebss0000000020010000 A _estack$ llvm-objcopy -O binary fw_lld.elf fw_lld.bin && wc -c < fw_lld.bin 584本机 RISC-V GNU ld 2.45.50.20251209 的结果在 LMA 上不同:
3 .data 00000028 0000000020000000 0000000008000219 00002000 2**3 4 .bss 00000104 0000000020000030 0000000008000241 00002030 2**40000000008000219 A _sidata$ riscv64-unknown-elf-objcopy -O binary fw_bfd.elf fw_bfd.bin && wc -c < fw_bfd.bin577.data 的 LMA 是 0x08000219,没有按 8 取整,objcopy 的产物因此是 577 字节;.bss 的 LMA 沿用了 FLASH 区域。这里手册和实现不一致,而实现是有意的。binutils 2.42 自己的 ld.texi 就写着 AT> 时 LMA 是 "the next free address in the region, aligned to the section's alignment requirements",可 ld/ldlang.c 第 6038 到 6050 行在算 LMA 时有一段注释(源码):
/* When LMA_REGION is the same as REGION, align the LMA as we did for the VMA, possibly including alignment from the bfd section. If a different region, then only align according to the value in the output statement. */.data 的 VMA 在 RAM、LMA 在 FLASH,是两个不同的区域,于是 LMA 只按输出节语句里写的对齐取整,输入节的 8 字节对齐不算。把 .data : { 改成 .data : ALIGN(8) {,即在语句里显式写出对齐(正文 rom.ld 就是这样写的),GNU ld 给出的 LMA 才变成 0x08000220。同一段代码里还有另一条路:输出节属性 ALIGN_WITH_INPUT(第 7632 行解析),手册说它让 "the difference between the VMA and LMA remains intact throughout this output section",LMA 跟着 VMA 的对齐调整一起移动;这个例子里 VMA 本来就在 RAM 的开头,不需要调整,实测 LMA 仍是 0x08000219。LMA 不对齐,启动代码要是按 8 字节一次地拷(像正文的 entry_rom.S),在不支持非对齐访问的芯片上就会出错。
练习四
-
两个链接器都在链接时停下,GNU ld 报
riscv64-unknown-elf-ld: error: trampoline larger than one page,lld 报ld.lld: error: error: trampoline larger than one page。lld 自己在前面加了error:,消息本身又以error:开头,所以出现了两遍。删掉trampoline.o时,trampsec没有内容,两次ALIGN(0x1000)之间是 0 字节,. - _trampoline等于 0。GNU ld 先报这条ASSERT,接着报vm.c、proc.c、trap.c对trampoline、userret、uservec的未定义引用;lld 先检查未定义符号,只报undefined symbol: userret、trampoline、uservec三条就停下了,走不到ASSERT。这条断言写的是"恰好一页"而不是"不超过一页",在 GNU ld 上两种错误它都能挡住。 -
.data的 LMA 等于 VMA,_sidata变成 0x80100000,和_sdata相同,拷贝循环原地自己拷给自己:
$ llvm-nm rom_noat.elf | grep -E "_sidata|_sdata"0000000080100000 D _sdata0000000080100000 A _sidata$ llvm-objcopy -O binary rom_noat.elf noat.bin && wc -c < noat.bin 1048592两种方式在 QEMU 里都正常打印四行。ELF 由 QEMU 按 p_paddr 直接把 .data 的初值放进了"RAM";原始二进制被整个拷到 0x80000000,文件里第 0x100000 字节起正好是 .data,也落进了"RAM"。QEMU 替程序干了装入的活,问题被掩盖了。二进制文件从 0x80000000 铺到 0x80100010,中间全是零,有 1048592 字节,比 64 KiB 的 ROM 大得多,烧不进去;脚本里 ROM 的 LENGTH 只约束放进这个区域的节,.data 已经不在 ROM 里,链接器不会报错。就算 ROM 足够大,烧到 ROM 里的字节也不会出现在 RAM 的地址上,上电后 .data 是 RAM 里的随机内容。
参考
附录:术语与工具
-
PIE — PIE(position-independent executable)是可以在不同加载基址运行的可执行文件。生成 PIE 需要编译与链接选项配合;static-PIE 还需要自身的启动路径完成必要重定位。 官方文档。 ↩
-
RISC-V — RISC-V 是开放的指令集架构。本系列主线是在原生 x86-64 Linux 上构建链接器;RV64 用于架构对照与内核案例。相关例子的编码、寄存器约定和重定位规则见 RISC-V psABI,不能直接套用 x86-64 的规则。 ↩
-
QEMU — QEMU 可模拟处理器和系统。用户态模式运行另一架构的用户程序,系统模式则连同机器设备一起模拟;本系列 xv6 实验使用后者启动完整内核。 官方文档。 ↩
-
GNU — GNU 是 “GNU’s Not Unix” 的递归缩写,指自由软件操作系统项目。GCC、binutils 和 glibc 都属于 GNU 项目,但分别承担编译、二进制处理和 C 运行库职责。 官方文档。 ↩
-
binutils — GNU binutils 是一组处理目标文件的工具,包含汇编器
as、链接器ld,以及readelf、nm、objdump、ar等检查与归档工具。 官方文档。 ↩ -
GCC — GCC(GNU Compiler Collection)是一组语言编译器。命令
gcc是驱动入口,会组织编译、汇编和链接;在终端调用它,并不意味着后续工作都在同一个进程里完成。 官方文档。 ↩ -
ELF — ELF(Executable and Linkable Format)规定目标文件、可执行文件与共享对象的结构。通用规则见 gABI,架构相关的调用约定和重定位规则见对应 psABI。 官方文档。 ↩
-
ld —
ld是常见的链接器命令名;本系列写 GNU ld 时特指 GNU binutils 的链接器。它读取目标文件、库与链接选项,完成符号解析、布局和重定位。 官方文档。 ↩ -
xv6 — xv6 是 MIT 用于操作系统教学的小型 Unix 风格内核。本系列采用 RISC-V 版本,借助较小的加载器与链接脚本观察 ELF 到进程的交接。 官方文档。 ↩
-
objdump —
objdump可反汇编机器码,也能显示节和重定位信息。GNU 与 LLVM 版本的排版、指令写法和默认选项并不完全相同,本文命令保留具体工具名。 官方文档。 ↩ -
musl — musl 是 Linux 的一种 C 标准库实现,提供
printf等库函数及运行时支持。本系列在需要分析或链接较小的静态运行库时使用它;普通 Linux 服务器不一定预装 musl。 官方文档。 ↩ -
nm —
nm列出目标文件的符号。字母标记概括符号所在节或绑定等属性;需要判断准确语义时,应继续对照 ELF 符号表字段。 官方文档。 ↩ -
ABI — ABI(Application Binary Interface)规定二进制组件如何协作,包括调用约定、数据布局和文件格式等。它约束编译结果之间的交接,比源码层面的 API 更靠近机器。 官方文档。 ↩
-
TLS — TLS(Thread-Local Storage)让不同线程拥有同一变量的独立实例。链接器描述初始化模板并处理寻址模型,运行时负责为线程建立实例。这里不是网络协议 Transport Layer Security。 官方文档。 ↩
-
GC — 本文 GC 指 section garbage collection,即链接器从入口和其他根出发保留可达节、删除无用节。它发生在构建阶段,与运行时堆内存的垃圾回收不同。 官方文档。 ↩