

[链接器的世界-原理篇03] 符号解析:同一个名字,究竟指向谁
上一章停在两个目标文件上:main.o 的符号表里有一个所属节为 *UND* 的 add,add.o 里有一个定义在 .text 偏移 0 处的 add,两个文件之间唯一的联系就是这个名字。只有一个候选的时候,配对显然成立。可一个名字可能有两个定义,定义可能藏在静态库的几百个成员里,也可能根本不存在。链接器在这些情况下各按什么规则办事,决定了程序能不能链出来、链出来的又是哪一份代码。
本章在 x86-64 Linux 上使用 Clang1 21.1.8、GNU2 ld 2.46 与 LLD3 21.1.8。nm4、readelf5、ar6 是本机 GNU binutils7,llvm-objdump 明确选用 LLVM8 的反汇编格式。只观察符号解析的链接使用 -e main、不带 C 库;需要执行的程序则由本机 musl-gcc9 静态链接并直接运行。
这里把 main 指定为入口,只是为了检查链接产物。它没有 C 启动代码准备调用环境,也不能像普通函数那样返回,因此不直接执行这类文件;运行实验会另行补齐启动代码和运行库。
一张全局符号表
第 2 章讲过符号的绑定。LOCAL 符号(C 里的 static 函数和变量、节符号、文件符号)只在自己的文件里有意义,链接器不拿它们和别的文件配对。参与配对的只有 GLOBAL 和 WEAK 两种。两个 .c 文件各有一个 static int helper(void),链接时互不干扰,各自文件里的调用在汇编阶段甚至可能已经算好了目标,根本不经过链接器的符号表。C 程序员把只在本文件用的函数写成 static,除了表达意图,也是在减少全局符号表里可能撞车的名字。
链接器为这些符号维护一张全局符号表,通常就是一张哈希表,键是名字,值是"目前找到的定义",或者"有人引用、还没找到定义"。它按命令行顺序读入每个目标文件,对文件里的每个全局符号做一次查表:
- 这个文件定义了它,表里还没有定义,就把这个定义记下来;
- 这个文件只是引用它(所属节为
*UND*),表里也没有定义,就记一笔"还缺"; - 所有输入读完之后,表里仍然只有引用、没有定义,其中至少有一处是普通的强引用(弱引用下一节讲),就是链接错误。通常还要有重定位用到它的名字,两个链接器在边界上的划法稍有不同,见下文。
把第 2 章的输入缩小到一次外部调用。以下是本章这组实验的完整源码:
// main.cint add(int a, int b);int main(void) { return add(1, 2); }// add.cint add(int a, int b) { return a + b; }clang -O1 -c main.c add.cld -e main main.o -o missing-add-O1 下对 add 的调用变成了一条尾跳转 jmp,要填的 4 个字节在 .text 偏移 0xb。main.o 和 add.o 的配对就是这样完成的:读 main.o 时记下"缺 add",读 add.o 时补上定义。把 add.o 去掉,GNU ld 报的是:
ld: main.o: in function `main':main.c:(.text+0xb): undefined reference to `add'报错里的 main.c:(.text+0xb) 不是源码行号,是重定位表(第 2 章讲过)里的一条记录:.text 偏移 0xb 处有 4 个字节要填到 add 的跳转位移,main.c 这个名字取自目标文件里的文件符号。链接器发现缺定义,是因为有重定位要用它。
这张表能工作,前提是每个名字最多只有一个定义。这个前提在真实程序里很容易被打破。
同名定义:强与弱
两个文件各写一句 int counter = 1; 和 int counter = 2;,再一起链接:
$ ld -e main a.o b.old: b.o:(.data+0x0): multiple definition of `counter'; a.o:(.data+0x0): first defined here
$ ld.lld -e main a.o b.old.lld: error: duplicate symbol: counter>>> defined at a.c>>> a.o:(counter)>>> defined at b.c>>> b.o:(.data+0x0)链接器拒绝替你挑一个,因为它没有任何依据判断哪个才是你想要的。ELF10 的通用规范 gABI11(第 2 章讲过,它和各架构的 psABI12 一起规定 ELF 的细节)在符号表一章里写明了这条规则:链接器合并多个可重定位文件时,不允许出现多个同名的 STB_GLOBAL 定义(gABI: Symbol Table)。
同一段规范紧接着给了一个出口:如果已经有一个全局定义,再出现同名的弱符号(STB_WEAK)不算错,链接器采用全局的那个,忽略弱的。人们因此把全局定义叫强定义,把弱符号的定义叫弱定义。在 C 里用 __attribute__((weak)) 写出弱定义,nm 用字母 V(弱的数据对象)或 W(弱的函数)标出它,强定义的数据是 D、函数是 T:
$ nm w.o a.o
w.o:0000000000000000 V counter
a.o:0000000000000000 D counter0000000000000000 T mainw.o 里是 __attribute__((weak)) int counter = 3;。把它放在 a.o 前面链接,结果用的是 a.o 的强定义:
$ ld -e main w.o a.o -o s2$ nm s2 | grep counter0000000000403004 D counter$ llvm-objdump -s -j .data s2 | tail -1 403000 03000000 01000000 .........data 里的两个字其实都还在:0x403000 处是弱定义的 3,0x403004 处是强定义的 1,counter 指向后者。符号被忽略了,它所在的节没有被删掉。链接器按节组织和搬运内容(第 2 章),一个节里可能还有别的东西,解析规则只决定名字指向谁。
两个弱定义之间,gABI 没有规定选谁。GNU ld 和 lld 的实际做法都是保留先读到的那个。准备两个弱定义 w.o(值 3)和 w2.o(值 4),再加一个只引用 counter 的 m.o:
$ ld -e main m.o w.o w2.o -o s3 && llvm-objdump -s -j .data s3 | tail -1 403000 03000000 04000000 ........$ ld -e main m.o w2.o w.o -o s4 && llvm-objdump -s -j .data s4 | tail -1 403000 04000000 03000000 ........两次 counter 都在 0x403000,也就是排在前面那个文件的值:换一下命令行顺序,程序读到的值就变了。
弱定义的典型用法是"库里提供一个默认实现,用户想换就自己写一个强定义"。还有一种用法反过来,只写弱引用、不写定义:
extern void hook(void) __attribute__((weak));int main(void) { if (hook) hook(); return 0; }nm 把这个符号标成小写的 w,表示一个未定义的弱符号。所有输入都读完了还没人定义它,链接器也不报错,按 gABI 的规定把它的值当作 0:
$ ld -e main u.o -o s6$ llvm-objdump -d --no-show-raw-insn s60000000000401000 <main>: 401000: cmpq $0x0, 0x2fd8(%rip) # 0x403fe0 401008: je 0x401014 <main+0x14> 40100a: pushq %rax 40100b: callq 0x0 ...$ llvm-objdump -s -j .got s6 403fe0 00000000 00000000 ........clang 对这个目标默认生成能装到任意地址的 PIE13 代码(第 1 章讲过 PIC14,PIE 是用于可执行文件的同一种做法,第 5 章细讲),这种代码不把绝对地址直接写进指令。编译器又不知道 hook 最后是不是 0,而 0 这个绝对地址没法写成"离当前指令多远"的 PC 相对距离,所以它通过 GOT15(第 1 章提过的那张存放地址的表,第 7 章细讲)取 hook 的地址。链接器建了一个 GOT 项,填上 0;if (hook) 比较的就是这个 GOT 项。callq 0x0 是一条真的跳向地址 0 的调用,因为有前面的判断挡着,它永远不会执行。加上 -fno-pic 编译,指令里直接是 $0x0 和一条 R_X86_64_32 hook 重定位,不再经过 GOT。
"弱"是整个名字的属性,不按文件分开算。下面两个文件是手写汇编:wk.s 用 .weak hook 声明弱引用,经 GOT 取它的地址;sk.s 只有一句 .globl hook。wk.o 弱引用 hook 并有一条重定位用到它,sk.o 没有重定位。只要有一个文件是普通引用,合并后的 hook 就是强的未定义符号,而重定位来自哪个文件无所谓:
$ ld -e main wk.o sk.old: wk.o: in function `main':(.text+0x3): undefined reference to `hook'$ ld.lld -e main wk.o sk.old.lld: error: undefined symbol: hook>>> referenced by wk.o:(.text+0x3)上面的规则都发生在链接期。到了运行时,glibc16 的动态链接器在多个共享库之间找定义时并不区分强弱,找到的第一个就用。ld.so(8) 手册在 LD_DYNAMIC_WEAK 一项里说明,2.2 之前的 glibc 曾经会跳过弱定义继续找强的,后来改成了现在的行为,旧行为只能用这个环境变量找回来(ld.so(8))。"弱让强"因此只在一次链接之内成立,跨共享库不要依赖它。
强与弱都是程序员明写出来的选择。C 语言里还有一种情况,两个文件都没写 weak,同名定义也不报错。
没有初值的全局变量:common
在两个 .c 文件里各写一句不带初值的 int x;,打开 -fcommon 编译,再链接到一起,链接器不报错,两个文件用的是同一个 x。这个行为来自很早的 Unix C 编译器。FORTRAN 有 COMMON 块,好几个程序单元声明同一个块就共享同一块存储,当时的链接器原本就支持"同名的块合并成一个、取最大的尺寸"(MaskRay: All about COMMON symbols);C 编译器借用了这个机制,把没有初值的全局变量当成这样的块交给链接器,于是程序员可以在每个用到它的文件里都写一遍 int x;。
这种符号在 ELF 里叫 common 符号,所属节是一个特殊的节号 SHN_COMMON,readelf 显示为 COM,nm 显示为 C。它还没有被分配到任何节里,所以 st_value 存的不是地址,是对齐要求:
$ nm c1.o c2.o
c1.o:0000000000000000 T main0000000000000004 C x
c2.o:0000000000000004 C x
$ readelf -sW c3.o # c3.c 里写的是 long x; Num: Value Size Type Bind Vis Ndx Name 2: 0000000000000008 8 OBJECT GLOBAL DEFAULT COM xgABI 规定 common 符号的 st_value 存对齐要求,readelf 的 Value 一列显示的正是它。nm 第一列看起来也像,其实是另一回事:GNU binutils 读入 common 符号时把尺寸放在了值的位置,所以 nm 显示的是尺寸。上面两个例子里尺寸和对齐恰好相等,换一个 char buf[100]; 就看得出差别:
$ nm cb.o0000000000000064 C buf$ readelf -sW cb.o | grep buf 2: 0000000000000010 100 OBJECT GLOBAL DEFAULT COM bufnm 显示 0x64,也就是 100 字节;readelf 的 Value 是对齐 0x10,Size 才是 100。链接时,链接器把同名的 common 符号合成一个,取最大的尺寸和最严的对齐,在 .bss(第 2 章讲过,存放初值为零的变量、在文件里不占空间的节)里给它留出位置:
$ ld -e main c1.o c2.o -o a && nm -S a | grep ' x$'0000000000403000 0000000000000004 B x$ ld -e main c1.o c3.o -o b && nm -S b | grep ' x$'0000000000403000 0000000000000008 B x第二次链接里,一个文件以为 x 是 4 字节的 int,另一个以为是 8 字节的 long,链接器默默按 8 字节分配。只有加上 --warn-common,GNU ld 才会说一句:
ld: c3.o: warning: common of `x' overriding smaller common from c1.o如果某个文件给了初值(int x = 5;),这个带初值的定义就是普通的强定义,common 符号让位给它,x 落在 .data 里,nm 显示为 D。
C 标准从来没有认可过跨文件的这种合并。标准里的"暂定定义"(tentative definition,指没有初值、不带存储类说明符或只带 static 的文件作用域变量声明)只在一个翻译单元(第 0 章讲过)内生效。每个翻译单元结束时,暂定定义就变成一个正式的定义;而标准要求整个程序里一个外部名字最多只有一个外部定义(C11 §6.9p5),两个翻译单元各有一个 int x; 就违反了这一条,是UB17。合并只是附录里列出的一种常见扩展(§6.9.2 与附录 J.5.11,见 N1570)。GCC18 10 和 Clang 11 先后把默认值改成了 -fno-common(GCC 10 移植说明、Clang 11 发布说明)。这时 int x; 直接放进 .bss,成为一个强定义:
$ nm n1.o n2.o # 同样的源码,-fno-common 编译
n1.o:0000000000000000 T main0000000000000000 B x
n2.o:0000000000000000 B x
$ ld -e main n1.o n2.old: n2.o:(.bss+0x0): multiple definition of `x'; n1.o:(.bss+0x0): first defined here本机的 clang 21 和 GCC 15 不加任何选项编译 int x;,nm 显示的都是 B。GCC 10 发布时,不少老项目就是在这里第一次见到 multiple definition。正确的写法一直是在头文件里写 extern int x;,只在一个 .c 文件里写定义。
先预测,再揭晓
强、弱、common 三种规则凑在一起,可以出一组小题。下面每行是两个模块,只写出和名字有关的那几行(模块 A 另有一个读 n 的 main)。请对每一行先写下预测:能不能链接?能的话,n 用的是哪一份?-fcommon 和默认的 -fno-common 下各是什么结果?题型借自 CMU 15-213 链接讲义第 22 页的 Linker Puzzles(15-213: Linking),题目重新出过。
| # | 模块 A | 模块 B |
|---|---|---|
| 1 | int n = 1; void f(void) {} | void f(void) {} |
| 2 | int n; | int n; |
| 3 | int n = 1; | int n; |
| 4 | int n = 1; | __attribute__((weak)) int n = 2; |
| 5 | int n; | __attribute__((weak)) int n = 2; |
用 clang 按两种选项编译,按 A、B 的顺序交给 GNU ld 和 lld,两个链接器的结论完全一致:
| # | -fcommon | -fno-common |
|---|---|---|
| 1 | 重复定义 f | 重复定义 f |
| 2 | 合并成 .bss 里的一个 n | 重复定义 n |
| 3 | 用 A 的 n,在 .data,值 1 | 重复定义 n |
| 4 | 用 A 的 n | 用 A 的 n |
| 5 | 用 A 的 n,在 .bss,值 0 | 用 A 的 n |
函数没有 common 一说,第 1 行在哪种选项下都是强定义撞车。第 2、3 行就是 GCC 10 之后老项目报错的两种样子。最容易猜错的是第 5 行:B 带初值,看上去更"实在",赢的却是没有初值的 A,main 读到 0,B 的那 4 个字节 02 00 00 00 留在 .data 里没人用。gABI 在讲弱符号的同一段里写了这一句:已有 common 符号时,再出现同名弱符号不算错,链接器采用 common 的那个、忽略弱的(gABI: Symbol Table)。
这句话的字面顺序是"已有 common,后来弱的"。反过来,弱定义先到、common 后到,gABI 没有单独写一句。两个链接器的做法是一样的,把第 5 行按 B、A 的顺序链接:
$ ld -e main p5b.o p5a.o -o g5 && nm g5 | grep ' n$'0000000000403004 B n$ ld.lld -e main p5b.o p5a.o -o l5 && nm l5 | grep ' n$'000000000020219c B nn 都在 .bss,main 仍然读到 0:common 取代了表里先到的弱定义。对 common 来说,弱定义在前在后结果一样,和两个弱定义之间"先到先得"不同。
如果你读过 CS
,会对第 5 行的结果更意外。CS 第 7.6.1 节用的是另一套词:函数和带初值的全局变量是"强符号",不带初值的全局变量是"弱符号",规则是多个强符号报错、一强多弱选强、多个弱符号任选一个(CS 第 2 版第 7 章试读)。按这套说法,第 5 行的 A 是弱、B 是强,应该选 B。两套术语说的根本不是同一种东西:CS 的"弱符号"是-fcommon 下的 common 符号,"任选一个"就是 common 合并;15-213 讲义第 20、24 页还把 extern 声明也算作弱符号,在 ELF 里那只是一个所属节为 *UND* 的未定义引用。本章说的弱定义和弱引用,指绑定为 STB_WEAK、要用 __attribute__((weak)) 明写的符号,教材的这一节没有提到它。读 CS 时把它的"弱"换成"common"去读,就不会和 ELF 的规则打架。默认改成 -fno-common 之后,它的第三条规则在默认设置下已经碰不到了,教材勘误也补了这一点(CS 3e Errata)。
上表每一行的两边都是同一种类型。第 0 章开头那个程序把两种类型放在了同一个名字上。
链接器不检查类型
那个程序的 main.c 定义了 int y = 5; int x = 7;,other.c 却声明 extern double x; 并写入 1.0。同一对象的声明类型不兼容,使这个程序具有 UB17;下面分析的是所列构建中的机器码和存储布局,不是 C 语言保证的运行结果。先看两边的符号表:
$ readelf -sW main.o | grep -E ' [xy]$' 6: 0000000000000004 4 OBJECT GLOBAL DEFAULT 2 y 7: 0000000000000000 4 OBJECT GLOBAL DEFAULT 2 x$ readelf -sW other.o | grep ' x$' 5: 0000000000000000 0 NOTYPE GLOBAL DEFAULT UND x引用一方的表项里只有名字:类型 NOTYPE,尺寸 0,所属节 UND。double 这个信息只留在 other.o 的机器码里:
$ llvm-objdump -dr other.o0000000000000000 <set_x>: 0: 48 8b 05 00 00 00 00 movq (%rip), %rax 0000000000000003: R_X86_64_PC32 .LC0-0x4 7: 48 89 05 00 00 00 00 movq %rax, (%rip) 000000000000000a: R_X86_64_PC32 x-0x4 e: c3 retq.LC0 保存 double 常量 1.0,movq 将它的 8 个字节写入 x。这里需要区分两个独立的问题:重定位决定指令访问哪里,指令本身决定访问多少字节。
偏移 0xa 处的 R_X86_64_PC32 写入的是位移 S + A - P,其中 S 是 x 的最终地址,A = -4,P 是该重定位字段的最终地址。字段占 4 字节,CPU 用字段之后的 RIP 加上这个位移,得到 (P + 4) + (S - 4 - P) = S。因此,链接器并不是把 x 的绝对地址直接写进指令。
符号表中的 st_size = 4 描述定义一方的对象大小,未定义引用的尺寸却是 0;这些表项不保存可用于检查两边是否声明了相同 C 类型的信息。普通符号解析与这条重定位计算也不要求从指令反推出 C 类型。链接器在松弛优化等阶段可能检查、改写指令,但这不构成 C 类型检查。
在上面的 .data 布局中,x 从偏移 0 开始,y 从偏移 4 开始。设 x 的最终地址为 X,则 y 位于 X + 4。1.0 的 IEEE 754 binary64 编码为 0x3ff0000000000000,小端序字节依次是 00 00 00 00 00 00 f0 3f。这次 8 字节写入将前四字节写到 x,后四字节写到相邻的 y,因而能解释所列构建中观察到的 x = 0, y = 1072693248。更换对象布局或优化方式,UB 的表现也可能改变。
再出一个。下面的程序会打印什么?
// fmain.c#include <stdio.h>extern int answer; /* 以为是变量 */int main(void) { printf("answer = %#x\n", answer); return 0;}// fanswer.cint answer(void) { return 42; }用 musl-gcc -O1 -Wall -static fmain.c fanswer.c -o fm 构建,没有警告,链接也没有报错;Linux 本机运行打印 answer = 0xfa1e0ff3。answer 在 fanswer.o 里是 FUNC,在 fmain.c 里被当成 int,链接器照样配对。本机 GCC 默认启用 CET,函数开头是字节 f3 0f 1e fa(endbr64),按小端序读成 32 位整数就是 0xfa1e0ff3;再往后才是 b8 2a 00 00 00(mov $42,%eax)。这个误读结果取决于编译器实际生成的指令,并不保证读到常数 42。数组和指针混用是同一类问题:一边定义 char msg[] = "hi";,另一边声明 extern char *msg;,后者把字符串的前 8 个字节当成指针,实测 printf("%p", msg) 打印 0x6968('i' 和 'h' 两个字节),接着 puts(msg) 去这个地址读字符串,段错误。
常规 ELF 符号表没有表达完整 C 类型所需的信息,普通链接也不进行跨文件的 C 类型兼容检查。类型信息仍可能保存在 DWARF19 调试数据或 LTO20 中间表示里;是否利用它诊断错误,是另一层工具机制。
最根本的办法是把 extern 声明写进头文件,并且让定义所在的文件也包含它:x.h 里写 extern int x;,main.c 和 other.c 都 #include "x.h"。other.c 再写 extern double x; 就会和头文件里的声明冲突,编译器在同一个翻译单元里看到两种类型,直接报错;main.c 里的定义 int x = 7; 也由编译器和头文件核对。类型检查本来就是编译器的事,头文件让每个翻译单元看到同一份声明。
第二个办法是链接期优化(LTO,link-time optimization)。打开 -flto 后,GCC 在 .o 里存的是编译器的中间表示,链接时由链接器插件交回编译器统一优化(第 12 章细讲),编译器这时第一次同时看到两个文件的声明。同一个程序加上 -flto:
$ musl-gcc -O2 -flto -static main.lto.o other.lto.o -o prog_ltoother.c:1:15: warning: type of 'x' does not match original declaration [-Wlto-type-mismatch] 1 | extern double x; | ^main.c:4:5: note: type 'int' should match type 'double'GCC 文档说这个警告默认开启,需要 -flto 才生效(GCC: Warning Options 的 -Wno-lto-type-mismatch 一项)。它只是警告,程序照样生成,运行打印 x = 0, y = 5。这并不是错误被修好了:反汇编里那条 8 字节的写入还在,只是优化器认定 y 从没被改过,把它折叠成了常量 5,y 的存储干脆没了。C++ 有对应的 -Wodr,同样默认开启、只在 LTO 下工作。两个翻译单元各定义一个字段不同的 struct S,GCC 15 报的是 type 'struct S' violates the C++ One Definition Rule [-Wodr](One Definition Rule 即单一定义规则,本章讲 COMDAT21 时细说)。
到这里为止,所有定义都在命令行上直接列出的目标文件里。真实的程序还依赖库,库里的定义有成百上千个,链接器不会把它们全部搬进来。
定义藏在库里:静态库
归档是容器,成员才是目标文件
普通 System V/GNU ar 文件以八字节 !<arch>\n 开始,后面重复排列成员头和成员内容。成员头占 60 字节,数值字段以 ASCII 文本编码,里面的 size 给出紧随其后的 payload 长度。若长度是奇数,再补一字节使下一个成员头从偶数偏移开始。GNU ar 生成的填充字节是换行;这一个字节不计入 size,也不属于成员内容。
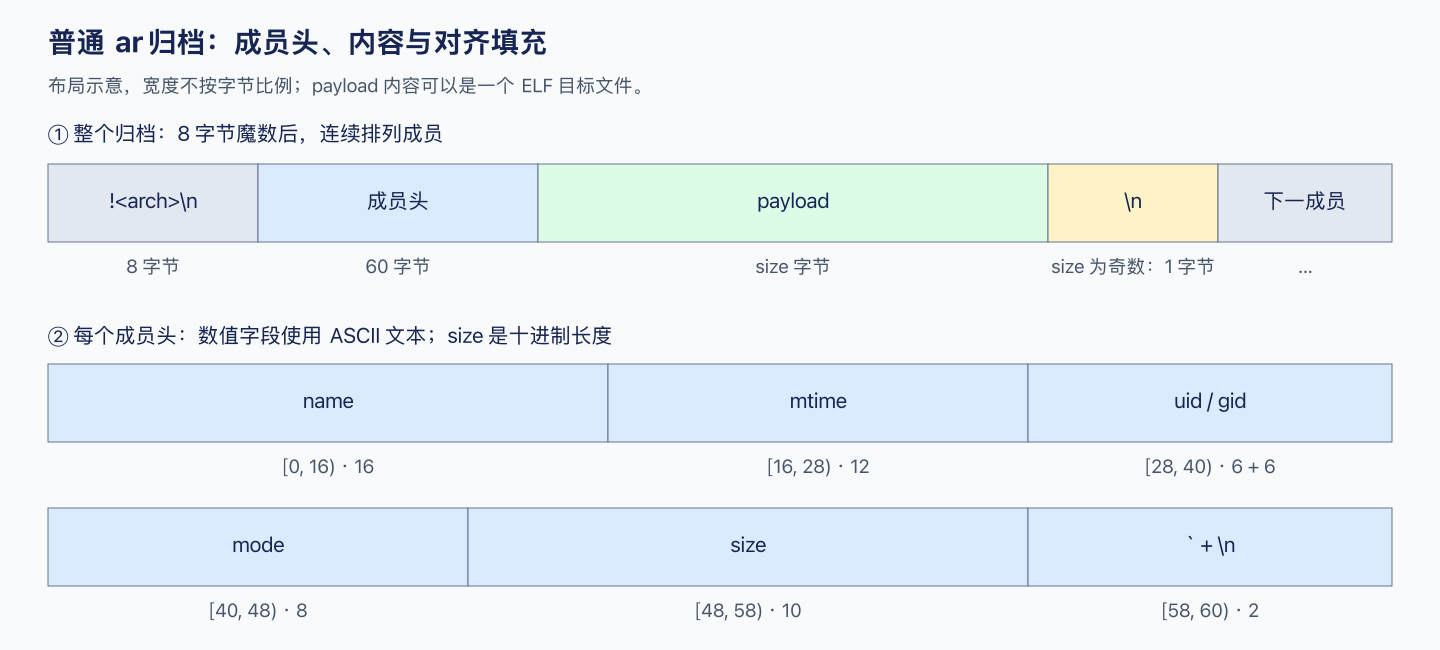
若成员头从文件偏移 h 开始,payload 的范围就是 [h+60, h+60+size),下一成员头位于 h+60+size+(size%2)。解析 ELF 时,传入的是 payload 的切片,不能把归档魔数、成员头或对齐填充一起传入。归档中的符号索引和长名称表是特殊成员,不是普通目标文件。
名称字段宽度有限,名称本身是字节串,不保证 UTF-8。GNU 格式用 // 成员保存长名称,用普通成员头中的 /十进制偏移 引用这张表;偏移相对于长名称表 payload 的开头,条目以 /\n 结束。普通短名称常写成 name.o/ 后加空格填满字段。索引成员 / 则记录符号与成员位置之间的关系。它能加速“去哪个成员找定义”,但不会把 archive 变成一个大 ELF,也不会让所有成员自动进入链接。
例如头部名称是 /17,含义是从长名称表内偏移 17 查名称;它既不是归档文件偏移 17,也不是第 17 个成员。成员可以同名,因此定位某个成员要用它在归档中的位置。普通 archive 包含 payload;thin archive 则可能引用外部文件,是另一种读取约定,不能按这里的内嵌内容公式处理。
抽取根据符号需求,而不是文件名
静态库(第 1 章提过的子程序库在今天的样子)是用 ar 命令把一批目标文件打成的一个归档文件,扩展名通常是 .a。下面建立一条跨库依赖:main 调用 add,add 再调用 scale;另放一个没有使用者的 unused_helper,观察它会不会被抽取。请在一个新的实验目录准备这四个文件,避免与前面的同名文件混用:
// main.cint add(int, int);int main(void) { return add(1, 2); }// add.cint scale(int);int add(int a, int b) { return scale(a + b); }// other.cint unused_helper(void) { return 99; }// scale.cint scale(int x) { return x * 2; }先分别编译,再打包归档。这里使用 Linux x86-64 的本机目标,关闭本例不需要的展开表和位置无关代码,让输出集中呈现符号配对。以下诊断偏移来自 Clang 21.1.8、GNU binutils 2.46 和 LLD 21.1.8;其他版本的指令长度和地址可能不同。
clang -O1 -fno-pic \ -fno-asynchronous-unwind-tables -c main.c add.c other.c scale.car rcs libscale.a scale.o本节直接用 ld -e main 检查链接结果;-e 只是指定 ELF 入口地址,不会补上调用 main 并处理其返回值的启动代码。这些输出只供 nm、readelf 等工具检查,不要把它们当作可直接运行的 C 程序。
$ ar rcs libmath.a add.o other.o$ ar t libmath.aadd.oother.o$ nm -s libmath.a | head -4
Archive index:add in add.ounused_helper in other.oar 的 s 选项会在归档开头写一份符号索引:哪个全局符号由哪个成员定义。GNU ld 靠这份索引工作,不用逐个打开成员;没有索引的归档它直接报错,提示先运行 ranlib 补上。它对静态库的处理和对普通目标文件不一样:普通目标文件无条件全部读入;静态库只拉取那些能补上"还缺"名字的成员,拉进来的成员按普通目标文件处理,它自己的引用又可能产生新的"还缺"。other.o 没人需要,就不会出现在输出里。C 库的静态版本由几千个小成员组成,常见的做法是一个函数一个文件,用到 printf 就只拉进 printf 那几个成员,输出不会被几千个用不到的函数撑大。
传统的 Unix 链接器(GNU ld 也是)在这里有一个关键细节:它从左到右扫描命令行,遇到一个静态库就用当时"还缺"的名字去查索引,反复拉取直到这个库再也补不上什么,然后继续往右走,不再回头。于是库的位置有了意义。把库放在 main.o 前面,扫描到库时还什么都不缺,一个成员都不拉:
$ ld -e main libmath.a libscale.a main.old: main.o: in function `main':main.c:(.text+0xb): undefined reference to `add'两个库的先后也有讲究。main.o libscale.a libmath.a 这个顺序里,扫描 libscale.a 时只缺 add,它补不上;到 libmath.a 拉进 add.o,又缺了 scale,可 libscale.a 已经过去了:
$ ld -e main main.o libscale.a libmath.ald: libmath.a(add.o): in function `add':add.c:(.text+0x3): undefined reference to `scale'规则因此是:使用者写在被使用者前面,main.o libmath.a libscale.a 就能链过。麻烦在于库之间的依赖可能成环。libx.a 里有两个成员,x1.o 的 log_value 调用 liby.a 里的 fmt,而 fmt 又调用 libx.a 另一个成员 x2.o 里的 fmt_impl。先补齐这个例子的全部输入,仍在刚才的实验目录操作:
// cm.cint log_value(int);int main(void) { return log_value(42); }// x1.cint fmt(int);int log_value(int x) { return fmt(x); }// x2.cint fmt_impl(int x) { return x; }// y.cint fmt_impl(int);int fmt(int x) { return fmt_impl(x); }clang -O1 -fno-pic \ -fno-asynchronous-unwind-tables -c cm.c x1.c x2.c y.car rcs libx.a x1.o x2.oar rcs liby.a y.o两个库无论先写哪一个,GNU ld 都会留下未解析引用。先写 libx.a 时缺的是 fmt_impl:
$ ld -e main cm.o libx.a liby.ald: liby.a(y.o): in function `fmt':y.c:(.text+0x1): undefined reference to `fmt_impl'扫描 libx.a 时只缺 log_value,x2.o 没人要;等 fmt 需要 fmt_impl 时,libx.a 已经扫过了。解决办法有两个:把 libx.a 再写一遍(cm.o libx.a liby.a libx.a),或者用 --start-group libx.a liby.a --end-group 把两个库括起来,让链接器在组内反复扫描,直到不再拉进新成员。ld 手册提醒过,这种反复扫描有不小的性能代价,只应在确实存在环的时候用(GNU ld 手册:Options)。
lld 换了一种做法。它读到静态库时,把每个成员定义的全局符号都记成"惰性"定义(它也不依赖归档索引,没有索引的归档照样能链):表里有这个名字,定义在某个成员里,等真有人需要时才去拉。后面再出现的引用也能找到前面库里的惰性定义,这些向前查找失败的例子便不再受库必须排在引用之后的限制。但输入顺序仍可能影响定义的选择,例如多个归档都提供同名符号时,不能据此任意重排。上面三个失败的命令,lld 全都能链过。这和 GNU ld 的语义不同,一个在 lld 下能链过的项目,换到 GNU ld 可能失败。lld 提供 --warn-backrefs,专门找出这种"往回引用"(lld: --warn-backrefs):
$ ld.lld -e main cm.o libx.a liby.a --warn-backrefsld.lld: warning: backward reference detected: fmt_impl in liby.a(y.o) refers to libx.a(x2.o)成员一旦被拉进来,就是整个目标文件进来,它里面的其他函数和变量也一起进来,哪怕没人用。这一点和前面讲过的强弱规则碰在一起,有两种结果初看很奇怪。先为弱引用与弱定义准备输入:u.c 只在 hook 存在时调用它,m.c 则无条件读取 counter。
// u.cextern void hook(void) __attribute__((weak));int main(void) { if (hook) hook(); return 0; }// hook.cvoid hook(void) {}// m.cextern int counter;int main(void) { return counter; }// w.c__attribute__((weak)) int counter = 3;// strong.cint counter = 9;clang -O1 -fno-pic \ -fno-asynchronous-unwind-tables -fno-builtin -c u.c hook.c m.c w.c strong.car rcs libhook.a hook.oar rcs libcnt.a strong.oar rcs libweak.a w.o第一种:弱的未定义引用不会单独触发成员抽取;一个名字已有弱定义时,链接器也不会仅为了寻找更强的定义去抽取成员。这不意味着库里的弱定义永远不会被抽取:它可以满足一个仍未解决的强引用。前面那个 if (hook) hook(); 的程序,把 hook 的强定义放进 libhook.a 一起链接,GNU ld 和 lld 都不拉它。输入 u.o 的 nm 输出里,hook 是表示弱未定义符号的 w;链接后对它的引用取值为 0。最终符号表是否还保留这个名字是另一回事:本例中 LLD 保留 w hook,GNU ld 则不再列出它。同样,w.o 里已有 counter 的弱定义(值 3),libcnt.a 里有一个强定义(值 9),链接 m.o w.o libcnt.a 的结果是:
$ ld -e main m.o w.o libcnt.a -o k1$ llvm-objdump -s -j .data k1 | tail -1 402000 03000000 ....用的是弱定义,强定义所在的成员根本没进来,lld 的结果相同。就强弱规则而言,拉取成员的理由只有一个:有一个非弱的引用还缺定义;一个已经有了定义(哪怕是弱的)的名字不缺什么。common 符号是个例外,而且两个链接器在这里分道扬镳:GNU ld 遇到 common 的 x,会去库里找一个带初值的 x 并拉进那个成员;lld 默认不这样做,要加 --fortran-common 才行。想让库里的强定义生效,就得让某个强引用先把那个成员拉进来,或者干脆把目标文件直接写在命令行上。
第二种:替换库里的函数,替换得了一半就会出错。程序自己定义了一个 malloc,静态库 libmem.a 的成员 mem.o 同时定义了 malloc 和 free。如果程序只用 malloc,表里不缺任何名字,mem.o 不会被拉进来,自己的版本顺利生效。可只要程序还调用了 free,mem.o 就会为了 free 整个进来,它带着的 malloc 和程序的撞在一起:
为这个成员准备以下两个源文件,CALL_FREE 决定程序是否调用 free:
// app.c#include <stddef.h>void *malloc(size_t size) { static unsigned char buf[16]; (void)size; return buf; }void free(void *);int main(void) {#ifdef CALL_FREE free(malloc(1));#else (void)malloc(1);#endif return 0;}// mem.c#include <stddef.h>void *malloc(size_t size) { (void)size; return 0; }void free(void *p) { (void)p; }clang -O1 -fno-pic -fno-asynchronous-unwind-tables -fno-builtin -c mem.cclang -O1 -fno-pic \ -fno-asynchronous-unwind-tables -fno-builtin -c app.c -DCALL_FREE -o app.oclang -O1 -fno-pic \ -fno-asynchronous-unwind-tables -fno-builtin -c app.c -o app-only.oar rcs libmem.a mem.old -e main app-only.o libmem.a -o malloc-only-fno-builtin 保留这里特意自定义的 malloc、free 调用,避免编译器依据标准库函数规则消去它们。app-only.o 链接成功;调用了 free 的 app.o 则触发重复定义:
$ ld -e main app.o libmem.ald: libmem.a(mem.o): in function `malloc':mem.c:(.text+0x0): multiple definition of `malloc'; app.o:app.c:(.text+0x0): first defined here静态链接 C 库时自己实现内存分配器,必须把同一个成员里的函数一起替换掉,原因就在这里。替换成功之后还有一个不太显眼的后果:C 库内部其他函数对 malloc 的调用,也都配对到了程序的版本上,因为全局符号表里这个名字只有一个定义。想知道某个成员为什么被拉进来,GNU ld 的映射文件(-Map,链接器输出的一份文本报告,列出每个节和符号放到了哪里,第 5 章细讲)开头就有一段答案,lld 有专门的 --why-extract:
$ ld -e main main.o libmath.a libscale.a -Map=-Archive member included to satisfy reference by file (symbol)
libmath.a(add.o) main.o (add)libscale.a(scale.o) libmath.a(add.o) (scale)...$ ld.lld -e main main.o libscale.a libmath.a --why-extract=-reference extracted symbollibmath.a(add.o) libscale.a(scale.o) scalemain.o libmath.a(add.o) add静态库之外还有共享库。它的定义同样进入这张全局符号表,只是进入的方式不同。
共享库也参加配对
静态库的成员会被拷进输出,共享库不会。命令行上出现一个 .so,链接器读的是它的动态符号表(共享库公开给运行时的那张符号表 .dynsym,下文和第 7 章细讲),把里面的定义也记进全局符号表,作用只是让引用"有着落":链接器确认 add 在运行时能从 libadd.so 里找到,在输出里记下"需要 libadd.so"(DT_NEEDED,第 7 章讲),地址留给运行时的动态链接器去填。只链 main.o libadd.so,输出里的 add 仍然是 U。
共享库的定义和目标文件的定义同时存在时,目标文件的优先,与命令行顺序无关。libadd.so 里的 add 做减法,add.o 里的做加法,把 .so 写在前面链接:
$ ld -e main main.o libadd.so add.o -o e1$ nm e1 | grep add0000000000401010 T add$ readelf -dW e1 | grep NEEDED 0x0000000000000001 (NEEDED) Shared library: [libadd.so]add 是可执行文件自己的定义,lld 结果相同。libadd.so 仍被记为依赖,因为它在命令行上出现过(GNU ld 的 --as-needed 可以去掉这种用不到的依赖,第 7 章讲)。这条优先级到运行时会以另一种形式再出现一次:可执行文件里的定义,会盖过共享库里同名的、对外公开的符号。
库把名字暴露给使用者,这本是它的目的。可一个库由很多个 .c 文件组成,文件之间互相调用的内部函数也必须是全局符号,否则别的文件找不到它;同时这些名字又不该让使用库的程序看到、更不该被它们的同名定义顶替。LOCAL 的范围太窄,只有一个文件;GLOBAL 太宽,整个程序都能看见。
不该外泄的名字:可见性
ELF 在绑定之外给符号加了第二个维度,叫可见性(visibility),存在符号表项的 st_other 字段里。它管模块之间的事。模块指链接器的一份输出:一个可执行文件,或者一个共享库(第 1 章讲过,运行时才装进来、可以被多个程序共用的库)。常用的有三档:
- default:默认值,符号在模块外可见,也可能被别的模块里的同名定义顶替;
- hidden:只在本模块内可见,链接完成后不出模块;
- protected:在模块外可见,但本模块内部对它的引用一定绑定到自己的定义,不会被顶替。
gABI 还定义了第四档 internal,具体含义留给各处理器的补充规范,通用工具一般按 hidden 处理,实际很少用到。在 C 里用 __attribute__((visibility("hidden"))) 指定:
__attribute__((visibility("hidden"))) int internal_counter = 1;__attribute__((visibility("protected"))) int api_level = 2;int bump(void) { return ++internal_counter + api_level; }$ readelf -sW vis.o Num: Value Size Type Bind Vis Ndx Name 3: 0000000000000000 21 FUNC GLOBAL DEFAULT 2 bump 4: 0000000000000000 4 OBJECT GLOBAL HIDDEN 4 internal_counter 5: 0000000000000004 4 OBJECT GLOBAL PROTECTED 4 api_level在目标文件里,internal_counter 仍然是 GLOBAL,同一个库的其他 .o 照样能引用它。把 vis.o 和一个读 internal_counter 的 peek.o 链成共享库,一切正常。区别出在输出上。共享库有一张给运行时用的动态符号表 .dynsym(第 7 章细讲),其他模块只能通过它看到这个库的符号:
$ ld.lld -shared vis.o -o libvis.so$ readelf --dyn-syms -W libvis.so Num: Value Size Type Bind Vis Ndx Name 1: 00000000000012e0 21 FUNC GLOBAL DEFAULT 6 bump 2: 000000000000336c 4 OBJECT GLOBAL PROTECTED 9 api_level$ readelf -sW libvis.so | grep internal 2: 0000000000003368 4 OBJECT LOCAL HIDDEN 9 internal_counterinternal_counter 不在 .dynsym 里;在普通符号表里,链接器把它降成了 LOCAL。程序想直接用它,链接时就找不到:
$ ld.lld -e main useh.o libvis.sold.lld: error: undefined symbol: internal_counter>>> referenced by useh.c>>> useh.o:(main)可见性还会改变编译器生成的代码。把 api_level 的 protected 去掉,变回 default,其余不变,编译时加 -fPIC(生成能装到任意地址的代码,第 1 章讲过 PIC),再对比两个目标文件:
# internal_counter 是 hidden,api_level 是 protected0000000000000000 <bump>: 0: movl (%rip), %eax 0000000000000002: R_X86_64_PC32 internal_counter-0x4 ... e: addl (%rip), %eax 0000000000000010: R_X86_64_PC32 api_level-0x4 14: retq
# internal_counter 是 hidden,api_level 是 default0000000000000000 <bump>: 0: movl (%rip), %eax 0000000000000002: R_X86_64_PC32 internal_counter-0x4 ... e: movq (%rip), %rcx 0000000000000011: R_X86_64_REX_GOTPCRELX api_level-0x4 15: addl (%rcx), %eax 17: retqR_X86_64_REX_GOTPCRELX 是"从 GOT 里取地址"的那类重定位,第 4 章细讲。default 的变量要先从 GOT 里取出地址再读,hidden 的变量直接按 PC 相对距离读;在 clang 下,protected 的变量也直接读。原因是 default 符号可能被别的模块顶替:程序本身或者更早装入的库里如果有一个同名定义,运行时的动态链接器会让所有引用都指向那一个,库自己的定义反而不用。这叫符号插入(symbol interposition),是第 7 章的重点之一。编译器生成共享库代码时不能假定 default 符号的定义就在本模块,只好多绕一层。hidden 和 protected 都承诺了"本模块内的引用就是自己",所以原则上都能直接访问,这也是很多项目用 -fvisibility=hidden 编译、只给导出的接口单独标 visibility("default") 的原因之一:动态符号表更小,函数调用和变量访问也更直接。GCC 对 protected 的数据更保守,本机 GCC 15 用同样的选项编译,api_level 仍然走 R_X86_64_REX_GOTPCRELX。原因是第 7 章要讲的复制重定位:非 PIC 的可执行文件会把共享库里的变量复制一份到自己这里,这时库内部如果直接访问自己那份,就和程序看到的不是同一个变量。protected 的数据因此麻烦不少,实际项目里多用 hidden。
未定义条目什么时候才会报错
解析规则决定名字对应谁,诊断规则还要决定:留下未定义条目是否必须拒绝输出。一个只被声明、从没被用到的外部名字,C 编译器根本不会写进符号表;手写汇编却可以造出这样的表项,.globl ghost 之后不再提它,汇编器就留下一个没有任何重定位指向的 GLOBAL UND:
这三份汇编输入把边界单独隔离出来:
# ug.s.text.globl mainmain: ret.globl ghost# dbg.s.text.globl mainmain: ret.section .debug_info,"",@progbits.quad dref# hg.s.text.globl mainmain: ret.globl ghost.hidden ghostclang -c ug.s dbg.s hg.s$ readelf -sW ug.o | grep ghost 2: 0000000000000000 0 NOTYPE GLOBAL DEFAULT UND ghost$ readelf -rW ug.o
There are no relocations in this file.$ ld -e main ug.o -o g_ug; echo $?0$ ld.lld -e main ug.o -o l_ug; echo $?; nm l_ug0 U ghost0000000000201120 T main两个链接器都不报错。GNU ld 的输出里没有 ghost,lld 把这个 U 原样留在了输出的符号表里。
"有重定位用到"这一条,两个链接器有两处划得不一样。一处是 dbg.o:唯一用到 dref 的重定位在 .debug_info 里,这个节不带 SHF_ALLOC(第 2 章讲过,带这个标志的节才会装进内存)。另一处是 hg.o:把 ghost 标成 .hidden,仍然没有任何重定位:
$ ld -e main dbg.old: dbg.o:(.debug_info+0x0): undefined reference to `dref'$ ld.lld -e main dbg.o; echo $?0$ readelf -sW hg.o | grep ghost 2: 0000000000000000 0 NOTYPE GLOBAL HIDDEN UND ghost$ ld -e main hg.o -o g_hgld: g_hg: hidden symbol `ghost' isn't definedld: final link failed: bad value$ ld.lld -e main hg.o; echo $?0调试信息里的引用,lld 不报,GNU ld 报。hidden 那一处走的是另一条检查:GNU ld 写输出符号表时,要求非弱、可见性不是 default 的符号必须在本模块里有定义,有没有重定位都一样(binutils 2.45 bfd/elflink.c 的 elf_link_output_extsym,注释原文 "If a non-weak symbol with non-default visibility is not defined locally, it is a fatal error.",源码)。lld 没有这条检查。这说明可见性约束和“是否存在待修补的引用”是两项不同的检查。
目前为止的规则都默认一个名字只该有一个定义,多出来的不是错误就是有意的覆盖。C++ 却让同一个函数在许多目标文件里各有一份,而且这是有意为之。
每个文件都有一份:COMDAT 与 ODR
C++ 的 inline 函数和模板实例写在头文件里,多个翻译单元可能各自生成一份独立的函数体;如果调用全部被内联或消除,也可能不生成这样的副本。编译器一次只看一个翻译单元,不知道别的文件有没有生成同样的东西,只能自己留一份。第 1 章讲过这带来的膨胀,以及 COMDAT 的来历。这里看它在目标文件里的样子:
// t1.cppinline int version() { return 1; }int from_t1() { return version(); }int main() { return from_t1(); }$ nm t1.o0000000000000000 T _Z7from_t1v0000000000000000 W _Z7versionv0000000000000010 T main$ readelf -gW t1.o
COMDAT group section [ 4] `.group' [_Z7versionv] contains 1 sections: [Index] Name [ 5] .text._Z7versionv_Z7versionv 是 version() 经过名字修饰(name mangling)之后的符号名。C++ 允许同名函数按参数重载、按命名空间区分,可链接器只认字符串,所以编译器把这些信息编码进名字:_Z 是前缀,7version 是长度加名字,最后的 v 表示参数列表为 void。规则由第 1 章提过的 Itanium C++ ABI22 规定(Itanium C++ ABI: Mangling),c++filt 可以把它还原。
version 的代码单独放在 .text._Z7versionv 这个节里,节标志带 G,表示它属于一个节组。节组由一个类型为 SHT_GROUP 的 .group 节描述:它的 sh_info 指向一个符号,这个符号的名字叫组的签名,这里就是 _Z7versionv;节的内容是一串 4 字节的字,第一个字是标志,GRP_COMDAT 表示这是一个 COMDAT 组,后面每个字是组内一个成员节的编号。本例的 .group 大小是 8 字节,正好是标志加一个成员。
链接器处理节组的规则在 gABI 的节一章里(gABI: Section Groups):签名相同的 COMDAT 组只保留一份,GNU ld 和 lld 保留的都是先读到的那份,其余整组丢弃,组内的节一个不留,它们自带的重定位也一起丢掉。整组进退是因为一个组里可能不止代码:函数用到的常量、它的异常处理数据,都可以和它放在同一个组里,只留一半就会出现指向不存在内容的引用。另外,version 的符号本身是弱的(nm 的 W),即使某种情况下两份定义都留下了,也不会报重复定义。
如果两个同签名的组内容不一样,丢弃就会出问题。下面用汇编手写两个签名都是 foo 的组,g1.o 的组里多定义了一个 foo_extra,g2.o 的没有,主程序两个都调用。让 g2.o 先被读到:
$ ld -e main gm.o g2.o g1.old: gm.o: in function `main':(.text+0x6): undefined reference to `foo_extra'
$ ld.lld -e main gm.o g2.o g1.old.lld: error: relocation refers to a symbol in a discarded section: foo_extra>>> defined in g1.o>>> section group signature: foo>>> prevailing definition is in g2.o...g1.o 的组被整个丢掉了,foo_extra 跟着消失。lld 把原因说得更清楚:符号的定义在被丢弃的节里,胜出的是 g2.o 那一组。正常的编译器不会生成这样的组,可同一个库的两个版本、两种编译选项混在一起时,这种错误会以 undefined reference 的面目出现,很难联想到 COMDAT。
链接器把同签名的组当作可替代的副本,通常不会逐字节验证它们。C++ 的 ODR23(One Definition Rule,单一定义规则)约束的是源程序:对于这里允许跨翻译单元重复定义的 inline 函数,定义要有相同的 token 序列,相应名字的查找结果也须满足一致性要求。这不等于各次编译必须生成完全相同的机器码。违反这些跨翻译单元条件时,通常不要求实现给出诊断;COMDAT 去重也不是 ODR 正确性的证明(C++ 标准草案:basic.def.odr)。违反时会发生什么,可以直接试。t2.cpp 里也有一个 inline int version(),但返回 2:
$ ld -e main t1.o t2.o -o o120000000000401030 <_Z7versionv>: 401034: movl $0x1, %eax$ ld -e main t2.o t1.o -o o210000000000401010 <_Z7versionv>: 401014: movl $0x2, %eax没有错误也没有警告,version() 返回几取决于哪个文件排在前面,lld 的结果相同。这还是两边都用 -O0 的情况。如果 t1.cpp 用 -O0、t2.cpp 用 -O1 混着编译,from_t2 直接被优化成了 movl $0x2, %eax; retq,t2.o 里干脆不再有 version 的符号,链接后 _Z7versionv 返回 1,from_t2 却返回 2。于是同一个程序里,经过调用的地方得到链接器留下的那份,被内联的地方得到各自翻译单元里的那份,两个答案同时存在。
链接器通常发现不了这种问题。它只看到两个同名的组,比较字节也没用:即使源码完全一样,不同的优化选项也会合法地生成不同的字节。能查出一部分的是看得到全部源码的工具,例如 GCC 在 LTO 下的 -Wodr 警告(前面"链接器不检查类型"一节演示过);gold 链接器也曾提供 --detect-odr-violations,借助调试信息报告一部分。
C 语言也有 inline,可它和 C++ 的规则不同,不走 COMDAT。按 C99 起的规定,一个文件里只写 inline、不写 extern 的函数定义,只供本文件内联使用,它不提供外部定义(C11 §6.7.4p7);整个程序里必须另有一个文件用 extern inline 或普通定义提供那一份。把 inline int twice(int x) 写进 .c 文件,用 -std=c11 -O0 编译:
$ nm ci.o0000000000000000 T main U twice$ ld -e main ci.old: ci.o: in function `main':ci.c:(.text+0x15): undefined reference to `twice'-O0 不做内联,main 只好调用 twice,而本文件按规定不提供它的外部定义,于是成了 U。换成 -O1,调用被内联,U twice 消失,链接通过。同一份源码,优化级别不同,一个能链过、一个不能。GCC 在 -std=gnu89 下的老规则正好相反,inline 会生成外部定义,从老代码迁移时这里经常出问题。C 代码里放在头文件中的小函数,惯用写法是 static inline:每个文件各留一份 LOCAL 的 t twice,彼此不冲突,也不依赖别人提供定义。
没人定义的名字:链接器合成的符号
到这里,每个定义都来自某个输入文件。还有一类名字,所有输入里都只有引用,链接器却不报 undefined reference,因为它自己造出了定义。最老的一组是 etext、edata、end,分别是代码、已初始化数据、整个映像(含 .bss)结束之后的第一个地址。MIT 教学操作系统 xv624 的 x86 版在链接器脚本的注释里写道,Unix 链接器按惯例提供这三个"伪符号"(pseudo-symbols),这个惯例比只读数据节 .rodata 出现得还早(xv6-public kernel.ld)。写一个程序引用它们,再加上指向 ELF 头的 __ehdr_start:
// syn.c#include <stdio.h>#include <elf.h>
extern char etext[], edata[], end[];extern const Elf64_Ehdr __ehdr_start;
int counter = 1; /* .data */int zeros[100]; /* .bss */
int main(void) { printf("__ehdr_start = %p magic = %.3s\n", (void *)&__ehdr_start, (const char *)__ehdr_start.e_ident + 1); printf("etext = %p\n", (void *)etext); printf("edata = %p\n", (void *)edata); printf("end = %p\n", (void *)end); return 0;}syn.o 里四个名字都是 U。用 musl-gcc -O1 -static syn.c -o syn 原生构建并运行,再和 readelf 对照:
$ ./syn__ehdr_start = 0x400000 magic = ELFetext = 0x405947edata = 0x408110end = 0x408958$ readelf -SW syn | grep -E "fini|data|bss" [ 3] .fini PROGBITS 0000000000405944 005944 000003 00 AX 0 0 1 [ 4] .rodata PROGBITS 0000000000406000 006000 000cba 00 A 0 0 32 [ 7] .fini_array FINI_ARRAY 0000000000407fc8 006fc8 000008 08 WA 0 0 8 [ 8] .data.rel.ro PROGBITS 0000000000407fd0 006fd0 000010 00 WA 0 0 8 [11] .data PROGBITS 0000000000408000 007000 000110 00 WA 0 0 32 [12] .bss NOBITS 0000000000408120 007110 000838 00 WA 0 0 32$ readelf -lW syn | grep LOAD LOAD 0x000000 0x0000000000400000 0x0000000000400000 0x000190 0x000190 R 0x1000 LOAD 0x001000 0x0000000000401000 0x0000000000401000 0x004947 0x004947 R E 0x1000 LOAD 0x006000 0x0000000000406000 0x0000000000406000 0x000cf4 0x000cf4 R 0x1000 LOAD 0x006fc0 0x0000000000407fc0 0x0000000000407fc0 0x000150 0x000998 RW 0x1000四个地址都对得上。__ehdr_start 是第一个 LOAD 段的起点,ELF 头本身就放在那里,所以能读出魔数 ELF。etext 是可执行段的末尾,0x401000 + 0x4947 = 0x405947,也就是 .fini 的结尾。edata 是 .data 的结尾 0x408000 + 0x110。end 是读写段在内存里的末尾 0x407fc0 + 0x998,.bss 也算在内。
GNU ld 的这些定义写在它的默认链接器脚本里(链接器脚本是告诉链接器怎样排布输出的小程序,第 5 章讲基本语法,ld --verbose 能打印出默认的那一份):
PROVIDE (etext = .); _edata = .; PROVIDE (edata = .); _end = .; PROVIDE (end = .);. 是脚本里"当前地址"的意思。PROVIDE 只在有人引用、却没有任何输入定义这个名字时才生效,所以它在符号解析里的地位比任何真实定义都低。程序自己写一个 int end = 3;,链接器就不再提供 end,nm 里的 end 指向程序的变量,GNU ld 和 lld 都是这样;没用 PROVIDE 的 _end 则照常由 GNU ld 定义。lld 没有默认脚本,在代码里实现同样的语义,只在被引用时才定义这些名字。
同一类的还有几组:
_GLOBAL_OFFSET_TABLE_指向 GOT,汇编代码按它算各个 GOT 项的位置,第 7 章讲 GOT 时会用到。被引用时,两个链接器都把它定义成本地符号,lld 放在.got.plt的开头;__start_节名和__stop_节名标出一个输出节的首尾,节名必须是合法的 C 标识符,第 5 章细讲;_binary_文件名_start、_end、_size在用-b binary把任意文件当作数据链接进来时生成,第 10 章细讲。
C 代码引用这类符号,惯用 extern char end[]; 这种数组写法。链接器给的只是一个地址,那里没有属于这个名字的存储,写成数组以后 end 本身就是那个地址,不会误去读它的"值"。xv6 内核就是这样用的:kernel/kalloc.c 声明 extern char end[]; // first address after kernel.,初始化时调用 freerange(end, (void *)PHYSTOP),把内核映像之后到物理内存上限之间的每一页交给页分配器,而 end 来自 kernel/kernel.ld 末尾的 PROVIDE(end = .);(xv6-riscv kalloc.c、kernel.ld)。内核要知道自己在哪里结束,才能把剩下的内存分出去,这个地址只有链接器知道。
把规则收进一张表的格子里
前面的规则是一条条看来的,在链接器内部,它们都落在同一个数据结构上。lld 的全局符号表里,每个名字在任何时刻都处于几种状态之一(lld/ELF/Symbols.h):Undefined(有人引用、还没定义)、Lazy(定义在某个还没拉进来的库成员里)、Shared(定义在某个共享库里)、Common(common 符号)、Defined(目标文件里的普通定义,强或弱)。每读到一个文件里的一个符号,就用"新来的那一项"和"表里现有的状态"做一次合并,合并规则写在 Symbols.cpp 的几个 resolve 函数里。本章前面给出的每一种输入都可以归结为这几条规则:
- 现有 Undefined,新来 Lazy;或者现有 Lazy,新来 Undefined:拉取那个库成员。现有状态如果是弱的 Undefined,源码注释写着"An undefined weak will not extract archive members",只记下这个名字有个惰性定义,不拉取,这就是
hook没被拉进来的原因。 - 现有已经是 Defined,新来 Lazy:什么也不做。弱定义的
counter挡住了libcnt.a里的强定义,走的就是这条路。 - 现有 Defined,新来 Defined:函数
shouldReplace只在"现有的不是 GLOBAL、新来的是 GLOBAL"时替换,也就是弱让强,两个都是弱的保留先来的;两个都是强的情况由另外的检查报成重复定义,下面马上会看到它的一个例外。合并时可见性也取两者中最严的一档,这同样是 gABI 的规则。 - 现有 Common,新来一个非弱的 Defined:被替换;现有的是弱的 Defined,新来 Common:也被替换,这就是谜题第 5 行倒过来链接时 common 胜出的原因;两个 Common 合并时取较大的尺寸。
- 现有 Shared,新来 Defined:被替换,这就是目标文件优先于共享库。
gABI 对同名的 STB_GLOBAL 定义没有留例外。可报重复定义的函数 reportDuplicate 在报错之前有几处放行,其中一处是给绝对符号的。绝对符号的所属节是特殊节号 SHN_ABS(readelf 显示为 ABS),值就是一个固定的数,不属于任何节,也不随链接搬动;汇编里写 .globl lim 加 lim = 5 就得到一个。两个文件各定义一个值相同的 lim,算不算重复定义?LLVM 21.1.8 的 lld/ELF/Symbols.cpp 第 536 至 538 行是这样写的(源码):
// Allow absolute symbols with the same value for GNU ld compatibility. if (!d->section && !errSec && errOffset && d->value == errOffset) return;d 是表里已有的定义,errSec 和 errOffset 是新来那个定义的节和值。两边都没有节、值相等就放行,注释说这是为了兼容 GNU ld:放过值相同的绝对符号是 GNU ld 的行为,lld 跟着兼容。条件里多出来的 errOffset && 要求新来的值不为 0,于是值同为 0 时 lld 照样报错,GNU ld 不报。下面的 r.o 里只有一个空的 main:
$ ld -e main r.o abs_a5.o abs_b5.o; echo $? # 两个 lim = 50$ ld.lld -e main r.o abs_a5.o abs_b5.o; echo $?0$ ld -e main r.o abs_a0.o abs_b0.o; echo $? # 两个 lim = 00$ ld.lld -e main r.o abs_a0.o abs_b0.old.lld: error: duplicate symbol: lim>>> defined in abs_a0.o>>> defined in abs_b0.o$ ld -e main r.o abs_a5.o abs_c6.o # lim = 5 和 lim = 6ld: abs_c6.o: in function `lim':(*ABS*+0x6): multiple definition of `lim'值不同时两个链接器都报错。
GNU ld 的实现分散在第 1 章提过的 BFD 库里,结构不同。除了静态库的扫描顺序、为 common 拉成员、值为 0 的绝对符号这三处,它在选哪个定义这件事上与 lld 一致,上述规则可以逐一对照实现;报错时机和 -y 的差异见下一节。第 16 章会看到,多线程的链接器还要保证这张表的结果与线程调度无关。
两条最常见的错误
undefined reference(lld 叫 undefined symbol)的意思是:所有输入读完,全局符号表里这个名字仍然只有引用,其中有强引用,而且有重定位要用它(本章“未定义条目什么时候才会报错”一节讨论了诊断的边界)。常见的根因有这几种:
- 定义根本没有参与链接:少写了一个目标文件或一个
-l库; - 定义在静态库里,但库排在引用者前面,或者库之间有环(只在 GNU ld 这类传统链接器上出现);
- 名字对不上:C 代码引用
version,C++ 那边定义的是修饰过的_Z7versionv,C++ 一侧需要用extern "C"关掉名字修饰; - 定义在另一个模块里,但它是 hidden 的;
- 定义在一个被丢弃的 COMDAT 组里。
名字对不上这一种最容易让人困惑,因为源码里两边写的明明是同一个词。C 文件 cmain.c 调用 version(),定义写在 C++ 文件 ver.cpp 里:
$ nm ver.o verc.o
ver.o:0000000000000000 T _Z7versionv
verc.o:0000000000000000 T version$ ld -e main cmain.o ver.old: cmain.o: in function `main':cmain.c:(.text+0x10): undefined reference to `version'ver.o 定义的是修饰过的 _Z7versionv(c++filt 还原出来是 version()),C 那边要的是不带修饰的 version,在链接器眼里这是两个毫不相干的字符串。verc.cpp 把定义写成 extern "C" int version(),符号名就成了 version,链接通过。
multiple definition(lld 叫 duplicate symbol)的意思是:同一个名字出现了两个强定义。最常见的来源是把函数或变量的定义写进了头文件,被两个 .c 文件包含;其次是老代码遇上默认的 -fno-common;再就是静态库成员被拉进来时,带进了一个和程序重名的强定义。
两类错误同时存在时,两个链接器报出来的不一样多。da.c 定义 counter 并调用一个没人定义的 missing,db.c 也定义了 counter:
$ ld -e main da.o db.old: db.o:(.data+0x0): multiple definition of `counter'; da.o:(.data+0x0): first defined hereld: da.o: in function `main':da.c:(.text+0x2): undefined reference to `missing'$ ld.lld -e main da.o db.old.lld: error: duplicate symbol: counter>>> defined at da.c>>> da.o:(counter)>>> defined at db.c>>> db.o:(.data+0x0)GNU ld 两条一起报。lld 在符号解析结束时集中报告重复定义,然后检查错误计数,有错就返回(lld/ELF/Driver.cpp 里注释为 "Return if there were name resolution errors." 的那几行,源码),不再去扫描重定位,而未定义符号正是在扫描重定位时才报的;去掉 db.o 再链一次,undefined symbol: missing 才出现。用 lld 时修好一类错误又冒出另一类,不代表刚才的修改引入了新问题。
两个链接器都提供 --allow-multiple-definition(简写 -z muldefs),让重复的强定义不再报错、保留先读到的那个。拿本章开头的 a.o b.o 试,counter 落在 a.o 的定义上,b.o 的那 4 个字节照样留在 .data 里。这个选项只是把错误藏起来,两份定义里哪份被用到,取决于命令行顺序,和前面 ODR 那一节的问题性质相同。
排查时,nm 是第一件工具:对所有相关的目标文件和库运行 nm -A,按名字过滤,看谁是 U(未定义)、谁是 T/D/B(强定义)、谁是 W/V(弱)、谁是 C(common)。第二件是让链接器自己说出它的决定。GNU ld 的 -y 名字(等价于 --trace-symbol=名字)会打印这个名字在解析过程中经过的引用和定义,lld 也支持同一个选项:
$ ld -e main main.o libmath.a libscale.a -y scaleld: libmath.a(add.o): reference to scaleld: libscale.a(scale.o): definition of scale经过编译器驱动程序(第 0 章讲过)时写成 -Wl,-y,scale,-Wl, 后面的内容会原样转交给链接器。
它打印的并不是每个提到这个名字的文件。拿开头那几个 counter 来试,mref.o 只引用,s.o 是强定义,w.o 是弱定义,cm.o 是 -fcommon 编译的 int counter;:
$ ld -e main mref.o s.o w.o -y counterld: mref.o: reference to counterld: s.o: definition of counter$ ld.lld -e main mref.o s.o w.o -y countermref.o: reference to counters.o: definition of counter$ ld.lld -e main mref.o cm.o -y countermref.o: reference to countercm.o: common definition of countercm.o: definition of counter强定义已经在表里,后来的弱定义被忽略,两个链接器都不打印它;顺序换成 w.o s.o,两行定义都会出现。lld 的定义那几行打在替换表项的函数 overwrite 里(Symbols.h),表项没被换掉就没有输出;引用那几行由 resolve(Undefined) 打印(Symbols.cpp),每个引用都会打,mref.o mref2.o s.o -y counter 里第二个引用者 mref2.o 也有一行。common 在解析结束后被换成 .bss 里的一个普通定义,又换了一次表项,所以多出一行 definition of。GNU ld 链接 mref.o cm.o 只打印一行定义。两者也有不一致的地方:GNU ld 会打印某些被忽略的定义,先 common 后弱定义(cm.o w.o)时打印那个弱定义,先强定义后 common(s.o cm.o)时打印那个 common,lld 两处都不打印。-y 没有列出某个文件,不能说明这个文件没定义它。
-y、前面的映射文件和 --why-extract 合起来,基本能还原链接器在每一步看到了什么。
链接器也允许你从命令行改写解析结果。--defsym=limit=real_limit 直接定义一个符号,让它等于另一个符号的值,链接后 limit 和 real_limit 都在 0x403000。--wrap=malloc 更常用于测试和调试:所有对 malloc 的未定义引用都改成指向 __wrap_malloc,而对 __real_malloc 的引用指向真正的 malloc:
$ ld -e main wm.o wr.o --wrap=malloc -o wrp0000000000401000 <main>: 401001: movl $0x10, %edi 401006: callq 0x401020 <__wrap_malloc>main 源码里写的是 malloc(16),链接后调用的是 __wrap_malloc。ld 手册特别说明,这个替换只作用于未定义的引用("Only undefined references are replaced by the linker"):如果 malloc 的定义和调用者在同一个目标文件里,对那个文件来说 malloc 是已定义符号,不是未定义引用,即使目标文件里留着一条 R_X86_64_PLT32 malloc 重定位,--wrap 也不会改它。
从定义到地址
符号解析确定的是引用所对应的定义,以及没有定义时应当如何处理。对来自目标文件的普通定义,结果包含输入文件、所属节和节内偏移;对 common 符号,结果仍是待分配存储的大小与对齐要求。绝对符号已有固定值,不需要安排存储。允许保留的未定义弱引用则按相应重定位规则处理,不能把它当成某个输入节中的定义。
这些结果并不等于最终地址。以静态链接中的普通符号为例,假设它位于某个输入 .text 节内的偏移 8,布局阶段将这个输入节放到输出虚拟地址 0x401020,符号地址才成为 0x401028。这里的 8 相对于输入节起点,0x401020 则属于输出地址空间;文件中的字节偏移是另一种坐标。
| 定义类别 | 解析后已经知道什么 | 何时能确定数值 |
|---|---|---|
| 普通节内定义 | 输入节及节内偏移,例如 8 | 布局给出该输入节的输出地址后,相加得到符号地址 |
绝对符号 SHN_ABS | 固定值,例如 0x42 | 无须加上节地址,值仍为 0x42 |
common 符号 SHN_COMMON | 合并后的大小与对齐要求 | 分配存储并完成布局后,得到所分配位置的地址 |
| 共享库提供的定义 | 链接时可用的符号及其动态链接约束 | 是否需要运行时查找,取决于可见性、绑定规则和重定位形式 |
解析阶段也可能保留尚未满足的引用。是否报错,要结合引用所在的节是否保留、输出类型及前文讨论的诊断规则判断。输入节是否最终进入输出,还需要垃圾回收等后续步骤决定;解析提供引用关系,布局给存活的内容安排位置,重定位再把所需的数值写入引用处。
因此,“add 定义在 add.o 的 .text 偏移 0”回答的是定义在哪里,还没有回答跳转指令要写什么。确定输出位置后,还要结合重定位类型、加数和写入位置计算结果。下一章将沿着这条关系解释指令字节如何得到最终的值。
练习
答案在章末。Linux 原生命令按本章顺序执行;错误案例也应记录退出状态。
观察
- 对第 0 章的
main.o、other.o和prog运行nm -A main.o other.o prog | grep -E ' [xy]$',再用musl-gcc -static main.o other.o -o prog -Wl,--trace-symbol=x重新链接一次。x在三个文件里各标成什么字母?链接器报告的引用和定义各来自哪个文件?所有输出里有没有一处提到double? - 静态链接这个程序:
int main(int argc, char **argv) { return puts(strdup(argv[0])) < 0; },加上-Wl,-y,strdup -Wl,-y,malloc。malloc是谁引用的,由 musl25libc.a的哪个成员定义?用nm看那个成员,malloc标成什么字母,这对"程序自己写一个malloc"意味着什么? - 对本章的
syn运行nm,etext、edata、end、__ehdr_start各标成什么字母?
预测
-
解析结果判定。用
REF(名字.模块) → DEF(名字.模块)写出每个引用配对到哪个模块的定义,链接失败写 ERROR。所有文件用clang -O0编译,默认-fno-common,按 m1.o、m2.o 的顺序链接,另有说明的除外。- (a) m1.c:
int buf[4]; int main(void) { return buf[0]; };m2.c:int buf[8]; int *get(void) { return buf; }。分别回答-fcommon和-fno-common,能链接的话buf多大? - (b) m1.c:
int level = 3; int main(void) { return level; };m2.c:__attribute__((weak)) int level = 1; int get(void) { return level; }。 - (c) m1.c:
__attribute__((weak)) int f(void) { return 1; } int main(void) { return f(); };m2.c:__attribute__((weak)) int f(void) { return 2; }。链接顺序是 m2.o、m1.o。 - (d) m1.c:
extern int secret; int main(void) { return secret; };m2.c:__attribute__((visibility("hidden"))) int secret = 7; int peek(void) { return secret; }。一种做法是把 m2.o 先链成libm2.so,再链接m1.o libm2.so;另一种是直接链接m1.o m2.o。 - (e) t1.cpp:
inline int ver() { return 1; } int from1() { return ver(); } int main() { return from1(); };t2.cpp:inline int ver() { return 2; } int from2() { return ver(); }。链接顺序 t2.o、t1.o,main返回几? - (f) m1.c:
static int n = 1; int main(void) { return n; };m2.c:int n = 2; int get(void) { return n; }。
- (a) m1.c:
-
静态库最短命令行。
main.o调用p1,三个库的成员和依赖如下,箭头表示"调用":main.o -> p1libp.a: p1.o (p1 -> q1) p2.o (p2 -> q2)libq.a: q1.o (q1 -> r1) q2.o (q2 不调用别人)libr.a: r1.o (r1 -> p2)用 GNU ld 时,(a) 每个库可以写多次,最短的命令行是什么?(b) 用
--start-group怎么写?(c)main.o libp.a libq.a libr.a报什么错?(d) 换成 lld 呢?
改坏
- 下面六个程序用
musl-gcc(GCC 15)构建,直接在 Linux 上运行。每个都会在某一步失败:预处理、编译、汇编、链接、加载、运行。判断是哪一步,并预测报错。- (a)
#include "config.h"加一个空的main,目录里没有config.h。 - (b)
int main(void) { return twice(21); },前面没有任何声明。 - (c)
int main(void) { __asm__("movq %eax, %rbx"); return 0; } - (d)
int twice(int x); int main(void) { return twice(21); },没有别的文件。 - (e)
int foo(void); int main(void) { return foo(); },链接时用-L. -lfoo链到libfoo.so(动态链接),运行时不设LD_LIBRARY_PATH。 - (f) 本章的
fanswer.c加上extern int answer; int main(void) { answer = 1; return 0; },静态链接。
- (a)
参考
- gABI: Symbol Table(绑定、可见性、弱符号与 common 的规则)
- gABI: Section Groups
- GNU ld 手册:Options(
--start-group、-y、--wrap、--warn-common、--defsym) - lld: --warn-backrefs
- GCC 10 Porting Guide(默认
-fno-common) - Clang 11 Release Notes
- MaskRay: All about COMMON symbols
- MaskRay: Symbol processing
- Itanium C++ ABI
- cppreference: Definitions and ODR
- CMU 15-213: Linking 讲义(Linker Puzzles、强弱符号的教学术语)与课堂活动
- CS 第 2 版第 7 章试读、CS 3e Errata
- GCC: Warning Options(
-Wlto-type-mismatch、-Wodr) - xv6-riscv(
kernel/kalloc.c、kernel/kernel.ld)、xv6-public kernel.ld
练习答案
展开答案
-
main.o里x和y都是D(偏移 0 和 4),other.o里x是U,prog里x是 0x408008 的D。--trace-symbol=x打印两行:main.o: definition of x和other.o: reference to x。没有任何一处提到double,链接器手里只有名字。 -
输出是:
ld: dup.o: reference to strdupld: .../libc.a(strdup.lo): definition of strdupld: .../libc.a(strdup.lo): reference to mallocld: .../libc.a(lite_malloc.lo): definition of mallocmalloc是被拉进来的strdup.lo引用的,由lite_malloc.lo定义,nm显示为W,一个弱定义。程序自己写一个强定义的malloc时,弱让强,不会出现正文libmem.a那种multiple definition。(这个程序没调用free,musl 用的是只分配不回收的简易版本;调用了free时会换成另一套实现,可以自己加上-y free追一下。) -
etext是T,edata是D,end是B,__ehdr_start是t。合成符号没有类型和尺寸(readelf里是 NOTYPE、尺寸 0),nm的字母只取决于它落在哪个节;__ehdr_start是小写,因为链接器把它定义成了本地符号,不参与和别的模块的配对。 -
两个链接器的结果一致。
- (a)
-fcommon:REF(buf.1)、REF(buf.2) → 合并后的同一个 common,在.bss,尺寸取较大的 32 字节(nm -S显示0x20)。-fno-common:ERROR,multiple definition of 'buf'。 - (b) REF(level.1) → DEF(level.1),REF(level.2) → DEF(level.1)。
get读到的是强定义的 3,弱定义的 1 仍留在.data的下一个字里;通过驱动程序链接并原生运行,退出码是 3。 - (c) REF(f.1) → DEF(f.2),
main返回 2。两个都是弱定义,保留先读到的 m2.o。clang 不会把弱函数内联进main,本题-O0的main里留的是一条带重定位的call,所以结果取决于链接。 - (d) 先链成共享库:ERROR,
undefined reference to 'secret',hidden 的定义不进libm2.so的.dynsym。直接链接m1.o m2.o:REF(secret.1) → DEF(secret.2),hidden 只限制模块之间,同一次链接里照常配对。 - (e) REF(ver.1)、REF(ver.2) → DEF(ver.2),
main返回 2。签名为_Z3verv的 COMDAT 组保留先读到的 t2.o 那份。 - (f) REF(n.1) → DEF(n.1),REF(n.2) → DEF(n.2)。
static的n是 LOCAL,不进全局符号表,链接后nm里一个是d、一个是D,互不相干。
- (a)
-
(a)
main.o libp.a libq.a libr.a libp.a libq.a。拉取顺序是 p1、q1、r1、p2、q2,每一步的需求都只能由排在后面的库满足,-Map开头那段证实了这个顺序:libp.a(p1.o) main.o (p1)libq.a(q1.o) libp.a(p1.o) (q1)libr.a(r1.o) libq.a(q1.o) (r1)libp.a(p2.o) libr.a(r1.o) (p2)libq.a(q2.o) libp.a(p2.o) (q2)命令行里的库必须以 p、q、r、p、q 为子序列,所以五个库已是最少。少写最后一个
libq.a,报p2.c:(.text+0x1): undefined reference to 'q2'。(b)main.o --start-group libp.a libq.a libr.a --end-group。(c)r1.c:(.text+0x1): undefined reference to 'p2'。(d) lld 下三个库各写一次、任意顺序都能链过,main.o libr.a libq.a libp.a也行。 -
- (a) 预处理:
fatal error: config.h: No such file or directory,gcc -E就会失败。 - (b) 编译:
error: implicit declaration of function 'twice'。GCC 14 起这是默认的错误,更早的 GCC 只给警告,失败会拖到链接阶段(GCC 14 Porting Guide)。 - (c) 汇编:
gcc -S能成功,汇编器报Error: operand type mismatch for 'movq'。编译器不检查内联汇编的内容,原样交给汇编器。 - (d) 链接:
undefined reference to 'twice',最后一行是collect2: error: ld returned 1 exit status,collect226 是 GCC 驱动程序调用链接器时经过的包装程序。 - (e) 加载:
Error loading shared library libfoo.so: No such file or directory (needed by ./b5),退出码 127。链接时-L.只告诉链接器去哪找,运行时 musl 的动态链接器不知道这个目录;改为LD_LIBRARY_PATH=. ./b5后程序正常返回 42。 - (f) 运行:链接成功,运行时段错误,退出码 139(128 + SIGSEGV 的 11)。
answer在可读可执行、不可写的段里,写入触发保护错误。
- (a) 预处理:
附录:术语与工具
-
Clang — Clang 是 LLVM 项目中的 C、C++ 等语言前端及驱动程序。它通常使用集成汇编器,但仍需调用链接器;最终使用哪个链接器取决于目标平台和配置。 官方文档。 ↩
-
GNU — GNU 是 “GNU’s Not Unix” 的递归缩写,指自由软件操作系统项目。GCC、binutils 和 glibc 都属于 GNU 项目,但分别承担编译、二进制处理和 C 运行库职责。 官方文档。 ↩
-
LLD — LLD 是 LLVM 项目的链接器。ELF 平台通常通过
ld.lld调用;lld-link则提供兼容 Windows 工具链的接口。它与负责处理源码的 Clang 是不同组件。 官方文档。 ↩ -
nm —
nm列出目标文件的符号。字母标记概括符号所在节或绑定等属性;需要判断准确语义时,应继续对照 ELF 符号表字段。 官方文档。 ↩ -
readelf —
readelf检查 ELF 头、节、段、符号及重定位等结构;它读取文件而不执行其中的程序。GNUreadelf与 LLVMllvm-readelf的显示格式可能不同。 官方文档。 ↩ -
ar —
ar建立和查看归档文件。静态库.a通常由多个目标文件成员组成,链接器根据未解析符号按需抽取成员。 官方文档。 ↩ -
binutils — GNU binutils 是一组处理目标文件的工具,包含汇编器
as、链接器ld,以及readelf、nm、objdump、ar等检查与归档工具。 官方文档。 ↩ -
LLVM — LLVM 是一组编译器与工具链项目的名称,包括优化基础设施、目标代码生成和相关工具。Clang、LLD 与 LLVM IR 各有职责,不能互作同义词。 官方文档。 ↩
-
musl-gcc —
musl-gcc是 GCC 的包装器,为编译和链接选择 musl 头文件、启动文件及库。它本身不意味着交叉编译;是否静态链接由-static等选项决定。 官方文档。 ↩ -
ELF — ELF(Executable and Linkable Format)规定目标文件、可执行文件与共享对象的结构。通用规则见 gABI,架构相关的调用约定和重定位规则见对应 psABI。 官方文档。 ↩
-
gABI — gABI 是通用 System V ABI,规定 ELF 等跨架构规则;psABI 是处理器相关补充,进一步规定寄存器约定、重定位编号与 TLS 等细节。 官方文档。 ↩
-
psABI — psABI(processor-specific ABI)是特定处理器架构的二进制接口约定。不同架构可以共用 ELF 文件结构,同时拥有不同的指令、调用约定和重定位公式。 官方文档。 ↩
-
PIE — PIE(position-independent executable)是可以在不同加载基址运行的可执行文件。生成 PIE 需要编译与链接选项配合;static-PIE 还需要自身的启动路径完成必要重定位。 官方文档。 ↩
-
PIC — PIC(position-independent code)使用适合位置变化的寻址方式。它常用于共享库;具体通过 PC 相对寻址还是表项间接访问,取决于架构与符号绑定。 官方文档。 ↩
-
GOT — GOT(Global Offset Table)保存供代码间接访问的地址或相关偏移。它让部分地址修补集中到数据表中;表项的具体用途由重定位类型与 ABI 决定。 官方文档。 ↩
-
glibc — glibc(GNU C Library)是许多 Linux 发行版默认使用的 C 库。库的启动文件、共享库和动态链接器共同参与程序构建与运行。 官方文档。 ↩
-
UB — UB(undefined behavior,未定义行为)表示语言标准不再对该次执行提出行为要求。观察到某次输出可以解释具体产物,却不能把它当作可移植的程序结果;链接错误
undefined reference是另一类问题。 官方文档。 ↩ ↩2 -
GCC — GCC(GNU Compiler Collection)是一组语言编译器。命令
gcc是驱动入口,会组织编译、汇编和链接;在终端调用它,并不意味着后续工作都在同一个进程里完成。 官方文档。 ↩ -
DWARF — DWARF 是调试信息格式,描述源码行、类型、变量与机器位置的关系。它可以随 ELF 保存,但不是 ELF 符号表的别名。 官方文档。 ↩
-
LTO — LTO(link-time optimization)在链接阶段协调编译器优化。它利用保留下来的中间表示跨文件分析,能力不同于仅处理本机目标文件的普通链接。 官方文档。 ↩
-
COMDAT — COMDAT 让工具链表示可供择一保留的重复定义组。ELF 通过 section group 与签名表达相关关系;选择副本时,组内关联内容需要一致处理。 官方文档。 ↩
-
ABI — ABI(Application Binary Interface)规定二进制组件如何协作,包括调用约定、数据布局和文件格式等。它约束编译结果之间的交接,比源码层面的 API 更靠近机器。 官方文档。 ↩
-
ODR — ODR(One Definition Rule)是 C++ 对定义一致性的要求。链接器选择了一个同名实例,并不能证明不同翻译单元中的定义满足语言规则。 官方文档。 ↩
-
xv6 — xv6 是 MIT 用于操作系统教学的小型 Unix 风格内核。本系列采用 RISC-V 版本,借助较小的加载器与链接脚本观察 ELF 到进程的交接。 官方文档。 ↩
-
musl — musl 是 Linux 的一种 C 标准库实现,提供
printf等库函数及运行时支持。本系列在需要分析或链接较小的静态运行库时使用它;普通 Linux 服务器不一定预装 musl。 官方文档。 ↩ -
collect2 —
collect2是 GCC 调用链接器时可能经过的辅助程序。它属于驱动调用链;诊断中出现这个名字,不代表又多了一种目标文件格式。 官方文档。 ↩