

[链接器的世界-原理篇13] ABI 演进:库升级了,旧程序怎么办
共享库升级时,真正需要兼容的对象不只是源码,还有已经发布的机器码。旧程序调用函数时使用哪些寄存器、为结构体预留多少空间、按什么偏移读取字段,都在编译时确定。替换库文件不会重新生成这些指令。
动态链接解决了运行时的文件选择与符号绑定,却没有因此验证二进制接口兼容。ABI(Application Binary Interface)描述调用双方在机器层面必须遵守的约定;即使函数名和源码声明没有改变,结构体布局的变化也可能让绑定成功的程序执行错误。
原理篇 07介绍了共享库加载和符号查找。本章在此基础上区分三个问题:什么变化破坏旧机器码的约定,SONAME 与符号版本怎样表达兼容边界,以及检查工具能发现哪些破坏、又有哪些问题必须由接口设计和语义测试判断。结构体升级的例子将先说明为什么“找到符号”远弱于“能够正确调用”。
一个能链接、能加载、结果却错了的程序
libpoint 是一个很小的库,1.0 版的头文件只有一个结构体和两个函数:
/* point1.h:libpoint 1.0 */struct point { int x; int y; };void point_init(struct point *p, int x, int y);int point_sum(const struct point *p);使用它的程序在全局放了一个数组,初始化前两个元素,打印它们的和:
/* app.c */#include <stdio.h>#include POINT_Hstruct point pts[3]; /* 第三个留作备用 */int main(void) { point_init(&pts[0], 1, 2); point_init(&pts[1], 10, 20); printf("sizeof(struct point) = %zu\n", sizeof(struct point)); printf("sum0 = %d, sum1 = %d\n", point_sum(&pts[0]), point_sum(&pts[1])); return 0;}1.1 版给结构体末尾加了一个字段 int z,point_init 把它置 0,point_sum 把它也加进去。两个函数的名字和参数声明表面上没有变化;先让这次升级继续使用原来的 soname libpoint.so.1:
/* point.c:1.0 和 1.1 共用一份源码,1.1 定义 HAVE_Z */#include POINT_Hvoid point_init(struct point *p, int x, int y) { p->x = x; p->y = y;#ifdef HAVE_Z p->z = 0; /* 新字段默认为 0 */#endif}int point_sum(const struct point *p) {#ifdef HAVE_Z return p->x + p->y + p->z;#else return p->x + p->y;#endif}新版头文件 point2.h 仍声明相同的函数,结构体定义增加 z:
/* point2.h:libpoint 1.1 */struct point { int x; int y; int z; };void point_init(struct point *p, int x, int y);int point_sum(const struct point *p);源码中的 #include POINT_H 由命令行的 -DPOINT_H 决定使用哪份头文件。先用 1.0 编译程序,再通过 LD_LIBRARY_PATH 换上 1.1;这样改变的只有运行时选到的库,程序本身保留原来的机器码。
$ mkdir -p v1 v2$ gcc -g -O1 -fPIC -shared -DPOINT_H='"point1.h"' -Wl,-soname,libpoint.so.1 point.c -o v1/libpoint.so.1$ ln -sf libpoint.so.1 v1/libpoint.so$ gcc -O1 -DPOINT_H='"point1.h"' app.c -Lv1 -lpoint -o app$ LD_LIBRARY_PATH=v1 ./appsizeof(struct point) = 8sum0 = 3, sum1 = 30$ gcc -g -O1 -fPIC -shared -DPOINT_H='"point2.h"' -DHAVE_Z -Wl,-soname,libpoint.so.1 point.c -o v2/libpoint.so.1$ LD_LIBRARY_PATH=v2 ./appsizeof(struct point) = 8sum0 = 13, sum1 = 30程序照常启动,没有任何警告,sum0 却从 3 变成了 13。用新头文件重新编译一次,结果又对了:
$ ln -sf libpoint.so.1 v2/libpoint.so$ gcc -O1 -DPOINT_H='"point2.h"' app.c -Lv2 -lpoint -o app_new$ LD_LIBRARY_PATH=v2 ./app_newsizeof(struct point) = 12sum0 = 3, sum1 = 30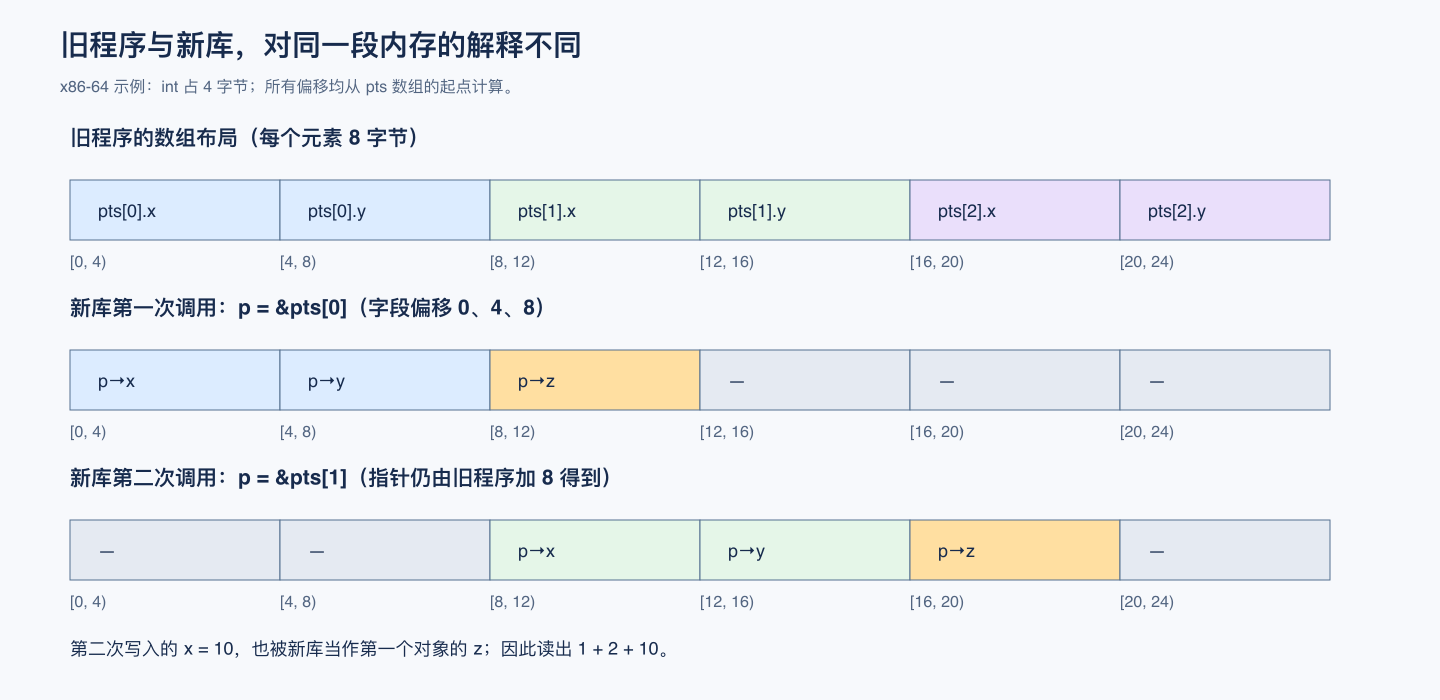
13 是这样来的。旧程序编译时认为 struct point 占 8 字节,pts[1] 从偏移 8 开始。新库的 point_init 认为它占 12 字节,往 &pts[0] 偏移 8 的地方写 z = 0,那里正是 pts[1].x。接着第二次调用把 pts[1].x 写成 10,于是新库读 pts[0] 的 z 读到了 10,1 + 2 + 10 = 13。pts[1] 的 z 落在备用的 pts[2] 上,它是 0,所以 sum1 碰巧还对。没有那个备用元素,第二次初始化还会越过数组边界,具体破坏什么取决于布局。这个类型与布局已经不一致的组合不满足正确 C 程序的要求;这里解释的是本例机器码的实测结果,不是语言标准保证的输出。
查看依赖和动态符号表,可以解释为什么这次绑定没有因名字不匹配而失败:
$ readelf -d app | grep NEEDED 0x0000000000000001 (NEEDED) Shared library: [libpoint.so.1] 0x0000000000000001 (NEEDED) Shared library: [libc.so.6]$ readelf --dyn-syms -W v2/libpoint.so.1 | grep point_ 5: 00000000000010f9 17 FUNC GLOBAL DEFAULT 9 point_init 6: 000000000000110a 13 FUNC GLOBAL DEFAULT 9 point_sumDT_NEEDED 要一个叫 libpoint.so.1 的文件,找到了;程序引用 point_init 和 point_sum 两个名字,库里有,绑定完成。.dynsym 里每个符号只有名字、地址、大小、类型(这里的类型是 FUNC 或 OBJECT 这一级,不是 C 的类型)和绑定属性,没有参数列表,也没有结构体布局。第 3 章讲过静态链接器不检查类型,一个文件里的 int x 能和另一个文件里的 double x 配上;动态链接是同一回事,只是两边的编译时间相隔了一次版本升级。sizeof(struct point) 这个 8 是编译器算好写进 app 机器码里的常数,库换了,这个数不会跟着变。
所以这一章的问题是:库要升级,旧程序又不能重新编译,哪些东西不能动,必须动的时候怎么办?
ABI 是什么
API(应用程序编程接口)是写在源码层面的约定:头文件里声明了哪些函数、类型和宏,文档说它们做什么。ABI(应用程序二进制接口,第 1 章提过这个词)是同一份约定编译之后的样子:机器码按什么规矩调用一个函数、一个结构体在内存里怎么摆、库导出了哪些符号。API 兼容要求旧源码使用新接口重新构建后仍满足原有接口约定,编译通过只是其中一项;ABI 兼容意味着旧的二进制不重新编译,直接换上新库还能正确运行。上一节的 app.c 使用新头文件重新编译后可以得到正确结果,但原二进制不能直接换库。这个具体程序的源码兼容,不足以保证所有使用 struct point 的程序都源码兼容,例如写死大小或将结构体直接作为文件格式的代码仍需另查。
Ulrich Drepper 在《How To Write Shared Libraries》(下文简称 dsohowto,引用的是 2011 年的 4.1.2 版)第 3 章"Maintaining APIs and ABIs"里给共享库的 ABI 下了一个定义:"The ABI of the DSO comprises the collection of all the definitions which were available for use during the lifetime of the DSO."(共享库的 ABI 是它整个生命周期里所有曾经可供使用的定义的集合。)DSO 是 dynamic shared object 的缩写,就是共享库。"整个生命周期"这几个字很重:一个符号一旦导出,就可能有程序依赖它;承诺兼容那些程序的后续版本需要继续满足相应约定,或明确改变兼容边界。接着他说,这只是容易的那一半:变量的大小和结构不能变成程序处理不了的样子,函数文档里写明的语义不能变。
把 ABI 拆开看,大致有四层。
第一层是调用约定:参数放在哪些寄存器或栈槽、返回值放在哪里、哪些寄存器由被调用者保存。本章 x86-64 System V ABI 的普通整数与指针参数依次使用 rdi、rsi、rdx、rcx、r8、r9;浮点、聚合类型和变参另有分配规则。库作者若把一个整数参数改成两个,旧调用方不会按新签名准备 rsi,新实现读到的便不是一个受接口保证的第二参数。这一层错配在成功解析函数名之后才暴露。
第二层是数据布局:结构体的大小、每个字段的偏移和对齐、枚举常量的值。上一节的故障出在这一层。
第三层是符号:导出了哪些名字,每个名字挂在哪个版本上。这是链接器和 ld.so 能直接检查的接口身份;它们还检查文件格式、重定位和平台属性等,但不会据此证明源码类型与语义兼容。后面几节主要围绕它展开。
第四层是语义:函数做什么、遇到边界情况返回什么。Drepper 用 strtok 举例:第一次调用传 NULL 是UB1,有的实现返回 NULL,有的实现会崩溃,两种都合法,但库在生命周期中途从一种换成另一种,依赖旧行为的程序就会出问题。他的结论是,稳定性应当以文档写明的接口为准,按未定义的方式使用接口的程序不在保证之内;文档写明的行为要改,就得用后面讲的符号版本。
下表列出常见的改动在源码和二进制两方面的后果。"源码兼容"指旧源码用新头文件能编译并且行为正确,"二进制兼容"指旧二进制不重新编译、直接换上新库能正确运行。
| 改动 | 源码兼容 | 二进制兼容 | 说明 |
|---|---|---|---|
| 增加导出函数 | 是 | 是(单向) | 旧程序不受影响;新程序拿到旧库上会缺符号 |
| 删除导出函数 | 否 | 否 | 旧程序启动或调用时报 undefined symbol(练习三) |
| C 函数加一个参数 | 否 | 否 | 名字没变,链接和加载都通过,参数按调用约定传错 |
| 结构体加字段 | 视使用方式 | 视使用方式 | 调用方自行分配对象、依赖大小或布局时可能不兼容;真正不透明且由库管理的对象可以保留扩展空间 |
| enum 中间插入常量 | 视语义依赖 | 通常不兼容 | 未显式固定的后续枚举值会变化;显式保持数值可避免这类错配 |
| enum 末尾追加常量 | 通常是 | 视表示范围和协议 | 需保持已有值与底层表示,并检查旧程序如何处理新增值 |
| 改头文件里的内联函数或宏 | 视改动 | 视改动 | 旧实现可能已编译进调用方;若它必须与库内新实现同步,就会不兼容 |
| C++ 改默认参数 | 是 | 是 | 旧程序仍用编译时填入的旧默认值,新默认值要重新编译才生效 |
| C++ 增加、删除或重排虚函数 | 视改动 | 有破坏风险 | 槽位、派生类实现与对象布局都可能受影响;不能视作普通追加函数 |
| C++ 改函数参数类型 | 视情况 | 否 | 修饰名变了,旧程序找不到符号(第 14 章) |
默认参数那一行的依据是 KDE 的 C++ 二进制兼容政策,它把这一条放在"可以做"的清单里,并注明"It requires recompilation to use the actual new default argument values":默认值由调用方在编译时填上,换库不影响旧程序,只是旧程序看不到新默认值。
最后一行和 C 不同。Drepper 指出,C++ 的函数名经过名字修饰(mangling,编译器把参数类型编码进符号名),签名一变符号名就变,旧程序会在链接或加载时报错,问题能被发现;变量的修饰名只含名字空间,不含类型,所以他建议不要把变量放进 API。名字修饰是第 14 章的内容。
表里挑三类做实验:enum、内联函数和虚函数表。三个库都用同一个 soname 编出 1.0 和 1.1 两份,程序只按 1.0 编译一次。
enum 的 1.1 版在 RED 和 GREEN 之间插了一个 YELLOW:
/* color.h */enum color { RED,#ifdef V2 YELLOW,#endif GREEN, BLUE };const char *color_name(enum color c);$ gcc -O1 color_app.c v1/libcolor.so.1 -o color_app$ LD_LIBRARY_PATH=v1 ./color_appGREEN -> green$ LD_LIBRARY_PATH=v2 ./color_appGREEN -> yellowGREEN 在旧程序里被编译成了常数 1,新库里 1 是 YELLOW。
内联函数的例子是一张小散列表。库负责按散列值把数据放进槽位,散列函数作为 static inline 写在头文件里,方便使用者自己算槽位;1.1 版换了一个散列函数:
/* tab.h */#define TAB_SIZE 8static inline unsigned tab_hash(const char *s) { unsigned h = 0;#ifdef V2 while (*s) h = (h * 33) ^ (unsigned char)*s++;#else while (*s) h = h * 31 + (unsigned char)*s++;#endif return h % TAB_SIZE;}void tab_put(const char *key, int val); /* 库里按 tab_hash 放进槽位 */int tab_slot(unsigned slot); /* 读一个槽位 */$ LD_LIBRARY_PATH=v1 ./tab_appapple -> slot 2 -> 7$ LD_LIBRARY_PATH=v2 ./tab_appapple -> slot 2 -> 0$ nm -D tab_app | grep tab_ U tab_put U tab_slottab_app 的动态符号只有 tab_put 和 tab_slot,没有 tab_hash:散列循环已经内联进了调用者。新库按新散列把 7 放进另一个槽,旧程序仍按旧算法去 2 号槽取值。这个已经固化在调用方机器码中的算法,不会因为换共享库而重新编译。
C++ 的例子在 area() 前面加了一个虚函数 perimeter():
// shape.hstruct Shape {#ifdef V2 virtual int perimeter() const;#endif virtual int area() const; virtual ~Shape(); int side;};Shape *make_square(int side);$ g++ -O1 shape_app.cc v1/libshape.so.1 -o shape_app$ LD_LIBRARY_PATH=v1 ./shape_apparea = 9$ LD_LIBRARY_PATH=v2 ./shape_apparea = 12$ objdump -d --no-show-raw-insn -C shape_app | sed -n '/<main>:/,/ret/p' ... 1178: mov %rax,%rbx 117b: mov (%rax),%rax 117e: mov %rbx,%rdi 1181: call *(%rax) ... 11a0: mov (%rbx),%rax 11a3: mov %rbx,%rdi 11a6: call *0x10(%rax)对象指针保存在 rbx,第一处从对象开头取出虚表指针,再通过表中第 0 项间接调用。旧程序认定该项是 area,新库却把 perimeter 插在前面,于是边长 3 的正方形得到“面积”12。这条调用已经按槽位编译好,动态加载器不会为它重新查 area 的名字。
delete s 的调用偏移为 0x10,即第 2 项。虚表中的动态重定位进一步说明槽位变化:
# v1,按槽位列出 R_X86_64_64 的目标0x3dd8 -> _ZNK5Shape4areaEv0x3de0 -> _ZN5ShapeD1Ev0x3de8 -> _ZN5ShapeD0Ev# v20x3dd0 -> _ZNK5Shape9perimeterEv0x3dd8 -> _ZNK5Shape4areaEv0x3de0 -> _ZN5ShapeD1Ev0x3de8 -> _ZN5ShapeD0Ev一个虚析构函数在虚表里占两项:D1 只析构对象,D0 析构之后再调用 operator delete 释放内存,delete s 调的是 D0。1.0 的第 2 项是 D0,1.1 的第 2 项变成了 D1。换一个程序 shape_leak.cc 验证:它做同样的 area() 加 delete s,同时在程序里定义全局的 operator new 和 operator delete 来计数,库里对它们的调用会按第 7 章的符号插入落到程序的定义上:
$ g++ -O1 shape_leak.cc v1/libshape.so.1 -o shape_leak$ LD_LIBRARY_PATH=v1 ./shape_leakarea = 9, operator new 1, operator delete 1$ LD_LIBRARY_PATH=v2 ./shape_leakarea = 12, operator new 1, operator delete 0换上 1.1 之后,每个 Shape 都不再被释放,这个泄漏不会有任何输出。
三个例子的共同点是:出错的信息,即常数 1、散列算法、槽位 0,都在编译时写进了旧程序的机器码。名字一样、版本一样,库就会被接受。这类改动需要明确的兼容策略:保持原约定,提供能继续满足旧约定的兼容接口,或用新 soname 将不兼容的一代区分开。单纯保留函数名无法修复调用方已经固化的布局。
soname 策略
第 7 章讲过,链接器把被链接库的 SONAME 写进程序的 DT_NEEDED,ld.so 按这个名字找文件。Drepper 把这叫作最老、最粗的一种 ABI 版本化办法:每做一次不兼容的改动就换一个文件名,新旧两个库可以同时装在系统里,旧程序找旧名字,新程序找新名字。它的好处是到处都能用,只要有 DT_SONAME 就行。
三个名字
先区分构建时选库和运行时找库。-Llib -lpoint 让静态链接器在 lib 中寻找可用输入;它打开共享库以后,读出库内的 DT_SONAME,并把这个名字写进新程序的 DT_NEEDED。后续启动时,动态加载器读取的是已经存进程序的依赖名,不会重新执行那条 -lpoint 命令。
| 名字 | 在哪里 | 主要用途 |
|---|---|---|
| libpoint.so.1.0.0 | 磁盘上的真实文件 | 保存这一份库实现 |
| libpoint.so.1 | 库的 DT_SONAME;通常也有同名磁盘链接 | 成为客户端运行时请求的依赖名 |
| libpoint.so | 通常是开发用磁盘链接 | 让新构建的 -lpoint 选择某一代输入 |
DT_SONAME 是 ELF 内的字符串,符号链接是文件系统里的路径关系,两者不是同一个东西。它们保持一致是一种安装安排。只改磁盘文件名不会自动改掉 ELF 内的 SONAME;只改开发链接也不会改掉旧程序里的 DT_NEEDED。
一个按惯例安装的共享库在磁盘上有三个名字。拿 libpoint 的两个主版本来看,1.0 的 soname 是 libpoint.so.1,不兼容的 2.0(就是开头加了 z 字段那份,这次老老实实换了 soname)是 libpoint.so.2:
$ gcc -O1 -fPIC -shared -DPOINT_H='"point1.h"' -Wl,-soname,libpoint.so.1 point.c -o lib/libpoint.so.1.0.0$ gcc -O1 -fPIC -shared -DPOINT_H='"point2.h"' -DHAVE_Z -Wl,-soname,libpoint.so.2 point.c -o lib/libpoint.so.2.0.0$ ldconfig -n -v liblib: (from <cmdline>:0) libpoint.so.1 -> libpoint.so.1.0.0 (changed) libpoint.so.2 -> libpoint.so.2.0.0 (changed)真实文件名 libpoint.so.1.0.0 带着完整的版本号,可以随每次发布变化。ldconfig 读出每个文件的 SONAME,建立以 soname 命名的符号链接,这是运行时 ld.so 要找的名字。第三个名字是不带版本号的 libpoint.so,只在链接时给 -lpoint 用,它指向哪个主版本,新编译的程序就用哪个。先让它指向 1,编出 app1;再改指 2,用新头文件编出 app2:
$ ln -sf libpoint.so.1 lib/libpoint.so$ gcc -O1 -DPOINT_H='"point1.h"' app.c -Llib -lpoint -Wl,-rpath,$W/soname/lib -o app1$ ln -sf libpoint.so.2 lib/libpoint.so$ gcc -O1 -DPOINT_H='"point2.h"' app.c -Llib -lpoint -Wl,-rpath,$W/soname/lib -o app2$ ls -l liblrwxr-xr-x libpoint.so -> libpoint.so.2lrwxr-xr-x libpoint.so.1 -> libpoint.so.1.0.0-rwxr-xr-x libpoint.so.1.0.0lrwxr-xr-x libpoint.so.2 -> libpoint.so.2.0.0-rwxr-xr-x libpoint.so.2.0.0$ readelf -d app1 | grep NEEDED | head -1 0x0000000000000001 (NEEDED) Shared library: [libpoint.so.1]$ readelf -d app2 | grep NEEDED | head -1 0x0000000000000001 (NEEDED) Shared library: [libpoint.so.2]$ ./app1; ./app2sizeof(struct point) = 8sum0 = 3, sum1 = 30sizeof(struct point) = 12sum0 = 3, sum1 = 30$ LD_DEBUG=libs ./app1 2>&1 | grep 'trying file=.*libpoint' | tail -1 664: trying file=$W/soname/lib/libpoint.so.1$ LD_DEBUG=libs ./app2 2>&1 | grep 'trying file=.*libpoint' | tail -1 666: trying file=$W/soname/lib/libpoint.so.2两个程序在同一个目录里各自加载了自己那一代的库,结果都对。
libtool 的 current:revision
真实文件名后面那串数字由谁决定?很多 C 项目用 GNU libtool 构建共享库,它不让作者直接写 soname,而是要三个整数 current:revision:age,从中算出 soname 和文件名。libtool 手册的版本化规则用接口代数解释它们:
把库的每一代接口编上号,current 是这个库实现的最新一代接口的编号,revision 是这一代接口的第几次实现(只修 bug、不动接口时加它),age 表示库还同时兼容往前多少代接口,所以它支持的接口编号是 current - age 到 current 这个区间。
每次发布前按改动更新三个数:源码改了就加 revision;接口有增删改就加 current 并把 revision 清零;只是增加就加 age,表示仍然兼容旧接口;有删除或修改就把 age 清零,表示和旧接口断了。
在 Linux 上,libtool 把这三个数换算成 soname lib名字.so.(current−age),文件名 lib名字.so.(current−age).age.revision。下面使用本章 Linux 工具链的 libtool 2.5.4:
$ libtool --mode=compile gcc -O1 -c demo.c$ libtool --mode=link gcc -o libdemo.la demo.lo -rpath /usr/local/lib -version-info 3:1:2$ ls .libs | grep '^libdemo.so'libdemo.solibdemo.so.1libdemo.so.1.2.1$ readelf -d .libs/libdemo.so | grep SONAME 0x000000000000000e (SONAME) Library soname: [libdemo.so.1]换几组值,结果如下(命令相同,只改 -version-info):
-version-info 0:0:0 -> libdemo.so.0.0.0 soname libdemo.so.0-version-info 1:0:1 -> libdemo.so.0.1.0 soname libdemo.so.0-version-info 1:1:1 -> libdemo.so.0.1.1 soname libdemo.so.0-version-info 2:0:0 -> libdemo.so.2.0.0 soname libdemo.so.2-version-info 3:1:2 -> libdemo.so.1.2.1 soname libdemo.so.1从 0:0:0 到 1:0:1 是增加了接口,soname 不变;1:1:1 只修了 bug;2:0:0 删了或改了接口,soname 从 .0 跳到 .2,跳过了 1,因为 soname 的数字是 current − age,并不是"第几个主版本"。最后一行是另一个独立的例子:3:1:2 表示库实现了 1 到 3 号接口,soname 是 .1,和 current 的 3 对不上。libtool 用这套与平台无关的编号,再按各平台的规则换算成各自的版本号,读起来不直观,手册专门警告不要让它跟着软件的发行版本号走:"Never try to set the interface numbers so that they correspond to the release number of your package."
什么时候升主版本号
规则可以从上一节的表直接推出来:只要有一个改动在"二进制兼容"那一栏是"否",又没有办法用下一节的符号版本把旧行为留给旧程序,就必须换 soname,用 libtool 的说法是把 age 清零。只增加接口时不换,这正是 age 存在的意义。
Drepper 也指出了换 soname 的代价。每次不兼容的改动都要换名字,系统里会堆积许多只差一点点的库;更糟的是,一个进程可能通过两个不同的依赖同时加载 libpoint.so.1 和 libpoint.so.2,它们导出同名的 point_init,按第 7 章的查找规则先找到的那个胜出,两份库互不知情,结果难以预料。他的判断是,唯一安全的做法是避免这种局面,而这几乎意味着所有二进制要一起更新,版本化也就形同虚设。
Debian 的包名为什么带 soname
运行时包需要让不兼容的两代库并存,因此包名通常随 SONAME 的主版本变化。这个约定并不表示包名必须与文件名机械相同:发行版迁移还可能增加后缀。当前 Ubuntu 的实际包是 libssl3t64,开发包是 libssl-dev:
apt-get download libssl3t64 libssl-devdpkg -c libssl3t64_*.deb | grep 'libssl\.so'dpkg -c libssl-dev_*.deb | grep 'libssl\.so'同机 dpkg-query -S 的另外三个结果是 libstdc++6:amd64 → libstdc++.so.6、libc6:amd64 → libc.so.6、libabigail8:amd64 → libabigail.so.8。应查询当前包的实际内容,不能沿用另一个发行版旧版本的包名来猜路径。
glibc 长期沿用 libc.so.6,并不表示内部从未做过不兼容改动;它还利用下面的符号版本机制保留旧接口。
符号版本的实践
SONAME 先决定装入哪份库;版本需求再给这份库中的符号加上约束。parse_num@VERS_1 与 parse_num@@VERS_2 可以共享函数的基本名字,但表示两份约定。@@ 指定新建普通引用的默认选择,单个 @ 的兼容实现仍可被显式版本引用使用。这些名字是发布者约定的标签,加载器不从字符串里的数字推断结构体或函数签名。
| 记录 | 解决的问题 | 索引怎样使用 |
|---|---|---|
| .dynsym | 动态符号的名字、定义或未定义状态 | 本文件中的符号序号 j |
| .gnu.version | 每个动态符号关联哪个版本 | 第 j 个 2 字节项与 .dynsym[j] 对应 |
| .gnu.version_d | 本文件定义的版本节点 | 在定义记录中找 vd_ndx 对应的编号及名称 |
| .gnu.version_r | 本文件向其他库请求的版本 | 在需求记录中找对应编号、版本名与库名 |
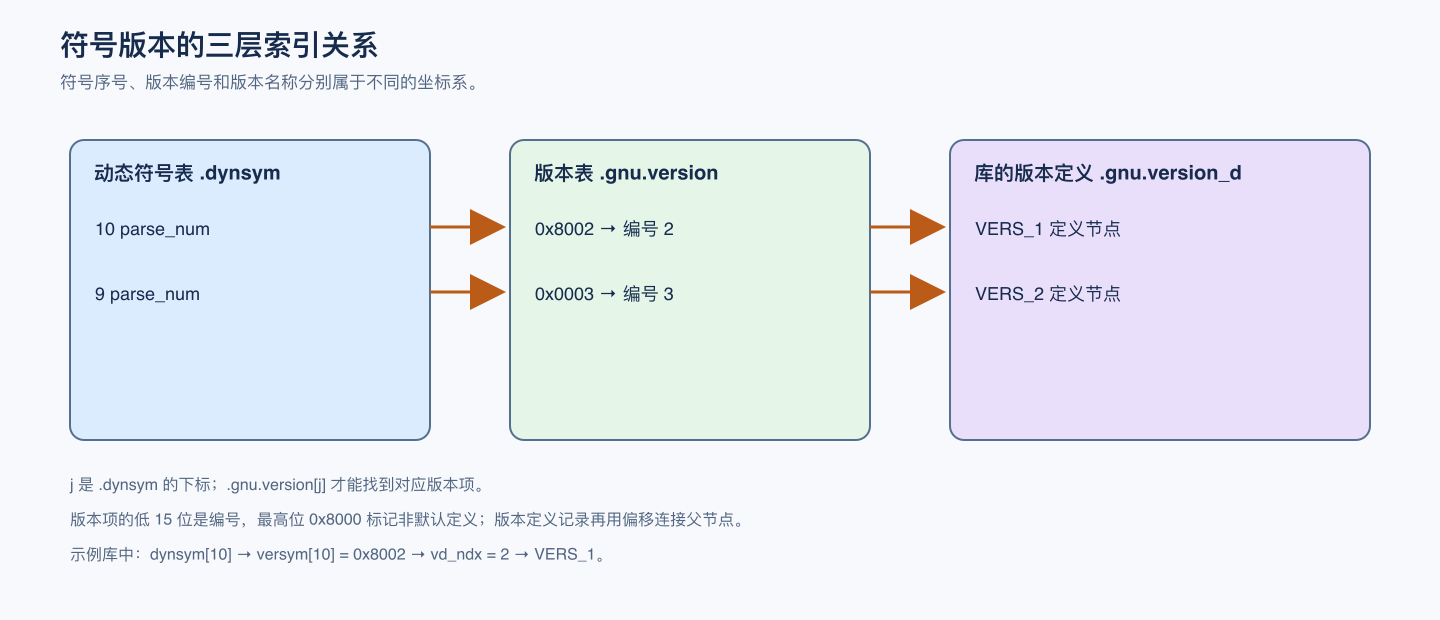
符号序号和版本编号是两套数。.gnu.version 的 2 字节项中,低 15 位才是编号,最高位是另一个版本标志。版本定义区也不是“编号 × 固定长度”的数组;记录通过偏移连接。跨文件匹配使用版本名称等元数据,不要求客户端与库碰巧分配了相同编号。后面的旧客户端将 VERS_1 编为 4,而库将它编为 2,它们仍描述同一个版本名。glibc 的版本检查先比较名称哈希,再比较名称字符串。
图使用后面 libparse 输出中的实际编号。parse_num@VERS_1 是 .dynsym[10];其版本项位于 .gnu.version 起点之后 10 × 2 = 20 字节处。在 x86-64 的 little-endian 编码中,两个字节 02 80 表示 0x8002,掩去 0x8000 后得到定义编号 2,即 VERS_1。另一个定义 .dynsym[9] 的字节为 03 00,得到编号 3,即默认版本 VERS_2。高位标志属于版本项,不是 ELF 符号的 STV_HIDDEN 可见性字段。
客户端沿另一条关系查找:旧程序的 .dynsym[5] 引用 parse_num,版本项给出本文件编号 4;.gnu.version_r 将 4 解释成 libparse.so.1 的 VERS_1 需求。库用编号 2 表示相同版本名。加载器并不是比较 4 == 2,而是先解码各自的记录,再验证所请求的版本名与定义是否匹配。这里跟踪的是带明确版本需求的引用;无版本引用和 dlsym 还涉及后文的兼容选择规则。
第 7 章已经展示了符号版本的机制:版本脚本给符号分组命名,.gnu.version、.gnu.version_d、.gnu.version_r 三个节分别记录每个符号的版本、库定义了哪些版本、程序需要哪些版本,@@ 是默认版本,@ 表示非默认版本,常用于保留兼容接口,也可以被显式带版本的引用请求。Drepper 在 dsohowto 第 3.3 节把它和 Solaris 的做法做了对比。Solaris 先引入了库内部的版本:每个符号挂一个版本,版本之间组成一张无环的继承图,程序记下它需要哪些版本,ld.so 启动时检查库是否都提供。这能处理兼容的改动。GNU 的扩展多做了两件事:同一个符号可以有多个定义,各挂一个不同的版本;程序不只记录需要哪些版本,还给每个引用的符号记下它绑定的是哪个版本。有了这两点,不兼容的改动也可以不换 soname。
这一节用一个函数走一遍完整的演进过程。libparse 1 版只有一个函数:
/* parse1.c:遇到非数字就停下,什么都没读到时返回 0 */int parse_num(const char *s) { int v = 0; while (*s >= '0' && *s <= '9') v = v * 10 + (*s++ - '0'); return v;}Drepper 建议共享库从第一天起就带版本脚本,哪怕暂时只有一个版本,因为以后的不兼容改动要靠这个版本名来区分:
/* parse1.map */VERS_1 { global: parse_num; local: *;};到了 2 版,作者想让 parse_num("abc") 返回 −1,好和 parse_num("0") 区分开,同时加一个能指定进制的 parse_num_base。改返回值是语义变化,按前面那张表属于不兼容改动;有了符号版本,可以把旧语义留给旧程序。
两个实现和继承的版本节点
/* parse2.c(节选) *//* 旧实现:名字随便起,用 .symver 挂到 parse_num@VERS_1 */int parse_num_v1(const char *s) { int v; digits(s, 10, &v); return v; }__asm__(".symver parse_num_v1, parse_num@VERS_1");
/* 新实现:用 GCC 10 起支持的 symver 属性挂到默认版本 */__attribute__((symver("parse_num@@VERS_2")))int parse_num_v2(const char *s) { int v; return digits(s, 10, &v) ? v : -1; }
/* 新函数只出现在 VERS_2 */int parse_num_base(const char *s, int base) { int v; return digits(s, base, &v) ? v : -1; }digits 是两个实现共用的内部函数,返回读到的数字个数。第 7 章用的是汇编伪指令 .symver,这里两种写法各用了一次。__attribute__((symver(...))) 是 GCC 10 加入的函数属性,GCC 10 的发布说明解释了为什么要它:内联汇编里的 .symver 和链接期优化(LTO2)不兼容。第 12 章讲过,LTO 下目标文件里装的是 IR3,编译器在链接时才重新生成代码,内联汇编里那行字对优化器来说是一段看不懂的文本,属性则是编译器自己认识的东西。
版本脚本也要跟着改:
/* parse2.map */VERS_1 { global: parse_num; local: *;};VERS_2 { global: parse_num; parse_num_base;} VERS_1;Drepper 在第 3.5 节逐条说明了这份文件的写法:parse_num 在两个节点里都出现,因为它有两个定义;parse_num_base 只在 VERS_2 里;local: *; 只写在第一个节点里;VERS_2 的定义末尾写上了 VERS_1。最后这一点就是版本节点的继承,读作"VERS_2 的前驱是 VERS_1",链接结果里能看到它:
$ gcc -O1 -fPIC -shared -Wl,-soname,libparse.so.1 -Wl,--version-script=parse2.map parse2.c -o v2/libparse.so.1$ readelf --dyn-syms -W v2/libparse.so.1 | grep parse_ 7: 000000000000124e 75 FUNC GLOBAL DEFAULT 14 parse_num_base@@VERS_2 10: 00000000000011b9 69 FUNC GLOBAL DEFAULT 14 parse_num@VERS_1 9: 00000000000011fe 80 FUNC GLOBAL DEFAULT 14 parse_num@@VERS_2$ readelf -V v2/libparse.so.1 | sed -n '/version_d/,$p'Version definition section '.gnu.version_d' contains 3 entries: Addr: 0x00000000000004e8 Offset: 0x000004e8 Link: 4 (.dynstr) 000000: Rev: 1 Flags: BASE Index: 1 Cnt: 1 Name: libparse.so.1 0x001c: Rev: 1 Flags: none Index: 2 Cnt: 1 Name: VERS_1 0x0038: Rev: 1 Flags: none Index: 3 Cnt: 2 Name: VERS_2 0x0054: Parent 1: VERS_1VERS_2 那一项的 Cnt: 2 表示它挂了两个名字,第一个是它自己,第二个是父节点 VERS_1。在 GNU 的模型里这条继承关系基本不起作用:Drepper 说它"is not really important in symbol versioning",写上是为了和 Solaris 的版本模型保持一致,也方便人读。在 Solaris 的模型里它是有用的:一个符号兼容地扩展了功能,就从老节点挪进新节点。用 Drepper 书里的例子,旧程序要 index@VERS_1,新库里只有 index@VERS_2,ld.so 沿着前驱一路往回找,找到 VERS_1 就算匹配。两种模型共同的一条规矩是,版本名和符号一样,发布了就不能删。练习三会故意违反它。
旧程序绑旧的,新程序绑新的
旧程序在 1 版上链接,新程序在 2 版上链接,源码是同一个 app.c:
$ gcc -O1 app.c -Lv1 -lparse -o app_old$ gcc -O1 app.c -Lv2 -lparse -o app_new$ readelf --dyn-syms -W app_old | grep parse_num 5: 0000000000000000 0 FUNC GLOBAL DEFAULT UND parse_num@VERS_1 (4)$ readelf --dyn-syms -W app_new | grep parse_num 3: 0000000000000000 0 FUNC GLOBAL DEFAULT UND parse_num@VERS_2 (3)$ readelf -V app_new | sed -n '/version_r/,$p'Version needs section '.gnu.version_r' contains 2 entries: Addr: 0x0000000000000548 Offset: 0x00000548 Link: 5 (.dynstr) 000000: Version: 1 File: libparse.so.1 Cnt: 1 0x0010: Name: VERS_2 Flags: none Version: 3 0x0020: Version: 1 File: libc.so.6 Cnt: 3 0x0030: Name: GLIBC_2.2.5 Flags: none Version: 5 0x0040: Name: GLIBC_2.3.4 Flags: none Version: 4 0x0050: Name: GLIBC_2.34 Flags: none Version: 2app.c 对 parse_num 的引用没有显式指定版本,因此在 2 版库上链接时选择默认的 parse_num@@VERS_2,并把这个版本需求记进可执行文件。parse_num@VERS_1 仍可满足显式请求旧版本的引用;后面的 fmemopen 实验就会在新编译的程序中这样使用它。默认选择与显式版本引用是两条路径,不能说静态链接器从不考虑 @ 定义。GNU ld 的版本脚本文档说明了多版本定义及默认版本的用法。
显式选择旧版本并不要求使用一个早已编译好的程序。下面这个新源码把 parse_old 的引用指定为 parse_num@VERS_1:
#include <stdio.h>extern int parse_old(const char *s);__asm__(".symver parse_old,parse_num@VERS_1");int main(void) { printf("explicit old: %d\n", parse_old("abc")); return 0;}$ gcc explicit-old.c -Lv2 -lparse -o explicit-old$ LD_LIBRARY_PATH=v2 ./explicit-oldexplicit old: 0名字 parse_old 只供 C 源码使用,.symver 把它关联到库中的版本化符号;最终并不需要库导出一个叫 parse_old 的函数。这个实验验证的是显式版本请求,不改变普通 parse_num 引用选择默认版本的规则。
两个程序都放到 2 版库上运行:
$ LD_LIBRARY_PATH=v2 ./app_oldparse_num("42") = 42, parse_num("abc") = 0$ LD_LIBRARY_PATH=v2 ./app_newparse_num("42") = 42, parse_num("abc") = -1$ LD_DEBUG=bindings LD_LIBRARY_PATH=v2 ./app_old 2>&1 | grep "symbol \`parse_num" 45: binding file ./app_old [0] to v2/libparse.so.1 [0]: normal symbol `parse_num' [VERS_1]$ LD_DEBUG=bindings LD_LIBRARY_PATH=v2 ./app_new 2>&1 | grep "symbol \`parse_num" 47: binding file ./app_new [0] to v2/libparse.so.1 [0]: normal symbol `parse_num' [VERS_2]同一个库、同一个名字,两个程序各拿到了自己编译时看到的那个语义。反过来,把新程序放到只有 1 版库的机器上:
$ LD_LIBRARY_PATH=v1 ./app_new./app_new: v1/libparse.so.1: version `VERS_2' not found (required by ./app_new)程序在 main 之前就停下了。Drepper 在第 3.2 节讨论过这种情形:只增加接口不会影响旧程序,但新程序遇上旧库会缺符号;不加版本时,惰性绑定(第 7 章)要等到第一次调用才发现,用户可以设 LD_BIND_NOW 让 ld.so 启动时就做完所有重定位来提前暴露它,但这样启动慢,他的结论是动态链接器应当不做重定位就认出旧库。第 3.3 节给出了做法:版本的数量远少于符号,ld.so 启动时拿程序列出的需求版本(这里是 .gnu.version_r)和库定义的版本(.gnu.version_d)对一遍就知道,代价很小。
glibc:memcpy 与 fmemopen
同名符号的不同版本不一定对应不同地址:有时只是兼容别名,有时确实保留了不同实现。直接查看本机 glibc 2.43:
readelf --dyn-syms -W /lib/x86_64-linux-gnu/libc.so.6 | grep -E ' (memcpy|memmove|fmemopen|pthread_create|__libc_start_main)@'以下省略符号编号和节编号,只列出地址、类型、名字:
0x0b9600 IFUNC memmove@@GLIBC_2.2.50x0c22f0 FUNC memcpy@GLIBC_2.2.50x0b8c80 IFUNC memcpy@@GLIBC_2.140x097fe0 FUNC fmemopen@@GLIBC_2.220x0983f0 FUNC fmemopen@GLIBC_2.2.50x0a4050 FUNC pthread_create@GLIBC_2.2.50x0a4050 FUNC pthread_create@@GLIBC_2.340x02a690 FUNC __libc_start_main@GLIBC_2.2.50x02a690 FUNC __libc_start_main@@GLIBC_2.34第 7 章讨论过 memcpy 对重叠区间的历史兼容问题。新默认版本是 2.14,旧程序可继续绑定 2.2.5;保留旧版本承诺,并不一定要保留最初那段机器码。glibc 的 x86-64 兼容源码将旧 memcpy 名字连到能处理重叠区间的实现,修复的是既有二进制的行为依赖,C 接口仍要求重叠时使用 memmove。
pthread_create 两个版本在本机指向同一地址;2.34 合并 libpthread 后增加了新的默认版本。__libc_start_main 的双版本也同址,但它的版本变化与启动代码传递初始化信息的新约定有关。名字版本表达的是可兼容的接口身份,不是“代码地址一定不同”。
fmemopen 则保留两份实现。旧实现拒绝长度 0,新实现接受;使用本章 glibc/fm.c:
#define _GNU_SOURCE#include <errno.h>#include <stdio.h>#include <string.h>#ifdef OLD__asm__(".symver fmemopen, fmemopen@GLIBC_2.2.5");#endifint main(void) { char buf[1]; FILE *f = fmemopen(buf, 0, "r"); printf("fmemopen(buf, 0, \"r\") = %s (%s)\n", f ? "FILE*" : "NULL", f ? "ok" : strerror(errno)); return 0;}$ gcc -O1 fm.c -o fm_new$ gcc -O1 -DOLD fm.c -o fm_old$ objdump -T fm_new fm_old | grep fmemopen... (GLIBC_2.22) fmemopen... (GLIBC_2.2.5) fmemopen$ ./fm_new; ./fm_oldfmemopen(buf, 0, "r") = FILE* (ok)fmemopen(buf, 0, "r") = NULL (Invalid argument)这里的 .symver 位于引用方,不是在实现一个函数,而是在指定本文件引用哪个已有版本。版本名有架构边界:AArch64 的 glibc 移植起点为 2.17,不能把本例 x86-64 的 2.2.5 字符串照搬到该架构。主线统一 x86-64,正是为了避免这种混用。
在新系统上编译,到旧系统上跑不了
glibc/th.c 使用 pthread_create 和 pthread_join。在本机编译后,objdump -T th 显示三个主要需求:
GLIBC_2.34 __libc_start_mainGLIBC_2.34 pthread_createGLIBC_2.34 pthread_join还有栈保护、格式化输出等引用。用 .symver 只把 pthread_create 固定为 2.2.5 后,另外两个 2.34 需求仍在。__libc_start_main 来自 Scrt1.o,不在自己的源文件里,所以修一个函数引用并不能降低整个程序的运行基线。
S="$W/sysroot-el7""$S/lib64/ld-linux-x86-64.so.2" \ --library-path "$S/lib64:$S/usr/lib64" ./th同一个 Linux 内核上,旧加载器报告 GLIBC_2.34 not found,退出码 1;固定过 pthread_create 的 th_pin 也一样失败。只改变 fmemopen 版本的 fm_old 同样因为启动代码的 2.34 需求失败。这一步验证的是旧用户态运行库的兼容性,不是在冒充完整的 CentOS 系统测试。
将头文件、启动对象和链接库一并换成旧 sysroot:
gcc -O1 --sysroot="$S" -B"$S/usr/lib64" \ -L"$S/usr/lib64" -L"$S/lib64" th.c -lpthread -o th_el7"$S/lib64/ld-linux-x86-64.so.2" \ --library-path "$S/lib64:$S/usr/lib64" ./th_el7输出为 thread returned 42。本次 th_el7 是 PIE4,依赖 libpthread.so.0 与 libc.so.6;三个关键引用都变成 GLIBC_2.2.5,并含 __stack_chk_fail@GLIBC_2.4 等较早需求。它也能在当前系统直接运行。旧程序到新库的兼容方向,靠的是新库确实保留了旧接口。
头文件也属于这个构建基线。当前头文件把 stat 编译成 stat@GLIBC_2.33;CentOS 7 的头文件则以内联包装调用 __xstat。单独改某个 .symver 不能替代整套兼容构建环境。对于发行的二进制,应选择明确的最老支持基线,并检查所有依赖的版本需求;例如 manylinux_2_17_x86_64 是对该架构及 glibc 基线的兼容承诺,不能仅凭一个主文件成功运行就断言整个包都符合它。
发布前查一遍:ABI 检查工具
开头那个故障,链接器和 ld.so 都查不出来,因为 .dynsym 里没有类型。类型信息其实在另一个地方:第 11 章讲的 DWARF5 调试信息里有每个函数的参数类型、每个结构体每个字段的偏移、每个枚举常量的值。ABI 检查工具就是把新旧两版库的调试信息读出来做对比。
abidiff
libabigail(ABI Generic Analysis and Instrumentation Library)是 sourceware 上的一个项目,abidiff 是它的命令行工具之一,Debian 里在 abigail-tools 包中。按它的手册,abidiff 默认读 DWARF,没有 DWARF 时退而读 CTF 或 BTF 这两种更紧凑的类型格式,都没有就只比较 ELF6 符号的增删;读完之后,只保留从库导出的函数和变量能够到达的那些类型,组成一份"ABI 语料",两份语料做差。对开头的 libpoint(两版都带 -g 编译):
$ abidiff v1/libpoint.so.1 v2/libpoint.so.1; echo "abidiff exit=$?"Functions changes summary: 0 Removed, 1 Changed (1 filtered out), 0 Added functionsVariables changes summary: 0 Removed, 0 Changed, 0 Added variable
1 function with some indirect sub-type change:
[C] 'function void point_init(point*, int, int)' at point.c:2:1 has some indirect sub-type changes: parameter 1 of type 'point*' has sub-type changes: in pointed to type 'struct point' at point2.h:2:1: type size changed from 64 to 96 (in bits) 1 data member insertion: 'int z', at offset 64 (in bits) at point2.h:2:1
abidiff exit=4它报出了结构体从 64 位变成 96 位、在偏移 64 位处插入了 int z,是通过 point_init 的第一个参数找到的;"1 filtered out"是 point_sum,它的参数指向同一个结构体,abidiff 默认不重复报告同一处变化,加 --redundant 就会把它也列出来。enum 的例子:
$ abidiff v1/libcolor.so.1 v2/libcolor.so.1; echo "abidiff exit=$?"... [C] 'function const char* color_name(color)' at color.c:2:1 has some indirect sub-type changes: parameter 1 of type 'enum color' has sub-type changes: type size hasn't changed 1 enumerator insertion: 'color::YELLOW' value '1' 2 enumerator changes: 'color::GREEN' from value '1' to '2' at color.h:2:1 'color::BLUE' from value '2' to '3' at color.h:2:1
abidiff exit=4退出码是一组位:手册规定 1 表示出错,2 表示用法错误(这时 1 也必须置位,实测给一个不存在的选项,退出码是 3),4(ABIDIFF_ABI_CHANGE)表示 ABI 有变化,8(ABIDIFF_ABI_INCOMPATIBLE_CHANGE)表示确定不兼容。只有 4 时,手册的原话是"the ABIs being compared might or might not be compatible. In that case, a human being needs to review the ABI changes",要人来判断。这里采用的工具版本与手册列出的明确不兼容情形包括:删除了导出的函数或变量,以及 C++ 虚函数在虚表里的位置变了。虚函数那个例子正好是后者:
$ abidiff v1/libshape.so.1 v2/libshape.so.1; echo "abidiff exit=$?"Functions changes summary: 0 Removed, 1 Changed (3 filtered out), 1 Added functionsVariables changes summary: 0 Removed, 0 Changed, 0 Added variable
1 Added function:
[A] 'method virtual int Shape::perimeter() const' {_ZNK5Shape9perimeterEv} note that this adds a new entry to the vtable of struct Shape
1 function with some indirect sub-type change:
[C] 'method virtual int Shape::area() const' at shape.cc:5:1 has some indirect sub-type changes: the vtable offset of method virtual int Shape::area() const changed from 0 to 1 note that this is an ABI incompatible change to the vtable of struct Shape...abidiff exit=1212 是 4 加 8。在 CI(持续集成)里,可以用上一版发布的库(或者用同一套工具里的 abidw 存下来的 XML 基线)和这次构建的库跑一遍 abidiff,退出码带 8 就拦下,只带 4 就交给人看。要检查结构体等类型层面的变化,需提供可用的类型信息,本例使用调试信息或分离出去的调试文件(第 11 章),abidiff 用 --d1、--d2 指定它们的位置。把调试信息剥掉再比,工具就只剩符号表可看了:
$ strip -o v1/libpoint.stripped.so v1/libpoint.so.1; strip -o v2/libpoint.stripped.so v2/libpoint.so.1$ abidiff v1/libpoint.stripped.so v2/libpoint.stripped.so; echo "abidiff exit=$?"abidiff exit=0abi-compliance-checker
另一个常用的工具是 Andrey Ponomarenko 开发的 abi-compliance-checker(ABICC),用 Perl 写成。它可以分析头文件,也可以吃 abi-dumper 从带调试信息的库里导出的 ABI 转储,生成一份 HTML 报告,按问题的严重程度分级。对同一对 libpoint:
$ abi-dumper v1/libpoint.so.1 -o v1.dump -lver 1.0WARNING: incompatible build option detected: -O1 (required -Og for better analysis)$ abi-dumper v2/libpoint.so.1 -o v2.dump -lver 1.1WARNING: incompatible build option detected: -O1 (required -Og for better analysis)$ abi-compliance-checker -l libpoint -old v1.dump -new v2.dump -report-path report.htmlPreparing, please wait ...Comparing ABIs ...Comparing APIs ...Creating compatibility report ...Binary compatibility: 100%Source compatibility: 100%Total binary compatibility problems: 0, warnings: 2Total source compatibility problems: 0, warnings: 1Report: report.html二进制兼容性 100%,两条警告。报告里把它们列在"Problems with Data Types, Low Severity"下:
Field z has been added to this type.1) This field will not be initialized by old clients.2) Size of the inclusive type has been changed.NOTE: this field should be accessed only from the new library functions, otherwise it may result in crash or incorrect behavior of applications.Size of this type has been changed from 8 bytes to 12 bytes.The fields or parameters of such data type may be incorrectly initialized or accessed by old client applications.这个判断有它的道理:结构体只以指针形式出现在接口里,如果对象总是由库自己分配(比如 point_new() 返回一个指针),使用者看不到 sizeof,末尾加字段确实是兼容的,很多库就是靠这种不透明指针在不换 soname 的情况下扩充结构体。开头的程序偏偏自己在全局数组里分配了对象,落进了 NOTE 里说的"crash or incorrect behavior"。两个工具报告的是同一个事实,对它的定级不同;一个结构体能不能在末尾加字段,取决于 API 是否允许使用者自己分配它,这一点从二进制里看不出来。
这个定级也决定了拿它做 CI 门禁时会发生什么。ABICC 默认的退出码是 0,开头那个故障会被放行;加上 -strict,警告也算作问题:
$ abi-compliance-checker -l libpoint -old v1.dump -new v2.dump -strict -report-path report-strict.html...Binary compatibility: 75%Source compatibility: 75%Total binary compatibility problems: 2, warnings: 0Total source compatibility problems: 1, warnings: 0Report: report-strict.html$ echo $?1按 abi-dumper 的提示改用 -Og 重新编译两版再比,默认和 -strict 两种模式的结论都和上面相同。和前面 abidiff 的退出码放在一起看,两个工具都要先想清楚"哪一级算失败",再接进门禁。
少导出一点
前面的每一种手段都有成本:换 soname 让发行版多一个包,符号版本让库里多一份旧实现,检查工具报出来的每一处变化都要有人判断。成本最低的办法是一开始就别承诺太多。Drepper 第 3.4 节说,库的两个版本之间之所以显得不兼容,很多时候是因为使用者用了库的内部接口,而内部接口本来就没打算保持稳定;与其事后抱怨,不如从一开始就不导出它们。
上一节的 abidiff 只看导出的接口。第 7 章比较过可见性、-fno-semantic-interposition、-Bsymbolic 和版本脚本对绑定及代码生成的影响。这里要区分两件事:hidden 可见性和版本脚本的局部化可以缩小导出集合;-Bsymbolic 主要改变库内引用的绑定,-fno-semantic-interposition 主要改变编译优化所用的替换假设,它们本身都不是删除导出符号的名单。那一章关心的是速度,这里换一个角度看:导出名单就是 ABI 的面积。下面这个库对外只承诺 fmt_width,fmt_pad 是它的内部函数,2 版给 fmt_pad 加了一个参数:
/* fmt.c */#ifdef V2int fmt_pad(int n, char c) { return c == ' ' ? n : 0; }#define PAD(n) fmt_pad(n, ' ')#elseint fmt_pad(int n) { return n; }#define PAD(n) fmt_pad(n)#endif#ifdef EXPORT_MACRO#define FMT_API __attribute__((visibility("default")))#else#define FMT_API#endifFMT_API int fmt_width(int len, int width) { return len < width ? PAD(width - len) : 0; }不加任何控制时,两个函数都会导出。用 abidiff 比较两版:
$ gcc -g -O1 -fPIC -shared fmt.c -o v1/libfmt.so$ gcc -g -O1 -fPIC -shared -DV2 fmt.c -o v2/libfmt.so$ abidiff v1/libfmt.so v2/libfmt.so; echo "abidiff exit=$?"Functions changes summary: 0 Removed, 1 Changed, 0 Added functionVariables changes summary: 0 Removed, 0 Changed, 0 Added variable
1 function with some indirect sub-type change:
[C] 'function int fmt_pad(int)' at fmt.c:6:1 has some sub-type changes: parameter 2 of type 'char' was added
abidiff exit=4fmt_pad 在 .dynsym 里,就可能有人调用它,它的参数一变,就是一次 ABI 改动。改成 -fvisibility=hidden 加显式导出宏(FMT_API 就是这样一个宏,大型库一般按平台把它定义成 visibility("default") 或 Windows 上的 __declspec(dllexport)):
$ gcc -g -O1 -fPIC -shared -fvisibility=hidden -DEXPORT_MACRO fmt.c -o v1/libfmt_h.so$ gcc -g -O1 -fPIC -shared -fvisibility=hidden -DEXPORT_MACRO -DV2 fmt.c -o v2/libfmt_h.so$ readelf --dyn-syms -W v2/libfmt.so | grep fmt_ 5: 0000000000001119 17 FUNC GLOBAL DEFAULT 11 fmt_pad 6: 000000000000112a 39 FUNC GLOBAL DEFAULT 11 fmt_width$ readelf --dyn-syms -W v2/libfmt_h.so | grep fmt_ 5: 000000000000110a 19 FUNC GLOBAL DEFAULT 9 fmt_width$ abidiff v1/libfmt_h.so v2/libfmt_h.so; echo "abidiff exit=$?"abidiff exit=0内部函数怎么改都不再算 ABI 变化。版本脚本里的 local: *; 能达到同样的效果:
$ cat fmt.mapFMT_1 { global: fmt_width; local: *;};$ gcc -g -O1 -fPIC -shared -Wl,--version-script=fmt.map fmt.c -o v1/libfmt_m.so$ gcc -g -O1 -fPIC -shared -Wl,--version-script=fmt.map -DV2 fmt.c -o v2/libfmt_m.so$ readelf --dyn-syms -W v2/libfmt_m.so | grep fmt_ 6: 000000000000110a 39 FUNC GLOBAL DEFAULT 11 fmt_width@@FMT_1$ abidiff v1/libfmt_m.so v2/libfmt_m.so; echo "abidiff exit=$?"abidiff exit=0区别在于版本脚本在链接时才起作用,编译器生成代码时并不知道哪些符号最终会变成本地符号,只能按可被替换的方式生成代码,再由链接器事后松弛,第 7 章 -Bsymbolic 那段反汇编里多绕的那一步就是这么来的。Drepper 的建议是两者一起用:可见性让编译器生成更好的代码,版本脚本则无论如何都应该有,因为它给每个导出符号挂上版本名,这是以后做不兼容改动的前提。
留下的问题
这一章的例子几乎都是 C,只有虚函数表那一个是 C++。C++ 的情况复杂得多。Drepper 说 C++ 的名字修饰让参数类型进了符号名,签名一改就能在链接或加载时被发现,这是它比 C 好的地方;可 C++ 也有大量编译进调用方的东西:内联函数、模板、类的布局、虚表的排列、默认参数。模板和内联函数在每个用到它们的翻译单元里各生成一份,由链接器去重,这叫 vague linkage(第 14 章细讲)。一个库的头文件里的模板改了实现,旧程序带着旧实例化,新库带着新实例化:内联掉的副本各跑各的;导出的弱定义会被 ld.so 按第 7 章的查找规则统一成一份,库里的调用也可能落到旧程序那份上。当这些定义仍指向同一 C++ 实体且不满足 ODR7 的一致性要求时,两种情况都可能违反 ODR(第 3 章讲过的单一定义规则)。
最有名的例子是 libstdc++ 自己。GCC 5.1 起,libstdc++ 为了满足 C++11 对 std::string 和 std::list 的要求换了新实现,新旧两套布局不兼容;它没有换 soname,而是把新实现放进内联名字空间 std::__cxx11(源码里照样写 std::string,符号名里却多了 __cxx11),用宏 _GLIBCXX_USE_CXX11_ABI 让使用者选择编译成哪一套,两套同时留在 libstdc++.so.6 里。练习一会在本机的 libstdc++.so.6 中看到同一个 time_get 的两份符号,一份名字里带 __cxx11,一份不带。这种做法靠的是名字修饰:名字空间是符号名的一部分,两套实现的符号名不同,可以并存。
Rust 的原生 ABI 不承诺跨编译器版本稳定。需要稳定的外部接口时,可以用 extern "C" 选择调用约定、用 #[repr(C)] 固定适合跨边界类型的布局,再明确内存所有权、生命周期与错误处理;这些标注并不会自动让任意 Rust 类型成为稳定接口。那么 _ZNSt7__cxx11... 这样的名字究竟是怎样把类型和名字空间编码进去的,链接器面对每个翻译单元都送来一份的模板实例化又是怎样只留下一份的?这是第 14 章的问题。
练习
本章三组练习沿用正文给出的输入,按各小题列出的命令依次完成。练习三还要用到前文的版本脚本和源文件;独立版本表解析器应复用本章已经定义的输入格式与校验规则。
练习一,观察。在本章的 Linux 主机上:
(1) 对系统的可执行文件目录和共享库目录中的每个 ELF 文件(跳过符号链接),用 objdump -T 找出它要求的最高 GLIBC_2.x 版本,按版本统计文件数。大多数文件停在哪个版本?可执行文件和共享库停在那里的原因各是哪几个符号?要求 GLIBC_2.36 的又是因为什么函数?如果直接 grep objdump -T 输出里的版本号,统计结果里会混进几个不该算的文件,是哪几个,它们有什么共同点?
(2) libstdc++.so.6 定义了多少个 GLIBCXX_* 版本节点、多少个 CXXABI_* 节点?最新的 GLIBCXX_3.4.30 的父节点是谁?挂在 GLIBCXX_3.4.30 上的默认版本符号里,找出名字只差一个 __cxx11 的符号对。
练习二,手算或预测。
(1) 一个 libtool 库当前是 -version-info 4:2:1。先写出它的 soname 和真实文件名。接下来依次发布三个版本:第一次只修了 bug;第二次增加了一个函数;第三次删掉了一个函数。按 libtool 手册的四条规则,写出每次的 c:r:a、soname 和文件名,再用 libtool 验证。第三次发布时 soname 的数字变化有什么出人意料的地方?
(2) 用正文的 parse1.c 编一个不带版本脚本的 libparse.so.1,让 app.c 对着它链接,得到 app_unver;然后把带两个版本的 2 版库放到运行时路径上。先预测:app_unver 里的 parse_num 引用带不带版本?它能启动吗?parse_num("abc") 输出 0 还是 −1?LD_DEBUG=bindings 的那一行末尾有没有方括号?
练习三,改坏。库作者觉得 2 版里的 parse_num_v1 已经没人用了,想在 3 版里"清理"掉,写了两种版本脚本:
/* parse3a.map:把 VERS_1 整个删掉 */VERS_2 { global: parse_num; parse_num_base; local: *;};/* parse3b.map:留着 VERS_1 节点,只删掉旧实现 */VERS_1 { local: *;};VERS_2 { global: parse_num; parse_num_base;} VERS_1;源码 parse3.c 只保留新实现,不再有任何 .symver。分别用两个脚本链接出 3 版库,让在 1 版上链接的 app_old 去用它。预测两种情况下的报错各是什么、在什么时候出现(启动时还是调用时),加上 LD_BIND_NOW=1 有没有区别。然后把库修好,让 app_old 恢复正常。
独立版本表解析器应复用本章已经定义的输入格式与校验规则。
参考
- Ulrich Drepper: How To Write Shared Libraries,4.1.2 版,2011-12-10,第 3 章 Maintaining APIs and ABIs(3.1 至 3.9 节)
- Ulrich Drepper: ELF Symbol Versioning
- GNU Libtool 手册(2.6.2 版在线手册):7.2 Libtool's versioning system、7.3 Updating library version information、7.3.1 Updating the version info manually;实验用的是 Linux 发行版提供的 libtool 2.5.4
- Debian Policy Manual 第 8 章 Shared libraries
- glibc 2.36 源码:
sysdeps/x86_64/multiarch/memmove-shlib-compat.h、sysdeps/x86_64/multiarch/memcpy.c、libio/fmemopen.c、libio/oldfmemopen.c、include/shlib-compat.h、sysdeps/unix/sysv/linux/aarch64/libc.abilist、sysdeps/unix/sysv/linux/x86_64/64/libc.abilist、NEWS(2.17 的 AArch64 移植、2.22 的 fmemopen),ftp.gnu.org/gnu/glibc - GCC 10 Release Series: Changes(symver 属性)
- libstdc++ 手册:Dual ABI
- libabigail 手册:abidiff
- lvc/abi-compliance-checker、lvc/abi-dumper
- PEP 600: Future 'manylinux' Platform Tags for Portable Linux Built Distributions
- Arm: Procedure Call Standard for the Arm 64-bit Architecture (AAPCS64)
- CentOS 7.9 x86-64 软件包:vault.centos.org/7.9.2009/os/x86_64/Packages
答案
每题的答案都折叠着,先自己做再展开。
练习一答案
(1) 脚本 ex/steps1.sh 对本机已安装文件做了一次快照;安装软件会改变文件数。提取版本必须保留完整的点分数字,例如 GLIBC_2.2.5,不能只截成 GLIBC_2.2。天真口径与只数未定义引用的结果为:
== 天真口径:1317 个文件 12 GLIBC_2.2.5 1 GLIBC_2.3.2 3 GLIBC_2.3.4 51 GLIBC_2.4 4 GLIBC_2.6 2 GLIBC_2.7 1 GLIBC_2.8 69 GLIBC_2.14 1 GLIBC_2.15 5 GLIBC_2.17 1 GLIBC_2.25 3 GLIBC_2.27 2 GLIBC_2.28 12 GLIBC_2.29 1 GLIBC_2.31 2 GLIBC_2.32 15 GLIBC_2.33 370 GLIBC_2.34 3 GLIBC_2.35 2 GLIBC_2.36 695 GLIBC_2.38 6 GLIBC_2.39 2 GLIBC_2.41 21 GLIBC_2.42 33 GLIBC_2.43== 只数 *UND*:1316 个文件 15 GLIBC_2.2.5 1 GLIBC_2.3.2 2 GLIBC_2.3.4 52 GLIBC_2.4 4 GLIBC_2.6 1 GLIBC_2.7 1 GLIBC_2.8 69 GLIBC_2.14 1 GLIBC_2.15 5 GLIBC_2.17 1 GLIBC_2.25 3 GLIBC_2.27 2 GLIBC_2.28 12 GLIBC_2.29 2 GLIBC_2.32 15 GLIBC_2.33 371 GLIBC_2.34 3 GLIBC_2.35 2 GLIBC_2.36 695 GLIBC_2.38 6 GLIBC_2.39 2 GLIBC_2.41 21 GLIBC_2.42 30 GLIBC_2.43== 两种口径不一致的文件/usr/lib/x86_64-linux-gnu/ld-linux-x86-64.so.2 GLIBC_2.35 -/usr/lib/x86_64-linux-gnu/libc.so.6 GLIBC_2.43 GLIBC_2.35/usr/lib/x86_64-linux-gnu/libc_malloc_debug.so.0 GLIBC_2.43 GLIBC_2.34/usr/lib/x86_64-linux-gnu/libdl.so.2 GLIBC_2.3.4 GLIBC_2.2.5/usr/lib/x86_64-linux-gnu/libm.so.6 GLIBC_2.43 GLIBC_2.4/usr/lib/x86_64-linux-gnu/libpthread.so.0 GLIBC_2.31 GLIBC_2.2.5/usr/lib/x86_64-linux-gnu/librt.so.1 GLIBC_2.7 GLIBC_2.2.5两种口径不同的七个文件都来自 glibc 的加载器或库:它们会自己定义 GLIBC_* 版本,所以只 grep 全部版本会把“提供什么”混成“要求什么”。加载器在只数 *UND* 的统计里消失,libc 自己则还会引用加载器的接口。
这次最高需求落在 2.38 的文件最多。扫描未定义符号可以看到,常见来源是 __isoc23_strtol、__isoc23_sscanf、__isoc23_strtoul 等 C23 接口,另外还有 strlcpy、strlcat 等符号;可执行文件和共享库都会引用它们。停在 2.34 的 371 个文件,则常由启动或线程、动态加载接口决定:
== 最高需求是 GLIBC_2.34 的文件,按引用的 2.34 符号计数 322 bin __libc_start_main 20 lib dlsym 15 lib pthread_create 13 lib pthread_join 12 lib pthread_setspecific 12 lib pthread_key_create 12 lib dlopen 10 lib dlerror 9 lib dlclose 8 lib dladdr其中 322 个可执行文件引用 __libc_start_main@GLIBC_2.34,共享库常见的是 dlsym、pthread_create 等接口。本次最高需求恰为 2.36 的两个文件分别是 systemd-run(open_tree)和 libXdmcp.so.6.0.0(arc4random_buf),不能沿用旧系统中“全都是随机数接口”的答案。
(2) 本机 libstdc++ 包含 36 个 GLIBCXX_* 版本节点和 19 个 CXXABI_* 节点。GLIBCXX_3.4.30 的父节点仍为 GLIBCXX_3.4.29,默认导出到该节点的符号有 9 个,其中四个 time_get 实例为:
985: 000000000018b9f0 5326 FUNC WEAK DEFAULT 14 _ZNKSt8time_getIwSt19istreambuf_iteratorIwSt11char_traitsIwEEE21_M_extract_via_formatES3_S3_RSt8ios_baseRSt12_Ios_IostateP2tmPKwRSt16__time_get_state@@GLIBCXX_3.4.30 3280: 000000000012f290 10095 FUNC WEAK DEFAULT 14 _ZNKSt7__cxx118time_getIwSt19istreambuf_iteratorIwSt11char_traitsIwEEE21_M_extract_via_formatES4_S4_RSt8ios_baseRSt12_Ios_IostateP2tmPKwRSt16__time_get_state@@GLIBCXX_3.4.30 3425: 000000000015bfe0 5612 FUNC WEAK DEFAULT 14 _ZNKSt8time_getIcSt19istreambuf_iteratorIcSt11char_traitsIcEEE21_M_extract_via_formatES3_S3_RSt8ios_baseRSt12_Ios_IostateP2tmPKcRSt16__time_get_state@@GLIBCXX_3.4.30 5769: 0000000000120bc0 11768 FUNC WEAK DEFAULT 14 _ZNKSt7__cxx118time_getIcSt19istreambuf_iteratorIcSt11char_traitsIcEEE21_M_extract_via_formatES4_S4_RSt8ios_baseRSt12_Ios_IostateP2tmPKcRSt16__time_get_state@@GLIBCXX_3.4.30985 与 3280 是 wchar_t 的旧、新 ABI 对照,3425 与 5769 是 char 对照。带 std::__cxx11 的名字与旧名字不同,因而能够在同一 SONAME 中并存;版本号相同不意味着名字或类型布局也相同。
练习二答案
(1) 先算。4:2:1 的 soname 是 4 − 1 = 3,文件名是 libfoo.so.3.1.2。
- 只修 bug:规则 1,
revision加一,得4:3:1,soname 仍是.3,文件名libfoo.so.3.1.3。 - 增加函数:规则 1 先得
4:4:1;规则 2,current加一并把revision清零,得5:0:1;规则 3,age加一,得5:0:2。soname5 − 2 = 3不变,文件名libfoo.so.3.2.0。 - 删除函数:规则 1、2 得
6:0:2;规则 4,age清零,得6:0:0。soname6 − 0 = 6,文件名libfoo.so.6.0.0。
libtool 实测:
4:2:1: libfoo.so.3.1.2 soname=libfoo.so.34:3:1: libfoo.so.3.1.3 soname=libfoo.so.35:0:2: libfoo.so.3.2.0 soname=libfoo.so.36:0:0: libfoo.so.6.0.0 soname=libfoo.so.6soname 从 .3 直接跳到 .6:修 bug 只把 revision 从 2 加到 3;增加接口时 current 从 4 变成 5,删除接口时再变成 6。最后 age 清零,current − age 从 3 变成 6。这个跳变来自接口编号与兼容区间的计算,不表示中间缺了两次软件发行。
(2) 实测:
$ gcc -O1 -fPIC -shared -Wl,-soname,libparse.so.1 parse1.c -o v0/libparse.so.1$ gcc -O1 app.c v0/libparse.so.1 -o app_unver$ readelf --dyn-syms -W app_unver | grep parse_num 6: 0000000000000000 0 FUNC GLOBAL DEFAULT UND parse_num$ readelf -V app_unver | grep -A1 'File: libparse' || echo "(没有对 libparse.so.1 的版本需求)"(没有对 libparse.so.1 的版本需求)$ LD_LIBRARY_PATH=v2 ./app_unverparse_num("42") = 42, parse_num("abc") = 0$ LD_DEBUG=bindings LD_LIBRARY_PATH=v2 ./app_unver 2>&1 | grep "symbol \`parse_num" 521: binding file ./app_unver [0] to v2/libparse.so.1 [0]: normal symbol `parse_num'链接时的库没有版本信息,引用就不带版本,.gnu.version_r 里也没有对 libparse.so.1 的需求,所以启动时没有可检查的东西,程序照常启动。运行时它拿到的是旧实现,输出 0,LD_DEBUG 那一行末尾没有方括号。这正是 dsohowto 第 3.8 节描述的情形:不带版本的引用碰上带版本的定义,选最早的那个。glibc 的 elf/dl-lookup.c 里 check_match 的注释写得很直接:"In the case of the old unversioned application the oldest (default) version should be used. In case of a dlsym() call the latest and public interface should be returned." 代码上,不带版本的普通查找直接接受版本索引小于 3 的定义(1 是基础版本,2 是第一个定义的版本,这里是 VERS_1),即使它带着隐藏位;dlsym 则只接受不隐藏的那个。
练习三答案
实测:
$ LD_LIBRARY_PATH=v3a ./app_old./app_old: v3a/libparse.so.1: version `VERS_1' not found (required by ./app_old)$ echo $?1$ LD_LIBRARY_PATH=v3b ./app_old./app_old: symbol lookup error: ./app_old: undefined symbol: parse_num, version VERS_1$ echo $?127$ readelf --dyn-syms -W v3b/libparse.so.1 | grep -E 'parse|VERS' 6: 0000000000000000 0 OBJECT GLOBAL DEFAULT ABS VERS_1 7: 0000000000001209 75 FUNC GLOBAL DEFAULT 14 parse_num_base@@VERS_2 8: 0000000000000000 0 OBJECT GLOBAL DEFAULT ABS VERS_2 9: 00000000000011b9 80 FUNC GLOBAL DEFAULT 14 parse_num@@VERS_2parse3a.map 删掉了 VERS_1 这个版本名,ld.so 启动时拿 app_old 的 .gnu.version_r 去对库的 .gnu.version_d,对不上,直接拒绝启动。parse3b.map 留着 VERS_1,版本检查通过了(库里还有 GNU ld 为每个版本名生成的同名 ABS 符号 VERS_1),可 VERS_1 下面已经没有 parse_num,查找失败。
两者出现的时机不同。在 main 开头先打印一行的 app_start.c 能看出来:
先显式构建惰性绑定的客户端。工具链可能默认启用立即绑定,不能凭省略选项就假定会延迟到首次调用;app_start.c 在打印后调用 fflush(stdout),避免缓冲输出掩盖程序是否进入 main。
gcc -O1 -Wl,-z,lazy app_start.c v1/libparse.so.1 -o app_startreadelf -d app_start | grep -E 'FLAGS|BIND_NOW'本例可见 PIE 标志,但不应出现 BIND_NOW 或 NOW;随后用环境变量开启立即绑定作为对照。
$ LD_LIBRARY_PATH=v3b ./app_startmain started./app_start: symbol lookup error: ./app_start: undefined symbol: parse_num, version VERS_1$ LD_BIND_NOW=1 LD_LIBRARY_PATH=v3b ./app_start./app_start: symbol lookup error: ./app_start: undefined symbol: parse_num, version VERS_1$ LD_LIBRARY_PATH=v3a ./app_start./app_start: v3a/libparse.so.1: version `VERS_1' not found (required by ./app_start)parse3b 的错误在惰性绑定下要等第一次调用 parse_num 才发生,程序已经跑了一段;加 LD_BIND_NOW=1 后提前到启动时。parse3a 的版本检查不涉及重定位,无论绑不绑定都在启动时失败。前一种更危险:程序可能已经做了一半的工作才崩掉。
修法是把删掉的东西放回来,也就是回到 2 版的写法:保留 parse_num_v1 和它的 .symver,版本脚本用 parse2.map。
$ gcc -O1 -fPIC -shared -Wl,-soname,libparse.so.1 -Wl,--version-script=parse2.map parse2.c -o v3fix/libparse.so.1$ LD_LIBRARY_PATH=v3fix ./app_oldparse_num("42") = 42, parse_num("abc") = 0真想去掉旧实现,就只能换 soname,让旧程序继续用旧的 libparse.so.1。
附录:术语与工具
-
UB — UB(undefined behavior,未定义行为)表示语言标准不再对该次执行提出行为要求。观察到某次输出可以解释具体产物,却不能把它当作可移植的程序结果;链接错误
undefined reference是另一类问题。 官方文档。 ↩ -
LTO — LTO(link-time optimization)在链接阶段协调编译器优化。它利用保留下来的中间表示跨文件分析,能力不同于仅处理本机目标文件的普通链接。 官方文档。 ↩
-
IR — IR(intermediate representation)是编译器使用的中间表示。它处于源码与最终机器码之间,便于分析和优化;LLVM IR 的文本形式与 bitcode 二进制编码表达同一套中间语言。 官方文档。 ↩
-
PIE — PIE(position-independent executable)是可以在不同加载基址运行的可执行文件。生成 PIE 需要编译与链接选项配合;static-PIE 还需要自身的启动路径完成必要重定位。 官方文档。 ↩
-
DWARF — DWARF 是调试信息格式,描述源码行、类型、变量与机器位置的关系。它可以随 ELF 保存,但不是 ELF 符号表的别名。 官方文档。 ↩
-
ELF — ELF(Executable and Linkable Format)规定目标文件、可执行文件与共享对象的结构。通用规则见 gABI,架构相关的调用约定和重定位规则见对应 psABI。 官方文档。 ↩
-
ODR — ODR(One Definition Rule)是 C++ 对定义一致性的要求。链接器选择了一个同名实例,并不能证明不同翻译单元中的定义满足语言规则。 官方文档。 ↩