

[链接器的世界-原理篇04] 重定位:一次调用,四个字节的距离
找到 add 的定义,还不能让 main 跳过去。x86-64 的直接跳转通常不存目标的完整地址,而是存从下一条指令到目标的距离:同一个 add 放在调用者前面或后面,机器码就要填入不同的数。符号解析确定了目标是谁,重定位把这个选择变成指令和数据所需的编码。
下面重新建立一组最小输入,只保留一次数据访问和一次函数调用。它与第 2 章变量较多的 main.c、第 3 章使用常量实参的版本不同,后面的偏移都以这里的源码为准:
// main.cint add(int a, int b); // 只声明,定义在 add.c 里int counter = 1;int main(void) { return add(counter, 2); }$ clang -O1 -c main.c -o main.o$ llvm-objdump -d -r main.o
0000000000000000 <main>: 0: 8b 3d 00 00 00 00 movl (%rip), %edi # 0x6 <main+0x6> 0000000000000002: R_X86_64_PC32 counter-0x4 6: be 02 00 00 00 movl $0x2, %esi b: e9 00 00 00 00 jmp 0x10 <main+0x10> 000000000000000c: R_X86_64_PLT32 add-0x4这份目标文件有两处待修改的字段:8b 3d 后面的四个零留给 counter,e9 后面的四个零留给到 add 的跳转距离,两处各对应 .rela.text 里的一条记录。零只是这份输入的初始内容,记录才是修改依据;最终计算结果也可能恰好是零。
实验在 x86-64 Linux 上完成,Clang/LLVM/LLD 为 21.1.8,GNU1 binutils2 为 2.46。主线使用本机目标,直接运行 ELF3;后面的 AArch64、i386 和 RISC-V4 小节是明确隔开的指令编码对照,也在 Linux 上生成并检查相应目标文件,不是日常实验环境。
便条上写了什么
第 2 章已经按原始字节拆过 Elf64_Rela:每条记录 24 字节,r_offset 是要修改的位置,r_info 的高 32 位是符号表下标、低 32 位是重定位类型,r_addend 是一个有符号的加数。对本章 main.o 的第一条记录来说,这三项分别是 2、counter 加 R_X86_64_PC32、−4(第 2 章那个 main.o 开头多一条 pushq,所以偏移是 3)。
换成链接器的视角,一条重定位记录有四个要素:在哪儿改(offset)、按什么规则算(type)、算的时候参考谁的地址(symbol)、再额外加多少(addend)。第 1 章把重定位比作便条,这四项就是便条上写的全部内容。
offset 是节内偏移,"哪个节"则由重定位表自己的节头说明。用 Linux 上的 LLVM5 21.1.8 llvm-readelf 看一眼:
$ llvm-readelf -S main.o [Nr] Name Type Address Off Size ES Flg Lk Inf Al [ 2] .text PROGBITS 0000000000000000 000040 000010 00 AX 0 0 16 [ 3] .rela.text RELA 0000000000000000 000140 000030 18 I 10 2 8 [ 8] .rela.eh_frame RELA 0000000000000000 000170 000018 18 I 10 7 8 [10] .symtab SYMTAB 0000000000000000 0000b0 000090 18 1 3 8(输出有裁剪。)第 2 章讲过,.rela.text 的 Lk(sh_link)是 10,表示记录里的符号下标查的是 10 号节 .symtab;Inf(sh_info)是 2,表示这张表修改的是 2 号节 .text。所以 "offset 2" 的完整意思是"2 号节从头数第 2 个字节"。
在目标文件里,.text 的地址一列还是 0,它最终放在哪里要等链接器决定。等它被放到某个地址 X 之后,要修改的那个字节的地址就是 X + 2。链接器总是这样做:先确定每个输入节的起点,再用"节起点 + 节内偏移"算出每处修改的真实位置。
一个字段,三种坐标
r_offset 只给出输入节内的位置。读取输入文件、计算重定位值、写入输出文件,各自还需要不同的起点。以下用一组示意布局把三者放在一起:输入 .text 的文件偏移是 0x40,输出 .text 的文件偏移是 0x120、虚拟地址是 0x401000,这个输入节被放在输出 .text 内偏移 0x20 处。重定位修改节内偏移 2 开始的四字节字段。
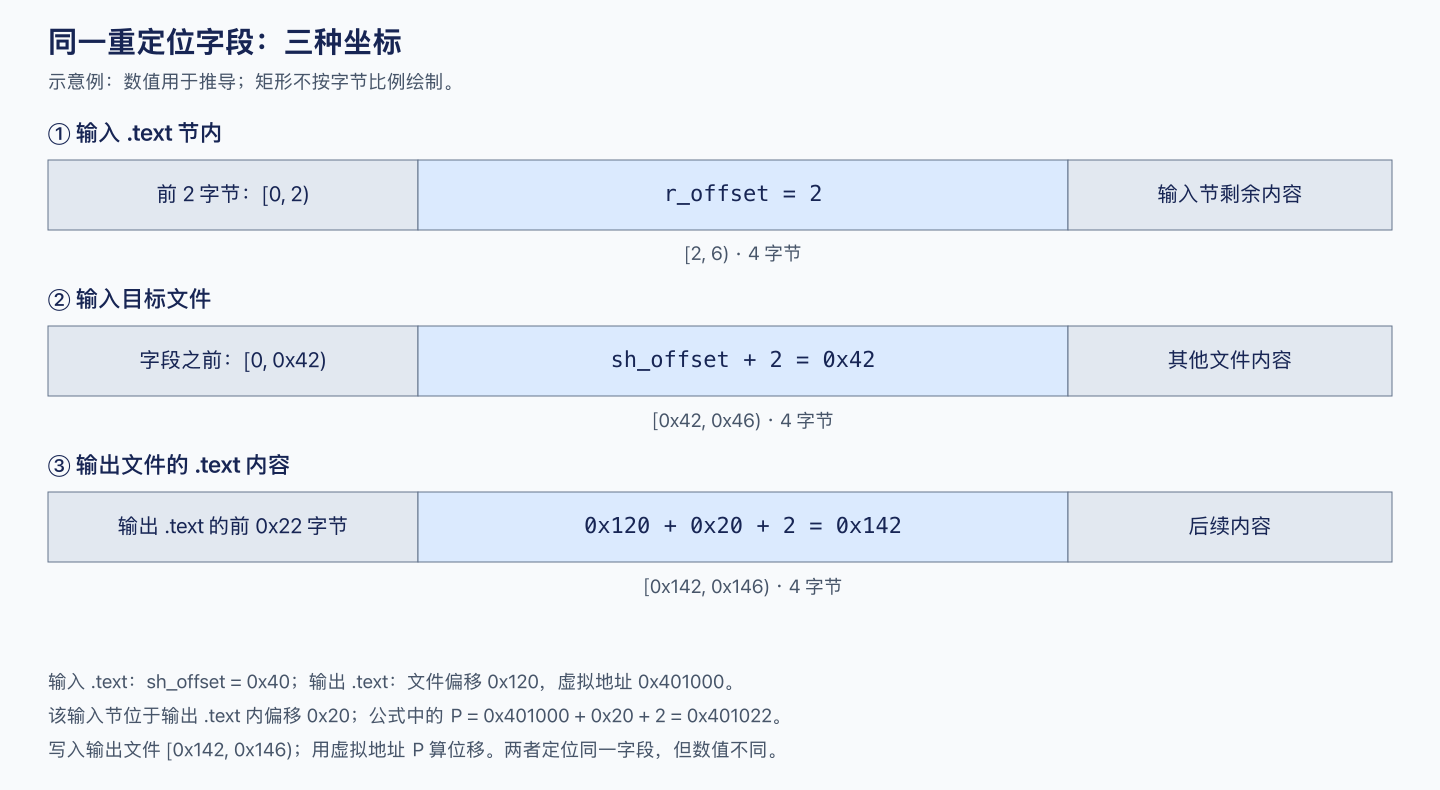
读取输入时,字段位于文件区间 [0x42, 0x46);写入输出时,字段位于 [0x142, 0x146);代入重定位公式的 P 则是 0x401022。前两个区间用于定位字节,最后一个地址用于计算程序运行时的距离。若符号地址 S = 0x402080、加数 A = −4,PC32 的结果是 0x105a,写入输出文件的四字节为 5a 10 00 00。CPU 以 P+4 为基准,加上这个位移后到达 0x402080。
如果程序已经把缓冲区切成“这个输入节在输出中的那块内容”,写入下标仍然是 2;如果持有整个输出文件,下标就是 0x142。下标取决于缓冲区的起点,P 则始终代表被修改字段的虚拟地址。把二者混用,会出现公式算对、字节写错位置的错误。
为什么不止一种算法
如果所有要填的地方都是"写入符号的地址",一种类型就够了。问题在于,不同的指令和数据,用不同的方式表达"那个地址"。写一个专门的例子:
// kinds.cextern int counter;extern int table[];
int *ptr = &counter; /* 数据里存一个绝对地址 */
int *addr_of(void) { return &counter; }int load_elem(long i) { return table[i]; }这里加了 -fno-pic(不生成位置无关代码),让编译器用最朴素的方式访问外部变量;默认的位置无关版本放到后面"GOT6 与 GOTPCRELX"一节讲。
$ clang -O1 -fno-pic -c kinds.c -o kinds.o$ llvm-objdump -d -r kinds.o
0000000000000000 <addr_of>: 0: b8 00 00 00 00 movl $0x0, %eax 0000000000000001: R_X86_64_32 counter 5: c3 retq ...0000000000000010 <load_elem>: 10: 8b 04 bd 00 00 00 00 movl (,%rdi,4), %eax 0000000000000013: R_X86_64_32S table 17: c3 retq
$ llvm-objdump -r kinds.o...RELOCATION RECORDS FOR [.data]:OFFSET TYPE VALUE0000000000000000 R_X86_64_64 counter同一个文件里出现了三种新类型,加上 main.o 里的两种,一共五种,各自对应一种表达方式:
ptr是存在.data里的一个 64 位指针,需要把counter的完整 8 字节地址原样写进去:R_X86_64_64。movl $counter, %eax把地址当作 32 位立即数(直接编码在指令里的常数)装进寄存器。x86-64 上,往 32 位寄存器写值会把高 32 位清零,所以这个 32 位数会被"零扩展"成 64 位地址:R_X86_64_32。movl table(,%rdi,4), %eax用"基址 + 下标 × 4"寻址,指令里的 32 位位移会被 CPU"符号扩展"(按最高位补齐高 32 位)成 64 位:R_X86_64_32S,S 就是 signed。movl counter(%rip), %edi用 RIP 相对寻址,指令里存的是"目标离这里多远":R_X86_64_PC32。jmp add存的也是距离,但目标是一个函数,它可能在另一个共享库里:R_X86_64_PLT32。
每种类型规定两件事:要写的字段有多宽,写进去的值怎么算。这些规定来自 x86-64 psABI7 的 "Relocation" 一节。先用三个记号描述直接地址与相对距离:
- A:加数,即记录里的
r_addend。 - S:符号的值;本节的普通代码与数据符号在最终映像中取其地址。
- P:被修改字段的地址,等于所属输入节的输出地址加
r_offset。不能直接拿输入中的节内偏移与最终地址 S 相减。
这三个量必须采用相容的坐标。下面几种类型已经足以解释直接地址和 PC 相对地址;涉及 PLT 或 GOT 的类型在对应小节引入,完整对照见附录。
名称 值 字段 计算R_X86_64_64 1 word64 S + AR_X86_64_PC32 2 word32 S + A - PR_X86_64_32 10 word32 S + AR_X86_64_32S 11 word32 S + AR_X86_64_32 和 32S 的计算式完全一样,区别只在"写进去之后要满足什么条件",后面讲溢出时再说。有了这些记号,就可以手算了。
从一条 PC32 算到四个字节
第 1 章已经解释过 PC32 的 −4:CPU 以下一条指令的开头为基准计算 RIP 相对地址,而这 4 个字节正好是指令的最后 4 个字节,两个基准差 4。代入 psABI 的公式,位移 = S − (P + 4) = S + (−4) − P,A 就是 −4。
先把这两个基点放到一条 call rel32 指令上看:
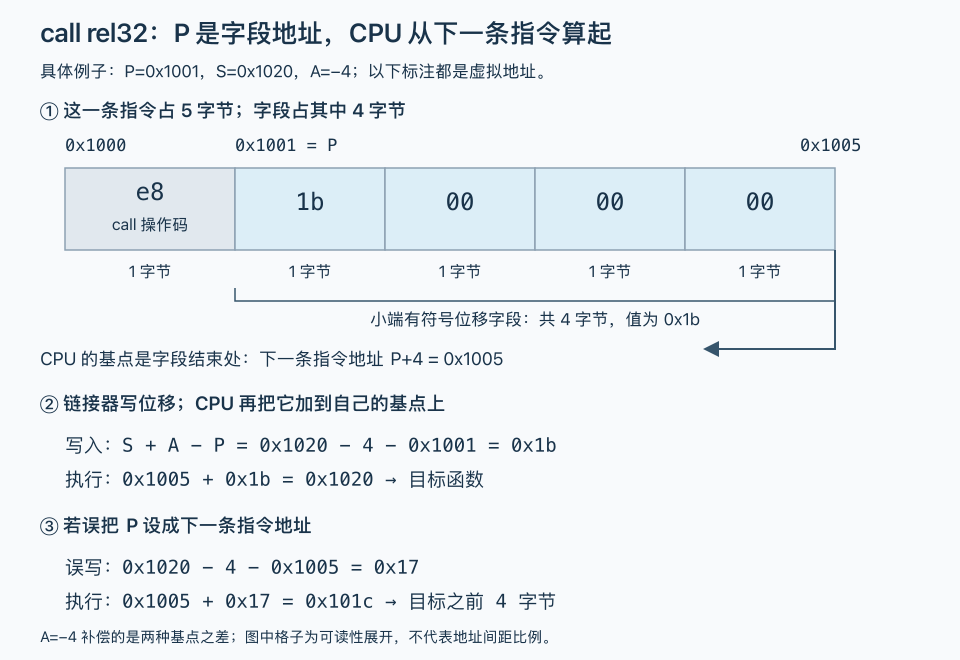
e8 是操作码,不在重定位字段内。图中 P=0x1001,下一条指令在 0x1005,目标 S=0x1020。链接器写入 0x1020-4-0x1001=0x1b,小端字节为 1b 00 00 00;CPU 从下一条指令计算 0x1005+0x1b=0x1020。如果把下一条指令的地址误用为 P,就会写入 0x17,实际跳到 0x101c,即目标之前 4 字节。P 与加数必须一起理解。
现在做一次完整的手算,然后用真实的链接结果核对。add.c 用第 2 章那个:
// add.cint add(int a, int b) { return a + b;}链接器使用本机 GNU ld 2.46,检查产物使用 GNU readelf8 和 LLVM llvm-objdump。链接时不带 C 库,用 -e main 直接把 main 指定为入口,这样的可执行文件不能正常运行,但足够用来观察链接器填进去的字节。
$ clang -O1 -c add.c -o add.o$ ld -static -e main main.o add.o -o app$ readelf -S -W app | grep -E '\.text|\.data' [ 1] .text PROGBITS 0000000000401000 001000 000014 00 AX 0 0 16 [ 3] .data PROGBITS 0000000000403000 003000 000004 00 WA 0 0 4$ readelf -s -W app | grep -E ' (main|add|counter)$' 3: 0000000000401010 4 FUNC GLOBAL DEFAULT 1 add 4: 0000000000403000 4 OBJECT GLOBAL DEFAULT 3 counter 6: 0000000000401000 16 FUNC GLOBAL DEFAULT 1 mainGNU ld 把输出的 .text 放在 0x401000。main.o 是第一个输入文件,它的 .text 从输出 .text 的开头放起,起点就是 0x401000;add.o 的 .text 排在后面,从 0x401010 开始(main 占 16 字节,正好对齐到 16)。counter 在 0x403000。
第一处修改。手算时先把要用的量逐个列出来,再代入公式,本章后面的手算都照这个格式。清单里的".text 起点"指的是被修改的那个 .o 的 .text 输入节在输出里的起点,只有它排在第一块时才和输出 .text 的起点相同:
.text 起点 = 0x401000;重定位偏移 = 0x2;P = 0x401000 + 0x2 = 0x401002;S = counter = 0x403000;A = -4S + A - P = 0x403000 + (-4) - 0x401002 = 0x1ffa0x1ffa 写成 32 位小端字节是 fa 1f 00 00,这条指令应该从 8b 3d 00 00 00 00 变成 8b 3d fa 1f 00 00。验证一下:下一条指令的地址是 0x401006,0x401006 + 0x1ffa = 0x403000,正好是 counter。再看链接器实际写进去的字节:
$ llvm-objdump -d app0000000000401000 <main>: 401000: 8b 3d fa 1f 00 00 mov 0x1ffa(%rip),%edi # 403000 <counter> 401006: be 02 00 00 00 mov $0x2,%esi 40100b: e9 00 00 00 00 jmp 401010 <add>
0000000000401010 <add>: 401010: 8d 04 37 lea (%rdi,%rsi,1),%eax 401013: c3 ret和手算一致。同样两个 .o 交给 Linux 上的 LLD9 21.1.8(ld.lld),地址完全不同:
$ ld.lld -static -e main main.o add.o -o app.lld$ llvm-objdump -d app.lld00000000002011b0 <main>: 2011b0: 8b 3d 0e 10 00 00 mov 0x100e(%rip),%edi # 2021c4 <counter> 2011b6: be 02 00 00 00 mov $0x2,%esi 2011bb: e9 00 00 00 00 jmp 2011c0 <add>lld 把 main 放在 0x2011b0、counter 放在 0x2021c4:
.text 起点 = 0x2011b0;重定位偏移 = 0x2;P = 0x2011b2;S = 0x2021c4;A = -4S + A - P = 0x2021c4 - 4 - 0x2011b2 = 0x100e填进去的就是 0e 10 00 00。公式相同,输入的 S 和 P 不同,结果自然不同。
如果目标在当前位置之前,结果是负数,按补码写入。把链接顺序反过来,让 add.o 排在前面:
$ ld -static -e main add.o main.o -o app2$ llvm-objdump -d app20000000000401000 <add>: 401000: 8d 04 37 lea (%rdi,%rsi,1),%eax 401003: c3 ret ...0000000000401010 <main>: 401010: 8b 3d ea 1f 00 00 mov 0x1fea(%rip),%edi # 403000 <counter> 401016: be 02 00 00 00 mov $0x2,%esi 40101b: e9 e0 ff ff ff jmp 401000 <add>(输出有裁剪。)add 只占 4 字节,main.o 的 .text 要求 16 字节对齐,中间 0x401004 到 0x40100f 这 12 字节是对齐留下的空隙。同样的输入交给 lld,空隙的填法不一样:
$ ld.lld -static -e main add.o main.o -o app2.lld$ llvm-objdump -s -j .text app2 401000 8d0437c3 662e0f1f 84000000 00006690 ..7.f.........f.$ llvm-objdump -s -j .text app2.lld 2011b0 8d0437c3 cccccccc cccccccc cccccccc ..7.............(输出有裁剪。)GNU ld 填的是多字节 nop(66 2e 0f 1f 84 00 00 00 00 00 是一条 10 字节的 nopw,66 90 是 2 字节的),lld 填的是 0xcc,即 int3 断点指令,执行流误入空隙会立刻停下。逐字节比较两个链接器的输出时,这些空隙本来就不同,不算重定位算错。
这次算的是 jmp:
.text 起点 = 0x401010;重定位偏移 = 0xc;P = 0x40101c;S = add = 0x401000;A = -4S + A - P = 0x401000 - 4 - 0x40101c = -0x20−0x20 的补码写成 e0 ff ff ff。PC32 的字段被当作有符号数,就是为了能向前也能向后跳。
这个算式也可以倒过来用。拿到一个链接好的文件、手里没有重定位表时,只看机器码就能反推目标在哪:把 e0 ff ff ff 按小端读成 0xffffffe0,按有符号数解释是 −0x20;jmp 的下一条指令地址是 0x40101b + 5 = 0x401020;目标 = 0x401020 + (−0x20) = 0x401000,正是 add。llvm-objdump 在 jmp 后面注释的 401000 <add>,就是这样算出来的。
加数为什么不总是 −4
既然这样,为什么 psABI 不干脆把 PC32 定义成 S - P - 4,还要让每条记录带一个加数?因为位移字段后面不一定紧跟下一条指令。再写两个函数看看:
// addend.cextern int counter;extern char flag;
int is_big(void) { return counter > 1000; }void set_flag(void) { flag = 1; }$ clang -O1 -fno-pic -c addend.c -o addend.o$ llvm-objdump -d -r addend.o
0000000000000000 <is_big>: 0: 31 c0 xorl %eax, %eax 2: 81 3d 00 00 00 00 e9 03 00 00 cmpl $0x3e9, (%rip) # imm = 0x3E9 0000000000000004: R_X86_64_PC32 counter-0x8 c: 0f 9d c0 setge %al f: c3 retq
0000000000000010 <set_flag>: 10: c6 05 00 00 00 00 01 movb $0x1, (%rip) # 0x17 <set_flag+0x7> 0000000000000012: R_X86_64_PC32 flag-0x5 17: c3 retqcmpl $0x3e9, counter(%rip) 在位移字段之后还跟着一个 4 字节立即数 e9 03 00 00(1001,编译器把 > 1000 改写成了 >= 1001),所以下一条指令在 P + 8 处,加数变成 −8;movb $1, flag(%rip) 后面跟 1 字节立即数,加数是 −5。汇编器在编码时知道指令的完整长度,它把这个差值算好放进加数,链接器就只需要套同一个公式 S + A - P,不必理解每条指令的格式。加数还可以表示符号之后的某个位置;元数据里的引用就提供了一个例子。
节符号与元数据也需要重定位
.rela.eh_frame 修改的是 7 号节 .eh_frame。看一下它的记录:
$ llvm-objdump -r main.o...RELOCATION RECORDS FOR [.eh_frame]:OFFSET TYPE VALUE0000000000000020 R_X86_64_PC32 .text符号写的是 .text,不是某个函数名。这是一个节符号(第 2 章讲过的 SECTION 类型符号),代表"本文件这个 .text 节的起点"。如果一个文件里有两个函数,就能看到它配合加数使用的样子,前面生成的 kinds.o 就是这样:
$ llvm-objdump -r kinds.o...RELOCATION RECORDS FOR [.eh_frame]:OFFSET TYPE VALUE0000000000000020 R_X86_64_PC32 .text0000000000000034 R_X86_64_PC32 .text+0x10第二个函数从 .text 内偏移 0x10 处开始,汇编器没有用函数名,而是写成".text 起点,加数 0x10"。顺带也能看到,重定位不只用于机器码:.eh_frame 是栈展开用的元数据(第 1 章提过它的来历),里面记录着"这段描述对应哪段代码",代码的地址同样要等链接时才知道,所以它也有自己的重定位表。.eh_frame 的内部结构留到第 8 章。
节符号也按这个规则取值。add.o 的 .eh_frame 里同样有一条引用节符号 .text 的 PC32,它指的是 add.o 自己那块 .text,链接后取的是这块输入节在输出里的地址 0x401010,不是输出 .text 的起点 0x401000。链接器把 .eh_frame 也合并进了输出,用 GNU readelf 解出每条 FDE10(描述一段代码怎么展开的记录,第 8 章细讲)覆盖的地址范围,就能看到这两个值:
$ readelf --debug-dump=frames app | grep FDE00000018 0000000000000014 0000001c FDE cie=00000000 pc=0000000000401000..000000000040101000000030 0000000000000010 00000034 FDE cie=00000000 pc=0000000000401010..0000000000401014第一条来自 main.o,第二条来自 add.o。两个文件的记录写的都是 .text,加数也一样,算出来的起点却差 0x10,差的正是 main.o 那块 .text 的长度。
PLT32:调用的目标可能不在本模块
第二处修改是 jmp add,类型 R_X86_64_PLT32,公式是 L + A - P,用的是 L(add 的 PLT 条目地址),不是 S。
原因在于编译 main.c 时,编译器不知道 add 最后会来自另一个 .o,还是来自运行时才加载的共享库。如果是后者,静态链接时根本不知道 add 的地址,链接器会生成一小段跳板代码(PLT 条目),让 jmp 先跳到跳板,再由跳板跳到运行时确定的真实地址。PLT32 这个类型的意思就是"如果需要,就让这里指向 PLT 条目"。
在上面的静态链接里,add 来自另一个 .o,不需要跳板,链接器直接把 L 取为 add 本身的地址。记录的类型仍是 PLT32,只是算出来的值和按 PC32 算的一样:
.text 起点 = 0x401000;重定位偏移 = 0xc;P = 0x40100c;L = add = 0x401010;A = -4L + A - P = 0x401010 + (-4) - 0x40100c = 0结果是 0,所以 llvm-objdump 里那条 jmp 仍然是 e9 00 00 00 00。这几个零已经是链接器算出来的值:add 紧跟在 main 后面,jmp 的下一条指令就是 add 的第一条指令,距离恰好为零。
要看到 L 和 S 真的不同,得让 add 来自共享库。把 add.c 编成位置无关代码做成 libadd.so,再把 main.o 链接成依赖它的 PIE11(位置无关可执行文件,每次运行被装到一个随机基址,第 5、7 章细讲):
$ clang -O1 -fPIC -c add.c -o addpic.o$ ld.lld -shared addpic.o -o libadd.so$ ld.lld -pie -e main main.o libadd.so -o app.dyn$ llvm-objdump -d app.dyn00000000000012d0 <main>: 12d0: 8b 3d 0a 21 00 00 mov 0x210a(%rip),%edi # 33e0 <counter> 12d6: be 02 00 00 00 mov $0x2,%esi 12db: e9 10 00 00 00 jmp 12f0 <add@plt>...00000000000012f0 <add@plt>: 12f0: ff 25 0a 21 00 00 jmp *0x210a(%rip) # 3400 <add>(输出有裁剪。)这次 L 是链接器生成的 add@plt:
.text 起点 = 0x12d0;重定位偏移 = 0xc;P = 0x12dc;L = add@plt = 0x12f0;A = -4L + A - P = 0x12f0 - 4 - 0x12dc = 0x10和填进去的 10 00 00 00 一致。jmp 先落到跳板上,跳板再通过一个运行时由 ld.so 填写的地址跳到真正的 add,那是第 7 章的内容。counter 定义在 main.c 自己里,所以仍然是 PC32 直接访问。
对本例中尚未定义的外部函数 add,直接调用或尾跳转使用 PLT32,给链接器保留了选择:目标最终在本模块里,就直接跳到它;需要经过 PLT,就跳到对应跳板。看到 PLT32 并不意味着最终一定会出现 PLT。
这条经验不能推广成“所有 call foo、jmp foo 都产生 PLT32”。目标能否在汇编时确定、符号的绑定与可见性、目标所在的节,以及汇编器的具体选择,都会影响结果。下面用同一份 x86-64 汇编分别交给 GNU as 2.46 和 LLVM 21.1.8 集成汇编器;每格按 call / jmp 列出重定位,无 表示汇编器已经直接算定,不留下该条指令的重定位记录:
| 目标 | GNU as | LLVM 集成汇编器 |
|---|---|---|
| 尚未定义的 GLOBAL 函数 | PLT32 / PLT32 | PLT32 / PLT32 |
| 同一节内的 GLOBAL 函数 | PLT32 / 无 | PLT32 / PLT32 |
| 另一节内的 GLOBAL 函数 | PLT32 / PLT32 | PLT32 / PLT32 |
| 同一节内的 LOCAL 函数 | 无 / 无 | 无 / 无 |
| 另一节内的 LOCAL 函数 | PC32 / PC32 | PLT32 / PLT32 |
| 同一节内的 WEAK 函数 | PLT32 / PLT32 | PLT32 / PLT32 |
因此判断一条引用的处理方式,应查看目标文件实际留下的记录,不能只看指令助记符,也不能仅凭 PC32 或 PLT32 反推符号的绑定属性。
绝对地址:64、32 和 32S
回到 kinds.o,给它配一个定义 counter 和 table 的文件,再链接一次:
// table.cint counter = 40;int table[16];$ clang -O1 -fno-pic -c table.c -o table.o$ ld -static -e addr_of kinds.o table.o -o kinds$ readelf -s -W kinds | grep -E 'counter|table|ptr' 3: 0000000000403000 8 OBJECT GLOBAL DEFAULT 3 ptr 5: 0000000000403010 64 OBJECT GLOBAL DEFAULT 4 table 6: 0000000000403008 4 OBJECT GLOBAL DEFAULT 3 counter(输出有裁剪。)counter 在 0x403008,table 在 0x403010,ptr 本身在 0x403000。
三处都是 S + A,没有 P 参与,清单里只剩 S 和 A:
R_X86_64_64 (.data 偏移 0x0,即 ptr):S = counter = 0x403008;A = 0;S + A = 0x403008,写 8 字节 08 30 40 00 00 00 00 00R_X86_64_32 (addr_of+0x1) :S = counter = 0x403008;A = 0;S + A = 0x403008,写 4 字节 08 30 40 00R_X86_64_32S (load_elem+0x3) :S = table = 0x403010;A = 0;S + A = 0x403010,写 4 字节 10 30 40 00对照链接结果:
$ llvm-objdump -d kinds0000000000401000 <addr_of>: 401000: b8 08 30 40 00 mov $0x403008,%eax 401005: c3 ret ...0000000000401010 <load_elem>: 401010: 8b 04 bd 10 30 40 00 mov 0x403010(,%rdi,4),%eax 401017: c3 ret$ llvm-objdump -s -j .data kindsContents of section .data: 403000 08304000 00000000 28000000 .0@.....(...(输出有裁剪。).data 开头 8 字节就是 ptr,内容 08 30 40 00 00 00 00 00;后面的 28 00 00 00 是 counter 的初值 40。
计算本身简单,麻烦在把 64 位的结果塞进 32 位字段。x86-64 psABI 要求链接器检查:截取低 32 位后,按该重定位规定的扩展方式恢复,必须得到原来的 64 位值。
也就是说,链接器截断之后必须检查:CPU 把这 32 位按零扩展(或符号扩展)还原回 64 位时,得到的是不是原来的值。0x403010 很小,两种扩展都没问题。可如果 table 被放到了 0x80000000,它的 32 位截断值是 00 00 00 80;零扩展回来是 0x80000000,R_X86_64_32 可以接受;符号扩展回来却是 0xffffffff80000000,地址错了,R_X86_64_32S 必须报错。
检查的是位表示能否恢复
符号地址通常以无符号整数保存,addend 却可以为负。公式的结果还可能是负位移。因此要分清三个步骤:求出公式的整数结果、得到目标机器的 64 位表示、检查较窄字段能否恢复这个表示。它们不能用一次强制转换代替。
对于这里的 x86-64 定宽重定位,64 位结果保留低 64 位,即按模 2^64 表示:0xffffffffffffffff + 1 得到全零位,0 + (−1) 得到全一位。R_X86_64_64 可以写入全部八字节;32 位类型还必须通过扩展检查。LLD 的 x86-64 实现 也区分了完整八字节写入、无符号范围检查和有符号范围检查。
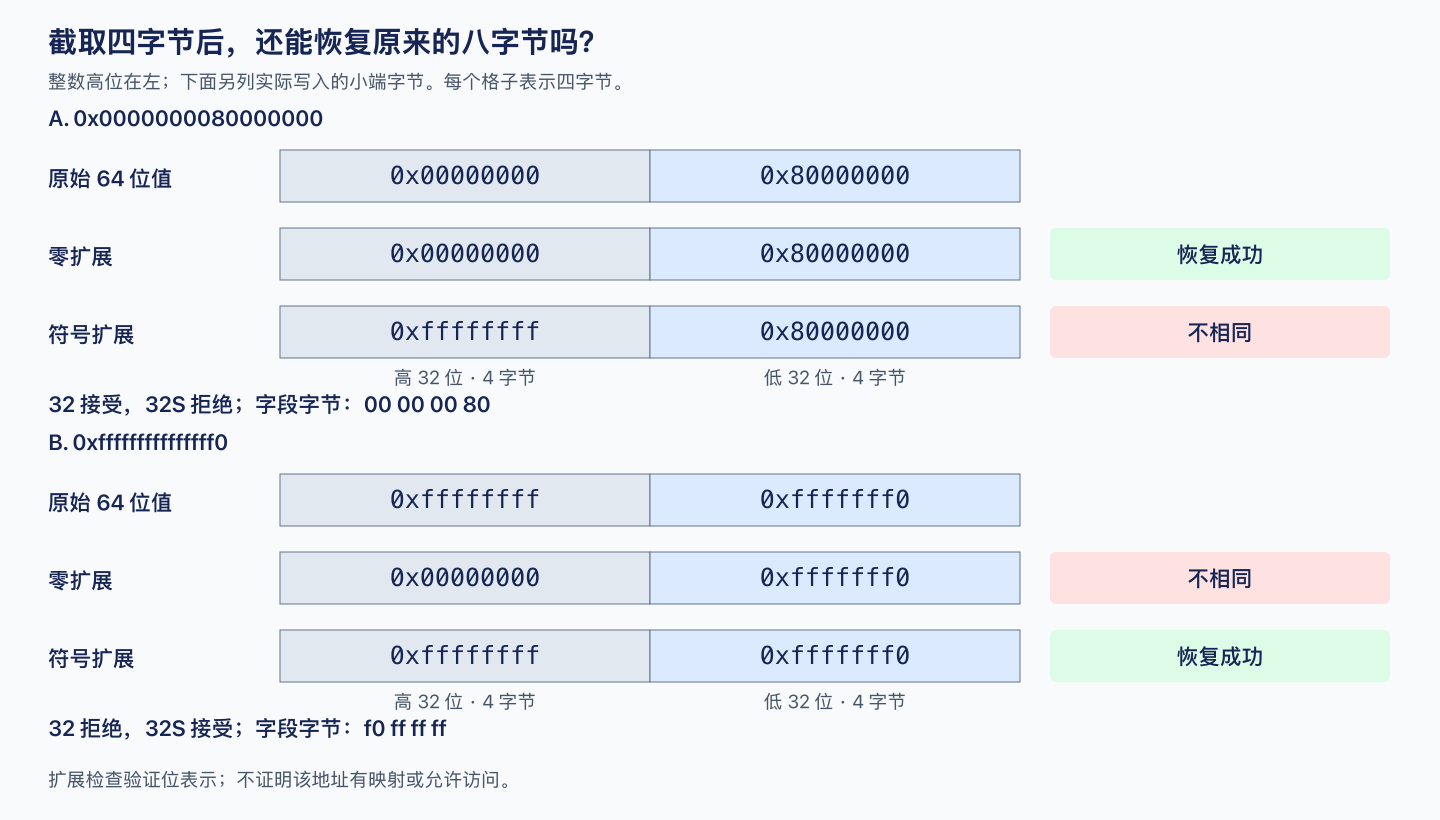
图中按整数书写顺序将高 32 位放在左边;文件里的小端字节顺序另列在下方。符号扩展复制的是低 32 位的最高位,也就是 bit 31。它为零时,高 32 位补零;它为一时,高 32 位全补一。
| 原来的 64 位表示 | 低 32 位 | 零扩展可恢复? | 符号扩展可恢复? |
|---|---|---|---|
0x000000007fffffff | 0x7fffffff | 是 | 是 |
0x0000000080000000 | 0x80000000 | 是 | 否 |
0xfffffffffffffff0 | 0xfffffff0 | 否 | 是,表示 −16 |
0x0000000100000000 | 0x00000000 | 否 | 否 |
第三行解释了一个容易误判的边界:若 S=0xfffffffffffffff0、A=0,32S 可以写入 f0 ff ff ff。这个 S 作为 u64 很大,但它的 64 位表示恰好等于 −16 的符号扩展结果。仅把无符号 S 与 i32::MAX 比较会错误拒绝它;仅截断则会错误接受第四行。这里检验的是字段的编码能力,并不说明该地址已经映射或可以访问。
负的 PC32 位移使用相同的补码表示。例如前面回跳的结果 −32,低四字节为 e0 ff ff ff,符号扩展恢复为 0xffffffffffffffe0。字段写入的范围检查与寻找待写字节的边界检查也是两件事:一个值能表示,并不保证那四字节仍在目标节内。
要观察正地址 0x80000000 导致的溢出,可以用 --section-start 强行把 .bss(table 所在的节)放到 0x80000000,counter 所在的 .data 不动。两个链接器都拒绝了:
$ ld -static -e addr_of kinds.o table.o --section-start=.bss=0x80000000 -o kinds2kinds.o: in function `load_elem':kinds.c:(.text+0x13): relocation truncated to fit: R_X86_64_32S against symbol `table' defined in .bss section in table.o
$ ld.lld -static -e addr_of kinds.o table.o --section-start=.bss=0x80000000 -o kinds2ld.lld: error: kinds.o:(function load_elem: .text+0x13): relocation R_X86_64_32S out of range: 2147483648 is not in [-2147483648, 2147483647]; references 'table'>>> referenced by kinds.c>>> defined in table.olld 报出的 2147483648 就是 0x80000000,后面的区间是 32 位有符号数的范围。GNU ld 的 relocation truncated to fit 说的也是同一件事:某条重定位算出的值放不进它的字段。
还有一种常见报错也和这两个类型有关。把 -fno-pic 编出来的 kinds.o 链接成 PIE,链接器会拒绝:
$ ld -pie -e addr_of kinds.o table.o -o kinds.pield: kinds.o: relocation R_X86_64_32 against symbol `counter' can not be used when making a PIE object; recompile with -fPIE
$ ld.lld -pie -e addr_of kinds.o table.o -o kinds.pield.lld: error: relocation R_X86_64_32 cannot be used against symbol 'counter'; recompile with -fPIC>>> defined in table.o>>> referenced by kinds.c>>> kinds.o:(addr_of)
ld.lld: error: relocation R_X86_64_32S cannot be used against symbol 'table'; recompile with -fPIC...(输出有裁剪。)PIE 的地址在运行时才确定,基址可能远在 4GB 之上,一个写死在指令里的 32 位绝对地址无法表达它。报错末尾的建议就是正确的修法。
那 ptr 处的 R_X86_64_64 在 PIE 里又怎么办?8 字节的字段装得下任何地址,问题只在于链接时还不知道基址。链接器的做法是先按基址为 0 算出一个值写进去,再在输出文件里留一条新的便条,让 ld.so 在程序启动、基址确定之后把基址加上去。这种留给运行时处理的重定位叫动态重定位,它们有自己的一套类型和存放位置,是第 7 章的主题。本章讨论的都是链接器自己就能算完的那一类,通常称为静态重定位。
把这些串起来:链接器怎么处理一条记录
看过几种类型之后,可以把链接器处理重定位的过程概括一下。下面是一段示意性的伪代码,省略了错误处理和各种特殊情况:
for 每个被保留下来的输入节 sec: base = 链接器给 sec 分配的输出地址 buf = sec 在输出文件里对应的那块字节 for 每条属于 sec 的重定位 r: P = base + r.offset S = 符号 r.sym 解析后的最终地址 # 节符号取那个输入节在输出里的地址 A = r.addend # REL 格式则从 buf 里读出 按 r.type 选择公式,算出 value # S+A、S+A-P、L+A-P、G+GOT+A-P ... 检查 value 能否放进该类型的字段 # 32S 查符号扩展,PC32 查 ±2GB ... 按该类型的编码方式把 value 写进 buf[r.offset]这个循环里有几处值得留意。
第一,每个输入节可以独立处理。一个节里的重定位只写这个节自己的字节,读的是全局已经确定的地址,节与节之间没有写冲突,所以这一步很适合并行,第 16 章会再谈。
第二,循环开头的"被保留下来的"有实际含义。如果某个节在之前的步骤里被删掉了,它的重定位也就不用处理;反过来,如果一条重定位引用了一个被删掉的节里的符号,链接器就得决定这个 S 该取什么值。这牵涉到布局和垃圾回收,第 5 章再说。
第三,这个写入循环使用已经确定的 S、P、L 和 GOT 地址。实际链接器还可能根据重定位需求先建立 GOT、PLT 或跳板,并因松弛重新布局;这里描述的是这些决策完成后的应用阶段。
第四,"检查"那一行不能省。只截断不检查的话,链接能成功,程序运行时却会访问错误的地址。
加数存在哪里:REL 与 RELA
到这里,加数一直是重定位记录里的一个独立字段。这种带显式加数的格式叫 RELA,对应 .rela.* 节和 SHT_RELA 类型。ELF 还有一种更早、更省空间的格式叫 REL(.rel.* 节,SHT_REL 类型),记录里只有 offset 和 info,没有 r_addend。那加数去哪了?把同一个 main.c 编译成 32 位 x86(i386)看看:
$ clang --target=i386-unknown-linux-gnu -O1 -fno-pic -c main.c -o m32.o$ llvm-objdump -h m32.o | grep -i rel 3 .rel.text 00000010 00000000 8 .rel.eh_frame 00000008 00000000$ llvm-objdump -d -r m32.o
00000000 <main>: 0: 83 ec 14 subl $0x14, %esp 3: 6a 02 pushl $0x2 5: ff 35 00 00 00 00 pushl 0x0 00000007: R_386_32 counter b: e8 fc ff ff ff calll 0xc <main+0xc> 0000000c: R_386_PC32 add 10: 83 c4 1c addl $0x1c, %esp 13: c3 retli386 的调用约定用栈传参,所以代码长得不一样,但关键在 call 那一行:要填的四个字节已经有内容了,fc ff ff ff,也就是 −4。REL 格式把加数直接存在被修改的位置里,链接器先把原来的内容读出来当作 A,再算 S + A - P 写回去。用 lld 链接验证一下(这里显式生成 i386 对象,只对照 REL 编码,不切换主线实验环境):
$ clang --target=i386-unknown-linux-gnu -O1 -fno-pic -c add.c -o a32.o$ ld.lld -m elf_i386 -static -e main m32.o a32.o -o app32$ llvm-objdump -d app3200401130 <main>: 401130: 83 ec 14 subl $0x14, %esp 401133: 6a 02 pushl $0x2 401135: ff 35 5c 21 40 00 pushl 0x40215c 40113b: e8 10 00 00 00 calll 0x401150 <add>$ llvm-readelf -s app32 | grep -E ' (main|add|counter)$' 3: 00401130 20 FUNC GLOBAL DEFAULT 2 main 4: 0040215c 4 OBJECT GLOBAL DEFAULT 3 counter 5: 00401150 9 FUNC GLOBAL DEFAULT 2 add(输出有裁剪。)call 那处,A 要从原字节里读:
.text 起点 = 0x401130;重定位偏移 = 0xc;P = 0x40113c;S = add = 0x401150;A = 原字节 fc ff ff ff = -4S + A - P = 0x401150 - 4 - 0x40113c = 0x10填进去的正是 10 00 00 00。R_386_32 那处的公式是 S + A,原字节是零,A 就是 0,于是直接填 counter 的地址 5c 21 40 00。
.rel.text 里两条记录一共 16 字节,每条 8 字节;同样的信息用 32 位 RELA(Elf32_Rela)要 12 字节一条,在 64 位上则是 16 字节对 24 字节。
32 位 ARM 的情况类似:
$ clang --target=armv7a-unknown-linux-gnueabihf -O1 -fno-pic -c main.c -o arm.o$ llvm-objdump -d -r arm.o00000000 <main>: 0: e3000000 movw r0, #0x0 00000000: R_ARM_MOVW_ABS_NC counter 4: e3400000 movt r0, #0x0 00000004: R_ARM_MOVT_ABS counter 8: e5900000 ldr r0, [r0] c: e3a01002 mov r1, #2 10: eafffffe b 0x10 <main+0x10> @ imm = #-0x8 00000010: R_ARM_JUMP24 addmovw 把一个 16 位立即数写进寄存器的低半部分,movt 写高半部分,两条合起来拼出 counter 的 32 位地址,各带一条重定位。b 指令里预先编码了 −8,原因和 x86 的 −4 相仿:32 位 ARM 有两种指令状态,4 字节定长的 ARM 状态和以 2 字节指令为主的 Thumb 状态,在 ARM 状态下读 PC 得到的是当前指令地址加 8(Thumb 状态下是加 4)。在 REL 格式里,这个偏差只能存在指令本身的立即数里。
REL 省空间,代价也很明显。第一,加数的取值范围受被修改字段的宽度和编码方式限制,ARM 的 ELF 规范(aaelf32)为此专门用一大段规定"各种指令里的初始加数怎么取出",MOVW/MOVT 这类指令还要特殊处理。第二,"读出原值、算完写回"这个动作不能重复执行,同一规范里直说 "A REL type relocation can never be idempotent"。如果某个工具要对同一段数据重新应用一次重定位,它必须先还原出最初的字节。
所以 64 位的新架构基本都选了 RELA。x86-64 psABI 写得很绝对:"The AMD64 LP64 ABI12 architecture uses only Elf64_Rela relocation entries with explicit addends."(LP64 指 long 和指针都是 64 位的常规模式。)AArch64 的 ELF 规范(aaelf64)在条文上允许 REL 和 RELA 混用,但 GCC13 和 LLVM 的工具链实际产出的都是 RELA;下文 AArch64 的实验里,节名就是 .rela.text。
放不下了:重定位溢出与 code model
回到 32 位字段。RIP 相对寻址的位移是 32 位有符号数,能表达的距离是 ±2GB。程序里有一个 3GB 的数组会怎样?
// huge.cchar huge[3UL << 30]; /* 3 GiB 的零初始化数组 */// use.cextern char huge[];int counter; /* 也在 .bss 里,链接时排在 huge 之后 */int get(void) { return counter + huge[0]; }$ clang -O1 -fno-pic -c huge.c -o huge.o$ clang -O1 -fno-pic -c use.c -o use.o$ llvm-objdump -d -r use.o0000000000000000 <get>: 0: 0f be 05 00 00 00 00 movsbl (%rip), %eax # 0x7 <get+0x7> 0000000000000003: R_X86_64_PC32 huge-0x4 7: 03 05 00 00 00 00 addl (%rip), %eax # 0xd <get+0xd> 0000000000000009: R_X86_64_PC32 counter-0x4 d: c3 retq编译顺利通过,编译器照常用 PC32 访问 huge 和 counter。两者都在 .bss(零初始化数据)里,链接时 huge.o 在前,counter 就排在 3GB 的 huge 之后,离 .text 超过了 2GB:
$ ld -static -e get huge.o use.o -o biguse.o: in function `get':use.c:(.text+0x9): relocation truncated to fit: R_X86_64_PC32 against symbol `counter' defined in .bss section in use.o
$ ld.lld -static -e get huge.o use.o -o bigld.lld: error: use.o:(function get: .text+0x9): relocation R_X86_64_PC32 out of range: 3221229571 is not in [-2147483648, 2147483647]; references 'counter'>>> referenced by use.c>>> defined in use.olld 报出的 3221229571 约等于 3GB,就是算出来的那个放不下的距离。出错的是 counter,不是那个巨大的数组:huge 的起点离代码很近,被挤到远处的是排在它后面的小变量。
编译器之所以敢用 32 位位移,是因为它和链接器之间有一个约定,叫 code model(代码模型)。psABI 的 "Architectural Constraints" 一节(low-level-sys-info.tex)定义了几种模型。默认的 small 模型规定:
all symbols are known to be located in the virtual addresses in the range from 0 to 2^31−2^24−1 or from 0x00000000 to 0x7effffff
上限没有取满 2GB,留出的 2^24(16MB)有一个注脚解释:这样对于不超过 16MB 的对象,"基址 + 偏移"的写法(例如 table+0x100)也保证落在范围内。在这个约定之下,编译器可以放心使用 PC32、32 和 32S。3GB 的数组违反了约定,于是要换模型。
medium 模型把数据分成两类,小数据仍按 small 的规则,大数据(psABI 写的默认阈值是大于 65535 字节,clang 用 -mlarge-data-threshold= 调整)放到 .ldata、.lbss 这类"大数据节"里,用 64 位绝对地址访问。把刚才两个文件都换成 -mcmodel=medium 重新编译:
$ clang -O1 -fno-pic -mcmodel=medium -c huge.c -o hugem.o$ clang -O1 -fno-pic -mcmodel=medium -c use.c -o usem.o$ llvm-objdump -d -r usem.o0000000000000000 <get>: 0: 48 b8 00 00 00 00 00 movabs $0x0,%rax 7: 00 00 00 2: R_X86_64_64 huge a: 0f be 00 movsbl (%rax),%eax d: 03 05 00 00 00 00 add 0x0(%rip),%eax # 13 <get+0x13> f: R_X86_64_PC32 counter-0x4 13: c3 ret$ ld -static -e get hugem.o usem.o -o big$ readelf -S -W big | grep -E 'bss|\.text' [ 1] .text PROGBITS 0000000000401000 001000 000014 00 AX 0 0 16 [ 3] .bss NOBITS 0000000000403000 003000 000008 00 WA 0 0 4 [ 4] .lbss NOBITS 0000000000403010 003000 c0000000 00 WAl 0 0 16$ llvm-objdump -d big0000000000401000 <get>: 401000: 48 b8 10 30 40 00 00 movabs $0x403010,%rax 401007: 00 00 00 40100a: 0f be 00 movsbl (%rax),%eax 40100d: 03 05 ed 1f 00 00 add 0x1fed(%rip),%eax # 403000 <counter> 401013: c3 ret链接成功了。huge 被放进 .lbss,访问它改用 movabs(x86-64 上唯一能带 64 位立即数的 mov 形式,10 字节)加 R_X86_64_64,链接器填进去的是完整的 8 字节地址 10 30 40 00 00 00 00 00;counter 仍在普通的 .bss 里,仍用 PC32(.text 起点 = 0x401000;重定位偏移 = 0xf;P = 0x40100f;S = 0x403000;A = −4;S + A − P = 0x1fed)。GNU ld 把 .lbss 排在 .bss 之后,小变量 counter 不再被大数组挤走。psABI 正是这样要求的:大数据节不要夹在普通的 .text 节和数据节之间,这样代码和小数据之间的距离仍在 2GB 以内。
large 模型对地址不做任何假设,连函数调用也不能用 32 位距离:
$ clang -O1 -fno-pic -mcmodel=large -c main.c -o large.o$ llvm-objdump -d -r large.o0000000000000000 <main>: 0: 48 b8 00 00 00 00 00 00 00 00 movabsq $0x0, %rax 0000000000000002: R_X86_64_64 counter a: 8b 38 movl (%rax), %edi c: 48 b8 00 00 00 00 00 00 00 00 movabsq $0x0, %rax 000000000000000e: R_X86_64_64 add 16: be 02 00 00 00 movl $0x2, %esi 1b: ff e0 jmpq *%rax$ ld -static -e main large.o add.o -o app.large$ llvm-objdump -d app.large0000000000401010 <main>: 401010: 48 b8 00 30 40 00 00 movabs $0x403000,%rax 401017: 00 00 00 40101a: 8b 38 mov (%rax),%edi 40101c: 48 b8 00 10 40 00 00 movabs $0x401000,%rax 401023: 00 00 00 401026: be 02 00 00 00 mov $0x2,%esi 40102b: ff e0 jmp *%rax两处 R_X86_64_64 都是 S + A,链接器直接填入 counter(0x403000)和 add(0x401000)的完整地址。对比 small 模型下的同一个 main:读 counter 从一条 6 字节的指令变成 10 字节的 movabs 加 2 字节的 mov;jmp add 从 5 字节的直接跳转变成 10 字节的 movabs 加 2 字节的间接跳转;整个函数从 16 字节涨到 29 字节,还多占了一个寄存器。所以 small 是默认值,psABI 也说它适合绝大多数程序。另外还有一个 kernel 模型,它把所有符号限定在地址空间最高的 2GB 里(0xffffffff80000000 起),Linux 内核就用它,这时 32S 的符号扩展正好派上用场。编译器在生成指令时就定下了字段宽度,链接器只能检查、不能扩宽,所以重定位溢出要回到编译选项上去修。
GOT 与 GOTPCRELX:链接器改写指令
main.c 里的 counter 是本文件定义的,编译器知道它一定和代码在同一个模块里。如果把定义挪到另一个文件,情况就变了:
// ext.c:和 main.c 一样,只是 counter 改为外部声明int add(int a, int b);extern int counter;int main(void) { return add(counter, 2); }// counter.cint counter = 1;$ clang -O1 -c ext.c -o ext.o$ llvm-objdump -d -r ext.o0000000000000000 <main>: 0: 48 8b 05 00 00 00 00 movq (%rip), %rax # 0x7 <main+0x7> 0000000000000003: R_X86_64_REX_GOTPCRELX counter-0x4 7: 8b 38 movl (%rax), %edi 9: be 02 00 00 00 movl $0x2, %esi e: e9 00 00 00 00 jmp 0x13 <main+0x13> 000000000000000f: R_X86_64_PLT32 add-0x4clang 以 Linux 为目标时默认生成 PIE 用的位置无关代码,这里没有加 -fno-pic。对 counter 的访问变成了两步:先从某个位置读出一个 8 字节的值到 %rax,再把它当作地址去读 counter。第一步读的就是 counter 的 GOT 项,里面存着 counter 的地址。
clang 这样做,是因为它不知道 counter 最终在哪:如果它来自一个共享库,它的地址在运行时才确定,而且和本模块之间的距离可能超过 2GB,PC32 直接寻址不可靠。经过 GOT 中转就没有这个问题:GOT 是本模块的一部分,到它的距离在链接时确定,GOT 项的内容可以在运行时由 ld.so 填写(第 7 章)。psABI 正文的脚注也是这个意思:"Even though the AMD64 architecture supports IP-relative addressing modes, a GOT is still required since the offset from a particular instruction to a particular data item cannot be known by the static linker." GCC 在 x86-64 的 PIE 里走的是另一条路:它假定外部变量就在可执行文件内,直接用 PC32 访问,万一变量其实在共享库里,再由链接器用复制重定位兜底,这也是第 7 章的内容。
这里引入两个量:GOT 是全局偏移表的地址,G 是该符号表项相对于 GOT 起点的字节偏移。因此 GOT + G 是表项地址,不是表项中存放的 counter 地址。R_X86_64_GOTPCREL、R_X86_64_GOTPCRELX 和 R_X86_64_REX_GOTPCRELX 的字段计算式均为 G + GOT + A - P;后两种还允许符合条件的指令改写。
计算式读作:该符号的 GOT 项的地址(GOT + G),减去当前位置,再修正 −4。结构和 PC32 一样,只是目标从 counter 本身换成了"存放 counter 地址的那一格"。
可在很多情况下,counter 其实就定义在同一个可执行文件里的另一个 .o 中,比如这里的 counter.o。到了链接时,链接器已经看到了全部输入,知道 counter 在本模块内、不会被别的模块替换("不会被替换"的精确条件涉及符号可见性和符号插入,第 3 章预告过,第 7 章细讲)。这时绕道 GOT 就是浪费:多一次内存读取,还要为它占一个 GOT 项。
更好的做法是把这条指令改掉。psABI 的 "Linker Optimization" 一章(linker-optimization.tex)规定了这种改写,条件是 foo 在本模块内定义,并且加数为 −4:
内存操作数形式 改写后mov foo@GOTPCREL(%rip), %reg → lea foo(%rip), %regmov foo@GOTPCREL(%rip), %reg → mov $foo, %reg (仅在非 PIC 且 foo 位于低 32 位地址时)call *foo@GOTPCREL(%rip) → nop call foo 或 call foo nopjmp *foo@GOTPCREL(%rip) → jmp foo nop另外还有 test 和 add、cmp 等算术指令的改写(把内存操作数换成立即数 $foo),只在非 PIC14 时适用。
mov 改 lea 是最常见的一种。opcode(操作码,指令里表示"做什么操作"的那个字节)8b 是 mov,意思是"从这个地址读 8 字节";8d 是 lea,意思是"把这个地址本身放进寄存器",两者的寻址方式编码完全相同。改写只需要把一个字节从 8b 改成 8d,再把位移从"到 GOT 项的距离"换成"到 counter 的距离"。改完后 %rax 里直接就是 counter 的地址,下一条 movl (%rax), %edi 不用动。
用 GNU ld 把 ext.o、counter.o、add.o 链接成 PIE,再加 --no-relax 链接一次作对照:
$ clang -O1 -c counter.c -o counter.o$ ld -pie -e main ext.o counter.o add.o -o app.pie$ ld -pie --no-relax -e main ext.o counter.o add.o -o app.norelax$ readelf -s -W app.pie | grep -E ' (main|counter|add)$' 6: 0000000000001020 4 FUNC GLOBAL DEFAULT 6 add 7: 0000000000004000 4 OBJECT GLOBAL DEFAULT 9 counter 9: 0000000000001000 19 FUNC GLOBAL DEFAULT 6 mainPIE 的链接地址从 0 起算,运行时再整体加上一个随机基址,所以这里的地址都很小。先看不做改写的版本:
$ llvm-objdump -d app.norelax0000000000001000 <main>: 1000: 48 8b 05 d9 2f 00 00 mov 0x2fd9(%rip),%rax # 3fe0 <_DYNAMIC+0x100> 1007: 8b 38 mov (%rax),%edi 1009: be 02 00 00 00 mov $0x2,%esi 100e: e9 0d 00 00 00 jmp 1020 <add>$ readelf -S -W app.norelax | grep -E '\.got |\.dynamic' [ 8] .dynamic DYNAMIC 0000000000003ee0 002ee0 000100 10 WA 4 0 8 [ 9] .got PROGBITS 0000000000003fe0 002fe0 000008 08 WA 0 0 8$ llvm-objdump -s -j .got app.norelaxContents of section .got: 3fe0 00400000 00000000 .@......$ readelf -r app.norelaxRelocation section '.rela.dyn' at offset 0x298 contains 1 entry: Offset Info Type Sym. Value Sym. Name + Addend000000003fe0 000000000008 R_X86_64_RELATIVE 4000(输出有裁剪。)llvm-objdump 给目标地址加注释时,用的是离它最近的前一个符号,0x3fe0 前面最近的符号是 _DYNAMIC,也就是 .dynamic 节的起点(0x3ed0,这个节是给 ld.so 看的,第 7 章讲),于是显示成 _DYNAMIC+0x110。这个地址其实是 .got 里的一项。链接器在 0x3fe0 建了这个 GOT 项,里面写着 counter 的链接地址 0x4000,并且留了一条 R_X86_64_RELATIVE 动态重定位,让 ld.so 启动时给这一项加上基址,正是前面"动态重定位"那段说的机制。指令的计算是 G + GOT + A − P:
.text 起点 = 0x1000;重定位偏移 = 0x3;P = 0x1003;GOT + G = counter 的 GOT 项 = 0x3fe0;A = -4G + GOT + A - P = 0x3fe0 - 4 - 0x1003 = 0x2fd9与填入的 d9 2f 00 00 一致。
再看默认的版本:
$ llvm-objdump -d app.pie0000000000001000 <main>: 1000: 48 8d 05 f9 2f 00 00 lea 0x2ff9(%rip),%rax # 4000 <counter> 1007: 8b 38 mov (%rax),%edi 1009: be 02 00 00 00 mov $0x2,%esi 100e: e9 0d 00 00 00 jmp 1020 <add>opcode 从 8b 变成了 8d,mov 变成了 lea;位移改按 S + A − P 计算:
.text 起点 = 0x1000;重定位偏移 = 0x3;P = 0x1003;S = counter = 0x4000;A = -4S + A - P = 0x4000 - 4 - 0x1003 = 0x2ff9即 f9 2f 00 00,现在直接指向 counter。这个版本既不需要那个 GOT 项,也不需要运行时的 R_X86_64_RELATIVE。jmp 那处 PLT32 也一样是算出来的(重定位偏移 = 0xf;P = 0x100f;L = add = 0x1020;A = −4;L + A − P = 0xd)。
指令长度没变,前后的代码不用挪动,这是 x86 上这类改写能安全进行的关键。call 和 jmp 的改写也是如此:call *foo@GOTPCREL(%rip) 是 6 字节,直接 call foo 只有 5 字节,多出来的那个字节用一个前缀或 nop 补齐。
这种链接期根据最终信息把指令换成更优形式的做法,叫 relaxation(松弛,也译作"放宽"),意思是放宽编译期不得不做的保守假设。
为什么要专门定义 GOTPCRELX 这个新类型,而不是直接对老的 R_X86_64_GOTPCREL 做改写?因为改写指令的前提是链接器确切知道这几个字节前面是什么指令。老的 GOTPCREL 只承诺"这 4 字节要填一个到 GOT 的距离",没有承诺它属于哪种指令,手写汇编里它完全可能出现在别的上下文中。新类型把这个承诺写进了规范:R_X86_64_GOTPCRELX 表示指令从重定位位置往前 2 字节开始,R_X86_64_REX_GOTPCRELX 表示往前 3 字节开始、带一个 REX 前缀(x86-64 上用于 64 位操作数的前缀字节,就是上面例子里的 48)。后来 Intel 的 APX 扩展把通用寄存器从 16 个增加到 32 个,需要更长的指令前缀,psABI 又为此加了 CODE_4 到 CODE_6 几个变体。
这组类型由 binutils 2.26(2016 年初)开始支持。新类型的代价是旧工具不认识它:用新汇编器或新 clang 生成的 .o,拿去给旧版 GNU ld 链接,会得到 unrecognized relocation (0x2a) in section `.text',0x2a 正是 42,R_X86_64_REX_GOTPCRELX(Stack Overflow 上的典型案例)。
AArch64:定长指令里放不下 32 位
x86 的指令是变长的,32 位位移可以作为一个完整字段嵌在指令里。AArch64 的指令一律 4 字节,扣掉 opcode 和寄存器编号后,留给立即数的位数很少,一条指令装不下一个 32 位偏移。看看同一个 main.c 在 AArch64 上的样子:
$ clang --target=aarch64-unknown-linux-gnu -O1 -c main.c -o a64.o$ llvm-objdump -d -r a64.o0000000000000000 <main>: 0: 90000008 adrp x8, 0x0 <main> 0000000000000000: R_AARCH64_ADR_PREL_PG_HI21 counter 4: 52800041 mov w1, #0x2 // =2 8: b9400100 ldr w0, [x8] 0000000000000008: R_AARCH64_LDST32_ABS_LO12_NC counter c: 14000000 b 0xc <main+0xc> 000000000000000c: R_AARCH64_JUMP26 add$ llvm-objdump -h a64.o | grep rela 3 .rela.text 00000048 0000000000000000 8 .rela.eh_frame 00000018 0000000000000000AArch64 有 31 个通用寄存器,x8 是 8 号寄存器的 64 位名字,w0、w1 是 0 号、1 号寄存器低 32 位的名字;按调用约定,w0、w1 是前两个 int 参数,w0 也用来放返回值。访问 counter 被拆成了两条指令,各带一条重定位。AArch64 也有一条按字节计算 PC 相对地址的 adr 指令,但它只有 21 位立即数,只够 ±1MB。于是有了按 4KB 的"页"来寻址的办法:同样是 21 位,每个单位代表 4096 字节,范围就扩大到 ±4GB,代价是丢掉了低 12 位,需要第二条指令补回来:
adrp x8, counter:算出counter所在的 4KB 页和当前指令所在页之间差几页,把目标页的起始地址放进x8。ldr w0, [x8, #lo12]:再用counter地址的低 12 位作为页内偏移去读。
AArch64 ELF 规范(aaelf64)用一个辅助函数定义这件事:Page(expr) 是 expr & ~0xFFF,并且特意注明,即使平台的实际内存页大小不是 4KB,这里也按 4KB 算。相关的几行:
编号 名称 计算 说明275 R_AARCH64_ADR_PREL_PG_HI21 Page(S+A)-Page(P) 写入 ADRP,取 X 的 [32:12] 位,检查 -2^32 <= X < 2^32277 R_AARCH64_ADD_ABS_LO12_NC S + A 写入 ADD,取 X 的 [11:0] 位,不检查溢出285 R_AARCH64_LDST32_ABS_LO12_NC S + A 写入 32 位 LDR/STR,取 X 的 [11:2] 位,不检查溢出282 R_AARCH64_JUMP26 S+A-P 写入 B,取 X 的 [27:2] 位,检查 -2^27 <= X < 2^27名字末尾的 NC 是 no check:低 12 位总是装得下,没什么可检查的;能不能够得着,由配对的 HI21 那条负责。LDST32 只取 [11:2] 位,是因为 32 位的 ldr 会把立即数自动乘以 4,所以要求地址 4 字节对齐。如果是取地址而不是读值,第二条指令就是 add,用 ADD_ABS_LO12_NC,kinds.c 编出来就是这样:
$ clang --target=aarch64-unknown-linux-gnu -O1 -fno-pic -c kinds.c -o a64k.o$ llvm-objdump -d -r a64k.o0000000000000000 <addr_of>: 0: 90000000 adrp x0, 0x0 <addr_of> 0000000000000000: R_AARCH64_ADR_PREL_PG_HI21 counter 4: 91000000 add x0, x0, #0x0 0000000000000004: R_AARCH64_ADD_ABS_LO12_NC counter 8: d65f03c0 ret用 lld 把 a64.o 和 AArch64 版的 add.o 链接起来,读出 S 和 P:
$ clang --target=aarch64-unknown-linux-gnu -O1 -c add.c -o add64.o$ ld.lld -static -e main a64.o add64.o -o app64$ llvm-readelf -s app64 | grep -E ' (main|add|counter)$' 10: 0000000000210198 16 FUNC GLOBAL DEFAULT 2 main 11: 00000000002201b0 4 OBJECT GLOBAL DEFAULT 3 counter 12: 00000000002101a8 8 FUNC GLOBAL DEFAULT 2 addmain 在 0x210198,counter 在 0x2201b0,add 在 0x2101a8。手算三条指令:
ADRP:.text 起点 = 0x210198;重定位偏移 = 0x0;P = 0x210198;S = counter = 0x2201b0;A = 0 Page(S + A) - Page(P) = 0x220000 - 0x210000 = 0x10000,即 0x10 页 ADRP 的 21 位页号拆成 immlo(2 位,放在第 29–30 位)和 immhi(19 位,放在第 5–23 位) 0x10 → immlo = 0, immhi = 4 0x90000008 | (4 << 5) = 0x90000088
LDR:重定位偏移 = 0x8;P = 0x2101a0;S = 0x2201b0;A = 0 S + A 的低 12 位 = 0x1b0,取 [11:2] 位得 0x6c,放在第 10–21 位 0xb9400100 | (0x6c << 10) = 0xb941b100
B:重定位偏移 = 0xc;P = 0x2101a4;S = add = 0x2101a8;A = 0 S + A - P = 0x2101a8 - 0x2101a4 = 4,右移 2 位得 1 0x14000000 | 1 = 0x14000001链接结果:
$ llvm-objdump -d app640000000000210198 <main>: 210198: 90000088 adrp x8, 0x220000 <add+0xfe58> 21019c: 52800041 mov w1, #0x2 // =2 2101a0: b941b100 ldr w0, [x8, #0x1b0] 2101a4: 14000001 b 0x2101a8 <add>三个指令字和手算完全一致。llvm-objdump 按指令字显示,存进文件时同样是小端序,90000088 在文件里是 88 00 00 90。
和 x86 对比可以看出两种设计的取舍。x86 一条指令、一个 32 位字段、一条重定位,但字段的含义要靠加数来修正(−4、−8、−5)。AArch64 两条指令、两条重定位,每条只负责地址的一部分,并且 ADRP 只看页号,P 的低 12 位根本不参与计算,所以不存在"PC 指向哪里"的偏差,加数一般就是 0。对链接器来说,AArch64 多出来的工作是把计算结果拆成位段,按每种指令各自的格式塞回去。
AArch64 同样有 GOT 版本和对应的 relaxation。读外部变量时,代码变成 adrp + ldr(读 GOT 项)+ ldr(读变量),重定位类型是 R_AARCH64_ADR_GOT_PAGE 和 R_AARCH64_LD64_GOT_LO12_NC。aaelf64 描述了链接器在符号不可被替换时,把前两条改写成 adrp + add 的优化,条件包括两条指令连续、使用同一个寄存器等,思路和 x86 的 mov 改 lea 一样,指令长度也不变。
够不着的跳转:thunk 与 veneer
上面那张表里,JUMP26 的检查条件是 −2^27 ≤ X < 2^27。b 和 bl(branch with link,跳转的同时把返回地址存进 x30,用于函数调用,对应的重定位是 R_AARCH64_CALL26)都只有 26 位立即数,乘以 4 之后能跳 ±128 MiB。编译器生成 bl far_func 时不知道两个函数最后相距多远;等到链接器发现够不着,指令已经定型,一条 4 字节的 bl 没法原地换成更长的序列。
可以把两个函数人为拉开。far_func 用 section 属性单独放进一个叫 .far 的节,再用 --section-start 把 .text 和 .far 分别放到 0x210000 和 0x10000000,相距约 254 MiB:
// near.cint far_func(int x);int main(void) { return far_func(41) + 1; }// far.c__attribute__((section(".far"))) /* 单独放进一个叫 .far 的节 */int far_func(int x) { return x + 1; }$ clang --target=aarch64-unknown-linux-gnu -O1 -c near.c -o near.o$ clang --target=aarch64-unknown-linux-gnu -O1 -c far.c -o far.o$ ld.lld -static -e main near.o far.o --section-start=.text=0x210000 --section-start=.far=0x10000000 -o thunk$ llvm-objdump -d thunk0000000000210000 <main>: 210000: a9bf7bfd stp x29, x30, [sp, #-0x10]! 210004: 910003fd mov x29, sp 210008: 52800520 mov w0, #0x29 // =41 21000c: 94000005 bl 0x210020 <__AArch64AbsLongThunk_far_func> 210010: 11000400 add w0, w0, #0x1 210014: a8c17bfd ldp x29, x30, [sp], #0x10 210018: d65f03c0 ret 21001c: 00000000 udf #0x0
0000000000210020 <__AArch64AbsLongThunk_far_func>: 210020: 58000050 ldr x16, 0x210028 <__AArch64AbsLongThunk_far_func+0x8> 210024: d61f0200 br x16 210028: 00 00 00 10 .word 0x10000000 21002c: 00 00 00 00 .word 0x00000000
Disassembly of section .far:
0000000010000000 <far_func>:10000000: 11000400 add w0, w0, #0x110000004: d65f03c0 retnear.o 里那条重定位是 R_AARCH64_CALL26 far_func,lld 没有报错,而是让 bl 先跳到一段它自己生成的小代码 __AArch64AbsLongThunk_far_func,就放在 main 后面、bl 够得着的地方。这段代码用 ldr 从紧跟其后的 8 字节里读出 far_func 的完整地址 0x10000000,放进 x16,再用 br x16 间接跳过去。返回地址是 bl 存进 x30 的,仍然指向 main 里的下一条指令,所以 far_func 返回时直接回到 main,跳板不在返回路径上。21001c 处的 4 个零字节被反汇编成 udf(永久未定义指令),只是对齐用的填充。顺带一提,这个输出文件有 254 MiB 大,两个节之间的空隙在文件里也占了位置,做完实验记得删掉。
这类由链接器插入、替一条短跳转"接力"的代码,lld 叫 range extension thunk(范围扩展跳板),Arm 的规范叫 veneer,也有人叫 stub 或 trampoline,说的是同一种东西。aaelf64 在 "Call and Jump relocations" 一节允许链接器为 CALL26、JUMP26 插入 veneer,并规定 veneer 只能破坏 IP0、IP1 两个寄存器和条件标志。AArch64 的调用约定 AAPCS64 把 x16、x17 定名为 IP0、IP1(intra-procedure-call 临时寄存器),调用方不能指望它们在一次函数调用前后保持不变,所以跳板可以放心拿 x16 来用。
边界也可以试出来。把 .far 放到 0x8210008,距离是 0x8210008 − 0x21000c = 0x7fffffc = 2^27 − 4,是 bl 能表达的最大正距离,lld 直接填了 95ffffff;再往后挪 4 字节到 0x821000c,跳板就出现了。如果链接成 PIE,lld 换用另一种跳板 __AArch64ADRPThunk_far_func,内容是 adrp x16 + add x16 + br x16,用前面讲过的页寻址在 ±4 GiB 内算出目标,不必在文件里存绝对地址,也就不需要动态重定位。
x86-64 很少需要这种东西。call 和 jmp 的 32 位相对位移(rel32)本来就能跳 ±2 GiB,而 small code model 已经约定整个程序在 2 GiB 以内,正常情况下 PLT32 不会溢出。真的越界时,两个链接器都只报错,不插跳板:
$ ld.lld -static -e main nearx.o farx.o --section-start=.text=0x210000 --section-start=.far=0x90000000 -o txld.lld: error: nearx.o:(function main: .text+0x7): relocation R_X86_64_PLT32 out of range: 2413756405 is not in [-2147483648, 2147483647]; references 'far_func'
$ ld -static -e main nearx.o farx.o --section-start=.text=0x210000 --section-start=.far=0x90000000 -o txnear.c:(.text+0x7): relocation truncated to fit: R_X86_64_PLT32 against symbol `far_func' defined in .far section in farx.o(nearx.o、farx.o 是同样两个文件的 x86-64 版本;输出有裁剪,两个链接器还各报了一条 .eh_frame 里的 PC32 溢出。)far_func 在同一个静态链接里,不需要 PLT 条目,链接器按 PC32 的算法求值,但报错时写的仍是记录本身的类型 R_X86_64_PLT32,类型没有变。x86-64 的出路在编译器一侧:前面看到的 large 模型把调用改成 movabs 加 jmp *%rax,代价由每一处调用承担。AArch64 的 bl 只能跳 ±128 MiB,大型程序的 .text 节完全可能超过这个尺寸,要是为此给每一处调用都换成长序列,代价太大,所以由链接器按需补救,只有够不着的那几处才多跳一次。MaskRay 的 Long branches in compilers, assemblers, and linkers 把十几种架构的跳转范围列成一张表,逐一说明汇编器和链接器各自怎么处理,PowerPC64、32 位 ARM 也靠 thunk;RISC-V、LoongArch 则反过来,先生成能跳得远的长序列,再靠下一节的 relaxation 缩短。
RISC-V:会改变代码长度的 relaxation
到这里为止的 relaxation 都有一个共同点:改写前后字节数不变。RISC-V 走得更远。这一节在同一台 Linux 上用 LLVM 21.1.8 显式选择 RISC-V 目标,生成对象后检查编码,并加 -fno-pic 得到最朴素的绝对寻址形式:
$ clang --target=riscv64-unknown-linux-gnu -O1 -fno-pic -c main.c -o rv.o$ llvm-objdump -d -r rv.o0000000000000000 <main>: 0: 00000537 lui a0, 0x0 0000000000000000: R_RISCV_HI20 counter 0000000000000000: R_RISCV_RELAX *ABS* 4: 00052503 lw a0, 0x0(a0) 0000000000000004: R_RISCV_LO12_I counter 0000000000000004: R_RISCV_RELAX *ABS* 8: 4589 li a1, 0x2 a: 00000317 auipc t1, 0x0 000000000000000a: R_RISCV_CALL_PLT add 000000000000000a: R_RISCV_RELAX *ABS* e: 00030067 jr t1 <main+0xa>lui(load upper immediate)把 20 位立即数放进寄存器的第 12–31 位,lw 以"寄存器 + 12 位有符号偏移"为地址读 4 字节,两条合起来读出 counter,重定位 R_RISCV_HI20 和 R_RISCV_LO12_I 各填一半。这和 AArch64 的"高位 + 低 12 位"是同一种结构,只是 lui 给的是绝对地址的高位。li a1, 2 把常数 2 放进第二个参数寄存器。auipc(add upper immediate to PC)把 20 位立即数左移 12 位后加上当前 PC,jr 是 jalr 不保存返回地址的写法,跳到"寄存器 + 12 位偏移";这一对完成到 add 的尾调用,一条 R_RISCV_CALL_PLT 同时负责两条指令。
把地址拆成"高 20 位 + 低 12 位"有一个容易算错的地方:lw 的 12 位偏移是有符号数,范围 −2048 到 2047;低 12 位的最高位(第 11 位)一旦是 1,lw 会把它当成负数。为了补上这个差,高 20 位要多加 1。RISC-V psABI 写成公式就是 HI20 = (symbol_address + 0x800) >> 12:加 0x800 正好在第 11 位为 1 时向第 12 位进一。
用 --section-start 把 counter 所在的 .data 放到一个低 12 位大于等于 0x800 的地址上就能看到:
$ clang --target=riscv64-unknown-linux-gnu -O1 -fno-pic -c add.c -o rvadd.o$ ld.lld -static --no-relax -e main rv.o rvadd.o --section-start=.data=0x12ff0 -o rv.hi$ llvm-objdump -d rv.hi0000000000015038 <main>: 15038: 00013537 lui a0, 0x13 1503c: ff052503 lw a0, -0x10(a0) 15040: 4589 li a1, 0x2$ llvm-readelf -s rv.hi | grep counter 16: 0000000000012ff0 4 OBJECT GLOBAL DEFAULT 1 counter(lld 把 .text 排到了 .data 后面,这不影响下面的计算。)
S = counter = 0x12ff0;A = 0;直接取高 20 位 = 0x12;低 12 位 = 0xff0,按 12 位有符号数是 0xff0 - 0x1000 = -0x10HI20 = (S + A + 0x800) >> 12 = 0x137f0 >> 12 = 0x13;LO12 = -0x10;(0x13 << 12) + (-0x10) = 0x13000 - 0x10 = 0x12ff0lui 的立即数是 0x13,比"直接取高 20 位"的 0x12 多 1,lw 的偏移是 −0x10,两者相加回到 0x12ff0。链接器如果忘了加 0x800,算出来的地址会差 4096 字节,而且不会报任何错。
每处地址引用都多带了一条 R_RISCV_RELAX,它不要求修改任何字节,只是告诉链接器"这里允许缩短"。按 RISC-V psABI(riscv-elf.adoc),目标在 ±1MiB 以内时,auipc + jalr 这 8 字节的一对可以换成一条 4 字节的 jal。用 lld 分别开、关 relaxation 链接一次:
$ ld.lld -static --no-relax -e main rv.o rvadd.o -o rv.norelax$ ld.lld -static -e main rv.o rvadd.o -o rv.relax$ llvm-objdump -d rv.norelax00000000000111d0 <main>: 111d0: 00012537 lui a0, 0x12 111d4: 1e852503 lw a0, 0x1e8(a0) 111d8: 4589 li a1, 0x2 111da: 00000317 auipc t1, 0x0 111de: 00830067 jr 0x8(t1) <add>
00000000000111e2 <add>:$ llvm-objdump -d rv.relax00000000000111d0 <main>: 111d0: 00012537 lui a0, 0x12 111d4: 1e052503 lw a0, 0x1e0(a0) 111d8: 4589 li a1, 0x2 111da: a009 j 0x111dc <add>
00000000000111dc <add>:(输出有裁剪。)8 字节的 auipc + jr 变成了一条 2 字节的 j:目标就在隔壁,clang 默认的 riscv64 Linux 目标又启用了压缩指令扩展,lld 直接选用了 2 字节的压缩跳转 c.j。main 从 18 字节缩到 12 字节,add 从 0x111e2 前移到 0x111dc,counter 也从 0x121e8 挪到 0x121e0,于是 lw 里的低 12 位从 0x1e8 变成 0x1e0。
lui/lw 上的 RELAX 表示另一种缩短:如果 counter 离全局指针寄存器 gp 所指的位置在 ±2KB 以内,可以删掉 lui,把 lw 改成以 gp 为基址。本例没有发生,是因为 lld 默认不做这种优化(要加 --relax-gp),而且它要求链接里定义了 __global_pointer$ 符号(通常由链接脚本提供),本例的链接里没有这个符号。实测加上 --relax-gp 并用 --defsym 补上这个符号后,lui 确实消失了,lw 变成了 lw a0, 0x1dc(gp)。
gp 只够得着前后各 2KB,所以编译器会把小变量单独放进 .sdata、.sbss 两个小数据节(small data,分别对应 .data 和 .bss),由链接器集中排在一起,__global_pointer$ 通常就定在这块区域里。clang 以 riscv64 Linux 为目标时默认不分,本例的 counter 在普通的 .data 里;加上 -msmall-data-limit=8(不超过 8 字节的变量算小数据)重新编译,counter 就进了 .sdata。xv615 的 kernel.ld 也收了 .sdata、.sbss,只是直接并进 .data 和 .bss,注释写着不需要区分。
lui 加 12 位偏移拼出的是绝对地址,RISC-V psABI 把这种用法叫 medlow 模型。RV64 上 lui 的结果会被符号扩展,所以它只够得着地址空间最低和最高的各约 2 GiB。xv6 的内核链接在 0x80000000,恰好落在 medlow 够不着的地方:
$ ld.lld -static --no-relax -e main rv.o rvadd.o --section-start=.text=0x80000000 -o rv.kld.lld: error: rv.o:(function main: .text+0x0): relocation R_RISCV_HI20 out of range: 524290 is not in [-524288, 524287]; references 'counter'524290 是 0x80002,超出了 20 位有符号数的范围。xv6 的 Makefile 里写的是 CFLAGS += -mcmodel=medany。medany 模型改用 auipc,地址相对于当前 PC 计算,只要求目标在指令前后 2 GiB 以内,放在哪个绝对地址都行:
$ clang --target=riscv64-unknown-linux-gnu -O1 -fno-pic -mcmodel=medany -c main.c -o rvm.o$ llvm-objdump -d -r rvm.o 0: 00000517 auipc a0, 0x0 0000000000000000: R_RISCV_PCREL_HI20 counter 4: 00052503 lw a0, 0x0(a0) 0000000000000004: R_RISCV_PCREL_LO12_I .Lpcrel_hi0$ ld.lld -static --no-relax -e main rvm.o rvaddm.o --section-start=.text=0x80000000 -o rv.k2$ llvm-objdump -d rv.k20000000080000000 <main>:80000000: 00002517 auipc a0, 0x280000004: 05852503 lw a0, 0x58(a0)(rvaddm.o 是同样选项编译的 add.c;输出有裁剪,R_RISCV_RELAX 没有列出。)counter 在 0x80002058:auipc 得到 0x80000000 + 0x2000,lw 再加 0x58。低 12 位那条重定位引用的不是 counter,而是 auipc 所在位置的局部标号 .Lpcrel_hi0:PC 相对的低 12 位要用 auipc 那条指令的 P 来算,链接器得先找到配对的高位重定位。
删掉字节之后,后续位置可能改变,其他引用的 P 和 S 也要更新;有些调用会因此进入可缩短的范围,链接器需要重新评估。对齐又增加了一层依赖:R_RISCV_ALIGN 让链接器从预留的填充中删除适当数量的字节,以满足新布局的对齐要求。不能简单用“所有距离只会变短”证明整个布局算法收敛,节对齐和固定地址也参与决定距离。对可能跨过删减区域的局部跳转,即使目标在同一函数里,汇编器也需要留下供链接器修正的重定位;原先按输入位置算出的距离未必仍然有效。规范分别规定了对齐重定位与松弛规则。
重定位记录的体积:CREL
前面的架构差异改变了计算和编码方式;还有一种成本与计算是否复杂无关:记录本身占用的空间。ELF64 的 RELA 每条 24 字节,而且其中大部分字节是冗余的。main.o 的 .rela.text 一共 48 字节:两个 offset 只差 10,两个类型号都很小,加数都是 −4,高位几乎全是零。在一个大型 C++ 项目里,.rela.* 节可能占到目标文件体积的相当一部分。
CREL 是针对这个问题提出的紧凑格式,第 1 章提过它的名字。它由 LLVM 开发者 MaskRay(宋方睿)在 2024 年 3 月提出,早期叫 RELLEB(设计文章)。思路很直接:记录按 offset 排序后,只存和前一条记录的差值,再用第 2 章讲过的 LEB12816 变长编码,小数字只占一个字节。
本机 Clang17 21.1.8 能产出 CREL,不过要显式打开,并允许这里使用的非标准节类型编号:
$ clang -O1 -Wa,--crel -c main.c -o crel.oclang: error: -Wa,--allow-experimental-crel must be specified to use -Wa,--crel. CREL is experimental and uses a non-standard section type code$ clang -O1 -Wa,--crel,--allow-experimental-crel -c main.c -o crel.o$ llvm-objdump -s -j .crel.text crel.oContents of section .crel.text: 0000 150f0402 7c2b0102 ....|+..同样两条重定位,从 48 字节变成了 8 字节。按设计文章里的规则,可以逐字节解出来:
15:头部,ULEB12818 编码的count * 8 + addend_bit * 4 + shift。0x15 = 2×8 + 1×4 + 1,即 2 条记录、显式存储加数、offset 差值右移 1 位存储(两个 offset 2 和 12 都是偶数)。0f:第一条的delta_offset * 8 + flags。0x0f = 1×8 + 7,offset 差值 1 左移 1 位得 2;flags 为 7,表示后面依次跟着符号、类型、加数三个差值。04027c:符号下标差 4、类型差 2、加数差 −4(SLEB128 单字节 0x7c 是 −4)。第一条的"前一条"视为全零,所以就是符号 4、类型 2、加数 −4。2b:第二条,0x2b = 5×8 + 3,offset 差 5 左移 1 位得 10,2 + 10 = 12;flags 为 3,只有符号和类型变了,加数沿用 −4。0102:符号下标 4 + 1 = 5,类型 2 + 2 = 4。
用 llvm-readelf -r crel.o 解码出来,内容和 main.o 的 .rela.text 完全一致。两个链接器对它的态度则截然不同:
$ ld.lld -static -e main crel.o add.o -o app.crel$ llvm-objdump -d app.crel00000000002011b0 <main>: 2011b0: 8b 3d 0e 10 00 00 mov 0x100e(%rip),%edi # 2021c4 <counter> 2011b6: be 02 00 00 00 mov $0x2,%esi 2011bb: e9 00 00 00 00 jmp 2011c0 <add>$ ld -static -e main crel.o add.o -o app.crel2ld: unknown architecture of input file `crel.o' is incompatible with i386:x86-64 outputld: error in crel.o(.eh_frame); no .eh_frame_hdr table will be createdlld 21 读懂了 CREL,产出的字节和前面用 main.o 链接的结果一模一样;GNU ld 2.46 不认识这种节,连文件的架构都没能识别出来。设计文章里给出的数据是,用 clang 以 -O3 构建 lld 时,x86-64 目标文件的总大小下降了 18.0%。
报错信息里的 "non-standard section type code" 对应本实验的格式状态:LLVM 19.1 开始支持 CREL,这里的节类型 SHT_CREL 使用 0x40000014 是 LLVM 临时选的一个值,它不在 gABI19 留给操作系统、处理器或用户自定义的区间里(这些区间分别从 SHT_LOOS 0x60000000、SHT_LOPROC 0x70000000、SHT_LOUSER 0x80000000 开始),而是 gABI 尚未分配的编号。2024 年 9 月提交给 generic-abi 的提案希望正式定为 0x14,对应的动态段标记 DT_CREL 也从临时的 0x40000026 改为 0x26;这里记录的是上述 LLVM 21 工具采用的实验性编号,不把它视为跨版本兼容承诺;正式编号与支持范围应以所用工具链和对应 ABI 文档为准。
所有的计算都缺一样东西
回头看这一章做过的每一次手算,第一步都是同一件事:先去 readelf -s、readelf -S 里查出链接器把东西放在了哪里。S 是符号的地址,P 是"输入节起点 + 节内偏移",L 和 GOT 是链接器自己生成的跳板和表格的位置。公式本身只是加减法和位运算,输入全靠这些地址。同样两个 .o,GNU ld 把 main 放在 0x401000,lld 放在 0x2011b0,填进去的字节也就不同;RISC-V 的例子更说明,地址分配和重定位甚至会互相影响。
所以链接器在动手填字节之前,必须先决定每个节放在哪里。同样的输入,两个链接器为什么选了不同的起点?没人引用的节,能不能直接扔掉?这些都是布局要回答的问题。
练习
答案在章末。完整输入、命令与跨 ISA 编码对照均在本章相应小节给出;主线编译器使用 Linux 本机目标。
观察
-
把每条重定位读成一封写给链接器的信。编译下面的
obs.c,用llvm-objdump -d -r obs.o查看,把.text里的三条重定位各翻译成一句话,格式是"亲爱的链接器:请在某节偏移某处的几个字节里,填入某某的值"。然后用llvm-objdump -t和llvm-readelf -S查一下,第二条引用的.L.str是什么、在哪个节里,为什么汇编器没有像.eh_frame那样写成"节符号加偏移"。// obs.cextern int limit;void warn(const char *msg);int check(int v) {if (v > limit)warn("too big");return v;}
手算与预测
-
变量清单手算。下面的
ex.c用默认选项编译,data.c只有一行int total = 7;,用ld.lld -static -e get ex.o data.o -o ex2链接。// ex.cextern int total;static int hits;int *slot = &total;int get(void) { return total; }int bump(void) { return ++hits; }$ llvm-objdump -d -r ex.o0000000000000000 <get>:0: 48 8b 05 00 00 00 00 movq (%rip), %rax # 0x7 <get+0x7>0000000000000003: R_X86_64_REX_GOTPCRELX total-0x47: 8b 00 movl (%rax), %eax9: c3 retq...0000000000000010 <bump>:10: 8b 05 00 00 00 00 movl (%rip), %eax # 0x16 <bump+0x6>0000000000000012: R_X86_64_PC32 .bss-0x416: ff c0 incl %eax18: 89 05 00 00 00 00 movl %eax, (%rip) # 0x1e <bump+0xe>000000000000001a: R_X86_64_PC32 .bss-0x41e: c3 retq$ readelf -rW ex.o | grep R_X86_64_640000000000000000 0000000600000001 R_X86_64_64 0000000000000000 total + 0$ readelf -SW ex2 | grep -E 'text|data|bss'[ 2] .text PROGBITS 0000000000201210 000210 000020 00 AX 0 0 16[ 5] .data PROGBITS 0000000000203230 000230 00000c 00 WA 0 0 8[ 6] .bss NOBITS 000000000020323c 00023c 000004 00 WA 0 0 4$ readelf -sW ex2 | grep -E ' (get|bump|total|slot|hits)$'2: 000000000020323c 4 OBJECT LOCAL DEFAULT 6 hits4: 0000000000201210 10 FUNC GLOBAL DEFAULT 2 get5: 0000000000203238 4 OBJECT GLOBAL DEFAULT 5 total6: 0000000000201220 15 FUNC GLOBAL DEFAULT 2 bump7: 0000000000203230 8 OBJECT GLOBAL DEFAULT 5 slotex.o的.text、.data、.bss都是对应输出节里的第一块。对每条重定位先列出变量清单(节起点、重定位偏移、P、S、A),再写一行算式,求出链接器写进去的字节:(a)slot处的R_X86_64_64;(b)bump里的两处R_X86_64_PC32;(c)get里的REX_GOTPCRELX,lld 会把它改写成lea,写出改写后的 7 个字节。最后用llvm-objdump -d ex2和llvm-objdump -s -j .data ex2自查。 -
AArch64 页计算。把
ex.c、data.c用--target=aarch64-unknown-linux-gnu -O1 -fno-pic编译,get在目标文件里是adrp x8加ldr w0, [x8],原始指令字分别是90000008和b9400100,重定位是ADR_PREL_PG_HI21 total和LDST32_ABS_LO12_NC total。用ld.lld -static -e get exa.o dataa.o --section-start=.data=0x12345670链接后,get在 0x123656c4,total在 0x12345678。求链接后的两个指令字。注意这次目标在代码前面。 -
反向手算。手里只有链接好的文件,没有重定位表:
-
(a) x86-64:
201228: 89 05 0e 20 00 00 mov %eax,XXX(%rip),这条指令访问的变量地址是多少? -
(b) AArch64:本章"够不着的跳转"一节的
near.c、far.c用-fPIC编译、链接成 PIE,lld 生成的跳板是21001c: 9007ef90 adrp x16, ...210020: 91000210 add x16, x16, #0x0210024: d61f0200 br x16只用这三个指令字,算出跳板最终跳去的地址。
-
改坏
-
(a) 显式用 small 模型编译下面两个文件,再用两个链接器各链接一次。先预测:会不会报错?如果报错,是哪条重定位、哪个符号?然后换成
-mcmodel=medium修好它,说明big和tab各自怎么被访问。// big.cchar big[1UL << 31]; /* 2 GiB */// idx.cextern char big[];int tab[4];int pick(long i) { return tab[i] + big[i]; }$ clang -O1 -fno-pic -mcmodel=small -c big.c -o big.o$ clang -O1 -fno-pic -mcmodel=small -c idx.c -o idx.o$ ld -static -e pick big.o idx.o -o pk$ ld.lld -static -e pick big.o idx.o -o pk(b) 回到"够不着的跳转"一节的
near.o、far.o,保持--section-start=.text=0x210000,把.far依次放到 0x8210008 和 0x821000c。哪一次会出现跳板?先用bl的位置 0x21000c 和 26 位立即数的范围算出来,再链接验证。
答案
练习一
$ llvm-objdump -d -r obs.o0000000000000000 <check>: 0: 53 pushq %rbx 1: 89 fb movl %edi, %ebx 3: 48 8b 05 00 00 00 00 movq (%rip), %rax # 0xa <check+0xa> 0000000000000006: R_X86_64_REX_GOTPCRELX limit-0x4 a: 3b 38 cmpl (%rax), %edi c: 7e 0c jle 0x1a <check+0x1a> e: 48 8d 3d 00 00 00 00 leaq (%rip), %rdi # 0x15 <check+0x15> 0000000000000011: R_X86_64_PC32 .L.str-0x4 15: e8 00 00 00 00 callq 0x1a <check+0x1a> 0000000000000016: R_X86_64_PLT32 warn-0x4 1a: 89 d8 movl %ebx, %eax 1c: 5b popq %rbx 1d: c3 retq- 亲爱的链接器:请在
.text偏移 0x6 处的 4 个字节里,填入"存放limit地址的那个 GOT 项"离这里多远,再减 4。前面 3 个字节是一条带 REX 前缀的mov,如果limit最后就在本模块里,你可以把它改成lea,直接填到limit的距离。 - 亲爱的链接器:请在
.text偏移 0x11 处的 4 个字节里,填入字符串.L.str离这里多远,再减 4。 - 亲爱的链接器:请在
.text偏移 0x16 处的 4 个字节里,填入到warn的距离再减 4;如果warn在共享库里,就让它指向你生成的 PLT 条目。
.L.str 是汇编器留下的局部符号,llvm-objdump -t 显示它是 l O .rodata.str1.1,长度 8,就是 "too big" 加结尾的零。.rodata.str1.1 的标志是 AMS,M 和 S 表示这是一个可合并的字符串节:链接器会把各个文件里相同的字符串合成一份,字符串在输出里的位置会变(第 5 章讲合并)。即使没有重复,lld 默认也会把这种节拆成一个个字符串重新排放,顺序可能和输入不同,加 -O0 才原样保留;GNU ld 保持原顺序:
$ llvm-objdump -s -j .rodata.str1.1 strs.o 0000 746f6f20 62696700 616c7068 61007a65 too big.alpha.ze$ ld.lld -static -e f strs.o w.o -o s.out$ llvm-objdump -s -j .rodata s.out 200120 746f6f20 62696700 6d696400 68656c6c too big.mid.hell$ ld.lld -O0 -static -e f strs.o w.o -o s.out$ llvm-objdump -s -j .rodata s.out 200120 746f6f20 62696700 616c7068 61007a65 too big.alpha.ze(strs.c 依次把 "too big"、"alpha"、"zeta"、"mid"、"x"、"hello world" 传给外部函数 warn,w.o 里是 warn 的空定义;输出有裁剪。)所以引用字符串的重定位不能按输入里的偏移预先算好,要等合并之后再查。链接器要按"引用落在哪个字符串上"来找它的新位置,如果写成"节符号加 −4",指向的是这个节开头之前的一个字节,链接器分不出引用的是哪个字符串,所以加数不为零时,汇编器保留了指向字符串本身的符号。可以对照一下加数为零的情况,const char *p = "too big"; 编出来的 .data 重定位就是 R_X86_64_64 .rodata.str1.1,用的是节符号。
练习二
(a) .data 起点 = 0x203230;重定位偏移 = 0x0;S = total = 0x203238;A = 0 S + A = 0x203238,写 8 字节 38 32 20 00 00 00 00 00
(b) 第一处:.text 起点 = 0x201210;重定位偏移 = 0x12;P = 0x201222;S = .bss 节符号 = 0x20323c;A = -4 S + A - P = 0x20323c - 4 - 0x201222 = 0x2016,写 16 20 00 00 第二处:重定位偏移 = 0x1a;P = 0x20122a;S = 0x20323c;A = -4 S + A - P = 0x20323c - 4 - 0x20122a = 0x200e,写 0e 20 00 00
(c) .text 起点 = 0x201210;重定位偏移 = 0x3;P = 0x201213;S = total = 0x203238;A = -4 S + A - P = 0x203238 - 4 - 0x201213 = 0x2021;opcode 8b 改成 8d 写 48 8d 05 21 20 00 00节符号 .bss 的值是 ex.o 的 .bss 在输出里的起点,这里它是输出 .bss 的第一块,所以就是 0x20323c,也就是 hits 的地址。核对:
$ llvm-objdump -d ex20000000000201210 <get>: 201210: 48 8d 05 21 20 00 00 lea 0x2021(%rip),%rax # 203238 <total> 201217: 8b 00 mov (%rax),%eax 201219: c3 ret...0000000000201220 <bump>: 201220: 8b 05 16 20 00 00 mov 0x2016(%rip),%eax # 20323c <hits> 201226: ff c0 inc %eax 201228: 89 05 0e 20 00 00 mov %eax,0x200e(%rip) # 20323c <hits> 20122e: c3 ret$ llvm-objdump -s -j .data ex2 203230 38322000 00000000 07000000 82 .........同样两个文件交给 GNU ld(ld -static -e get ex.o data.o),get 的第一条指令变成 48 c7 c0 08 30 40 00,即 mov $0x403008,%rax。这是 psABI 改写表里的第二行:输出不是 PIE,total 又在低 32 位地址里,链接器直接把地址当立即数写进指令,这时 48 c7 c0 后面的 4 字节按 32S 的方式写入,算式是 S + A,A 不再是 −4。
练习三
ADRP:.text 中 get 的地址 = 0x123656c4;重定位偏移 = 0x0;P = 0x123656c4;S = total = 0x12345678;A = 0 Page(S + A) - Page(P) = 0x12345000 - 0x12365000 = -0x20000,即 -0x20 页 21 位补码:0x200000 - 0x20 = 0x1fffe0 → immlo = 0x1fffe0 & 3 = 0,immhi = 0x1fffe0 >> 2 = 0x7fff8 0x90000008 | (0 << 29) | (0x7fff8 << 5) = 0x90ffff08
LDR:重定位偏移 = 0x4;S = 0x12345678;A = 0 低 12 位 = 0x678,取 [11:2] 位得 0x19e 0xb9400100 | (0x19e << 10) = 0xb9467900$ llvm-objdump -d exa00000000123656c4 <get>:123656c4: 90ffff08 adrp x8, 0x12345000123656c8: b9467900 ldr w0, [x8, #0x678]123656cc: d65f03c0 ret和正文一样,lld 把 .text 排在了 --section-start 指定的 .data 后面,所以页差是负的。
练习四
(a) 位移字段 0e 20 00 00 按小端读出是 0x200e;指令长 6 字节,下一条指令在 0x201228 + 6 = 0x20122e;目标 = 0x20122e + 0x200e = 0x20323c。这就是练习二里的 hits,llvm-objdump 的注释 # 20323c <hits> 也是这么算的。
(b)
adrp:指令字 = 0x9007ef90;P = 0x21001c immlo = (0x9007ef90 >> 29) & 3 = 0;immhi = (0x9007ef90 >> 5) & 0x7ffff = 0x3f7c 页数 = (0x3f7c << 2) | 0 = 0xfdf0,最高位为 0,是正数 x16 = Page(P) + 0xfdf0 × 0x1000 = 0x210000 + 0xfdf0000 = 0x10000000add:立即数 = (0x91000210 >> 10) & 0xfff = 0,x16 不变br x16:跳到 0x100000000x10000000 正是 far_func。实测反汇编(nearp.o、farp.o 是加 -fPIC 编译的两个文件):
$ ld.lld -pie -e main nearp.o farp.o --section-start=.text=0x210000 --section-start=.far=0x10000000 -o thunk.pie$ llvm-objdump -d thunk.pie000000000021001c <__AArch64ADRPThunk_far_func>: 21001c: 9007ef90 adrp x16, 0x10000000 <far_func> 210020: 91000210 add x16, x16, #0x0 210024: d61f0200 br x16练习五
(a) 会报错,出错的是 tab,不是 big:
$ llvm-objdump -d -r idx.o0000000000000000 <pick>: 0: 0f be 87 00 00 00 00 movsbl (%rdi), %eax 0000000000000003: R_X86_64_32S big 7: 03 04 bd 00 00 00 00 addl (,%rdi,4), %eax 000000000000000a: R_X86_64_32S tab e: c3 retq$ ld -static -e pick big.o idx.o -o pkidx.o: in function `pick':idx.c:(.text+0xa): relocation truncated to fit: R_X86_64_32S against symbol `tab' defined in .bss section in idx.o$ ld.lld -static -e pick big.o idx.o -o pkld.lld: error: idx.o:(function pick: .text+0xa): relocation R_X86_64_32S out of range: 2149589408 is not in [-2147483648, 2147483647]; references 'tab'>>> referenced by idx.c>>> defined in idx.o两处都是 32S,没有用 PC32:x86-64 的 RIP 相对寻址不能再带下标寄存器,big[i]、tab[i] 只能写成"32 位绝对位移 + 下标"。big 自己在 .bss 开头,地址很小;tab 排在 2 GiB 的 big 后面,lld 报的 2149589408 是 0x802021a0,lld 把 big 放在 0x2021a0,加上 0x80000000 就是 tab。0x802021a0 超过了 0x7fffffff,符号扩展后变成负地址。和正文 huge.c 那次一样,被挤出去的是排在大数组后面的小变量。
改用 -mcmodel=medium 重新编译两个文件后能链接:
$ llvm-objdump -d -r idx.o0000000000000000 <pick>: 0: 48 b8 00 00 00 00 00 00 00 00 movabsq $0x0, %rax 0000000000000002: R_X86_64_64 big a: 0f be 04 07 movsbl (%rdi,%rax), %eax e: 03 04 bd 00 00 00 00 addl (,%rdi,4), %eax 0000000000000011: R_X86_64_32S tab 15: c3 retq$ ld -static -e pick big.o idx.o -o pk$ llvm-objdump -d pk0000000000401000 <pick>: 401000: 48 b8 10 30 40 00 00 movabs $0x403010,%rax 401007: 00 00 00 40100a: 0f be 04 07 movsbl (%rdi,%rax,1),%eax 40100e: 03 04 bd 00 30 40 00 add 0x403000(,%rdi,4),%eax 401015: c3 ret$ readelf -SW pk | grep bss [ 3] .bss NOBITS 0000000000403000 003000 000010 00 WA 0 0 16 [ 4] .lbss NOBITS 0000000000403010 003000 80000000 00 WAl 0 0 16big 超过阈值,进了 .lbss,用 movabs 加 R_X86_64_64 取地址;tab 只有 16 字节,留在 .bss,仍然用 32S,现在它在 0x403000,装得下。
(b) bl 的立即数是 26 位有符号数,乘 4 后范围是 −2^27 到 2^27 − 4,即 −0x8000000 到 0x7fffffc。0x8210008 − 0x21000c = 0x7fffffc,正好是上限,直接 bl;0x821000c − 0x21000c = 0x8000000,超出 4 字节,出现跳板:
$ ld.lld -static -e main near.o far.o --section-start=.text=0x210000 --section-start=.far=0x8210008 -o t$ llvm-objdump -d t | grep bl 21000c: 95ffffff bl 0x8210008 <far_func>$ ld.lld -static -e main near.o far.o --section-start=.text=0x210000 --section-start=.far=0x821000c -o t$ llvm-objdump -d t | grep bl 21000c: 94000004 bl 0x21001c <__AArch64AbsLongThunk_far_func>95ffffff 的低 26 位是 0x1ffffff,乘 4 是 0x7fffffc。两个输出文件都有约 128 MiB,做完记得删掉。
参考
附录:x86-64 重定位记号与类型
记号依据 x86-64 psABI 的 Relocation 定义。A 是加数,S 是符号值,P 是被修改字段的位置;L 是符号的 PLT 条目地址;GOT 是全局偏移表地址,G 是符号的 GOT 条目相对于表起点的偏移。其他公式中的 B 表示运行时加载基址,Z 表示符号大小。具体重定位类型同时规定计算、字段宽度和结果的可表示性。
名称 值 字段 计算R_X86_64_64 1 word64 S + AR_X86_64_PC32 2 word32 S + A - PR_X86_64_PLT32 4 word32 L + A - PR_X86_64_GOTPCREL 9 word32 G + GOT + A - PR_X86_64_32 10 word32 S + AR_X86_64_32S 11 word32 S + AR_X86_64_GOTPCRELX 41 word32 G + GOT + A - PR_X86_64_REX_GOTPCRELX 42 word32 G + GOT + A - P附录:术语与工具
-
GNU — GNU 是 “GNU’s Not Unix” 的递归缩写,指自由软件操作系统项目。GCC、binutils 和 glibc 都属于 GNU 项目,但分别承担编译、二进制处理和 C 运行库职责。 官方文档。 ↩
-
binutils — GNU binutils 是一组处理目标文件的工具,包含汇编器
as、链接器ld,以及readelf、nm、objdump、ar等检查与归档工具。 官方文档。 ↩ -
ELF — ELF(Executable and Linkable Format)规定目标文件、可执行文件与共享对象的结构。通用规则见 gABI,架构相关的调用约定和重定位规则见对应 psABI。 官方文档。 ↩
-
RISC-V — RISC-V 是开放的指令集架构。本系列主线是在原生 x86-64 Linux 上构建链接器;RV64 用于架构对照与内核案例。相关例子的编码、寄存器约定和重定位规则见 RISC-V psABI,不能直接套用 x86-64 的规则。 ↩
-
LLVM — LLVM 是一组编译器与工具链项目的名称,包括优化基础设施、目标代码生成和相关工具。Clang、LLD 与 LLVM IR 各有职责,不能互作同义词。 官方文档。 ↩
-
GOT — GOT(Global Offset Table)保存供代码间接访问的地址或相关偏移。它让部分地址修补集中到数据表中;表项的具体用途由重定位类型与 ABI 决定。 官方文档。 ↩
-
psABI — psABI(processor-specific ABI)是特定处理器架构的二进制接口约定。不同架构可以共用 ELF 文件结构,同时拥有不同的指令、调用约定和重定位公式。 官方文档。 ↩
-
readelf —
readelf检查 ELF 头、节、段、符号及重定位等结构;它读取文件而不执行其中的程序。GNUreadelf与 LLVMllvm-readelf的显示格式可能不同。 官方文档。 ↩ -
LLD — LLD 是 LLVM 项目的链接器。ELF 平台通常通过
ld.lld调用;lld-link则提供兼容 Windows 工具链的接口。它与负责处理源码的 Clang 是不同组件。 官方文档。 ↩ -
FDE — FDE(Frame Description Entry)关联一段代码的地址范围与栈展开指令。移动代码或重新组织
.eh_frame时,链接器必须同步更新相关地址和记录间的引用。 官方文档。 ↩ -
PIE — PIE(position-independent executable)是可以在不同加载基址运行的可执行文件。生成 PIE 需要编译与链接选项配合;static-PIE 还需要自身的启动路径完成必要重定位。 官方文档。 ↩
-
ABI — ABI(Application Binary Interface)规定二进制组件如何协作,包括调用约定、数据布局和文件格式等。它约束编译结果之间的交接,比源码层面的 API 更靠近机器。 官方文档。 ↩
-
GCC — GCC(GNU Compiler Collection)是一组语言编译器。命令
gcc是驱动入口,会组织编译、汇编和链接;在终端调用它,并不意味着后续工作都在同一个进程里完成。 官方文档。 ↩ -
PIC — PIC(position-independent code)使用适合位置变化的寻址方式。它常用于共享库;具体通过 PC 相对寻址还是表项间接访问,取决于架构与符号绑定。 官方文档。 ↩
-
xv6 — xv6 是 MIT 用于操作系统教学的小型 Unix 风格内核。本系列采用 RISC-V 版本,借助较小的加载器与链接脚本观察 ELF 到进程的交接。 官方文档。 ↩
-
LEB128 — LEB128(Little Endian Base 128)逐组保存整数的七个有效位,常用于 DWARF 与 WebAssembly。它有无符号和有符号两种形式,不是固定宽度的小端整数。 官方文档。 ↩
-
Clang — Clang 是 LLVM 项目中的 C、C++ 等语言前端及驱动程序。它通常使用集成汇编器,但仍需调用链接器;最终使用哪个链接器取决于目标平台和配置。 官方文档。 ↩
-
ULEB128 — ULEB128 是无符号整数的变长编码:每字节低七位承载数值,最高位表示是否继续。SLEB128 是相应的有符号形式;解析时需要限制长度并检查溢出。 官方文档。 ↩
-
gABI — gABI 是通用 System V ABI,规定 ELF 等跨架构规则;psABI 是处理器相关补充,进一步规定寄存器约定、重定位编号与 TLS 等细节。 官方文档。 ↩