

[链接器的世界-原理篇05] 布局与 GC:给每个节找位置,让无用代码退场
一条 R_X86_64_PC32 重定位按 S + A − P 计算位移:S 是目标符号的地址,P 是待修补位置的地址,A 是加数。公式确定以后,答案仍然没有确定。同样的目标文件交给不同链接器,或只打开删除无用节的选项,S 和 P 都可能改变。
地址来自布局。输入文件只给出了各自节内的相对位置;多个节怎么相接、哪里需要留空、哪些字节应该同处一段,由链接器在输出文件里统一安排。这些决定既改变重定位的结果,也决定加载后的内存权限。
为观察这些变化,main.c 同时放入一个初始化过的全局变量、一个未初始化的大数组、一个只读字符串、两个函数,以及一个自己写的程序入口 _start(不链接 C 库,后面再说为什么叫这个名字):
int counter = 1; /* .data */int buffer[1024]; /* .bss */const char msg[] = "hi"; /* .rodata */
__attribute__((noinline)) int used(int x) { return x + counter; }__attribute__((noinline)) int unused(int x) { return x * 3; }
void _start(void) { buffer[0] = used(41); for (;;) { }}noinline 是为了不让编译器把 used 内联进 _start,否则后面的垃圾回收实验看不出效果。编译成目标文件,used 里读 counter 的那条指令还是一条带空位的"便条":
$ clang -O1 -fno-pic -fno-asynchronous-unwind-tables -c main.c -o plain.o$ llvm-objdump -d plain.o0000000000000000 <used>: 0: 89 f8 movl %edi, %eax 2: 03 05 00 00 00 00 addl (%rip), %eax # 0x8 <used+0x8> 8: c3 retq偏移 4 开始的 4 个字节是零,旁边挂着一条 R_X86_64_PC32 counter - 4。把 plain.o 交给 GNU1 ld 和 lld,可以观察链接器默认布局的差别;再把同一份源码按函数、变量分节,开启 GC2,可以观察删除内容怎样改变地址。先生成这三份输出:
ld plain.o -o bfdld.lld plain.o -o lldclang -O1 -fno-pic \ -fno-asynchronous-unwind-tables -ffunction-sections -fdata-sections \ -c main.c -o split.old --gc-sections split.o -o bfd_gc这条指令在三份输出中分别是:
GNU ld: addl 0x1ffc(%rip), %eax # 0x403004 <counter>GNU ld --gc-sections: addl 0xff8(%rip), %eax # 0x402000 <counter>lld: addl 0x103c(%rip), %eax # 0x2021a4 <counter>第二行的输入 split.o 多了 -ffunction-sections -fdata-sections;它们怎样为 GC 提供删除边界,后面再从节表和引用图中展开。重定位公式没变,加数没变,变的是 S 和 P。以第一行为例:used 被放在 0x401000,空位在它后面 4 个字节,P = 0x401004;counter 被放在 0x403004,S = 0x403004;于是 0x403004 − 4 − 0x401004 = 0x1ffc。
决定 used 落在 0x401000、counter 落在 0x403004 的那一步,叫布局(layout)。本章在 x86-64 Linux 上使用 Clang3 21.1.8、GNU ld/readelf 2.46 和 LLD4 21.1.8。编译、链接和权限实验均在本机进行。
地址分配依赖哪些大小
一个静态链接器大致按这样的顺序工作:读入所有输入文件;解析符号,给每个引用配上定义(第 3 章);可选地做垃圾回收(GC),删掉没人用的节;布局;最后写出文件,并在写的同时套用重定位(第 4 章)。这是不考虑迭代时的依赖顺序。第 4 章的 RISC-V5 松弛和远跳转桩会让大小与地址互相影响,真实实现可能在布局与调整之间往返。
布局为保留的内容分配输出位置:需要加载的内容有虚拟地址,有文件内容的部分还要安排文件偏移;BSS 这类零初始化存储只需要内存空间。地址是一个接一个排出来的:.text 从某个地址开始,第一个输入节占 9 字节,第二个输入节从下一个对齐位置开始,依此类推;.text 结束后,下一个输出节的起点又取决于 .text 的总长度。后面任何一块的地址,都依赖它前面所有块的大小。因此,一次布局计算需要一组确定的大小;如果后续优化改变了大小,就必须更新布局,而不能继续使用旧地址。
难处在于有些块的大小没法从输入文件里直接读出来,要等链接器加工完才知道。最常见的例子是字符串常量。下面是两个几乎一样的文件,各自调用一次 printf("hi"):
/* s1.c;s2.c 只是把 f1 换成 f2 */int printf(const char *, ...);void f1(void) { printf("hi"); }第三个文件 s0.c 给出一个什么也不做的 printf 和调用 f1、f2 的 _start,同样不链接 C 库。用 clang -O1 编译 s1.c,字符串 "hi" 没有进 .rodata,而是进了一个叫 .rodata.str1.1 的节:
$ clang -O1 -fno-pic -fno-asynchronous-unwind-tables -c s1.c -o s1.o$ readelf -SW s1.o | grep rodata [ 4] .rodata.str1.1 PROGBITS 0000000000000000 00004c 000003 01 AMS 0 0 1Flg 一列的 A 是第 2 章讲过的 SHF_ALLOC,M 和 S 是第 2 章见过的 SHF_MERGE 和 SHF_STRINGS:节里的内容是可以合并的元素,相同的只留一份,元素大小写在 ES 一列;S 进一步说明元素是以零结尾的字符串,这时 ES 表示每个字符占几个字节(gABI 第 4 章 Sections)。节名里的 str1.1 说的也是这件事:字符串,字符宽 1 字节,对齐 1 字节。s2.o 里有一个一模一样的节。三个文件链接到一起:
$ ld -o m_bfd s0.o s1.o s2.o$ readelf -SW m_bfd | grep rodata [ 2] .rodata PROGBITS 0000000000402000 002000 000003 01 AMS 0 0 1$ objdump -d m_bfd | grep -B1 'mov \$0x402000'0000000000401030 <f1>: 401030: bf 00 20 40 00 mov $0x402000,%edi--0000000000401040 <f2>: 401040: bf 00 20 40 00 mov $0x402000,%edi两个输入节各 3 字节,输出的 .rodata 却只有 3 字节,f1 和 f2 传给 printf 的是同一个地址。第 2 章链接 main.o 时看到 .rodata 和 .rodata.str1.1 进了同一个输出节,用的就是这条规则:.rodata.* 归入 .rodata,带 MS 标志的内容先去重再摆放。去重之后剩多少字节,取决于所有输入文件里有哪些字符串,链接器必须看完全部输入才能算出来,而它后面每一个节的地址都等着这个数。
合并后,输入偏移怎样对应输出位置
普通拼接保留整个输入节的内部次序,因此可以用“输出起点 + 输入偏移”定位字节。去重改变了这个前提:输入节内相邻的两个元素,可能分别对应输出中早已存在的两个位置。链接器需要保留从输入元素到输出元素的映射,而不是给整个输入节指定一个平移量。
以字符宽度和对齐均为 1、仅合并完整字符串的策略为例:
| 输入 | 含终止 NUL 的范围 | 内容 | 合并输出中的范围 |
|---|---|---|---|
| A | [0, 6) | hello\0 | [0, 6) |
| A | [6, 12) | world\0 | [6, 12) |
| B | [0, 6) | world\0 | [6, 12) |
| B | [6, 9) | hi\0 | [12, 15) |
| B | [9, 15) | hello\0 | [0, 6) |
输出为 hello\0world\0hi\0。B 的偏移 7 位于 hi\0 内,距离该元素起点为 1,因此映射到输出偏移 12 + 1 = 13。B 的偏移 9 则属于下一个元素,映射到 0。所有范围采用左闭右开区间;元素末尾不会再次属于前一个元素。
形式化地,输入元素范围为 [i, i+n),对应输出起点为 o,则其中的输入偏移 x 映射为 o + (x-i)。再加上输出合并区域的虚拟地址,才得到重定位所需的地址。若元素需要对齐,输出起点 o 还要先向上对齐;对齐填充不等于某个输入元素的有效内容。
重定位还必须区分普通符号和节符号。普通符号指明某个对象的位置,通常先把该位置映射到输出,再按重定位表达式应用 addend。STT_SECTION 符号指向整个输入节;汇编器可以把元素位置编码进 addend,此时必须先确定真正被引用的输入元素。若直接把输入节起点映射后再加原偏移,B 的 hello\0 就会指向错误位置。PC 相对重定位中 addend 还可能含有指令编码所需的修正量,不能把任何 addend 都盲目当作字符串索引;处理方式必须与具体重定位、符号类型及编译器产生的表示一致。
完整元素去重只是一个清晰的基本模型。实际链接器也可能做字符串后缀合并,并采用更宽的兼容分组规则。无论策略如何,关键不变量都相同:每个被引用的有效输入位置,必须能找到语义等价的输出位置;删除重复字节并没有删除对这些字节的引用。
大小还可能来自链接器生成的合成节。第 7 章要讲的 GOT6(全局偏移表,一个存放地址的数组)和 PLT7(过程链接表,一组跳转桩)最典型:每有一个符号需要通过 GOT 访问,GOT 就多一项;.dynsym(动态符号表)有多大,取决于要对运行时公开多少符号。链接器要先扫一遍所有重定位,数清楚需要多少项,才能知道这些节有多大。
因此,重定位处理至少要区分需求分析与最终写入两个阶段;下面用两遍扫描描述这个依赖,不要求实现恰好只遍历两次。第一遍在布局之前,只看类型和目标符号,统计需要生成什么(几项 GOT、几个 PLT 桩、要不要动态重定位);第二遍在布局之后,S 和 P 都有了,才真正计算并写入。第 4 章讲的 relaxation 会让这件事更复杂。x86-64 的 GOTPCRELX 改写不改变指令长度,不影响后面的地址,但改写后可能不再需要 GOT 项,因此需求扫描时就要分析能否省去 GOT 项,布局后还须满足距离等约束;具体实现可以保留保守分配,或在地址变化时重新调整。RISC-V 的 relaxation 会把指令变短,后面的地址随之前移,又可能有新的指令能变短,链接器只好迭代到不再变化。
从输入节到输出节
知道了为什么大小要先算完,回到布局本身。第一步是决定哪些输入节放进同一个输出节。先看原材料,readelf -S 列出 plain.o 的节头表(只保留了相关的几行):
$ readelf -SW plain.o [Nr] Name Type Address Off Size ES Flg Lk Inf Al [ 2] .text PROGBITS 0000000000000000 000040 000042 00 AX 0 0 16 [ 3] .rela.text RELA 0000000000000000 000178 000048 18 I 10 2 8 [ 4] .data PROGBITS 0000000000000000 000084 000004 00 WA 0 0 4 [ 5] .rodata PROGBITS 0000000000000000 000088 000003 00 A 0 0 1 [ 6] .bss NOBITS 0000000000000000 000090 001000 00 WA 0 0 16 [ 7] .comment PROGBITS 0000000000000000 000090 000028 01 MS 0 0 1 [ 8] .note.GNU-stack PROGBITS 0000000000000000 0000b8 000000 00 0 0 1三个函数挤在同一个 .text 里,0x42 字节;Address 一列全是零,因为目标文件里的节还没有地址。Al 一列是对齐要求:.text 要求起始地址是 16 的倍数,.data 是 4。.bss 的类型是 NOBITS,大小 0x1000 但在文件里不占空间,它的 Off 和下一节 .comment 相同。.comment 带 MS 标志,里面是编译器写进去的版本串,.note.GNU-stack 的 Off 正好是 0x90 + 0x28 = 0xb8。
链接器把所有输入文件里的节收集起来,按名字归类,拼成输出节(output section)。最简单的规则是同名合并:每个 .o 里都有 .text,它们首尾相接拼成输出文件的 .text。拼接时每个输入节都要满足自己的对齐,中间不够的地方用填充字节补齐;输出节的对齐取所有输入节对齐的最大值。
实际规则比同名合并宽一些。GNU ld 的默认规则写在它内置的链接脚本里,用 ld --verbose 可以把整份脚本打印出来,.text 那一段是这样的:
.text : { *(.text.unlikely .text.*_unlikely .text.unlikely.*) *(.text.exit .text.exit.*) *(.text.startup .text.startup.*) *(.text.hot .text.hot.*) *(SORT(.text.sorted.*)) *(.text .stub .text.* .gnu.linkonce.t.*) /* .gnu.warning sections are handled specially by elf.em. */ *(.gnu.warning) }每一行 *(...) 是一条输入节描述:星号匹配任意输入文件,括号里是要匹配的节名,可以带通配符。所以 .text.used、.text._start 这类名字都会进输出节 .text。行的先后就是摆放的先后:编译器认为不太会执行的代码(.text.unlikely,比如错误处理路径)、程序退出时才跑的代码、启动时只跑一次的代码,各自聚在一起,常用的热代码放在一起,这样运行时的热点集中在更少的内存页上。同样,.data.* 进 .data,.rodata.* 进 .rodata,.bss.* 进 .bss。
输入节的名字如果哪条规则都匹配不上,就成了孤儿节(orphan section)。链接器不会丢掉它,而是按启发式规则给它找个位置,通常是挨着标志位相近的输出节,并且原名保留成一个独立的输出节。后面 __start_ 符号那一节会遇到一个叫 myhooks 的孤儿节。
lld 默认不使用文本形式的内置链接脚本,等价的规则写在它的源代码里,效果大体一致:.text.* 进 .text,.data.* 进 .data,诸如此类。
从输出节到段
输出节是给链接器、调试器和 llvm-objdump 这类工具看的。加载器(Linux 内核里处理 execve 的那段代码,以及第 7 章的 ld.so;execve 是让当前进程换成运行另一个程序的系统调用)不看节头表,只看程序头表。第 2 章说过这是 ELF8 的两种视图;布局的下一步,就是把输出节分组装进段(segment)。
分组的依据是内存权限。第 1 章说过,操作系统以页为单位管理虚拟内存,x86-64 上页大小通常是 4 KiB。CPU 的页表以页为单位设置权限,一页要么可执行要么不可执行,要么可写要么不可写,所以权限相同的输出节才适合放进同一个段:代码放进可读可执行(RX)的段,常量放进只读(R)的段,可写数据放进可读写(RW)的段。下面是 GNU ld 链接 plain.o 的结果:
$ ld -o bfd plain.o$ readelf -lW bfd
Elf file type is EXEC (Executable file)Entry point 0x401020There are 5 program headers, starting at offset 64
Program Headers: Type Offset VirtAddr PhysAddr FileSiz MemSiz Flg Align LOAD 0x000000 0x0000000000400000 0x0000000000400000 0x000158 0x000158 R 0x1000 LOAD 0x001000 0x0000000000401000 0x0000000000401000 0x000042 0x000042 R E 0x1000 LOAD 0x002000 0x0000000000402000 0x0000000000402000 0x000003 0x000003 R 0x1000 LOAD 0x002004 0x0000000000403004 0x0000000000403004 0x000004 0x00100c RW 0x1000 GNU_STACK 0x000000 0x0000000000000000 0x0000000000000000 0x000000 0x000000 RW 0x10
Section to Segment mapping: Segment Sections... 00 01 .text 02 .rodata 03 .data .bss 04每一行是一个程序头,各列对应 ELF 规范里 Elf64_Phdr 结构的字段(gABI 第 5 章 Program Header):
- Type 是
p_type。PT_LOAD(显示为 LOAD)表示"把这一段装进内存",加载器只对这种段做映射。GNU_STACK是第 1 章讲过的那个可执行栈标记,它不对应任何内容,只用 Flg 一列告诉内核栈要什么权限,这里是 RW,不可执行。 - Offset 是
p_offset,段的内容从文件的哪个偏移开始。 - VirtAddr 是
p_vaddr,段要放到哪个虚拟地址。PhysAddr(p_paddr)在普通操作系统上没有用,链接器一般填成和p_vaddr相同。 - FileSiz 是
p_filesz,段在文件里占多少字节;MemSiz 是p_memsz,在内存里占多少字节。 - Flg 是
p_flags,R、W、E 三个权限位。 - Align 是
p_align,对齐要求。
再看最后一个 LOAD 段。它装着 .data 和 .bss,FileSiz 只有 4,也就是 counter 的 4 个字节;MemSiz 是 0x100c,多出来的 0x1008 字节是 .bss 里的 buffer(4096 字节)加上前面的对齐填充。gABI9 规定,当 p_memsz 大于 p_filesz 时,"多出来的字节值为 0,跟在段的初始化区域之后"。这就是 .bss 不占文件空间的实现方式:未初始化的全局变量反正要清零,没必要在文件里存 4096 个零,只要让段在内存里比在文件里长一截,加载器负责把多出来的部分清零。用这一种“文件前缀加零填充尾部”的表示时,.bss 放在该段的末尾;如果后面还有需要文件初始化的内容,就必须调整布局、另建段,或者显式存储中间的零,不能继续把它们统称为这一段的零填充尾部。
文件游标与内存游标何时分开
上面的 RW 段可以画成两行。.data 的四字节来自文件,后续内存先补八字节对齐间隙,再容纳 4096 字节的 buffer。段描述的是整个区间,因此零填充还包括对齐间隙,并不只对应名字叫 .bss 的那部分。
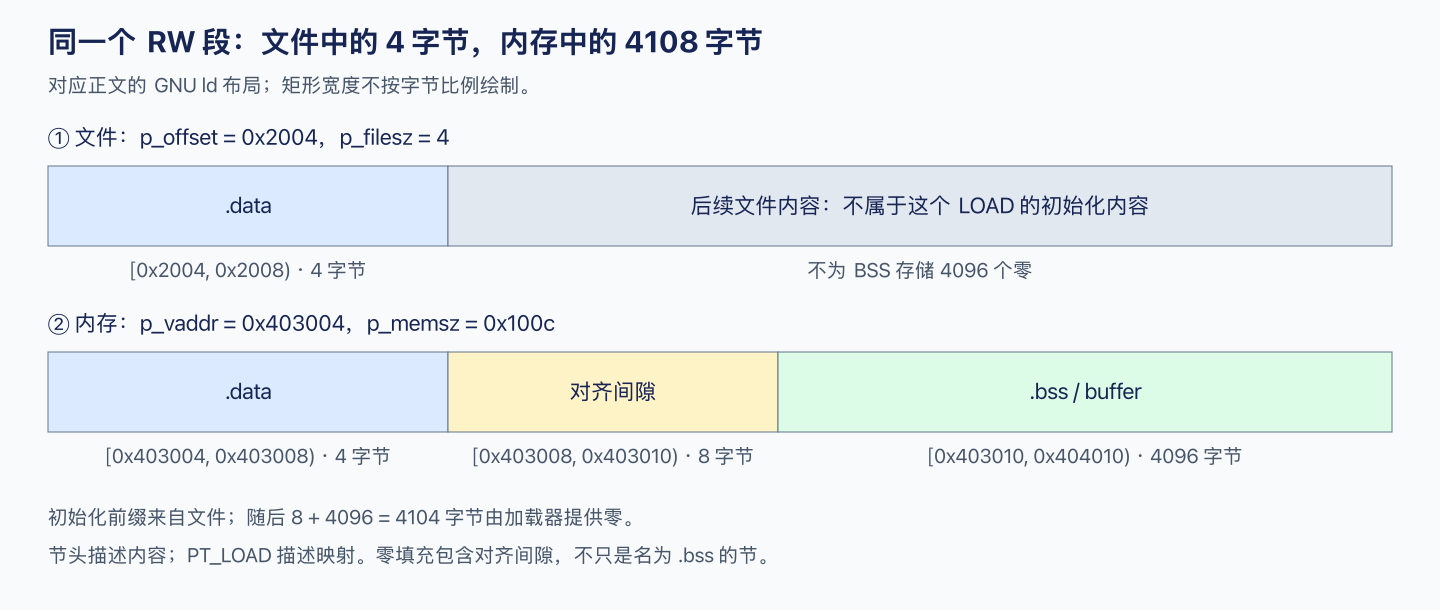
安排 .data 时,文件游标和内存游标都前进四字节;安排后面的零初始化存储时,只有内存游标继续前进。0x403008 向上对齐到 16 的倍数得到 0x403010,再加 0x1000 得到内存终点 0x404010,所以 p_memsz = 0x404010 − 0x403004 = 0x100c。文件初始化区域仍止于 0x2008,所以 p_filesz = 0x2008 − 0x2004 = 4。文件后面可以有节头表、符号表或其他内容;它们不会因此成为这个段的初始化数据。
对正整数对齐量 a,向上对齐是取不小于当前游标的最小 a 的倍数。已有游标 x 时,所需填充为 (a − x % a) % a。布局实现要先检查加上这段填充、再加上内容长度是否溢出或超过资源限制,才能增长缓冲区。这个操作与“无条件再加一个对齐单位”不同:已经对齐的位置不需要填充。
第一个 LOAD 段只装了 ELF 头和程序头表,0x158 字节,正好是 64 字节的 ELF 头加上 5 个各 56 字节的程序头:64 + 5 × 56 = 0x158。Section to Segment mapping 里 00 号后面是空的,因为头部不属于任何节。
头部也要占地址空间,这带来一个自我指涉的小麻烦:程序头表有几项,取决于布局最后分出了几个段;而第一个节能从哪里开始,又取决于程序头表有多大。GNU ld 的默认链接脚本(后面会细看)里有这样一句:
. = SEGMENT_START("text-segment", 0x400000) + SIZEOF_HEADERS;. 是位置计数器,表示"当前排到的地址",给它赋值就是把后面的东西挪到那个地址去。SEGMENT_START("text-segment", 0x400000) 的意思是"代码段的起始地址,命令行没指定就用 0x400000"。SIZEOF_HEADERS 是链接器对 ELF 头加程序头表大小的估计。上面的例子里代码被推到了下一页,看不出这个估计起了什么作用。加上 -z noseparate-code(下一小节解释)让代码紧跟在头部后面:
$ ld -z noseparate-code -o bfd_nosep plain.o$ readelf -sW bfd_nosep | grep -w used 3: 00000000004000f0 9 FUNC GLOBAL DEFAULT 1 used这次只有 3 个程序头,头部是 64 + 3 × 56 = 0xe8 字节,0x400000 + 0xe8 = 0x4000e8,再按 .text 要求的 16 字节对齐向上取整,就是 used 所在的 0x4000f0。估大了只浪费几个字节。估小了,两个链接器会把段的起点往前挪一页来塞下头部;连这个余地都没有时(比如脚本把第一个节放在地址 64),GNU ld 会报 not enough room for program headers,lld 报 could not allocate headers。
为什么偏移和地址要同余
仔细看这几行的 Offset 和 VirtAddr:0x1000 对 0x401000,0x2000 对 0x402000,0x2004 对 0x403004。两者的低 12 位总是相同。gABI 对此有硬性要求:可加载段的 p_vaddr 和 p_offset 必须模页大小同余("loadable process segments must have congruent values for p_vaddr and p_offset, modulo the page size"),并且在 p_align 不为 0 或 1 时,二者模 p_align 也要相等。
原因在于加载器怎么把段放进内存。它用 mmap(把文件的一段映射进进程地址空间的系统调用)把文件的一段映射到一段虚拟地址,而 mmap 只能按页工作:文件偏移必须是页大小的整数倍,虚拟地址也必须是页大小的整数倍,映射建立后,文件里的第 k 个字节就出现在起始地址加 k 的位置。如果一个段在文件里从页内偏移 0x004 开始,那它映射到内存后也必然从页内偏移 0x004 开始。同余使文件内容能通过整页映射落到指定位置,不必为纠正段起点而搬移内容;页尾清零和写时复制仍可能发生,第 6 章会看到。
最后那个 RW 段展示了链接器怎么利用这一点省空间。.rodata 在文件里结束于 0x2003,.data 按 4 字节对齐,文件偏移取下一个 4 的倍数 0x2004,不用填到下一页。但 RW 段的权限和前面的 R 段不同,不能和它共用一页内存,所以虚拟地址跳过一整页,取 0x403004。加载时,文件的第 2 页(偏移 0x2000 起)被映射两次:一次只读放在 0x402000,一次可读写放在 0x403000。同余只约束页内偏移,不要求段从页边界开始,所以两个段可以共用一页文件内容,各自映射到不同的内存页。GNU ld 的默认脚本里这一步写作 . = DATA_SEGMENT_ALIGN (CONSTANT (MAXPAGESIZE), CONSTANT (COMMONPAGESIZE));:MAXPAGESIZE 是链接器假设的最大页大小,COMMONPAGESIZE 是目标平台最常用的页大小,本实验工具链的这两个值都是 0x1000,其他构建配置可能不同。效果是把位置计数器推到下一页,但保留页内偏移。
Align 列的 0x1000 就是这个最大页大小,可以用 -z max-page-size 改。AArch64 这类架构的页大小可以配置,链接器必须按可能的最大值对齐,否则程序在页大小为 16 KiB 或 64 KiB 的内核上会加载失败。
separate-code:GNU ld 与 lld 不同的默认值
上面 GNU ld 的输出里,代码独占一个 RX 段,并且这个段从文件偏移 0x1000 开始、以 0x1000 对齐,和前后的段不共享任何一页。代价是文件里出现大段填充:这个只有几十字节代码的程序,文件有 9200 字节。
这是 -z separate-code 的效果。GNU ld 手册对它的描述是:生成一个单独的代码段,这个段"只包含指令,并且必须与任何其他数据处在完全不相交的页中"(ld 手册:Options)。binutils10 2.30 加入了这个选项,2.31(2018 年)新增了配置开关 --enable-separate-code,并且对 Linux/x86 目标默认开启,NEWS 里还特意注明"-z separate-code can increase disk and memory size"(binutils ld/NEWS)。ld --help 的输出里也写着 -z separate-code Create separate code program header (default)。
把前面那个 bfd_nosep 的程序头打印出来对比一下:
$ readelf -lW bfd_nosep Type Offset VirtAddr PhysAddr FileSiz MemSiz Flg Align LOAD 0x000000 0x0000000000400000 0x0000000000400000 0x000135 0x000135 R E 0x1000 LOAD 0x000138 0x0000000000401138 0x0000000000401138 0x000004 0x001008 RW 0x1000 GNU_STACK 0x000000 0x0000000000000000 0x0000000000000000 0x000000 0x000000 RW 0x10
Section to Segment mapping: Segment Sections... 00 .text .rodata 01 .data .bss文件缩到 1320 字节,但 ELF 头、程序头表、.text 和 .rodata 都进了同一个可执行段,头部和常量字符串也变成了可以执行的字节。攻击者做代码复用攻击(ROP,把程序里现成的指令片段串起来执行)时,可执行区域里的每一段字节都是潜在的素材,常量数据里恰好凑出 ret 之类的字节序列并不稀奇。开着 separate-code 时,可执行的页里就只剩 .text。
注意 separate-code 只管可执行段。默认的 bfd 里,R 段(.rodata)和 RW 段照样共用文件的第 2 页;bfd_nosep 里 RW 段从偏移 0x138 开始,和 RX 段共用文件第 0 页。两个链接器都允许不同权限的段共用文件页,分歧只在可执行段要不要和别人共用:GNU ld 默认不让,lld 默认让。ld.lld 的手册把三档写得很清楚:noseparate-code (default) allows overlap,separate-code allows overlap between two executable segments, or two non-executable segments,separate-loadable-segments disallows overlap(ld.lld(1))。这里的 overlap 指相邻的 PT_LOAD 段落在文件的同一页上。同一个 plain.o 用 lld 链接:
$ ld.lld -o lld plain.o$ readelf -lW lld Type Offset VirtAddr PhysAddr FileSiz MemSiz Flg Align PHDR 0x000040 0x0000000000200040 0x0000000000200040 0x000118 0x000118 R 0x8 LOAD 0x000000 0x0000000000200000 0x0000000000200000 0x00015b 0x00015b R 0x1000 LOAD 0x000160 0x0000000000201160 0x0000000000201160 0x000042 0x000042 R E 0x1000 LOAD 0x0001a4 0x00000000002021a4 0x00000000002021a4 0x000004 0x00100c RW 0x1000 GNU_STACK 0x000000 0x0000000000000000 0x0000000000000000 0x000000 0x000000 RW 0
Section to Segment mapping: Segment Sections... 00 01 .rodata 02 .text 03 .data .bss有三处和 GNU ld 不同。第一,.rodata 排在 .text 前面,和头部同处第一个只读段。这是 lld 默认的 --rosegment:只读、不可执行的节单独成段,不和代码混在一起;加 --no-rosegment 时 .rodata 会并进 RX 段。第二,多了一个 PHDR 段,它描述程序头表自身在内存中的位置。第三,也是最主要的:三个 LOAD 段在文件里是紧挨着的(0x0、0x160、0x1a4),没有页级填充;虚拟地址却各自跳了一页(0x200000、0x201160、0x2021a4),同余依然成立。文件只有 1376 字节(.comment 里有版本串,换工具链这个数会变)。
RX 段从文件偏移 0x160 开始,可 mmap 只能从页边界映射,所以加载器实际映射的是文件的第 0 页,放到 0x201000,权限 RX。文件第 0 页里不只有 .text,还有 ELF 头、程序头表和 .rodata,它们在 0x201000 到 0x20115f 这段地址上就成了可执行的。RW 段从 0x1a4 开始,同样落在文件第 0 页。于是这一页文件内容被映射了三次:只读放在 0x200000,可执行放在 0x201000,可读写放在 0x202000。lld 的取舍是文件更小,代价是可执行区域里混进了少量非代码字节。需要隔离时加 -z separate-code:
$ ld.lld -z separate-code -o lld_sep plain.o$ readelf -lW lld_sep | grep LOAD LOAD 0x000000 0x0000000000200000 0x0000000000200000 0x00015b 0x00015b R 0x1000 LOAD 0x001000 0x0000000000201000 0x0000000000201000 0x000042 0x000042 R E 0x1000 LOAD 0x002000 0x0000000000202000 0x0000000000202000 0x000004 0x001010 RW 0x1000代码段回到了页对齐的文件偏移 0x1000,文件涨到 9144 字节。在这个例子里 R 段和 RW 段中间隔着 RX 段,谁也挨不着谁,所以 -z separate-loadable-segments 得到的程序头和它一样。
附注节与 PT_NOTE
SHT_NOTE 是装附注的节类型,给操作系统或工具看,最常见的是 .note.gnu.build-id:链接器对输出内容算出的散列,用来认出是哪一个文件。lld 排只读节时把附注节放在最前面(.interp 之后),.rodata 这类节放在后面、靠近 .text。源码注释的理由是 core 文件(进程崩溃时的内存转储)可能被截断,靠前的附注更可能留下来(Writer.cpp 的 getSectionRank)。排好之后,createPhdrs 把连续且对齐相同的一串附注节合成一个 PT_NOTE,对齐一变就另起一个(同一文件)。下面的 notes.o 有三个手写的附注节,.note.a、.note.b 按 4 字节对齐,.note.c 按 8 字节,链接时再让 lld 生成 build-id:
$ ld.lld --build-id -o n2 notes.o$ readelf -lW n2 Type Offset VirtAddr PhysAddr FileSiz MemSiz Flg Align PHDR 0x000040 0x0000000000200040 0x0000000000200040 0x000188 0x000188 R 0x8 LOAD 0x000000 0x0000000000200000 0x0000000000200000 0x00022f 0x00022f R 0x1000 LOAD 0x000230 0x0000000000201230 0x0000000000201230 0x000005 0x000005 R E 0x1000 GNU_STACK 0x000000 0x0000000000000000 0x0000000000000000 0x000000 0x000000 RW 0 NOTE 0x0001c8 0x00000000002001c8 0x00000000002001c8 0x000028 0x000028 R 0x4 NOTE 0x0001f0 0x00000000002001f0 0x00000000002001f0 0x000018 0x000018 R 0x8 NOTE 0x000208 0x0000000000200208 0x0000000000200208 0x000024 0x000024 R 0x4
Section to Segment mapping: Segment Sections... 01 .note.a .note.b .note.c .note.gnu.build-id .rodata 04 .note.a .note.b 05 .note.c 06 .note.gnu.build-id.rodata 在输入文件里排在附注节前面,输出时被挪到最后。本例的 PT_NOTE 指向第一个 LOAD 段里已有的字节,不额外分配存储;附注内容可能供内核、运行时或工具使用。
程序从哪里开始执行
段都已就位,内核把它们映射进内存之后,还要知道从哪条指令开始执行。GNU ld 那份 readelf11 输出的第二行是 Entry point 0x401020,这个值存在 ELF 头的 e_entry 字段里。内核加载完所有段后,跳到这个地址开始执行用户态代码,它就是第 0 章说的入口地址。
链接器怎么决定入口?GNU ld 手册列了一个按顺序尝试的规则(ld 手册:Entry Point):先看命令行 -e,再看链接脚本里的 ENTRY(symbol),然后是目标平台约定的符号,再然后是代码节的第一个字节,最后是地址 0。x86-64 Linux 的默认脚本开头就写着 ENTRY(_start),所以入口符号叫 _start。如果找不到它,两个链接器的反应不一样:
$ ld -o ne noentry.old: warning: cannot find entry symbol _start; defaulting to 0000000000401000$ ld.lld -o ne2 noentry.old.lld: warning: cannot find entry symbol _start; not setting start addressGNU ld 退到 .text 的开头,lld 把入口留成 0。两者都只是警告,链接会成功,但产物多半一运行就崩溃。
平时写 C 程序从来不用自己定义 _start,因为编译器驱动程序在链接时悄悄加了几个目标文件。第 0 章说过,gcc、clang 是驱动程序,会替你补上一长串链接参数。用 -### 让 gcc 只打印它要执行的命令,不执行。下面用的是 本机 GCC12 15.2.0 加 musl13 包装器,链接那一步的输入文件按顺序是(路径、-L 和部分选项已省略,hello.o 代指 hello.c 编译出的临时目标文件,名字每次都不同):
$ musl-gcc -no-pie -### hello.c -o hello... Scrt1.o crti.o crtbeginS.o hello.o libgcc.a libgcc_eh.a -lc libgcc.a libgcc_eh.a crtendS.o crtn.o这些是启动文件,crt 是 C runtime 的缩写。本机规格文件选择的 Scrt1.o 来自 musl C 库,定义了 _start,它取出参数、交给 C 库初始化,再调用 main、用返回值调用 exit,细节在第 6 章。和布局有关的只有一点:同名节按输入顺序拼接,crti.o 的 .init 片段在最前,crtn.o 的在最后,拼起来正好是一个完整的函数,所以这些文件的顺序不能乱。
这些文件也解释了为什么正常链接出的程序里 main 不在 .text 开头。把 hello.c 链接出来按地址排序:
$ musl-gcc -no-pie -O1 hello.c -o hello$ nm -n hello | grep -i ' t '0000000000401000 T _init0000000000401040 T _start0000000000401060 T _start_c0000000000401090 t deregister_tm_clones00000000004010c0 t register_tm_clones0000000000401100 t __do_global_dtors_aux0000000000401140 t frame_dummy0000000000401149 T main0000000000401153 T _fini.text 从 0x401040 开始,最前面是 Scrt1.o 的 _start 和 musl 的 _start_c,接着是 crtbeginS.o 里 GCC 的几个辅助函数,main 排到了 0x401149。第 4 章的程序直接调用链接器、用 -e 指定入口,没有这些启动文件,main 就是 .text 的第一个函数;lld 把它放在 0x2011b0 这种不整齐的地址,原因就是上一节的同余规则。
本章的例子用 -nostdlib 风格直接调用链接器。-nostdlib 是驱动程序的选项,意思是不加启动文件、也不加 C 库和 GCC 的支持库;这里干脆不经过驱动程序,效果一样。没有这套启动文件,就必须自己写 _start,并且它不能返回(没有调用者可以返回),可以像本例一样停在循环里,也可以通过退出系统调用结束进程。
基址:0x400000、0x200000 和 PIE
入口 0x401020 是 .text 的起点 0x401000 加上 _start 在 plain.o 的 .text 里的偏移 0x20。那整个映像为什么从 0x400000 起排,lld 却从 0x200000 起排?这两个数都是约定。GNU ld 的写在默认脚本里,ld --verbose 能看到:
PROVIDE (__executable_start = SEGMENT_START("text-segment", 0x400000)); . = SEGMENT_START("text-segment", 0x400000) + SIZEOF_HEADERS;lld 的写在源码里,x86-64 目标的构造函数中有一行 defaultImageBase = 0x200000;(lld/ELF/Arch/X86_64.cpp)。不从 0 开始,一个直接的好处是让空指针附近的低地址保持未映射,解引用空指针会立刻触发段错误。两者都可以改:GNU ld 用 -Ttext-segment=ADDR,lld 用 --image-base=ADDR。
这样链接出来的程序类型是 EXEC,所有地址在链接时就定死了,每次运行都在同一个位置。这对攻击者很友好:知道了程序的布局,就知道 ROP 素材在哪里。于是有了 PIE14(position-independent executable,位置无关可执行文件):程序用位置无关的方式编译(-fPIE,第 1 章讲过 PIC15 的概念),链接成一种"可以放在任意基址"的可执行文件。每次运行时,内核在 execve 加载它的时候随机选一个基址;ld.so 负责的是给之后加载的共享库找地方。这就是地址空间布局随机化(ASLR16,每次运行把各模块放到随机地址)对主程序的覆盖。
$ clang -O1 -fPIE -fno-asynchronous-unwind-tables -c main.c -o pie.o$ ld -pie --no-dynamic-linker -o bfd_pie pie.o$ readelf -hlW bfd_pie Type: DYN (Position-Independent Executable file) Entry point address: 0x1020 LOAD 0x000000 0x0000000000000000 0x0000000000000000 0x000201 0x000201 R 0x1000 LOAD 0x001000 0x0000000000001000 0x0000000000001000 0x000042 0x000042 R E 0x1000 LOAD 0x002000 0x0000000000002000 0x0000000000002000 0x000008 0x000008 R 0x1000 LOAD 0x002f30 0x0000000000003f30 0x0000000000003f30 0x0000d4 0x0010e0 RW 0x1000 DYNAMIC 0x002f30 0x0000000000003f30 0x0000000000003f30 0x0000d0 0x0000d0 RW 0x8 GNU_RELRO 0x002f30 0x0000000000003f30 0x0000000000003f30 0x0000d0 0x0000d0 R 0x1文件类型变成了 DYN,和共享库相同;第一个段的虚拟地址是 0,入口是 0x1020。这里的地址都是相对基址的偏移,实际地址要等运行时加上基址才知道。多出来的 DYNAMIC 段是给运行时用的信息表,第 7 章细讲。GNU_RELRO 圈出一块"修补完就改成只读"的区域,这里正好是 .dynamic;这里 .dynamic 从虚拟地址 0x3f30 开始,占 0xd0 字节,结束于页边界 0x4000。这样的布局让加载器能够以页为单位保护 RELRO17 区域,同时让后续需要写入的 .data 位于下一页;保护机制在第 7 章展开。
--no-dynamic-linker 的意思是不给这个 PIE 指定 ld.so。普通的 PIE 带一个 PT_INTERP 程序头,写着动态链接器的路径,内核会先把 ld.so 加载进来,由它在跳到入口之前修补需要修补的地址。这个例子里只有 PC 相对寻址,readelf -r bfd_pie 输出 There are no relocations in this file.,没有任何东西要修补,所以不带 ld.so 也能运行。真正的 static-pie(静态链接、但仍可随机放置的程序)通常有要修补的绝对地址,由 C 库的启动代码自己修。
现在 PIE 是主流发行版的默认值。GCC 6 加入了配置选项 --enable-default-pie,用它构建的 GCC 默认生成 PIE(GCC 6 Release Notes),Ubuntu 从 16.10 起在 amd64 等架构上默认开启(Ubuntu 安全文档)。所以今天随手 gcc hello.c 得到的多半是 DYN,要传统布局得加 -no-pie。
这引出一个问题:PIE 的代码里,used 读 counter 的那条 PC 相对寻址指令,S 和 P 都只是相对基址的偏移,两者一减基址抵消了,所以链接时就能算出最终值。但如果数据里存的是一个绝对地址(比如一个函数指针数组),链接时就填不出最终值。第 4 章已经见过链接器的做法:先按基址 0 填一个值,再留一条 R_X86_64_RELATIVE 让 ld.so 加上基址。这套交给运行时的机制,本章结尾会再回到它。
GC:把没人用的节删掉
回到开头的实验。第二行 addl 0xff8(%rip) 和第一行不同,是因为 .rodata 被删掉了,.data 跟着往前移了一页。删掉它的是 --gc-sections。
为什么要以节为单位
普通 --gc-sections 以输入节为回收单位。即使符号表记录了函数的起点和长度,也不足以安全地任意切开机器码:节内可能有汇编器已算好的相对引用、局部标签和嵌入数据,需要一并修正。编译器把可独立删除的实体分节,才给链接器提供了明确的边界。所以对 plain.o 开 GC,效果很有限:
$ ld --gc-sections --print-gc-sections -o bfd_gc2 plain.old: removing unused section '.rodata' in file 'plain.o'unused 函数没人调用,可它和 _start 挤在同一个 .text 里,_start 必须保留,.text 就整个保留了,unused 跟着搭车。--print-gc-sections 列出被删掉的节,是观察 GC 的基本手段:lld 写到标准输出,每行以 removing unused section 开头;GNU ld 写到标准错误,每行带着链接器自己的名字作前缀,比如 ld:。
要让 GC 有效,需要编译器把每个函数、每个变量放进各自独立的节。这就是 -ffunction-sections 和 -fdata-sections:
$ clang -O1 -fno-pic -fno-asynchronous-unwind-tables \ -ffunction-sections -fdata-sections -c main.c -o split.o$ readelf -SW split.o [Nr] Name Type Address Off Size ES Flg Lk Inf Al [ 2] .text PROGBITS 0000000000000000 000040 000000 00 AX 0 0 4 [ 3] .text.used PROGBITS 0000000000000000 000040 000009 00 AX 0 0 16 [ 4] .rela.text.used RELA 0000000000000000 000178 000018 18 I 14 3 8 [ 5] .text.unused PROGBITS 0000000000000000 000050 000004 00 AX 0 0 16 [ 6] .text._start PROGBITS 0000000000000000 000060 000022 00 AX 0 0 16 [ 7] .rela.text._start RELA 0000000000000000 000190 000030 18 I 14 6 8 [ 8] .data.counter PROGBITS 0000000000000000 000084 000004 00 WA 0 0 4 [ 9] .rodata.msg PROGBITS 0000000000000000 000088 000003 00 A 0 0 1 [10] .bss.buffer NOBITS 0000000000000000 000090 001000 00 WA 0 0 16节名就是"原来的节名 + 点 + 符号名",这正是为什么默认链接规则里要有 .text.*、.data.*。重定位也随之拆开,每个节有自己的 .rela.*:
$ readelf -rW split.oRelocation section '.rela.text.used' at offset 0x178 contains 1 entry: Offset Info Type Symbol's Value Symbol's Name + Addend0000000000000004 0000000300000002 R_X86_64_PC32 0000000000000000 counter - 4
Relocation section '.rela.text._start' at offset 0x190 contains 2 entries: Offset Info Type Symbol's Value Symbol's Name + Addend0000000000000007 0000000200000004 R_X86_64_PLT32 0000000000000000 used - 4000000000000000d 0000000600000002 R_X86_64_PC32 0000000000000000 buffer - 4这两张表就是一张图。把每个节看成一个顶点,一条重定位"节 X 的某处引用了符号 Y,Y 定义在节 Z"就是一条从 X 指向 Z 的边:.text._start 指向 .text.used 和 .bss.buffer,.text.used 指向 .data.counter。
节的身份不依赖输出地址
GC 在尚未布局的输入节图上工作。一个顶点可用“输入文件身份、该文件的节下标”定位;同名节来自不同对象时仍是不同顶点。沿一条重定位边查到的是选中定义所属的输入节,还不需要知道它最终放到哪里。
例如 _start → .text.used → .data.counter 是从根可达的链。若另有 .text.unused → .rodata.msg,但没有根到达 .text.unused,这两个节之间即使互相引用也不会自动存活。可达性要求一条从根出发的路径,单纯存在引用不是保留理由。
标记完成后,布局才把存活内容合并、对齐并分配地址。若用输出地址充当图顶点,会把还未得到的布局结果当成 GC 前提;删除节又会移动后面的地址。保持输入身份稳定,能够让符号选择、存活判断和最终地址分配分别表达各自的结果。
标记过程
GC 就是在这张图上做一次可达性分析,和编程语言运行时的标记-清除垃圾回收是同一个思路。先选出一批根,标记为存活;然后从存活的节出发,沿着它的重定位找到被引用的节,也标记为存活,直到没有新节可标;最后没被标记的节全部丢弃。
$ ld --gc-sections --print-gc-sections -o bfd_gc split.old: removing unused section '.text.unused' in file 'split.o'ld: removing unused section '.rodata.msg' in file 'split.o'$ ld.lld --gc-sections --print-gc-sections -o lld_gc split.oremoving unused section split.o:(.text)removing unused section split.o:(.text.unused)removing unused section split.o:(.rodata.msg)unused 和 msg 没有任何边指向它们,被删掉了(lld 还报告了那个空的 .text)。lld 有一个选项 --why-live,能打印出某个符号为什么活着,也就是从根到它的那条引用链:
$ ld.lld --gc-sections --why-live=counter -o x split.olive symbol: split.o:(counter)>>> referenced by: split.o:(used)>>> referenced by: split.o:(_start) (entry point)链的末端写着 (entry point),说明根是入口。哪些节算根?GNU ld 手册说:包含入口符号的节,以及包含命令行上 -u(强制视为未定义)符号的节会被保留,被动态对象引用的符号所在的节也会保留;生成共享库时,链接器必须假设每一个可见的符号都会被引用。另外带 SHF_GNU_RETAIN 标志的节不参与回收(ld 手册:Options),这个标志由源码里的 retain 属性产生,意思是"链接器不许删我",后面会用到它。lld 的标记代码里还有一个"保留节"列表(lld/ELF/MarkLive.cpp):.init_array、.fini_array、.preinit_array 这几类存放初始化和析构函数指针的节;.init、.fini;.ctors、.dtors,它们是 .init_array/.fini_array 出现之前存放构造、析构函数指针的老办法,旧的目标文件里还会遇到;以及不在 COMDAT18 组里的 SHT_NOTE 节(前面附注节一小节讲过)。这些节的共同点是没有任何代码"引用"它们,它们是由 C 库启动代码、加载器或别的工具按位置或名字找到的,从重定位图上看不出它们有用,必须直接当作根。符号层面,lld 除了入口,还把 _init 和 _fini 两个符号所在的节当作根(MarkLive.cpp 第 348、349 行)。代码里用的是 ctx.arg.init 和 ctx.arg.fini,也就是 -init、-fini 选项的值,默认就是这两个名字:
$ ld.lld --gc-sections --why-live=_init --why-live=_fini -o i ini.olive symbol: ini.o:(_init) (initializer function)live symbol: ini.o:(_fini) (finalizer function)$ ld.lld --gc-sections --print-gc-sections --init=foo -o i2 ini.o | grep _initremoving unused section ini.o:(.text._init)ini.c 定义了空的 _init、_fini、other 和 _start,没人调用前三个。换成 --init=foo,_init 就和 other 一样被删了。GNU ld 对同一批节的保护写在默认链接脚本里,用的是 KEEP:
.init_array : { PROVIDE_HIDDEN (__init_array_start = .); KEEP (*(SORT_BY_INIT_PRIORITY(.init_array.*) SORT_BY_INIT_PRIORITY(.ctors.*))) KEEP (*(.init_array EXCLUDE_FILE (*crtbegin.o *crtbegin?.o *crtend.o *crtend?.o ) .ctors)) PROVIDE_HIDDEN (__init_array_end = .); }KEEP(...) 匹配到的输入节一律视为根。
还有两条规则不靠"当作根",而是直接决定某类节的去留。
第一条,不加载的节(没有 SHF_ALLOC 标志,比如 .comment 和所有 .debug_*)默认全部保留。lld 的源码注释说得很直白:可达性不是判断它们有没有用的好信号,通常没有任何节引用 .comment,但它应该留着。
第二条是 SHF_LINK_ORDER(readelf 的 Flg 列显示为 L)。带这个标志的节是元数据,它的节头 Lk 字段指向它所描述的那个节,两者同生共死:函数节活着它就活着,函数节被删它也被删。典型的是编译器生成的插桩信息,也就是为了运行时追踪、打补丁或统计覆盖率而给每个函数额外记录的数据。比如 -fpatchable-function-entry=2 让编译器在每个函数开头留两字节空指令,并把这些位置记进 __patchable_function_entries 节,每个函数一份:
$ clang -O1 -fno-pic -fno-asynchronous-unwind-tables \ -ffunction-sections -fdata-sections -fpatchable-function-entry=2 -c main.c -o pfe.o$ readelf -SW pfe.o | grep -E 'patchable_function_entries|text\.unused' [ 5] __patchable_function_entries PROGBITS 0000000000000000 000050 000008 00 WAL 3 0 8 [ 7] .text.unused PROGBITS 0000000000000000 000060 000006 00 AX 0 0 16 [ 8] __patchable_function_entries PROGBITS 0000000000000000 000068 000008 00 WAL 7 0 8 [12] __patchable_function_entries PROGBITS 0000000000000000 000098 000008 00 WAL 10 0 8$ ld --gc-sections --print-gc-sections -o pfe_b pfe.old: removing unused section '.text.unused' in file 'pfe.o'ld: removing unused section '__patchable_function_entries' in file 'pfe.o'ld: removing unused section '.rodata.msg' in file 'pfe.o'三个元数据节的 Lk 分别是 3、7、10,指向 .text.used、.text.unused、.text._start。.text.unused 被删时,Lk 为 7 的那一份跟着被删,输出里的 __patchable_function_entries 只剩 0x10 字节,两个函数各 8 字节。lld 的结果相同。
.eh_frame 是另一个特例。它存放栈展开信息,所有函数的记录挤在同一个节里,每个函数一条 FDE19。链接器不能按节删它,只能单独扫描,把属于被删函数的 FDE 一条条剔掉。第 8 章再讲它的格式。
共享库那条规则有个直接推论:一个共享库默认导出所有全局符号,所以它们全是根,GC 能删的很少。用第 3 章讲过的 hidden 可见性(例如 -fvisibility=hidden)把不打算导出的符号藏起来,GC 才有发挥空间。
-ffunction-sections 也有代价。链接器要处理的输入节数量成倍增长,重定位也变多:全局函数之间的调用本来就要留给链接器(可能被第 3 章的符号插入替换),而 static 函数的局部调用原本能在汇编时算死,拆开之后跨了节,也只能留给链接器:
$ cat st.c__attribute__((noinline)) static int helper(int x) { return x * 2; }int api(int x) { return helper(x) + 1; }$ clang -O1 -fno-pic -fno-asynchronous-unwind-tables -c st.c -o st.o$ readelf -rW st.oThere are no relocations in this file.$ clang -O1 -fno-pic -fno-asynchronous-unwind-tables -ffunction-sections -c st.c -o st.o$ readelf -rW st.o | grep R_X860000000000000002 0000000300000004 R_X86_64_PLT32 0000000000000000 .text.helper - 4所以它通常是在发布构建里和 --gc-sections 一起开,用于控制最终体积。
引用了被删的节,S 填什么
第 4 章在套用重定位的循环里留了一个问题:如果一条重定位引用的符号所在的节被删了,S 该取什么值?
如果只考虑普通 GC 沿重定位遍历保留下来的可加载节,这个问题不会出现。GC 的标记就是沿着重定位走的,一个存活的可加载节只要引用了某个节,那个节就会被标记存活。被删的节,一定没有任何存活的可加载节指向它。
不加载的节就不同了。.debug_* 默认全部保留,而调试信息会描述每一个函数,包括被删掉的那个。把 main.c 加上 -g 编译(这里用 -gdwarf-4,方便看 .debug_ranges),再开 GC 链接:
$ clang -O1 -g -gdwarf-4 -fno-pic -fno-asynchronous-unwind-tables \ -ffunction-sections -fdata-sections -c main.c -o dbg.o$ ld.lld --gc-sections -o dbg_lld dbg.o$ objdump --dwarf=info dbg_lld | grep -A6 DW_TAG_subprogram | grep -E 'name|low_pc' <9d> DW_AT_low_pc : 0x201160 <ab> DW_AT_name : (indirect string, offset: 0x8c): used <c4> DW_AT_low_pc : 0 <d2> DW_AT_name : (indirect string, offset: 0x85): unused <eb> DW_AT_low_pc : 0x201170 <f9> DW_AT_name : (indirect string, offset: 0x3c): _start$ readelf -x .debug_ranges dbg_lld 0x00000000 60112000 00000000 69112000 00000000 `. .....i. ..... 0x00000010 01000000 00000000 01000000 00000000 ................ 0x00000020 70112000 00000000 92112000 00000000 p. ....... ..... 0x00000030 00000000 00000000 00000000 00000000 ................unused 已经不在程序里了,描述它的那条调试记录还在,记录起始地址的 DW_AT_low_pc 引用的是 .text.unused。链接器在这种地方填一个约定的"墓碑值"(tombstone),告诉调试器这一项作废:这里 DW_AT_low_pc 填了 0,.debug_ranges 里那一项成了 [1, 1),一个空区间。不同的调试节为什么要填不同的值,两个链接器各填什么,第 11 章细讲。
另一种被丢弃的节来自 COMDAT。第 1 章和第 3 章讲过,同一个签名的 COMDAT 组只保留第一份,其余整组丢弃。如果某个文件在组外引用了自己那份组里的局部符号,就会引用到一个被丢弃的节,这时链接器没有墓碑可填,只能报错。用两个汇编文件构造一下,cb.s 的组里多了一个局部标签 helper,_start 在组外调用它:
$ cat cb.s .section .text.foo,"axG",@progbits,foo,comdat .globl foofoo: rethelper: ret .text .globl _start_start: call foo call helper1: jmp 1b$ ld.lld -o c1 ca.o cb.old.lld: error: relocation refers to a discarded section: .text.foo>>> defined in cb.o>>> section group signature: foo>>> prevailing definition is in ca.o>>> referenced by cb.o:(.text+0x6)$ ld -o c2 ca.o cb.o`.text.foo' referenced in section `.text' of cb.o: defined in discarded section `.text.foo[foo]' of cb.oca.s 只有前四行,同样定义了组 foo。ca.o 排在前面,它的组胜出,cb.o 的整组被丢弃,call helper 那条重定位(汇编器把它写成了 .text.foo - 3)就没有了目标。这个错误多见于手写汇编,或混用了生成方式不同的目标文件。
_start 和 _stop:链接器替你定义的边界
GC 有一类棘手的情况,正好引出链接器另一个常用功能。很多程序用"把元素放进同一个自定义节,运行时遍历整个节"的方式做注册表:每个源文件往节里放一个函数指针,不需要一个中心文件列出所有成员。遍历需要知道节的起点和终点,这两个地址只有链接器知道。
GNU ld 和 lld 的约定是:如果一个输出节的名字是合法的 C 标识符(只含字母、数字、下划线,不以数字开头),而程序引用了 __start_节名 或 __stop_节名 却没有定义它们,链接器就自动定义这两个符号,分别指向该输出节的起点和终点。.text 这类带点的名字不行,因为 C 代码里没法写出 __start_.text。
/* reg.c:往自定义节 myhooks 里放两个函数指针 */typedef void (*hook_t)(void);static void hook_a(void) {}static void hook_b(void) {}__attribute__((section("myhooks"), used)) static hook_t pa = hook_a;__attribute__((section("myhooks"), used)) static hook_t pb = hook_b;
/* run.c:遍历 myhooks */typedef void (*hook_t)(void);extern hook_t __start_myhooks[], __stop_myhooks[];void _start(void) { for (hook_t *p = __start_myhooks; p < __stop_myhooks; p++) (*p)(); for (;;) { }}两个文件都按 split.o 的方式编译,每个函数、每个变量一节:
$ clang -O1 -fno-pic -fno-asynchronous-unwind-tables \ -ffunction-sections -fdata-sections -c reg.c -o reg.o$ clang -O1 -fno-pic -fno-asynchronous-unwind-tables \ -ffunction-sections -fdata-sections -c run.c -o run.oused 属性只阻止编译器删掉这两个变量,管不到链接器。myhooks 不匹配默认脚本里的任何规则,是一个孤儿节,链接器会把它单独放成一个输出节。注意从重定位图上看,run.o 引用的是 __start_myhooks,而这个符号不属于任何输入节,所以没有任何一条边指向 myhooks。开 GC 后,两个链接器的结果不同:
$ ld --gc-sections --print-gc-sections -o r1 run.o reg.o$ readelf -sW r1 | grep -E 'myhooks|hook' 3: 0000000000401030 1 FUNC LOCAL DEFAULT 1 hook_a 4: 0000000000401040 1 FUNC LOCAL DEFAULT 1 hook_b 9: 0000000000402000 0 NOTYPE GLOBAL PROTECTED 2 __start_myhooks 12: 0000000000402010 0 NOTYPE GLOBAL PROTECTED 2 __stop_myhooks
$ ld.lld --gc-sections --print-gc-sections -o r2 run.o reg.oremoving unused section run.o:(.text)removing unused section reg.o:(.text)removing unused section reg.o:(.text.hook_a)removing unused section reg.o:(.text.hook_b)removing unused section reg.o:(myhooks)ld.lld: error: undefined symbol: __start_myhooks>>> referenced by run.c>>> run.o:(_start)>>> the encapsulation symbol needs to be retained under --gc-sections properly; consider -z nostart-stop-gc (see https://lld.llvm.org/ELF/start-stop-gc)
ld.lld: error: undefined symbol: __stop_myhooks...GNU ld 保留了 myhooks,__start_myhooks 和 __stop_myhooks 相差 0x10,正好两个指针。这两个符号的可见性一栏是 PROTECTED(第 3 章讲过的可见性:对外可见,但模块内部的引用不会被别的模块替换)。GNU ld 默认给这类链接器定义的符号 protected,可以用 -z start-stop-visibility= 改,比如改成 hidden。lld 则把整个 myhooks 删了,然后报告符号未定义。
protected 只是默认值。lld 用 addOptionalRegular 定义这两个符号,走的是普通的符号解析 resolve,双方的可见性取更严的一个(Symbols.cpp)。vis.c 里放一个 myinit 节,把 __start_myinit 声明成 hidden,__stop_myinit 不加属性:
extern char __start_myinit[] __attribute__((visibility("hidden")));extern char __stop_myinit[];$ ld.lld -o v vis.o$ readelf -sW v | grep -E 'start_|stop_' 3: 0000000000202184 0 NOTYPE LOCAL HIDDEN 2 __start_myinit 6: 0000000000202188 0 NOTYPE GLOBAL PROTECTED 2 __stop_myinithidden 符号模块外看不到,lld 把绑定写成 LOCAL;GNU ld 同样给 HIDDEN,绑定仍是 GLOBAL。
另外,addStartStopSymbols 是在遍历输出节时调用的,只有实际存在的输出节才有这两个符号(Writer.cpp)。节不存在时,强引用报 undefined symbol;弱引用保持未定义,值为 0,链接照样成功。这常用来探测可选的节:
$ cat weak.cextern char __start_optsec[] __attribute__((weak));extern char __stop_optsec[] __attribute__((weak));unsigned long n;void _start(void) { n = __stop_optsec - __start_optsec; if (__start_optsec) n += 100; for (;;) { } }$ ld.lld -o w weak.o; echo $?0$ readelf -sW w | grep optsec 3: 0000000000000000 0 NOTYPE WEAK DEFAULT UND __start_optsec 4: 0000000000000000 0 NOTYPE WEAK DEFAULT UND __stop_optsec反汇编 _start 能看到两个地址都被填成了 mov $0x0,n 最后是 0。
lld 的文档讲了这段历史(lld: -z start-stop-gc):2015 年 10 月前后,GNU ld 改成只要存活的节引用了 __start_meta,所有名为 meta 的输入节都保留。这是保守做法,对不考虑 GC 的老代码友好;但有些元数据节本来就希望被精确回收,比如上一节那种每个函数一份的插桩信息,函数删了它也该删,保守做法会白白增大体积。ld.lld 13.0.0 起默认 -z start-stop-gc,即 __start_/__stop_ 引用不再让节存活。名字以 __libc_ 开头的节例外,仍按旧规则处理,源码注释说这是给 glibc20 2.34 之前的 libc.a 留的退路(MarkLive.cpp,glibc PR27492),注释举的例子是 __libc_atexit。下面的 lreg.c 往 __libc_hooks 和 myhooks 各放一个指针,lrun.c 遍历前者,对后者只用弱引用探测:
$ ld.lld --gc-sections --print-gc-sections -o l lrun.o lreg.oremoving unused section lrun.o:(.text)removing unused section lreg.o:(.text)removing unused section lreg.o:(myhooks)$ readelf -sW l | grep -E '__start|__stop' 6: 00000000002021a8 0 NOTYPE GLOBAL PROTECTED 2 __start___libc_hooks 7: 00000000002021b0 0 NOTYPE GLOBAL PROTECTED 2 __stop___libc_hooks 8: 0000000000000000 0 NOTYPE WEAK DEFAULT UND __start_myhooks__libc_hooks 活了下来,myhooks 被删,弱引用的 __start_myhooks 是 0。文档还说 GNU ld 2.37 加了同名选项来恢复旧行为,但在本例里它和 lld 并不等价:GNU ld 2.46 加上 -z start-stop-gc --gc-sections 链接同样两个文件,myhooks、hook_a、hook_b 照样保留,__start_myhooks 仍是 0x402000。
在 lld 下有三种修法。一是按报错提示加 -z nostart-stop-gc,回到保守行为。二是在源码里给变量加 retain 属性,编译器会给节打上 SHF_GNU_RETAIN 标志(readelf -S 的 Flg 列显示为 R),两个链接器都不回收这样的节:
$ readelf -SW reg2.o | grep myhooks [ 5] myhooks PROGBITS 0000000000000000 000058 000008 00 WAR 0 0 8 [ 7] myhooks PROGBITS 0000000000000000 000060 000008 00 WAR 0 0 8$ ld.lld --gc-sections --print-gc-sections -o r3 run.o reg2.oremoving unused section run.o:(.text)removing unused section reg2.o:(.text)(加了 retain 之后,编译器把两个变量放进了两个同名的 myhooks 节,链接时会合并。)hook_a、hook_b 也活下来了,因为存活的 myhooks 节通过重定位引用了它们。三是写链接器脚本,用 KEEP 把节显式保留,这正是下一节的内容。
链接器脚本:把布局规则写出来
前面已经零星看过 GNU ld 默认脚本的片段。链接器脚本(linker script)就是用一种小语言写下的布局规则:哪些输入节进哪个输出节,输出节按什么顺序、放在什么地址。下面是一个能用两个链接器跑通上例的最小脚本,它用自己定义的 hooks_begin/hooks_end 代替 __start_/__stop_:
ENTRY(_start)SECTIONS{ . = 0x10000; .text : { *(.text .text.*) } . = ALIGN(0x1000); .data : { *(.data .data.*) . = ALIGN(8); PROVIDE(hooks_begin = .); KEEP(*(myhooks)) PROVIDE(hooks_end = .); } .bss : { *(.bss .bss.*) *(COMMON) } /DISCARD/ : { *(.comment) }}逐句看:
ENTRY(_start)指定入口符号,对应上文入口规则的第二条。SECTIONS { ... }里每一项.名字 : { ... }定义一个输出节,花括号里是输入节描述,写法和默认脚本相同。也可以只匹配某些文件,比如*crtbegin.o(.ctors)只取文件名以crtbegin.o结尾的那个文件里的.ctors。.是前面见过的位置计数器。. = 0x10000;把它设到 0x10000,下一个输出节从这里开始;. = ALIGN(0x1000);把它推到下一个 4 KiB 边界。在输出节内部,.随着输入节的放入不断增长,所以hooks_begin = .记下的是myhooks放入前的地址,hooks_end = .是放入后的地址。. = ALIGN(8);不能省。myhooks要求 8 字节对齐,链接器放它之前会自己补填充,但那是在hooks_begin = .求值之后;如果前面的.data长度不是 8 的倍数,hooks_begin就会指向填充字节。实测在.data里多放一个 4 字节的变量、去掉这一行,两个链接器给出的hooks_begin都是 0x11004,而第一个指针实际在 0x11008。KEEP(*(myhooks))把所有myhooks输入节放进.data,并让它们成为 GC 的根。PROVIDE(sym = expr)定义一个符号,但只在程序引用了它而又没有自己定义时才生效。默认脚本里大量使用它,比如PROVIDE (etext = .);,这样用户代码可以自由使用etext这个名字而不会冲突。/DISCARD/是一个特殊的输出节名,放进去的输入节直接丢弃。*(COMMON)收集第 3 章讲过的 common 符号。
遍历用的 run2.c 只是把 run.c 里的两个符号名换掉,编译选项和 run.o 相同:
/* run2.c */typedef void (*hook_t)(void);extern hook_t hooks_begin[], hooks_end[];void _start(void) { for (hook_t *p = hooks_begin; p < hooks_end; p++) (*p)(); for (;;) { }}$ clang -O1 -fno-pic -fno-asynchronous-unwind-tables \ -ffunction-sections -fdata-sections -c run2.c -o run2.o$ ld -T tiny.ld --gc-sections --print-gc-sections -o s_bfd run2.o reg.o$ readelf -lW s_bfd Type Offset VirtAddr PhysAddr FileSiz MemSiz Flg Align LOAD 0x001000 0x0000000000010000 0x0000000000010000 0x000041 0x000041 R E 0x1000 LOAD 0x002000 0x0000000000011000 0x0000000000011000 0x000010 0x000010 RW 0x1000 GNU_STACK 0x000000 0x0000000000000000 0x0000000000000000 0x000000 0x000000 RW 0x10$ readelf -sW s_bfd | grep -E 'hooks|hook_|_start' 3: 0000000000010030 1 FUNC LOCAL DEFAULT 1 hook_a 4: 0000000000010040 1 FUNC LOCAL DEFAULT 1 hook_b 7: 0000000000011000 0 NOTYPE GLOBAL DEFAULT 2 hooks_begin 8: 0000000000011010 0 NOTYPE GLOBAL DEFAULT 2 hooks_end 9: 0000000000010000 34 FUNC GLOBAL DEFAULT 1 _startld.lld -T tiny.ld 得到的 LOAD 段和符号地址相同,只有 GNU_STACK 的 Align 一栏是 0 而不是 0x10。_start 精确地落在 0x10000,.data 落在 0x11000。脚本里没写头部的位置,这次 ELF 头就不在任何 LOAD 段里了。
脚本还可以用 MEMORY 声明目标机器上的内存区域(比如 FLASH 和 RAM),输出节用 > FLASH 指定区域。映射文件里的 VMA 是链接地址,LMA 是加载地址,普通程序二者相同;单片机固件的 .data 初始值烧在 Flash(LMA),启动代码再拷到 RAM(VMA),脚本里用 AT> 表达,第 10 章细讲。
操作系统内核和固件因此离不开链接器脚本。普通的用户程序交给加载器,放在哪里都行,链接器的默认规则就够了;而内核和固件往往没有加载器,或者加载器只会把文件原样拷贝到某个固定地址,然后跳过去。中断向量表必须在硬件规定的地址,代码要在 Flash 里,可写数据要在 RAM 里,有些节在启动后要整段释放,这些都得在脚本里写明。Linux 内核的每个架构都有自己的脚本,x86 的是 arch/x86/kernel/vmlinux.lds.S,它先经过 C 预处理器展开,再交给链接器。
不写 -T 时,GNU ld 用的就是 ld --verbose 打印出来的那份内置脚本,两百多行,本章讲过的规则几乎都能在里面找到对应的一句。lld 没有这样一份文本,它在代码里实现了等价的默认布局,但能接受大部分 GNU ld 的脚本语法。
一个真实的最小脚本:xv6 的 user.ld
tiny.ld 是为本章的例子拼出来的,真实项目里也有差不多同样短的脚本。第 0 章提过的教学操作系统 xv621 跑在 RISC-V 上,它的用户程序(cat、ls、sh)都用同一份 user/user.ld 链接,唯一的例外是 _forktest:Makefile 第 117 到 120 行用 -N -e main -Ttext 0 直接链接它,注释说它要尽量小。下面是 mit-pdos/xv6-riscv riscv 分支 commit 06aad25 里这个文件的全文:
OUTPUT_ARCH( "riscv" )
SECTIONS{ . = 0x0;
.text : { *(.text .text.*) }
.rodata : { . = ALIGN(16); *(.srodata .srodata.*) /* do not need to distinguish this from .rodata */ . = ALIGN(16); *(.rodata .rodata.*) }
.eh_frame : { *(.eh_frame) *(.eh_frame.*) }
. = ALIGN(0x1000); .data : { . = ALIGN(16); *(.sdata .sdata.*) /* do not need to distinguish this from .data */ . = ALIGN(16); *(.data .data.*) }
.bss : { . = ALIGN(16); *(.sbss .sbss.*) /* do not need to distinguish this from .bss */ . = ALIGN(16); *(.bss .bss.*) }
PROVIDE(end = .);}同一 commit 的 Makefile 第 91 行和第 107 行是:
LDFLAGS = -z max-page-size=4096 $(LD) $(LDFLAGS) -T $U/user.ld -o $@ $< $(ULIB)ULIB 是 xv6 自带的四个目标文件 ulib.o usys.o printf.o umalloc.o,用户态的 C 库就这么多,没有 crt1.o。这一节是 Linux 主机上显式选择 RISC-V 工具的 xv6 布局对照,不运行 RISC-V 程序。拿 user.ld 和 RISC-V 的 GNU ld 默认脚本(本机安装的 RISC-V GNU binutils 2.45.50.20251209,riscv64-unknown-elf-ld -m elf64lriscv --verbose;这里显式指定 64 位仿真模式)逐处对照:
-
OUTPUT_ARCH( "riscv" )声明输出文件的目标体系结构,默认脚本开头也有同样一句。 -
默认脚本开头是
ENTRY(_start),user.ld 没有ENTRY,入口于是落到上文规则的第三条:目标平台约定的符号。手册的原话是 "For many targets this is start",RISC-V 也在其中。user/ulib.c定义了void start(int argc, char **argv),调用main后用返回值调用exit,相当于一个只有两行的crt1.o。下面的u.s在start前面塞了两条nop:start在地址 0 时,后面两条回退规则给出的也是 0,分不出走的是哪条。rv64gc 下nop汇编成 2 字节的压缩指令c.nop,GNU ld 给出的e_entry是 0x4,正是start。lld 没有这条规则,只警告cannot find entry symbol _start,入口留成 0。 -
默认脚本从
SEGMENT_START("text-segment", 0x10000) + SIZEOF_HEADERS排起,把头部装进第一个段。user.ld 从. = 0x0;排起,地址 0 前面没有空间,头部不进任何 LOAD 段。xv6 的内核从文件里读头部,不需要它们出现在进程内存里。 -
默认脚本有七八十个输出节,
.init、.init_array、.tdata、.got、.dynamic都在里面;user.ld 只有五个。xv6 的用户程序没有构造函数、没有线程局部变量、不做动态链接,这些节的输入根本不存在。 -
.sdata、.sbss是第 4 章讲过的 RISC-V 小数据节,.srodata是只读的小数据。默认脚本把它们集中排放,并定义__global_pointer$供gp寻址;user.ld 直接并进普通节,注释说不必区分(第 4 章引用过kernel.ld里同样的注释),也就没有__global_pointer$。 -
只读和可写两部分之间,默认脚本用
DATA_SEGMENT_ALIGN,保留页内偏移只把地址推到下一页;user.ld 用. = ALIGN(0x1000);,让.data从新一页的开头开始。 -
PROVIDE(end = .);是第 3 章讲过的传统符号end。
最后两处差别,以及 Makefile 里的 -z max-page-size=4096,都是为了 xv6 的加载器。第 6 章会细读 xv6 内核里 exec 系统调用的实现 kexec,这里只看它对链接器提的要求:对每个 PT_LOAD,它先检查 ph.vaddr % PGSIZE != 0(PGSIZE 是 xv6 定义的页大小,4096),不满足就拒绝执行;再调用 loadseg,按页循环,用 walkaddr(查进程页表,把虚拟地址换成物理地址)查出每一页的物理地址,用 readi(从文件的指定偏移读若干字节)每次最多读一页。walkaddr 返回的是物理页的起点,不带页内偏移,所以 loadseg 的注释写着 "va must be page-aligned"。
前面说同余是整页映射的直接推论。Linux 用 mmap 加载,要求 p_offset 与 p_vaddr 模页大小同余,段可以从页中间开始。xv6 用 readi 把文件内容拷进新分配的页,从文件哪个偏移读都行,p_offset 取什么值它都不在乎;它要求的是 p_vaddr 本身按页对齐。两套约束各自来自加载器的工作方式,同余对 xv6 没有用处,页对齐对 Linux 也不是必需的。前面 separate-code 一节里 lld 链接 plain.o 得到的 RX 段,p_offset 是 0x160,p_vaddr 是 0x201160,满足 Linux 的要求,xv6 会拒绝。
-z max-page-size=4096 也是为加载器写的。ALIGN(0x1000) 只把地址推到下一个 4 KiB 边界,链接器判断两个段是否同处一页,用的却是它假设的最大页大小,也就是前面同余一节末尾讲的 -z max-page-size。用下面这个 RISC-V 小程序实测:
$ cat u.s .text nop nop .globl startstart: la a0, counter lw a0, 0(a0) li a7, 2 ecall .section .rodatamsg: .asciz "hi" .data .balign 4counter: .word 1 .bss .balign 4buffer: .zero 4096$ riscv64-unknown-elf-as -march=rv64gc -mabi=lp64d -mno-relax u.s -o u.o$ riscv64-unknown-elf-ld -m elf64lriscv -T user.ld -o u u.o$ riscv64-unknown-elf-readelf -hlW u | grep -E 'Entry|LOAD' Entry point address: 0x4 LOAD 0x001000 0x0000000000000000 0x0000000000000000 0x000023 0x000023 R E 0x1000 LOAD 0x002000 0x0000000000001000 0x0000000000001000 0x000004 0x001010 RW 0x1000$ riscv64-unknown-elf-ld -m elf64lriscv -z max-page-size=65536 -T user.ld -o u64 u.oriscv64-unknown-elf-ld: warning: u64 has a LOAD segment with RWX permissions$ riscv64-unknown-elf-readelf -lW u64 | grep LOAD LOAD 0x010000 0x0000000000000000 0x0000000000000000 0x001004 0x002010 RWE 0x10000这套 RISC-V 工具的默认值已经是 0x1000,加上 -z max-page-size=4096 输出完全相同。改成 65536,0 和 0x1000 落在同一个 64 KiB 的"页"里,GNU ld 把两部分并成一个 RWX 段,文件也大了 0xF000 字节。Makefile 把这个假设钉成 xv6 的页大小,产物就不随工具链的默认值变化。
lld 也接受这份脚本,但要补两个选项:-e start,因为它不认 start;--no-rosegment,否则 .rodata 会单独成段,u.o 的这个段从 0x14 开始,过不了 kexec 的对齐检查。这里观察的是 xv6 的布局约束;当前原生 x86-64 课程不要求 tinylink 链接这些 RISC-V 用户程序。内核本身用的是另一份 kernel.ld,它要把入口钉在 QEMU22 跳转的物理地址上,还要导出 etext、end 给内核代码划分权限和内存,那是第 10 章的内容。
映射文件:看布局的结果
脚本写完,怎么确认链接器真按你的意思排了?让它把结果写出来:-Map=文件名。GNU ld 的映射文件按默认脚本的顺序逐条展开,信息很全。开头先列出被 GC 丢弃的输入节:
$ ld --gc-sections -Map=out.map -o bfd_gc split.o$ cat out.mapDiscarded input sections
.text 0x0000000000000000 0x0 split.o .text.unused 0x0000000000000000 0x4 split.o .rodata.msg 0x0000000000000000 0x3 split.o .llvm_addrsig 0x0000000000000000 0x0 split.o最后一行的 .llvm_addrsig 是 clang 生成的节,记录哪些符号的地址被取用过,供 lld 的相同代码折叠(ICF23,第 12 章)使用。它带 SHF_EXCLUDE 标志,意思是"不进输出文件",GNU ld 按这个标志丢掉它。
然后每个输出节下面列出它由哪些输入节组成、每个输入节的地址和大小、其中定义了哪些符号,以及对齐产生的填充:
.text 0x0000000000401000 0x32... *(.text .stub .text.* .gnu.linkonce.t.*) .text.used 0x0000000000401000 0x9 split.o 0x0000000000401000 used *fill* 0x0000000000401009 0x7 .text._start 0x0000000000401010 0x22 split.o 0x0000000000401010 _startused 占 9 字节,.text._start 要求 16 字节对齐,中间补了 7 字节的 *fill*。往下翻能看到位置计数器的每一次赋值:
0x0000000000402000 . = DATA_SEGMENT_ALIGN (CONSTANT (MAXPAGESIZE), CONSTANT (COMMONPAGESIZE))....data 0x0000000000402000 0x4 *(.data .data.* .gnu.linkonce.d.*) .data.counter 0x0000000000402000 0x4 split.o 0x0000000000402000 counter开头那个问题的答案就在这里:counter 在 0x402000,used 在 0x401000,P = 0x401004,0x402000 − 4 − 0x401004 = 0xff8。lld 的映射文件更紧凑,一行一项,下面是同一输入的 lld 映射文件末尾。
程序突然大了一截时,对比前后两份映射文件,就能看出是哪个输出节变大、多了哪些输入节、来自哪个目标文件。
用 ld.lld --gc-sections -Map=split.map split.o -o split_lld 链接前面 GC 实验的输入(-Map 指定映射文件),文件末尾是这样几行:
VMA LMA Size Align Out In Symbol... 0 0 42 1 .comment 0 0 42 1 <internal>:(.comment) 0 0 90 8 .symtab 0 0 90 8 <internal>:(.symtab) 0 0 35 1 .shstrtab 0 0 35 1 <internal>:(.shstrtab) 0 0 23 1 .strtab 0 0 23 1 <internal>:(.strtab)Out 一列是输出节,In 一列是组成它的输入节。<internal> 表示这一块不是从哪个输入文件原样搬来的,而是链接器生成的。.symtab 和两个字符串表是链接器新写的;.comment 同样带 MS 标志,lld 把各输入文件的 .comment 去重,再加上自己的一行版本串,合成一个新节。
文件写完之后
到这里,静态链接的地址分配就完整了。输入节按规则并成输出节,可合并的字符串先去重;输出节按权限装进段,段按约定的基址和同余规则放进地址空间。GC 在布局之前删掉不可达的节,链接器脚本可以改写其中任何一步。对本章这些不依赖共享库、也不需要运行时解析符号的固定地址程序,所展示的重定位可以在链接时完成。ET_EXEC 本身并不保证不存在动态链接:采用固定主程序地址的可执行文件,也可以在运行时加载共享库并完成剩余重定位。
链接器的工作到这里就交卷了,交出去的是一个文件:几个 PT_LOAD 段写明了从文件哪里取多少字节、放到哪个地址、给什么权限,ELF 头里写着入口 _start 的地址。可程序要运行,光有文件不够。谁来读这张程序头表,按它把字节放进内存?.bss 那段只在 p_memsz 里出现、文件里根本没有的零从哪里来?PIE 的基址在什么时候、由谁选定,那些按基址 0 填好的绝对地址又由谁补上?_start 被跳到的时候,栈上已经有了什么,它离 main 还有多远?这张程序头表交给谁、它怎样变成一个进程,是下一章的内容。
练习
完整源文件、链接脚本和执行命令已在本节逐项给出。
练习一,观察。用 lld 链接本章的 plain.o,同时写出映射文件:
$ ld.lld -Map=lld.map -o lld plain.o$ readelf -lW lld$ readelf -SW lld回答:三个 LOAD 段各装了哪些输出节,每个输出节由哪个输入节组成,其中定义了哪些符号?RW 段的 FileSiz 和 MemSiz 差多少,差出来的是什么?.bss 在文件里占多少字节,从 readelf -S 的哪两列能看出来?
练习二,手算。一个目标文件只有四个节:
节 类型 大小 对齐.text PROGBITS 0x1a3 16.rodata PROGBITS 0x2c 16.data PROGBITS 0x18 8.bss NOBITS 0x2000 64用下面的脚本链接,页大小 0x1000:
ENTRY(_start)PHDRS { ro PT_LOAD; rx PT_LOAD; rw PT_LOAD; }SECTIONS{ . = 0x400100; .rodata : { *(.rodata) } :ro . = ALIGN(0x1000) + (. & 0xfff); .text : { *(.text) } :rx . = ALIGN(0x1000) + (. & 0xfff); .data : { *(.data) } :rw .bss : { *(.bss) } :rw /DISCARD/ : { *(.comment) *(.note.GNU-stack) }}PHDRS 用来自己声明程序头,节后面的 :ro 指定它进哪个段;这里没有声明头部要装入,所以头部不进任何段。(. & 0xfff) 是位置计数器的页内偏移,ALIGN(0x1000) + (. & 0xfff) 就是"下一页的同一页内偏移",效果和 DATA_SEGMENT_ALIGN 一样。已知文件开头是 64 字节的 ELF 头和 3 个各 56 字节的程序头。规则只有两条:输出节的起点是当前的 . 按该节的对齐向上取整;每个段第一个节的文件偏移,取不小于当前文件末尾、且与它的地址模 0x1000 同余的最小值。先列出每个节的起始地址,再算三个 LOAD 段的 p_offset、p_vaddr、p_filesz、p_memsz。
练习三,改坏。把 main.c 里的 msg 和 unused 删掉,用本章开头的编译选项编译成 t.o,写一个最小脚本 ok.ld:.text 从 0x10000 开始,.data 和 .bss 放在下一页。用两个链接器分别链接,确认 used 在 0x10000。然后做三处修改,每处先预测报错还是警告,再运行:
- 把
.data前面的. = ALIGN(0x1000);改成. = 0x10010;,让两个段重叠。 - 把
.text :改成.text 0x10004 :,给一个不满足 16 字节对齐的地址。 - 把
. = ALIGN(0x1000);改成. = 0x10800;,两段不重叠,但同处一页、权限不同。继续使用 x86-64 本机目标,把_start末尾的死循环换成 Linuxexit系统调用,再直接执行两个链接器的产物,比较页权限。
答案
练习一
$ readelf -lW lld Type Offset VirtAddr PhysAddr FileSiz MemSiz Flg Align PHDR 0x000040 0x0000000000200040 0x0000000000200040 0x000118 0x000118 R 0x8 LOAD 0x000000 0x0000000000200000 0x0000000000200000 0x00015b 0x00015b R 0x1000 LOAD 0x000160 0x0000000000201160 0x0000000000201160 0x000042 0x000042 R E 0x1000 LOAD 0x0001a4 0x00000000002021a4 0x00000000002021a4 0x000004 0x00100c RW 0x1000 GNU_STACK 0x000000 0x0000000000000000 0x0000000000000000 0x000000 0x000000 RW 0
Section to Segment mapping: Segment Sections... 00 01 .rodata 02 .text 03 .data .bss 04$ cat lld.map VMA LMA Size Align Out In Symbol 200158 200158 3 1 .rodata 200158 200158 3 1 plain.o:(.rodata) 200158 200158 3 1 msg 201160 201160 42 16 .text 201160 201160 42 16 plain.o:(.text) 201160 201160 9 1 used 201170 201170 4 1 unused 201180 201180 22 1 _start 2021a4 2021a4 4 4 .data 2021a4 2021a4 4 4 plain.o:(.data) 2021a4 2021a4 4 1 counter 2021b0 2021b0 1000 16 .bss 2021b0 2021b0 1000 16 plain.o:(.bss) 2021b0 2021b0 1000 1 buffer ...$ readelf -SW lld | grep -E '\.data|\.bss|\.comment' [ 3] .data PROGBITS 00000000002021a4 0001a4 000004 00 WA 0 0 4 [ 4] .bss NOBITS 00000000002021b0 0001a8 001000 00 WA 0 0 16 [ 5] .comment PROGBITS 0000000000000000 0001a8 000042 01 MS 0 0 1第一个 LOAD(R)装 ELF 头、程序头表和 .rodata(来自 plain.o:(.rodata),定义 msg);第二个(RX)装 .text(来自 plain.o:(.text),定义 used、unused、_start,没开 GC,unused 还在);第三个(RW)装 .data(counter)和 .bss(buffer)。
RW 段 MemSiz − FileSiz = 0x100c − 0x4 = 0x1008。0x1000 是 buffer,另外 8 字节是 .data 结束的 0x2021a8 到 .bss 按 16 字节对齐后的 0x2021b0 之间的填充。
.bss 在文件里占 0 字节。它的类型是 NOBITS,Off 一列是 0x1a8,紧跟着的 .comment 的偏移也是 0x1a8;Size 一列的 0x1000 只说明它在内存里有多大。加载器按 p_memsz 分配内存、只按 p_filesz 读文件,多出来的部分是零,所以文件里不必存这 4096 个零。
练习二
变量清单:页大小 0x1000;头部共 64 + 3 × 56 = 0xe8 字节。
.rodata:地址 0x400100(已是 16 的倍数),结束于 0x40012c。文件偏移取不小于 0xe8、且模 0x1000 余 0x100 的最小值:0x100。.text:ALIGN(0x1000)得 0x401000,加页内偏移 0x12c 得 0x40112c,按 16 对齐为 0x401130,结束于 0x4012d3。当前文件末尾是 0x100 + 0x2c = 0x12c,模 0x1000 余 0x130 的最小值是 0x130。.data:0x402000 + 0x2d3 = 0x4022d3,按 8 对齐为 0x4022d8,结束于 0x4022f0。文件末尾 0x130 + 0x1a3 = 0x2d3,偏移取 0x2d8。.bss:0x4022f0 按 64 对齐为 0x402300,结束于 0x404300,不占文件空间。
段 p_offset p_vaddr p_filesz p_memszro 0x100 0x400100 0x2c 0x2crx 0x130 0x401130 0x1a3 0x1a3rw 0x2d8 0x4022d8 0x18 0x404300 − 0x4022d8 = 0x2028验证:用汇编写出这四个节(.zero 填出大小,.balign 给出对齐),两个链接器的结果一致,和手算相同:
$ cat calc.s .section .text,"ax",@progbits .balign 16 .globl _start_start: .zero 0x1a3, 0x90 .section .rodata,"a",@progbits .balign 16 .zero 0x2c .section .data,"aw",@progbits .balign 8 .zero 0x18 .section .bss,"aw",@nobits .balign 64 .zero 0x2000$ clang -c calc.s -o calc.o$ ld.lld -T calc.ld -o calc_lld calc.o$ readelf -lW calc_lld Type Offset VirtAddr PhysAddr FileSiz MemSiz Flg Align LOAD 0x000100 0x0000000000400100 0x0000000000400100 0x00002c 0x00002c R 0x1000 LOAD 0x000130 0x0000000000401130 0x0000000000401130 0x0001a3 0x0001a3 R E 0x1000 LOAD 0x0002d8 0x00000000004022d8 0x00000000004022d8 0x000018 0x002028 RW 0x1000$ readelf -SW calc_lld | grep bss [ 4] .bss NOBITS 0000000000402300 0002f0 002000 00 WA 0 0 64$ ld -T calc.ld -o calc_bfd calc.o # readelf -lW 的输出与上面相同两个文件都是 1376 字节。
练习三
ENTRY(_start)SECTIONS{ . = 0x10000; .text : { *(.text .text.*) } . = ALIGN(0x1000); .data : { *(.data .data.*) } .bss : { *(.bss .bss.*) *(COMMON) }}两个链接器给出的 LOAD 段相同,used 在 0x10000,_start 在 0x10010:
LOAD 0x001000 0x0000000000010000 0x0000000000010000 0x000032 0x000032 R E 0x1000 LOAD 0x002000 0x0000000000011000 0x0000000000011000 0x000004 0x001010 RW 0x1000修改 1,两个链接器都报错:
$ ld.lld -T overlap.ld -o ov_lld t.old.lld: error: section .text virtual address range overlaps with .data>>> .text range is [0x10000, 0x10031]>>> .data range is [0x10010, 0x10013]
ld.lld: error: section .text load address range overlaps with .data>>> .text range is [0x10000, 0x10031]>>> .data range is [0x10010, 0x10013]$ ld -T overlap.ld -o ov_bfd t.old: section .data LMA [0000000000010010,0000000000010013] overlaps section .text LMA [0000000000010000,0000000000010031]lld 分别检查链接地址(VMA)和加载地址(LMA),GNU ld 这里报的是 LMA。
修改 2,链接都成功,只有 lld 警告:
$ ld.lld -T mis.ld -o mis_lld t.old.lld: warning: address (0x10004) of section .text is not a multiple of alignment (16)$ ld -T mis.ld -o mis_bfd t.o$ readelf -SW mis_lld | grep ' .text' [ 1] .text PROGBITS 0000000000010004 001004 00003e 00 AX 0 0 16$ readelf -SW mis_bfd | grep ' .text' [ 1] .text PROGBITS 0000000000010004 001004 00003e 00 AX 0 0 4两者都把输出节放在 0x10004,再在节内补 12 字节,让输入节从 0x10010 开始,所以 used 在 0x10010。区别在输出节的对齐记录:lld 保留 16 并警告,GNU ld 悄悄把它降成 4。
修改 3,两个链接器都不报错,结果却完全不同:
$ ld.lld -T samepg.ld -o sp_lld t.o$ readelf -lW sp_lld | grep LOAD LOAD 0x001000 0x0000000000010000 0x0000000000010000 0x000032 0x000032 R E 0x1000 LOAD 0x001800 0x0000000000010800 0x0000000000010800 0x000004 0x001010 RW 0x1000$ ld -T samepg.ld -o sp_bfd t.old: warning: sp_bfd has a LOAD segment with RWX permissions$ readelf -lW sp_bfd | grep LOAD LOAD 0x001000 0x0000000000010000 0x0000000000010000 0x000804 0x001810 RWE 0x1000lld 照写两个段,它们都要映射 0x10000 这一页;GNU ld 把两段并成一个 RWX 段并警告。继续使用 x86-64 源文件,把 a.c 的 _start 改成原生 Linux 退出系统调用:
void _start(void) { buffer[0] = used(41); __asm__ volatile("syscall" : : "a"(60L), "D"((long)buffer[0]) : "rcx", "r11", "memory"); __builtin_unreachable();}在同一台 x86-64 Linux 上用 GNU ld 2.46 和 LLD 21.1.8 原生链接并执行,系统页大小为 4096。a.c 其余定义与 main.c 相同:
$ clang -O1 -fno-pic -fno-asynchronous-unwind-tables -c a.c -o a.o$ ld.lld -z max-page-size=4096 -T samepg.ld -o a_sp a.o$ ld -z max-page-size=4096 -T samepg.ld -o a_sp_bfd a.old: warning: a_sp_bfd has a LOAD segment with RWX permissions$ ld.lld -T ok.ld a.o -o a_ok$ ld -T ok.ld a.o -o a_ok_bfd$ ./a_ok; echo $? # lld 链接未修改的 ok.ld42$ ./a_ok_bfd; echo $? # GNU ld 链接未修改的 ok.ld42$ ./a_sp; echo $? # lld,同页Segmentation fault (core dumped)139$ strace ./a_sp 2>&1 | tail -2--- SIGSEGV {si_signo=SIGSEGV, si_code=SEGV_ACCERR, si_addr=0x10030} ---+++ killed by SIGSEGV (core dumped) +++$ ./a_sp_bfd; echo $? # GNU ld,同页,RWX420x10030 是这个程序的入口 _start,SEGV_ACCERR 表示地址有映射但权限不允许。两个段都要映射 0x10000 这一页,后映射的 RW 段把先映射的 RX 段覆盖了,代码页变成不可执行,取第一条指令就出错,状态 128 + 11 = 139。GNU ld 的产物能运行,代价是代码页可写。两种结果都说明,同余只保证每个段自己映射得上,段与段之间不能共用一页内存,要靠脚本自己留出整页的间隔。
参考
附录:术语与工具
-
GNU — GNU 是 “GNU’s Not Unix” 的递归缩写,指自由软件操作系统项目。GCC、binutils 和 glibc 都属于 GNU 项目,但分别承担编译、二进制处理和 C 运行库职责。 官方文档。 ↩
-
GC — 本文 GC 指 section garbage collection,即链接器从入口和其他根出发保留可达节、删除无用节。它发生在构建阶段,与运行时堆内存的垃圾回收不同。 官方文档。 ↩
-
Clang — Clang 是 LLVM 项目中的 C、C++ 等语言前端及驱动程序。它通常使用集成汇编器,但仍需调用链接器;最终使用哪个链接器取决于目标平台和配置。 官方文档。 ↩
-
LLD — LLD 是 LLVM 项目的链接器。ELF 平台通常通过
ld.lld调用;lld-link则提供兼容 Windows 工具链的接口。它与负责处理源码的 Clang 是不同组件。 官方文档。 ↩ -
RISC-V — RISC-V 是开放的指令集架构。本系列主线是在原生 x86-64 Linux 上构建链接器;RV64 用于架构对照与内核案例。相关例子的编码、寄存器约定和重定位规则见 RISC-V psABI,不能直接套用 x86-64 的规则。 ↩
-
GOT — GOT(Global Offset Table)保存供代码间接访问的地址或相关偏移。它让部分地址修补集中到数据表中;表项的具体用途由重定位类型与 ABI 决定。 官方文档。 ↩
-
PLT — PLT(Procedure Linkage Table)是一组函数调用跳板,常与 GOT 和动态符号绑定配合。PLT 存放指令,不能简单理解成另一张纯地址表。 官方文档。 ↩
-
ELF — ELF(Executable and Linkable Format)规定目标文件、可执行文件与共享对象的结构。通用规则见 gABI,架构相关的调用约定和重定位规则见对应 psABI。 官方文档。 ↩
-
gABI — gABI 是通用 System V ABI,规定 ELF 等跨架构规则;psABI 是处理器相关补充,进一步规定寄存器约定、重定位编号与 TLS 等细节。 官方文档。 ↩
-
binutils — GNU binutils 是一组处理目标文件的工具,包含汇编器
as、链接器ld,以及readelf、nm、objdump、ar等检查与归档工具。 官方文档。 ↩ -
readelf —
readelf检查 ELF 头、节、段、符号及重定位等结构;它读取文件而不执行其中的程序。GNUreadelf与 LLVMllvm-readelf的显示格式可能不同。 官方文档。 ↩ -
GCC — GCC(GNU Compiler Collection)是一组语言编译器。命令
gcc是驱动入口,会组织编译、汇编和链接;在终端调用它,并不意味着后续工作都在同一个进程里完成。 官方文档。 ↩ -
musl — musl 是 Linux 的一种 C 标准库实现,提供
printf等库函数及运行时支持。本系列在需要分析或链接较小的静态运行库时使用它;普通 Linux 服务器不一定预装 musl。 官方文档。 ↩ -
PIE — PIE(position-independent executable)是可以在不同加载基址运行的可执行文件。生成 PIE 需要编译与链接选项配合;static-PIE 还需要自身的启动路径完成必要重定位。 官方文档。 ↩
-
PIC — PIC(position-independent code)使用适合位置变化的寻址方式。它常用于共享库;具体通过 PC 相对寻址还是表项间接访问,取决于架构与符号绑定。 官方文档。 ↩
-
ASLR — ASLR(Address Space Layout Randomization)随机化进程中某些区域的位置。它是操作系统的加载策略,PIE 等产物形式为相应地址变化提供条件。 官方文档。 ↩
-
RELRO — RELRO(RELocation Read-Only)将需要重定位、但之后不应继续写入的区域转为只读。ELF 的
PT_GNU_RELRO描述该范围,实际保护由启动路径实施。 官方文档。 ↩ -
COMDAT — COMDAT 让工具链表示可供择一保留的重复定义组。ELF 通过 section group 与签名表达相关关系;选择副本时,组内关联内容需要一致处理。 官方文档。 ↩
-
FDE — FDE(Frame Description Entry)关联一段代码的地址范围与栈展开指令。移动代码或重新组织
.eh_frame时,链接器必须同步更新相关地址和记录间的引用。 官方文档。 ↩ -
glibc — glibc(GNU C Library)是许多 Linux 发行版默认使用的 C 库。库的启动文件、共享库和动态链接器共同参与程序构建与运行。 官方文档。 ↩
-
xv6 — xv6 是 MIT 用于操作系统教学的小型 Unix 风格内核。本系列采用 RISC-V 版本,借助较小的加载器与链接脚本观察 ELF 到进程的交接。 官方文档。 ↩
-
QEMU — QEMU 可模拟处理器和系统。用户态模式运行另一架构的用户程序,系统模式则连同机器设备一起模拟;本系列 xv6 实验使用后者启动完整内核。 官方文档。 ↩
-
ICF — ICF(Identical Code Folding)合并被判定为等价的代码。字节相同不一定足以证明可合并,还需要考虑重定位目标、函数地址是否可观察以及关联的运行时元数据。 官方文档。 ↩