

[链接器的世界-原理篇14] C++ 与 Rust:语言特性留下的链接难题
本章从链接器可见的文件观察语言特性,不要求先掌握完整 C++ 或 Rust ABI。前提是原理篇 03的符号身份、原理篇 05的节组与去重,以及原理篇 06中 main 之前的启动过程。翻译单元指独立编译的一份源码及其包含内容;crate 是 Rust 的编译与依赖单位,并不等于一个源码文件。
语言支持可以分成三项责任。编译器把实体身份、数据结构与运行时需求写入目标文件;链接器处理这些符号、节和重定位;运行库执行初始化、同步与异常处理。链接器通常不需要理解类定义或泛型源码,却必须保留它们在二进制接口中表达的关系。
| 语言要求 | 编译器提供的表示 | 链接与运行时各负责什么 |
|---|---|---|
| 同一 inline 函数或模板实例可出现在多个文件中 | 修饰名、绑定、COMDAT 组 | 链接器保留一致的实体身份,并重定向引用 |
| 虚调用与运行时类型识别 | 虚表、typeinfo、指针重定位 | 链接器布局并修补指针,生成的代码和运行库使用这些数据 |
| 初始化、局部 static 与 panic | 初始化数组、guard、辅助函数引用及展开信息 | 链接器连接数据和依赖;启动代码、guard 协议与展开器执行相应行为 |
先沿这三项责任理解各例的输入与结果。名字文法的逐项解码可留作查询;Rust 部分再跟踪 crate → 对象/归档 → 链接命令,比较 panic 与 no_std 对运行时的不同要求。涉及异常清理时,恢复调用者的基础规则见原理篇 08。
C 代码通常把函数声明放进头文件,把实现放进一个 .c 文件。多个文件都可以调用它,最终只需要找到那一个定义。C++ 的头文件却经常直接包含函数体:一个短小的 inline 函数,或者一个要适用于许多类型的函数模板。两个 .cpp 包含同一个头文件,就可能各自生成同一个函数的机器码。
这时,简单地把同名定义当成错误已经不够了。有些重复是语言允许的,最终还必须表现为同一个实体;另一些看似同名的函数实际是不同的重载,必须同时存在。编译器需要把“哪些不同、哪些相同”表达成链接器认识的名字、绑定和节组。名字修饰与重复定义处理,正是 C++ 语言规则落到目标文件上的两个接口。
头文件中的函数,为什么没有重复定义错误
inline 容易被理解为“要求把函数体展开到调用处”,但展开与否是优化选择。这里更关键的语言规则是:满足 ODR1 的一致性条件时,具有外部链接的 inline 函数可以在多个翻译单元中定义,却仍代表同一个函数。函数中的静态局部变量也必须由这些调用共同使用。函数模板则是一份生成规则;给出 int 这样的类型参数后,编译器才能生成对应的函数实例。
头文件 common.h 把三种情况放在一起:twice 是 inline 函数,add 是函数模板,next_id 的静态局部变量 n 要跨调用保存计数。
// common.h:两个 .cpp 都包含它inline int twice(int x) { return 2 * x; }
template <typename T>T add(T a, T b) { return a + b; }
inline int next_id() { static int n = 0; // 函数内的静态局部变量 return ++n;}a.cpp 和 b.cpp 都包含它,都调用这三个函数,都用 int 实例化了 add:
// a.cpp#include "common.h"int fa(int x) { return twice(x) + add<int>(x, 1) + next_id(); }// b.cpp#include <cstdio>#include "common.h"int fa(int x);int fb(int x) { return twice(x) + add<int>(x, 2) + next_id(); }int main() { int a = fa(1), b = fb(1); std::printf("fa=%d fb=%d next_id=%d\n", a, b, next_id());}用 -O0 分别编译这两个文件,本例的 GCC 会为三个函数都生成可调用的副本,也为 n 分配存储。若把 twice 换成头文件里一个普通的非 inline 函数,两份外部定义会触发第 3 章的 multiple definition 错误。现在的差别应该能从目标文件中看出来:符号是强定义还是弱定义,节是否放进了 COMDAT2 组,以及最终有没有合并为同一个计数器。
如果两个文件各用自己的 n,main 中最后一次调用会得到 2;如果三次调用共享它,就会得到 3。this example also检查符号、节组和运行结果:
$ g++ -fno-pie -O0 -c a.cpp$ g++ -fno-pie -O0 -c b.cpp$ g++ -fno-pie -static a.o b.o -o ab$ nm a.o0000000000000000 T _Z2fai0000000000000000 W _Z3addIiET_S0_S0_0000000000000000 W _Z5twicei0000000000000000 W _Z7next_idv0000000000000000 u _ZZ7next_idvE1n$ readelf -gW a.o
COMDAT group section [ 1] `.group' [_Z5twicei] contains 1 sections: [Index] Name [ 9] .text._Z5twicei
COMDAT group section [ 2] `.group' [_ZZ7next_idvE1n] contains 1 sections: [Index] Name [ 10] .bss._ZZ7next_idvE1n
COMDAT group section [ 3] `.group' [_Z7next_idv] contains 2 sections: [Index] Name [ 11] .text._Z7next_idv [ 12] .rela.text._Z7next_idv
COMDAT group section [ 4] `.group' [_Z3addIiET_S0_S0_] contains 1 sections: [Index] Name [ 13] .text._Z3addIiET_S0_S0_$ nm ab | grep -E 'twice|addI|next_id'00000000004018b0 W _Z3addIiET_S0_S0_000000000040187f W _Z5twicei0000000000401891 W _Z7next_idv00000000004b1a90 u _ZZ7next_idvE1n$ ./abfa=5 fb=7 next_id=3链接没有报错。三个函数都是 W(弱的函数),n 是 u(GNU unique 数据对象),而且每一个都单独待在自己的 COMDAT 组里,组的签名就是符号名本身。两种去重的手段同时用上了,看不出链接器不报错靠的是哪一样。b.o 的 nm3 输出也包含这些可合并定义,但完整符号表并不与 a.o 相同,它还定义自己的 fb 和 main。最终产物里每个可合并名字只剩一个地址,next_id=3 说明全程序只有一个 n,三次调用数的是同一个计数器。fa(1) 是 2+2+1,fb(1) 是 2+3+2,main 里那次是第 3 次。
再看组里的成员。next_id 的组有两个节,代码节和它的重定位节 .rela.text._Z7next_idv,因为它要引用 n 的地址;n 没有和 next_id 同组,它单独成组,放在 .bss._ZZ7next_idvE1n 里。
同一台 Linux 上换用 Clang4 21,三个函数仍是 W,静态局部变量变成 V。GCC 生成的同一个变量则是 u,用 readelf5 可以进一步确认绑定:
$ clang++ -fno-pie -O0 -c a.cpp -o a_clang.o$ nm a_clang.o0000000000000000 T _Z2fai0000000000000000 W _Z3addIiET_S0_S0_0000000000000000 W _Z5twicei0000000000000000 W _Z7next_idv0000000000000000 V _ZZ7next_idvE1n$ readelf -sW a.o | grep _ZZ 7: 0000000000000000 4 OBJECT UNIQUE DEFAULT 10 _ZZ7next_idvE1n小写 u 对应 STB_GNU_UNIQUE,是 GNU 对 ELF6 的扩展;Clang 这里用的是 WEAK。GNU unique 用于共享库加载时保持同一 C++ 实体的身份;GCC 的 -fno-gnu-unique 可以关闭这种绑定。它与普通弱定义并不具有完全相同的动态加载语义,但本例静态链接再配合 COMDAT,两者都得到唯一的计数器。GCC Code Gen Options说明了这项选项以及对 dlclose 的影响。
名字修饰:把类型写进名字
C 的函数 area 在 ELF 符号表里就叫 area。C++ 不能这样做:report(int) 和 report(double) 是两个函数,geo::counter 和全局的 counter 是两个变量,Point::norm() const 是某个类的成员。第 3 章说过,链接器配对只比较符号名这个字符串,它不知道什么是命名空间,什么是参数类型。于是编译器把这些信息编码进名字,生成一个在链接层面唯一的字符串,这就是名字修饰(name mangling),解码的过程叫 demangle。
修饰规则不属于 C++ 标准,由 ABI7 规定。Linux、BSD、macOS 和大部分非 Windows 平台上的 GCC、Clang 用的是 Itanium C++ ABI 第 5.1 节(Itanium C++ ABI: External Names)。这套 ABI 原本为 Intel 的 Itanium 处理器制定,后来成了这些平台上 C++ 的通用约定,除了修饰之外还规定了类的布局、虚表、异常处理(第 8 章的 personality 和 LSDA8 就出自它的异常处理部分)。它的总体结构只有一行:
<mangled-name> ::= _Z <encoding>文档在这一行前面写着"Entities with C linkage and global namespace variables are not mangled",带 C 链接属性的实体和全局命名空间里的变量不修饰。其余的名字都以 _Z 开头。C 和 C++ 标准都把以下划线加大写字母开头的标识符保留给实现,用户代码不应使用(编译器其实照样接受),_Z 前缀因此不会和正常的 C 符号冲突。
读一个 _Z 名字
示例放了一组声明,函数体都是空的:
#include <string>namespace geo {struct Point { int x, y; int norm() const; };int Point::norm() const { return x * x + y * y; }double dist(const Point &a, const Point &b) { return 0; }void move(Point &p, const Point &d) {}}void report(int) {}void report(double) {}void report(const char *) {}void report(const std::string &) {}template <typename T> T biggest(T a, T b) { return a > b ? a : b; }template long biggest<long>(long, long);template double biggest<double>(double, double);extern "C" void report_c(int) {}int counter = 0;namespace geo { int counter = 0; }编译后看符号表,再交给 binutils 的 c++filt 和 LLVM9 的 llvm-cxxfilt 解码:
$ g++ -fno-pie -O0 -c names.cpp$ nm names.o | grep -v ' U '0000000000000079 T _Z6reportPKc0000000000000088 T _Z6reportRKNSt7__cxx1112basic_stringIcSt11char_traitsIcESaIcEEE0000000000000069 T _Z6reportd000000000000005b T _Z6reporti0000000000000000 W _Z7biggestIdET_S0_S0_0000000000000000 W _Z7biggestIlET_S0_S0_0000000000000032 T _ZN3geo4distERKNS_5PointES2_0000000000000048 T _ZN3geo4moveERNS_5PointERKS0_0000000000000004 B _ZN3geo7counterE0000000000000000 T _ZNK3geo5Point4normEv0000000000000000 B counter0000000000000097 T report_c$ nm names.o | grep -v ' U ' | awk '{print $3}' | c++filtreport(char const*)report(std::__cxx11::basic_string<char, std::char_traits<char>, std::allocator<char> > const&)report(double)report(int)double biggest<double>(double, double)long biggest<long>(long, long)geo::dist(geo::Point const&, geo::Point const&)geo::move(geo::Point&, geo::Point const&)geo::countergeo::Point::norm() constcounterreport_cllvm-cxxfilt 的输出逐行相同,只在 std::allocator<char> > 那里少一个空格,这是两个 demangler 的排版习惯不同。nm -C 和 objdump -C 内部做的是同一件事。
四个 report 的修饰名可以照着规则读出来。_Z 之后先是名字,写成"长度加字符":6report。然后是参数类型,内建类型各有一个字母,i 是 int,d 是 double,c 是 char,l 是 long,v 是 void(空参数列表写作 v,第 3 章的 _Z7versionv 就是这样)。复合类型用前缀表示:P 是指针,R 是左值引用,K 是 const。PKc 从左往右读就是"指向 const char 的指针"。
带命名空间或类的名字要用 N 和 E 括起来,中间依次是各级名字:N3geo4moveE 是 geo::move,N3geo7counterE 是 geo::counter。成员函数的 const 写在 N 后面:_ZNK3geo5Point4normEv 里的 K 修饰的是 this,也就是 norm() const。变量 geo::counter 的修饰名里只有名字没有类型,int 改成 long,符号名不变,第 13 章引用的 Drepper 不建议在 API 里放变量,原因就在这里;全局的 counter 照规则不修饰。
模板参数用 I 和 E 括起来:_Z7biggestIlE 是 biggest<long>。后面是函数类型,T_ 表示第一个模板参数,这里是返回类型;两个参数写成 S0_S0_,这是替换:S_ 是模板名 biggest,S0_ 是 T_,规则见下。
替换:S_ 和 S0_
geo::dist(const Point&, const Point&) 如果照字面写全,两个参数各要写一遍 RKN3geo5PointE。实际的修饰名是 _ZN3geo4distERKNS_5PointES2_,短了不少。这是 ABI 第 5.1.10 节的压缩规则:修饰过程中出现过的"可替换成分"按出现顺序编号,后面再次出现时写成 S_、S0_、S1_……分别引用第 0、1、2 个。文档原文说,替换只针对会出现在符号表里的实体,"we make substitutions for prefixes of qualified names, but not for arbitrary components of them",内建类型也不进字典。
照这个规则给 dist 编号,从左往右,成分先于包含它的结构:
_ZN 3geo 4dist E R K N S_ 5Point E S2_ S_ = geo S0_ = geo::Point S1_ = geo::Point const S2_ = geo::Point const&函数名 dist 本身不进字典(文档列出的两个例外之一:除 extern "C" 函数以外的函数名和运算符名)。读到第一个参数时,geo 已经是 S_,所以 geo::Point 写成 NS_5PointE,它自己成为 S0_;外面包一层 const 是 S1_,再包一层引用是 S2_。第二个参数和第一个完全相同,一个 S2_ 就够了。
geo::move(Point&, const Point&) 是 _ZN3geo4moveERNS_5PointERKS0_。第一个参数是 Point&,进字典的是 S0_ = geo::Point 和 S1_ = geo::Point&;第二个参数是 const Point&,前面没有出现过,但它的核心 geo::Point 出现过,所以写成 RKS0_。ABI 文档里自己举的例子是 _ZN1N1TIiiE2mfES0_IddE,解码成 N::T<int, int>::mf(N::T<double, double>),其中 S0_ 指 N::T 这个模板名,后面接上新的模板参数 IddE。
这个例子里不带参数的模板名 N::T 也进了字典,是"函数名不进字典"之外的例外:语法里 <unscoped-template-name> 和 <template-prefix>(ABI 的说法是"actually refers to a template name (without template arguments)")都可以由 <substitution> 替换,模板名因此总是替换候选,函数模板的名字也一样。_Z7biggestIlET_S0_S0_ 的字典里,S_ 是模板名 biggest,S0_ 是模板参数 T_;谜题里 add<int> 的 _Z3addIiET_S0_S0_ 同理,S_ 是 add,S0_ 是 T_。把最后一个参数换成别的编号交给两个 demangler,可以核对这个顺序:
_Z7biggestIlET_S0_S_ long biggest<long>(long, biggest)_Z7biggestIlET_S0_S0_ long biggest<long>(long, long)_Z7biggestIlET_S0_S1_ (两个工具都无法解码,字典里只有两项)除了编号替换,还有几个固定缩写:St 是 ::std::,Sa 是 std::allocator,Ss 是 std::string 的完整类型,So 是 std::ostream。可上面 report(const std::string &) 的修饰名里没有 Ss,是一长串 NSt7__cxx1112basic_stringIcSt11char_traitsIcESaIcEEE:GCC 5 起 libstdc++ 把新的 std::string 放进内联命名空间 std::__cxx11(第 13 章讲过这次 ABI 切换),它已经不是 Ss 指代的那个 std::basic_string<char, ...>,只能逐级写出来。
修饰规则是平台 ABI 的一部分。仍在这台 Linux 上,Clang 用 --target=arm64-apple-macos 编译不依赖系统头文件的 ms.cpp,再由 llvm-nm 读取 Mach-O,名字多一个下划线,成为 __ZN3geo4moveERNS_5PointERKS0_。同一份源码用 --target=x86_64-pc-windows-msvc 生成 COFF10,report(int) 则修饰为 ?report@@YAXH@Z,其中 X 是返回类型 void,H 是参数 int。这两步只比较文件中的 ABI 编码,不运行 Darwin 或 Windows 程序;脚本不需要相应 SDK。
extern "C"
C 程序调用 C++ 写的函数时名字对不上,C 要 area,C++ 给的是 _Z4areaii,第 3 章用 ver.cpp 和 verc.cpp 演示过这个 undefined reference 和 extern "C" 的修法(mangle/run2.sh 用 area.cpp 重做了一遍)。extern "C" 告诉编译器这个函数使用 C 的语言链接(language linkage),不修饰。C 库的头文件用 __cplusplus 宏包一层,让同一份头文件在两种语言里都声明出不修饰的名字:
#ifdef __cplusplusextern "C" {#endifint area(int w, int h);#ifdef __cplusplus}#endif代价是重载能力没了:两个 extern "C" 的 area 会生成同一个符号名,编译器直接拒绝。
为什么不编码返回类型
report 的四个修饰名里都只有参数,没有返回类型。ABI 第 5.1.5.3 节把规则写得很明白:
Template functions (names or types) have return types encoded, with the exceptions listed below. Function types not appearing as part of a function name mangling, e.g. parameters, pointer types, etc., have return type encoded, with the exceptions listed below. Non-template function names do not have return types encoded.
普通函数名不编码返回类型,因为 C++ 不允许只靠返回类型重载,同一作用域里参数相同的两个函数本来就不能共存,名字里写上返回类型也区分不出更多东西。函数类型出现在别处时要编码,比如函数指针参数 void (*)(int) 写作 PFviE,F 和 E 之间第一个是返回类型。函数模板是另一回事:两个不同的函数模板可以同名、参数相同、只有返回类型不同,它们的实例必须得到不同的名字。tget1.cpp 只看得到 template <typename T> T get(int),tget2.cpp 只看得到 template <typename T> T *get(int),各自用 get<int> 实例化:
$ nm tget1.o tget2.o | grep gettget1.o:0000000000000000 W _Z3getIiET_itget2.o:0000000000000000 W _Z3getIiEPT_i0000000000000000 u _ZZ3getIiEPT_iE1v两个实例都叫 get<int>(int),修饰名靠 T_ 和 PT_ 区分开。如果不写返回类型,它们会落进同一个 COMDAT 签名,链接器只留一份,另一个文件就会调用到错误的函数。
普通函数不编码返回类型,后果是声明和定义的返回类型不一致时,链接器发现不了。ratio.cpp 定义 double ratio(int),use_ratio.cpp 里却声明成 int ratio(int):
$ nm ratio.o use_ratio.o | grep ratioratio.o:0000000000000000 T _Z5ratioiuse_ratio.o: U _Z5ratioi$ ./ratio_badratio(10) = -1282999152$ objdump -d --no-show-raw-insn ratio.o
ratio.o: file format elf64-x86-64
Disassembly of section .text:
0000000000000000 <_Z5ratioi>: 0: endbr64 4: pxor %xmm0,%xmm0 8: cvtsi2sd %edi,%xmm0 c: mulsd 0x0(%rip),%xmm0 # 14 <_Z5ratioi+0x14> 14: ret链接器匹配的是修饰后的符号名,调用双方采用的返回值约定却已经不同。按 x86-64 psABI11,这个 double 结果由 %xmm0 返回;错误的调用者按 int 的约定读取 %eax,并没有读取计算得到的浮点结果。这里违反了跨翻译单元的类型一致性要求,运行得到的整数不能作为有定义的程序结果解释。链接成功只说明名字得到了定义,不能证明调用 ABI 一致。参数类型写错则会改变符号名:use_ratio.cpp 改成声明 double ratio(long),修饰名变成 _Z5ratiol,链接直接失败,lld 还会提示近似的名字:
$ ld.lld -static -o ratio_bad2 ratio.o use_ratio2.old.lld: error: undefined symbol: ratio(long)>>> referenced by use_ratio.cpp>>> use_ratio2.o:(main)>>> did you mean: ratio(int)>>> defined in: ratio.o这和第 3 章"链接器不检查类型"的结论一致:名字修饰把参数类型带进了名字,让一部分类型错误在链接时暴露出来,可返回类型和变量类型仍然不在名字里。把声明放进头文件,让定义它的 .cpp 也包含这个头文件,编译器就能在编译阶段抓住这类不一致。
vague linkage:每个用到的地方都生成一份
开头的 twice、add<int>、n 需要区分两层意义上的“定义”。C++ 的单一定义规则(ODR)允许符合条件的 inline 函数、模板等在多个翻译单元中有定义;这些定义必须满足相同 token 序列及相应的名字查找等一致性要求,不能任意写成不同实现。程序语义上,外部 inline 函数及其静态局部变量仍各是一个实体。语言允许源码重复,不等于允许运行时各自保存一份互不相关的状态。C++ 草案:ODR规定了这些条件。
分开编译时,某个翻译单元需要实体的可调用副本或存储,编译器不能总是假定别处会提供,于是多个目标文件可能都带上它。Itanium ABI 将这种归属不唯一、需要约定生成位置及重复处理方式的情形称为 vague linkage;第 5.2 节为不同实体规定生成规则,并在 ELF 上利用 COMDAT 节组删除重复副本。Itanium C++ ABI:Vague Linkage。
COMDAT 组是在制定 Itanium ABI 的过程中加入 gABI12 的机制。Ian Lance Taylor 的链接器系列第 15 篇(2007 年)列出的 vague linkage 实体是"inline functions defined in a header file, virtual tables, and typeinfo objects"(Linkers part 15),第 16 篇再加上模板实例(Linkers part 16)。按 ABI 5.2 的各小节,可以把会出现重复的东西归成几类:
- inline 函数的外部副本(5.2.1):编译器没有内联,或者需要取它的地址时,在每个引用它的目标文件里生成一份,用 COMDAT 组去重,签名是修饰名。
- inline 函数里的静态数据(5.2.2):开头例子里的
n,修饰名_ZZ7next_idvE1n的意思是"next_id()里的局部实体n",Z...E括住所在的函数。ABI 要求它单独放进 COMDAT 组,它的 guard 变量(后面讲)也要放进 COMDAT 组。 - 模板实例:函数模板、类模板的成员函数和静态数据成员,在需要生成外部副本的目标文件中可能各有一份;显式实例化等机制也可以集中生成。
- 虚表(vtable,5.2.3,第 13 章提过它按槽位调用)和类型信息(typeinfo,5.2.4):虚表的生成位置要看类是否有可作为唯一归属的函数等条件;下面先观察内容,再推导这项称为 key function 的规则。
Taylor 第 16 篇把这种每个翻译单元都实例化、交给链接器去重的做法叫 Borland 模型,与之相对的 Cfront 模型在链接时才回头调用编译器补出缺的实例;GCC 在支持 COMDAT 的平台上用前一种。
两种实现:COMDAT 与弱定义
回到开头的现象:不报 multiple definition,靠的是弱定义还是 COMDAT 组?把 twice 的那一份手写成汇编,用两个宏分别控制"绑定是 WEAK 还是 GLOBAL"和"节在不在 COMDAT 组里",四种组合各生成两个文件,每个文件另有一个调用 twice 的函数 user1 或 user2:
# twice.S(节选)#if defined(COMDAT) .section .text._Z5twicei,"axG",@progbits,_Z5twicei,comdat#else .section .text._Z5twicei,"ax",@progbits#endif#if defined(WEAK) .weak _Z5twicei#else .globl _Z5twicei#endif .type _Z5twicei,@function_Z5twicei: leal (%rdi,%rdi), %eax ret"axG" 里的 G 和后面的 _Z5twicei,comdat 让汇编器生成一个以 _Z5twicei 为签名的 COMDAT 组(第 3 章看过 .group 节的格式)。两个文件一起交给 GNU ld 和 lld,链接成功的话,数一数产物里有几条 lea,也就是 twice 的代码留了几份。示例中的输出:
======== weak+comdat0000000000000000 W _Z5twiceild.bfd: ok, twice 的副本数 = 1ld.lld: ok, twice 的副本数 = 1======== comdat0000000000000000 T _Z5twiceild.bfd: ok, twice 的副本数 = 1ld.lld: ok, twice 的副本数 = 1======== weak0000000000000000 W _Z5twiceild.bfd: ok, twice 的副本数 = 2ld.lld: ok, twice 的副本数 = 2======== neither0000000000000000 T _Z5twiceild.bfd: t2_neither.o: in function `twice(int)':(.text._Z5twicei+0x0): multiple definition of `twice(int)'; t1_neither.o:(.text._Z5twicei+0x0): first defined hereld.lld: error: duplicate symbol: twice(int)>>> defined at t1_neither.o:(twice(int))>>> defined at t2_neither.o:(.text._Z5twicei+0x0)两种手段单独拿出来都能让链接通过,效果却不同。只有 COMDAT 组、符号是 GLOBAL 时,第二个文件的组在符号解析之前就被整组丢弃,它的 _Z5twicei 定义跟着消失,链接器根本看不到第二个强定义,产物里只有一份代码。只有弱定义、没有组时,第 3 章的强弱规则生效:两个弱定义同名不算错,链接器采用第一个,所有调用都指向它;可第二份代码所在的节没有被丢弃,照样占着输出文件的空间,产物里有两份 lea,其中一份没有任何人调用。
COMDAT 组让多余的副本整组消失,弱定义让剩下的同名定义不算冲突。ABI 对 guard 变量两样都要求,5.2.2 讲完 guard 可以和数据同组、也可以单独成组之后,补了一句"In either case, it must be weak"。更早的 .gnu.linkonce 节只靠节名去重,第 1 章讲过它的来历。
弱定义这条退路留下的多余副本,--gc-sections(第 5 章)可以清掉。再写一个 _start 同时调用 user1 和 user2,让两个文件都活着:
======== weak + --gc-sections(_start 调用 user1 和 user2)ld.bfd: 不加 2 份,加 --gc-sections 1 份ld.lld: 不加 2 份,加 --gc-sections 1 份两个调用都解析到第一份 twice,第二份所在的节没有任何引用,被当作垃圾回收。不加这个选项,它就一直留在产物里。
虚表和类型信息长什么样
虚函数调用需要根据对象的实际类型选择实现。常见的实现是在对象里保存一个虚表指针(vptr),由它指向一张函数地址表(vtable);运行时类型识别还需要类型信息对象(typeinfo)。这些结构是编译器生成的数据,也需要符号、存储和重定位。它们可能在多个翻译单元中出现,因此同样涉及 vague linkage。odr_a.cpp 定义一个类 Greeter,两个虚函数都写在类定义里(于是都是 inline 的),再加一个通过指针调用 hello 的函数和一个创建对象的函数:
// odr_a.cppstruct Greeter { virtual const char *hello() { return "hello (A)"; } virtual const char *bye() { return "bye (A)"; }};const char *call_a(Greeter *g) { return g->hello(); }Greeter *make_a() { return new Greeter; }$ readelf -SW odr_a.o | grep -E '_ZT[VIS]7Greeter' [18] .rodata._ZTV7Greeter PROGBITS 0000000000000000 000140 000020 00 AG 0 0 8 [19] .rela.rodata._ZTV7Greeter RELA 0000000000000000 0005c8 000048 18 IG 28 18 8 [20] .rodata._ZTI7Greeter PROGBITS 0000000000000000 000160 000010 00 AG 0 0 8 [21] .rela.rodata._ZTI7Greeter RELA 0000000000000000 000610 000030 18 IG 28 20 8 [22] .rodata._ZTS7Greeter PROGBITS 0000000000000000 000170 000009 00 AG 0 0 8$ readelf -rW odr_a.o | sed -n '/rela.rodata._ZTV7Greeter/,/^$/p;/rela.rodata._ZTI7Greeter/,/^$/p'Relocation section '.rela.rodata._ZTV7Greeter' at offset 0x5c8 contains 3 entries: Offset Info Type Symbol's Value Symbol's Name + Addend0000000000000008 0000001100000001 R_X86_64_64 0000000000000000 _ZTI7Greeter + 00000000000000010 0000000800000001 R_X86_64_64 0000000000000000 _ZN7Greeter5helloEv + 00000000000000018 0000000900000001 R_X86_64_64 0000000000000000 _ZN7Greeter3byeEv + 0
Relocation section '.rela.rodata._ZTI7Greeter' at offset 0x610 contains 2 entries: Offset Info Type Symbol's Value Symbol's Name + Addend0000000000000000 0000001200000001 R_X86_64_64 0000000000000000 _ZTVN10__cxxabiv117__class_type_infoE + 100000000000000008 0000001300000001 R_X86_64_64 0000000000000000 _ZTS7Greeter + 0$ objdump -s -j .rodata._ZTS7Greeter odr_a.o | tail -1 0000 37477265 65746572 00 7Greeter.$ objdump -dr --no-show-raw-insn -j .text._ZN7GreeterC2Ev odr_a.o | grep -A1 'mov \$0x0,%edx' c: mov $0x0,%edx d: R_X86_64_32 _ZTV7Greeter+0x10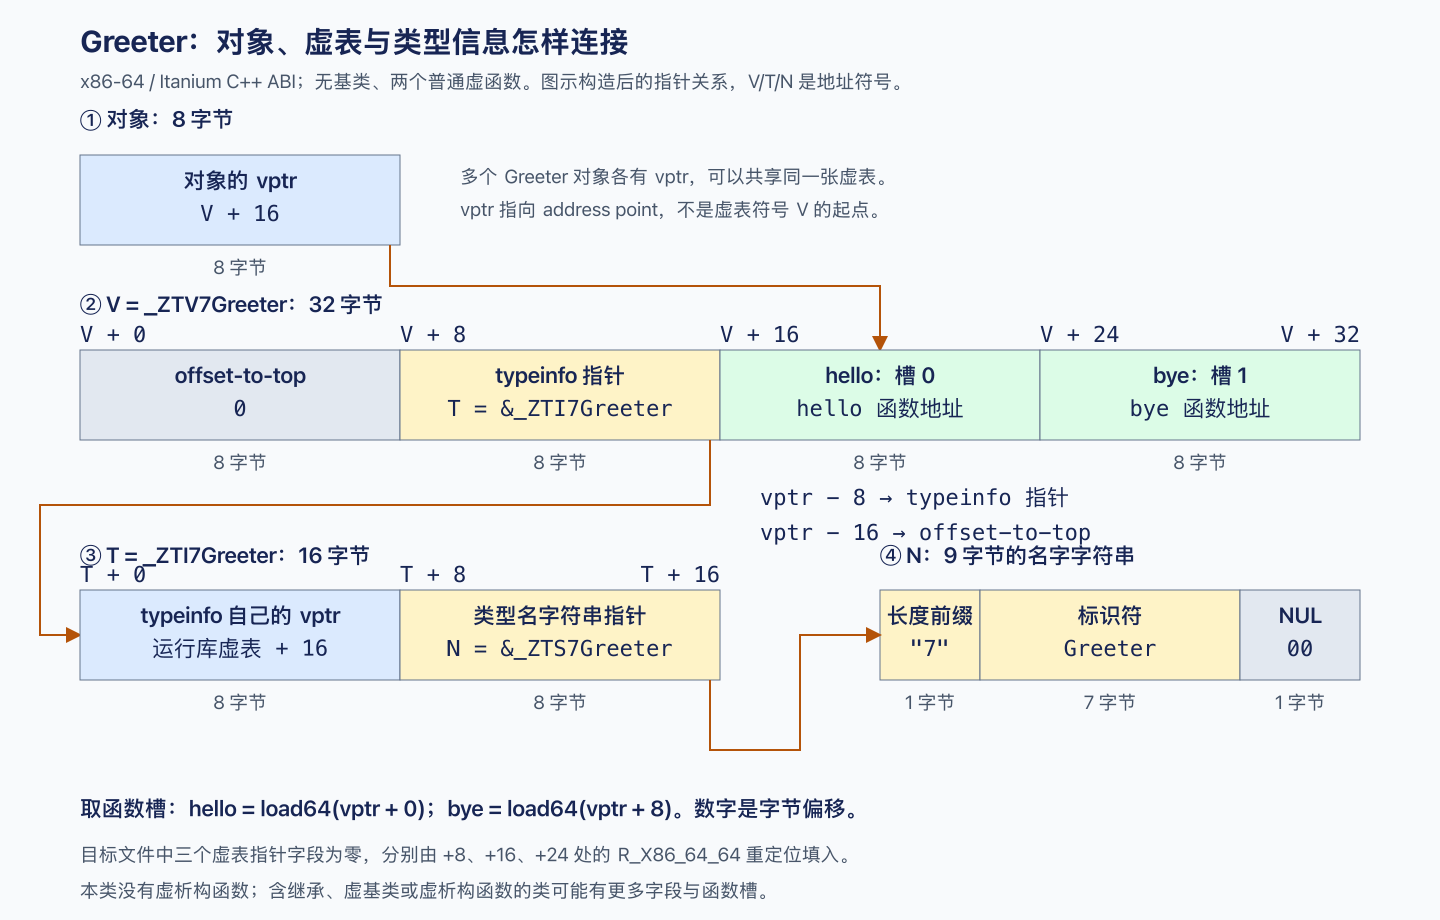
虚表 _ZTV7Greeter 32 字节,4 个 8 字节的项。第一项是 offset-to-top,即"从这个虚表指针所在的子对象到完整对象开头的距离",这个没有基类的 Greeter 中为 0,用不着重定位。第二项指向 typeinfo _ZTI7Greeter。后两项是两个虚函数,顺序就是类定义里的声明顺序。三条重定位都是 R_X86_64_64 绝对地址:本例显式给原生 GCC 加了 -fno-pie,虚表放在只读的 .rodata;生成 PIE 时同样的内容会放进 .data.rel.ro,由第 7 章的 RELRO13 机制在填完地址后设为只读。
typeinfo 16 字节。第一项是 __cxxabiv1::__class_type_info 的虚表加 16,typeinfo 本身也是一个带虚函数的 C++ 对象,有自己的虚表指针;第二项指向类型名字符串 _ZTS7Greeter,内容 7Greeter\0,就是修饰名去掉 _ZTS 的部分。dynamic_cast、typeid 和异常的 catch 匹配类型时用的就是它。
对象里存的虚表指针不指向虚表开头。构造函数写进对象的是 _ZTV7Greeter+0x10,跳过了 offset-to-top 和 typeinfo 两项,指向第一个虚函数。虚函数的槽号从虚表指针指向的位置开始、从 0 数起:hello 是 0 号槽,bye 是 1 号槽。调用第 i 个虚函数就是取 *(vptr + 8*i) 再间接调用,call_a 先 mov (%rax),%rax 从对象里取出虚表指针,再 mov (%rax),%rdx 取 0 号槽,最后 call *%rdx。往前数的两项留给 dynamic_cast 和 typeid,它们从虚表指针往回找 typeinfo 和 offset-to-top。
选哪一份,内容不一样怎么办
第 3 章已经测过:签名相同的 COMDAT 组,GNU ld 和 lld 都保留先读到的那一份。Taylor 第 15 篇的说法是"After the linker sees a COMDAT section f1, it will discard all subsequent f1 COMDAT sections",并且指出如果各份内容不同,链接器"would not notice the error either";他还提到微软的 PE14 格式可以要求重复的 COMDAT 节内容完全相同,否则报错。ELF 链接器不比较内容,前面讲过原因:同一个函数在不同优化选项下合法地生成不同字节。
第 3 章演示的是 inline 函数返回值不同,这里把虚表卷进来。odr_b.cpp 也定义一个叫 Greeter 的类,两个虚函数的声明顺序和 odr_a.cpp 相反,返回的字符串也不同:
// odr_b.cppstruct Greeter { virtual const char *bye() { return "bye (B)"; } virtual const char *hello() { return "hello (B)"; }};const char *call_b(Greeter *g) { return g->hello(); }Greeter *make_b() { return new Greeter; }odr_main.cpp 打印 call_a(make_a()) 和 call_b(make_b())。如果分别观察两份定义,各自把 hello 放在不同的槽号;将它们放进同一个程序却违反了 ODR。这个例子故意构造不一致的类定义,标准不要求诊断这类跨翻译单元违规。下面观察一种构建的后果,不是预测合法 C++ 程序的规则(C++ draft: basic.def.odr)。
$ nm -C odr_a.o | grep -v ' U '0000000000000000 T call_a(Greeter*)0000000000000025 T make_a()0000000000000000 W Greeter::bye()0000000000000000 W Greeter::hello()0000000000000000 W Greeter::Greeter()0000000000000000 W Greeter::Greeter()0000000000000000 n Greeter::Greeter()0000000000000000 V typeinfo for Greeter0000000000000000 V typeinfo name for Greeter0000000000000000 V vtable for Greeter$ readelf -gW odr_a.o | grep 'group section'COMDAT group section [ 1] `.group' [_ZN7Greeter5helloEv] contains 2 sections:COMDAT group section [ 2] `.group' [_ZN7Greeter3byeEv] contains 2 sections:COMDAT group section [ 3] `.group' [_ZN7GreeterC5Ev] contains 2 sections:COMDAT group section [ 4] `.group' [_ZTV7Greeter] contains 2 sections:COMDAT group section [ 5] `.group' [_ZTI7Greeter] contains 2 sections:COMDAT group section [ 6] `.group' [_ZTS7Greeter] contains 1 sections:$ objdump -d --no-show-raw-insn odr_b.o | sed -n '/<_Z6call_bP7Greeter>:/,/ret/p' | grep -E '\(%rax\)|add|call'0000000000000000 <_Z6call_bP7Greeter>: 14: mov (%rax),%rax 17: add $0x8,%rax 1b: mov (%rax),%rdx 25: call *%rdx$ g++ -fno-pie -static odr_main.o odr_a.o odr_b.o -o ab$ ./abcall_a(make_a()) = hello (A)call_b(make_b()) = bye (A)$ g++ -fno-pie -static odr_main.o odr_b.o odr_a.o -o ba$ ./bacall_a(make_a()) = bye (B)call_b(make_b()) = hello (B)Greeter 没有 key function(后面讲),它的虚表、typeinfo、类型名字符串、隐式生成的构造函数都在各自的 COMDAT 组里,每个文件一份。构造函数有 C1(完整对象构造)和 C2(基类子对象构造)两个入口,这里两者相同,GCC 让两个名字指向同一段代码,放进签名为 _ZN7GreeterC5Ev 的同一个组;这个签名符号是定义在 .group 节自身上的 LOCAL 符号,.group 不占内存,nm 就把它显示成 n。
在 B 的类定义里 hello 是 1 号槽,所以 call_b 先 add $0x8 再取。a 在前时,链接器留下 odr_a.o 的构造函数和虚表,make_b() 调用的构造函数也是 A 的那份,它把 A 的虚表地址写进新对象;call_b 取 1 号槽,拿到的是 A 的 bye,于是打印 bye (A)。顺序反过来,call_a 取 0 号槽,拿到的是 B 的 bye。这一构建没有发出警告,交换链接顺序改变了观察结果;ODR 违规本身不具备这样的执行保证。这种问题在实际项目里常见的来源是:两个库各自定义了一个同名的辅助类,都放在全局命名空间里,或者同一个头文件被两个库用不同的宏配置编译。把只在本文件用的类放进匿名命名空间,它的所有符号就成了 LOCAL,不再参加跨文件的去重。
vtable 放在哪个 .o:key function
虚表如果每个用到它的文件都生成一份,大型程序里重复的就太多了。ABI 5.2.3 定了一条规则:
Otherwise, if the class has a key function (see below), the tables are emitted in the object for the translation unit containing the definition of the key function. This is unique if the key function is not inline.
key function 的定义也在同一节:"The key function is the first non-pure virtual function that is not inline at the point of class definition.",即类定义里第一个既不是纯虚、也不是 inline 的虚函数。C++ 要求非纯虚的虚函数必须在某处有定义,而一个非 inline 函数的定义只能有一个,所以定义它的那个翻译单元是唯一的,虚表放在那里就够了,其余文件只引用。
// shape.hstruct Shape { virtual double area() const; // 第一个非 inline、非纯虚的虚函数:key function virtual const char *name() const { return "shape"; } virtual ~Shape() {}};shape.cpp 定义 Shape::area,use_shape.cpp 只包含头文件、创建一个 Shape 并通过指针调用 name() 和 area():
$ nm -C shape.o | grep -v ' U '0000000000000000 W Shape::~Shape()0000000000000000 W Shape::~Shape()0000000000000000 W Shape::~Shape()0000000000000000 n Shape::~Shape()0000000000000000 T Shape::area() const0000000000000000 W Shape::name() const0000000000000000 V typeinfo for Shape0000000000000000 V typeinfo name for Shape0000000000000000 V vtable for Shape$ nm -C use_shape.o U _Unwind_Resume0000000000000000 W Shape::~Shape()0000000000000000 W Shape::~Shape()0000000000000000 W Shape::~Shape()0000000000000000 n Shape::~Shape() U vtable for Shape U operator delete(void*, unsigned long) U __gxx_personality_v0 U __stack_chk_fail0000000000000000 T main U printf$ ./okshape 0三个 Shape::~Shape() 是析构函数的三个入口:D1 析构完整对象,D2 析构基类子对象,D0 是 deleting destructor,析构完再调用 operator delete,供 delete p 经由虚表调用;三者放在签名为 _ZN5ShapeD5Ev 的同一个组里。use_shape.o 里 inline 的析构函数照样各有一份,虚表却只有一个 U。它要虚表,是因为 Shape 的构造函数和析构函数都要把虚表地址写进对象。shape.o 里的虚表仍然是 V、仍然在 COMDAT 组里,虽然按 ABI 它是唯一的。ABI 在这一节的注释里解释过:旧版要求虚表一律用 vague linkage,这在合法程序里没有必要,但"it is also harmless, and implementations may opt to continue to do it for compatibility",GCC 就是这样做的。
如果忘了定义 area,或者定义它的 shape.cpp 没有参加链接:
$ g++ -fno-pie -static use_shape.o -o bad.../ld: use_shape.o: in function `main':use_shape.cpp:(.text+0x1d): undefined reference to `vtable for Shape'.../ld: use_shape.o: in function `Shape::~Shape()':use_shape.cpp:(.text._ZN5ShapeD2Ev[_ZN5ShapeD5Ev]+0xd): undefined reference to `vtable for Shape'collect2: error: ld returned 1 exit status$ ld.lld -static -o bad use_shape.old.lld: error: undefined symbol: vtable for Shape>>> referenced by use_shape.cpp>>> use_shape.o:(main)...报错里没有提到 Shape::area()。main 通过虚表调用 area,目标文件里没有对 _ZNK5Shape4areaEv 的直接引用;缺的是虚表,而虚表缺失的原因要从 key function 规则倒推回去。这条报错的经典来源有三个:key function 只声明没定义;定义它的 .cpp 没有加进构建;以及头文件里的类后来加了一个非 inline 的虚函数,却没人去写它的定义。typeinfo 跟着虚表走(ABI 5.2.4),所以有时看到的是 undefined reference to 'typeinfo for Shape',原因相同。
GNU ld 的报错里有一个细节:析构函数所在的节名写成 .text._ZN5ShapeD2Ev[_ZN5ShapeD5Ev],方括号里是它所属 COMDAT 组的签名。
静态初始化的顺序
vague linkage 处理的是"同一个东西有很多份"。全局对象带来的是另一类问题:它们的初值要运行代码才能算出来,这段代码得在 main 之前执行,而且各个翻译单元的代码之间有先后。
C++ 先进行静态初始化:能常量初始化的对象,其初值可以直接体现在文件数据中;其余对象先零初始化,常常对应 .bss。节的选择还取决于只读性和重定位要求,并不全是 .data。随后,仍需在运行时求值的初始化由代码完成,称为动态初始化;调用构造函数也可能通过常量求值完成,不能仅凭源码中有函数调用就判断。对下面的全局对象,编译器生成初始化函数,并把地址放进 .init_array。第 6 章讲过 .init_array 怎样在 __libc_start_main 里、main 之前被逐项调用,Taylor 第 14 篇讲过它的前身:a.out 时代靠 GNU 链接器的 set 符号把构造函数收集成表,早期 ELF 用 .ctors 节,配合 crtbegin.o、crtend.o 里的首尾标记,后来才有 SHT_INIT_ARRAY 和 DT_INIT_ARRAY(Linkers part 14)。
跨文件初始化为什么会受链接顺序影响
下面四个文件共同构成一个程序。base.h 提供各翻译单元一致的类定义;base_value 是先零初始化的整数,BaseInitializer 的构造函数随后把它写成 40。另一个翻译单元用当时的 base_value 计算 derived:
// base.h#pragma oncestruct BaseInitializer { BaseInitializer(); };extern int base_value;extern int derived;// base.cpp#include "base.h"#include <cstdio>int base_value;BaseInitializer::BaseInitializer() { std::puts("init base"); base_value = 40;}#ifdef PRIO__attribute__((init_priority(PRIO)))#endifBaseInitializer base_initializer;// derived.cpp#include "base.h"#include <cstdio>static int make_derived() { std::puts("init derived"); return base_value + 2;}int derived = make_derived();// main.cpp#include "base.h"#include <cstdio>int main() { std::printf("base=%d derived=%d\n", base_value, derived);}在这些文件所在目录编译:
for f in base derived main; do g++ -fno-pie -O1 -c "$f.cpp"donebase_value 不需要动态初始化;需要运行的是 base_initializer 的构造函数。编译器生成 _GLOBAL__sub_I_base_value,并用一条 8 字节的 .init_array 记录引用它。本次 GNU 工具输出如下,节号和地址随工具链变化:
$ nm base.o0000000000000021 t _GLOBAL__sub_I_base_value0000000000000000 T _ZN15BaseInitializerC1Ev0000000000000000 T _ZN15BaseInitializerC2Ev0000000000000000 B base_initializer0000000000000004 B base_value U puts$ readelf -SW base.o | grep init_array [ 6] .init_array INIT_ARRAY 0000000000000000 000088 000008 08 WA 0 0 8 [ 7] .rela.init_array RELA 0000000000000000 0002f8 000018 18 I 13 6 8$ readelf -rW base.o | grep -A2 'rela.init_array'Relocation section '.rela.init_array' at offset 0x2f8 contains 1 entry: Offset Info Type Symbol's Value Symbol's Name + Addend0000000000000000 0000000200000001 R_X86_64_64 0000000000000000 .text + 21.rela.init_array 的 r_offset=0 表示填写该 .init_array 的第一项,S+A 来自 .text 节符号加 0x21,恰好是初始化函数所在位置。输入数组里保存待重定位的指针;输出数组里保存运行时可以调用的函数地址。
$ g++ -fno-pie -static main.o base.o derived.o -o bd$ ./bdinit baseinit derivedbase=40 derived=42$ g++ -fno-pie -static main.o derived.o base.o -o db$ ./dbinit derivedinit basebase=40 derived=2$ objdump -s -j .init_array bd
bd: file format elf64-x86-64
Contents of section .init_array: 4ac130 70184000 00000000 f9184000 00000000 p.@.......@..... 4ac140 10194000 00000000 40174000 00000000 ..@.....@.@.....$ nm bd | grep -E '_GLOBAL__sub_I|frame_dummy'00000000004018f9 t _GLOBAL__sub_I_base_value0000000000401910 t _GLOBAL__sub_I_derived00000000004ac130 d __frame_dummy_init_array_entry0000000000401870 t frame_dummy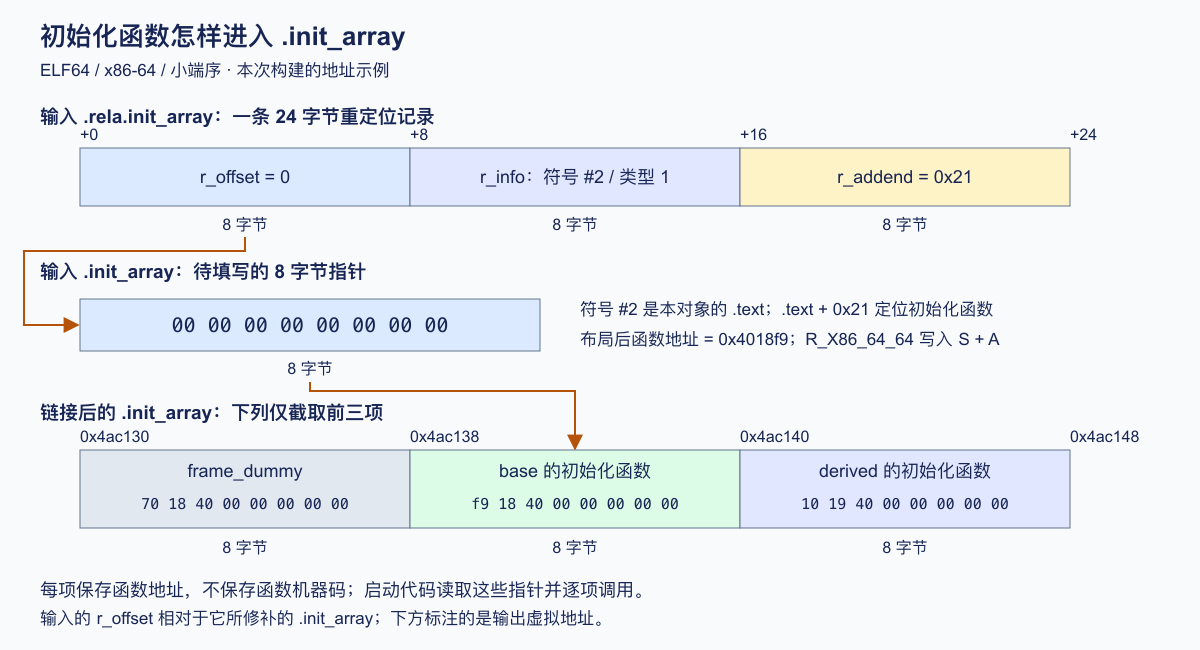
每项 8 字节,按小端序解码。0x4ac130 处的 70 18 40 00 00 00 00 00 是 frame_dummy 的地址 0x401870;下一项 f9 18 40 00 00 00 00 00 指向 0x4018f9;再下一项指向 0x401910。同名 .init_array 输入节在这份默认布局中按输入顺序拼接,glibc 静态运行库另外加入自己的初始化项。替换为 -fuse-ld=lld,两种顺序得到相同的 42/2 对照。
这里 derived=2 来自整数 base_value 已有的零值,不需要访问尚未构造的类对象。base_initializer 先运行就把它改成 40,derived 随后得到 42;反过来,derived 先固定为 2,后续写入 base_value 不会重新计算它。
静态初始化规则保证静态初始化先于动态初始化;动态初始化规则没有为这两个普通翻译单元建立所需的依赖顺序。这里观察的是当前编译器和默认链接布局的行为,不是 C++ 保证按命令行对象顺序执行。这个依赖风险称为 static initialization order fiasco。
可以把依赖显式放进函数调用。下面是完整的替代程序;base() 第一次调用时初始化局部 static,此后返回同一整数:
// base_fix.h#pragma onceint &base();extern int derived;// base_fix.cpp#include "base_fix.h"#include <cstdio>static int make_base() { std::puts("init base"); return 40;}int &base() { static int value = make_base(); return value;}// derived_fix.cpp#include "base_fix.h"#include <cstdio>static int make_derived() { std::puts("init derived"); return base() + 2;}int derived = make_derived();// main_fix.cpp#include "base_fix.h"#include <cstdio>int main() { std::printf("base=%d derived=%d\n", base(), derived);}for f in base_fix derived_fix main_fix; do g++ -fno-pie -O1 -c "$f.cpp"doneg++ -fno-pie -static main_fix.o derived_fix.o base_fix.o -o fix_dbg++ -fno-pie -static main_fix.o base_fix.o derived_fix.o -o fix_bd./fix_db./fix_bd两个程序都打印:
init derivedinit basebase=40 derived=42make_derived 必须先取得 base() 的返回值才能继续计算,因此链接顺序不再承担这条依赖。函数内 static 的一次性初始化由下一节的 guard 机制实现。
init_priority 与 .init_array.N
另一种办法是明确指定初始化优先级。GCC 的 init_priority 属性给一个类类型的全局对象指定 101 到 65535 的优先级,数字越小越先初始化(GCC: C++ Attributes)。上面的 base.cpp 已包含由 PRIO 控制的属性声明;-DPRIO=101 使属性附着到 base_initializer,而不是整数 base_value。宏本身不会改变链接器行为,是声明上的属性让编译器生成带编号的输入节:
$ g++ -fno-pie -O1 -DPRIO=101 -c base.cpp -o base_p.o$ readelf -SW base_p.o | grep init_array [ 6] .init_array.00101 INIT_ARRAY 0000000000000000 000088 000008 08 WA 0 0 8 [ 7] .rela.init_array.00101 RELA 0000000000000000 000300 000018 18 I 13 6 8$ g++ -fno-pie -static main.o derived.o base_p.o -o db_prio && ./db_prioinit baseinit derivedbase=40 derived=42base_p.o 排在最后,base_initializer 的构造函数仍先运行,把 base_value 写成 40。排序是链接器做的。GNU ld 的默认链接脚本里,.init_array 输出节是这样写的:
$ ld.bfd --verbose | grep -A4 '^ .init_array' .init_array : { PROVIDE_HIDDEN (__init_array_start = .); KEEP (*(SORT_BY_INIT_PRIORITY(.init_array.*) SORT_BY_INIT_PRIORITY(.ctors.*))) KEEP (*(.init_array EXCLUDE_FILE (*crtbegin.o *crtbegin?.o *crtend.o *crtend?.o ) .ctors))带编号的 .init_array.* 先放,按 SORT_BY_INIT_PRIORITY 从小到大排;不带编号的 .init_array 放在后面,按输入顺序。旧式的 .ctors.N 在 GNU ld 里也混进同一个排序,它的编号和优先级是反着的(.ctors 从后往前执行),SORT_BY_INIT_PRIORITY 会做换算。lld 没有默认链接脚本,同样的规则写在代码里,对 .init_array 输出节按名字后缀的数字稳定排序,没有后缀的排在最后,同优先级保持输入顺序;.ctors 在 lld 里是单独的输出节,另有一套排序,不会混进 .init_array(lld/ELF/OutputSections.cpp 的 sortInitFini)。这段排序只在没有链接脚本 SECTIONS 命令时生效,自己写链接脚本(第 10 章)就要自己写 SORT_BY_INIT_PRIORITY。实测 -fuse-ld=lld 链接 db_prio,输出与 GNU ld 相同。0 到 100 留给编译器和运行库自己用,用户代码写 50,GCC 15 会给出 -Wprio-ctor-dtor 警告。
GNU ld 的 --sort-section=name 给链接脚本里的通配符模式套上 SORT_BY_NAME(ld 手册:Options),可各个文件的输入节都叫 .init_array,按名字排序不改变它们的相对顺序。实测 -Wl,--sort-section=name 链接 derived.o base.o,输出仍然是 derived=2。
init_priority 的编号是全程序共用的,各个库各自挑数字,同样可能撞车。
guard 变量:函数内的 static
static int value = make_base(); 这一行要求第一次执行到这里时完成初始化,以后不再重复;C++11 起还要求多个线程同时第一次进来时,只有一个线程执行初始化,其他线程等待完成(cppreference: Storage class specifiers, Static block variables)。编译器的实现办法是为这种需要动态初始化的局部 static 配一个 guard 变量,记录“初始化过没有”。常量初始化的局部 static 不需要这条运行时路径。ABI 第 2.8 节规定 guard 是 64 位,第一个字节在初始化前为 0、完成后为 1;第 5.1.4.4 节规定它的名字是 GV 加上被保护对象的名字:
<special-name> ::= GV <object name> # Guard variable for one-time initialization示例有一个普通函数 config() 和一个 inline 函数 config_inl(),里面各有一个用函数调用初始化的 static int value:
static int compute() { std::puts("compute"); return 42; }
int &config() { static int value = compute(); return value;}
inline int &config_inl() { // inline 版本:value 和 guard 都要走 vague linkage static int value = compute(); return value;}int use_inl() { return config_inl(); }$ nm guard.o U _Unwind_Resume0000000000000000 T _Z6configv0000000000000064 T _Z7use_inlv0000000000000000 u _ZGVZ10config_inlvE5value0000000000000000 b _ZGVZ6configvE5value0000000000000000 u _ZZ10config_inlvE5value0000000000000008 b _ZZ6configvE5value U __cxa_guard_abort U __cxa_guard_acquire U __cxa_guard_release U __gxx_personality_v0 U puts$ nm guard.o | awk '{print $NF}' | grep _ZGV | c++filtguard variable for config_inl()::valueguard variable for config()::value$ readelf -gW guard.o | grep -A3 _ZGVCOMDAT group section [ 1] `.group' [_ZGVZ10config_inlvE5value] contains 1 sections: [Index] Name [ 9] .bss._ZGVZ10config_inlvE5value
COMDAT group section [ 2] `.group' [_ZZ10config_inlvE5value] contains 1 sections: [Index] Name$ readelf -sW guard.o | grep -E '_ZGV|_ZZ' 5: 0000000000000000 8 OBJECT LOCAL DEFAULT 6 _ZGVZ6configvE5value 6: 0000000000000008 4 OBJECT LOCAL DEFAULT 6 _ZZ6configvE5value 16: 0000000000000000 8 OBJECT UNIQUE DEFAULT 9 _ZGVZ10config_inlvE5value 17: 0000000000000000 4 OBJECT UNIQUE DEFAULT 10 _ZZ10config_inlvE5value普通函数 config() 只有一个定义,它的 value 和 guard 都是 LOCAL(b),不参与跨文件的全局同名选择,但仍需要链接器布局和重定位。inline 函数 config_inl() 在每个包含它的文件里都有一份,它的 value 和 guard 也必须全程序只有一个,否则每个文件各初始化一次。本机 GCC 因而把两者标成 GNU unique(u),各自放在自己的 COMDAT 组里。ABI 5.2.2 建议 guard 和数据放同一个组,也允许分开,GCC 选了分开。guard 的大小是 8 字节,和 ABI 一致。
config() 的代码就是 ABI 3.3.3 节给出的那段伪代码:
$ objdump -dr --no-show-raw-insn guard.o | sed -n '/<_Z6configv>:/,/^$/p'0000000000000000 <_Z6configv>: 0: endbr64 4: movzbl 0x0(%rip),%eax # b <_Z6configv+0xb> 7: R_X86_64_PC32 .bss-0x4 b: test %al,%al d: je 15 <_Z6configv+0x15> f: mov $0x0,%eax 10: R_X86_64_32 .bss+0x8 14: ret 15: push %rbx 16: mov $0x0,%edi 17: R_X86_64_32 .bss 1b: call 20 <_Z6configv+0x20> 1c: R_X86_64_PLT32 __cxa_guard_acquire-0x4 20: test %eax,%eax 22: jne 2b <_Z6configv+0x2b> 24: mov $0x0,%eax 25: R_X86_64_32 .bss+0x8 29: pop %rbx 2a: ret 2b: mov $0x0,%edi 2c: R_X86_64_32 .rodata.str1.1 30: call 35 <_Z6configv+0x35> 31: R_X86_64_PLT32 puts-0x4 35: movl $0x2a,0x0(%rip) # 3f <_Z6configv+0x3f> 37: R_X86_64_PC32 .bss 3f: mov $0x0,%edi 40: R_X86_64_32 .bss 44: call 49 <_Z6configv+0x49> 45: R_X86_64_PLT32 __cxa_guard_release-0x4 49: jmp 24 <_Z6configv+0x24> 4b: endbr64 4f: mov %rax,%rbx 52: mov $0x0,%edi 53: R_X86_64_32 .bss 57: call 5c <_Z6configv+0x5c> 58: R_X86_64_PLT32 __cxa_guard_abort-0x4 5c: mov %rbx,%rdi 5f: call 64 <_Z7use_inlv> 60: R_X86_64_PLT32 _Unwind_Resume-0x4快路径是三条判断加返回:读 guard 的第一个字节(.bss 偏移 0,PC32 的加数 −4 是第 4 章讲过的指令长度修正),不为 0 就直接返回 value 的地址(.bss+0x8)。为 0 才进慢路径,调用 __cxa_guard_acquire(&guard):返回 1 表示当前线程拿到了初始化权,执行 compute(),把结果存进 value,再调用 __cxa_guard_release 把第一个字节置 1、唤醒等待的线程;返回 0 表示别的线程已经初始化完了。ABI 对 acquire 的描述是"Returns 1 if the initialization is not yet complete; 0 otherwise",还说线程安全的实现"will probably guard access to the first byte of the guard_object with a mutex"。后半段是异常路径:compute() 抛异常时调用 __cxa_guard_abort,把 guard 留在未初始化状态,下次进来再试,然后 _Unwind_Resume 继续展开,这一段由第 8 章讲过的 LSDA 指过来。
这三个函数在 C++ 运行库里。静态链接时,链接器为了它们从 libstdc++.a 拉进 guard.o 这个成员(第 3 章的按需拉取),--trace-symbol 能看到:
$ g++ -fno-pie -static main.o guard.o -o g -Wl,--trace-symbol=__cxa_guard_acquire.../ld: guard.o: reference to __cxa_guard_acquire.../ld: .../libstdc++.a(guard.o): definition of __cxa_guard_acquire$ ./gcomputecompute42 42 42main 调用了两次 config() 和一次 use_inl(),compute 只打印了两次,config 和 config_inl 各一次。
如果程序确定是单线程的,或者是不想依赖运行库的嵌入式代码,可以用 -fno-threadsafe-statics 关掉这套机制:
$ nm guard_nts.o | grep -E 'cxa|_ZGV'0000000000000000 u _ZGVZ10config_inlvE5value0000000000000000 b _ZGVZ6configvE5value$ objdump -dr --no-show-raw-insn guard_nts.o | sed -n '/<_Z6configv>:/,/^$/p'0000000000000000 <_Z6configv>: 0: endbr64 4: cmpb $0x0,0x0(%rip) # b <_Z6configv+0xb> 6: R_X86_64_PC32 .bss-0x5 b: je 13 <_Z6configv+0x13> d: mov $0x0,%eax e: R_X86_64_32 .bss+0x8 12: ret 13: sub $0x8,%rsp 17: mov $0x0,%edi 18: R_X86_64_32 .rodata.str1.1 1c: call 21 <_Z6configv+0x21> 1d: R_X86_64_PLT32 puts-0x4 21: movl $0x2a,0x0(%rip) # 2b <_Z6configv+0x2b> 23: R_X86_64_PC32 .bss 2b: movb $0x1,0x0(%rip) # 32 <_Z6configv+0x32> 2d: R_X86_64_PC32 .bss-0x5 32: mov $0x0,%eax 33: R_X86_64_32 .bss+0x8 37: add $0x8,%rsp 3b: retguard 变量还在,三个 __cxa_guard_* 的引用没了,初始化完成后直接 movb $0x1 写 guard 的第一个字节(cmpb 的立即数占了指令末尾 1 个字节,加数变成 −5),也就是 ABI 3.3.3 开头说的"An implementation that does not anticipate supporting multi-threading may simply check the first byte"。guard 的布局不变,两种目标文件可以混着链接,混在一起时线程安全就无从保证了。
Rust 的链接
名字修饰、去重与初始化并非 C++ 独有的问题。Rust 同样要把多个源码文件和依赖库组织成可执行程序,但编译边界不同:它以 crate 为单位。一个 crate 可以包含多个源码模块,生成一个库或可执行程序;rustc 能一起处理这些模块,也能读取依赖 crate 提供的类型与泛型元数据。因此,有些在 C++ 中依靠头文件传递的信息,在 Rust 中由编译器的中间产物传递。
下面的观察沿用上面的示例。实测编译器为 rustc 1.93.1 (01f6ddf75 2026-02-11),编译器和产物都运行在 x86-64 Linux 上。命令显式写出 edition、target 和需要的名字修饰选项;legacy 对照不传 v0。musl 用来观察自带启动文件与静态运行库的安排,不是跨操作系统运行方案。阅读链接命令前,先区分 rustc 的目标选项与它随后交给 C 驱动程序或链接器的参数。
crate 与 rlib
本节需要 Rust 的 musl 目标标准库,不是只安装 musl-gcc 就够了。先执行下面的编译检查;若报告找不到 std,使用 rustup 管理同版本工具链并安装目标组件(rustup 目标组件说明):
rustc --edition 2024 --target x86_64-unknown-linux-musl --crate-type rlib --emit metadata -o /dev/null - <<'RS'pub fn target_check() {}RS# 仅在缺少该组件、且当前 rustc 由 rustup 管理时执行:rustup target add --toolchain 1.93.1 x86_64-unknown-linux-musl发行版提供的系统 rustc 不一定由 rustup 管理;对另一个工具链安装组件不会补齐这个编译器。编译检查通过后再生成下文的归档。可选的 x86_64-unknown-none 对照还需要它自己的目标组件,不是主线的前提。
rustc 可以把一个 crate 拆成若干个代码生成单元(codegen unit,CGU),各自交给 LLVM 并行生成代码,每个 CGU 产出一个目标文件,名字以 .rcgu.o 结尾。所以 Rust 的"翻译单元"比 C++ 大得多,拆分是编译器自己的事,和源文件怎么划分没有直接关系。
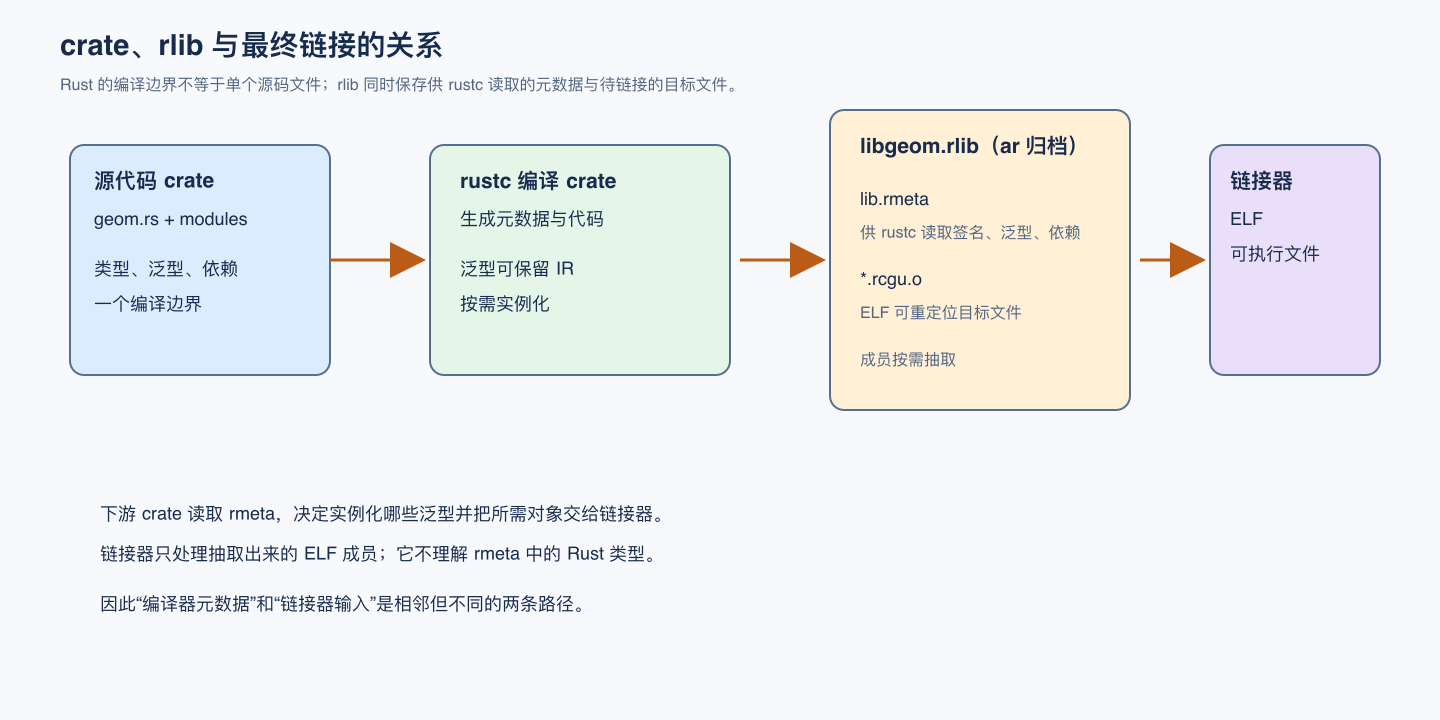
库 crate 默认编译成 rlib。Rust Reference 的 linkage 一章说它是"used as an intermediate artifact and can be thought of as a 'static Rust library'",和 staticlib 不同的是,rlib 会被编译器在之后的编译中解读,rustc 在里面找元数据,就像在共享库里找一样(Rust Reference: Linkage)。它的格式就是第 3 章见过的 ar 归档:
// geom.rs:一个库 cratepub struct Point { pub x: i64, pub y: i64 }impl Point { pub fn norm2(&self) -> i64 { self.x * self.x + self.y * self.y }}pub fn biggest<T: PartialOrd>(a: T, b: T) -> T { if a > b { a } else { b } }#[inline(never)]pub fn area(w: i64, h: i64) -> i64 { w * h }$ rustc --edition 2024 --target x86_64-unknown-linux-musl -C symbol-mangling-version=v0 --crate-type rlib -O geom.rs$ mkdir -p x; (cd x && ar x ../libgeom.rlib)$ ar tv libgeom.rlibrw-r--r-- 0/0 4272 Jan 1 00:00 1970 lib.rmetarw-r--r-- 0/0 3488 Jan 1 00:00 1970 geom.geom.6df4528c38c6272b-cgu.0.rcgu.o$ file x/*x/geom.geom.6df4528c38c6272b-cgu.0.rcgu.o: ELF 64-bit LSB relocatable, x86-64, version 1 (SYSV), not strippedx/lib.rmeta: ELF 64-bit LSB relocatable, x86-64, version 1 (SYSV), not stripped$ nm x/*.rcgu.o0000000000000000 T _RNvCs9rhE2iFS63T_4geom4area$ readelf -SW x/lib.rmeta | grep '\.rmeta' [ 2] .rmeta PROGBITS 0000000000000000 000060 000e7c 00 E 0 0 1本次两个成员都是 ELF 可重定位文件,时间戳是 1970 年,uid 和 gid 是 0,这是为了可复现构建(第 16 章)。lib.rmeta 里只有一个 .rmeta 节,装的是 crate 的元数据:公开了哪些类型和函数、它们的签名、泛型函数的中间表示、依赖了哪些 crate,还有源文件的绝对路径。所以同一份源码换个目录编译,lib.rmeta 的大小就会变:放在 rp/a/ 下是 4280 字节,放在 rp/longer-directory-name/ 下是 4296 字节。要让产物和目录无关,得加 --remap-path-prefix=$PWD=/src,加上以后两处的 rlib 逐字节相同。
本版 rlib 只有 lib.rmeta 和代码目标文件,没有 lib.rmeta-link。lib.rmeta 不定义用于普通符号解析的符号,链接器按需抽取时不会因程序的函数引用而选中它;.rmeta 的 E 标志是 SHF_EXCLUDE,在整库拉入等场合仍要求链接器排除这个节。rlib 是编译器内部产物,不能把某一版的成员数量当成稳定格式契约。
nm 只列出了 area。Point::norm2 是公开函数,却不在目标文件里:rustc 判断它足够小,标记为可跨 crate 内联,不在本 crate 生成代码,等下游用到时由下游去生成。biggest 是泛型函数,类型参数没定,根本没法生成机器码,它以中间表示的形式存在 lib.rmeta 里。这两者和 C++ 头文件里的 inline 函数、模板处境相同,都要在使用者那里生成代码。
两套修饰:legacy 与 v0
_RNvCs9rhE2iFS63T_4geom4area 不是 Itanium 的格式。Rust 的 legacy 规则沿用 _ZN...E 路径编码并追加哈希;v0 使用独立的 _R 语法,能直接表示泛型参数等 Rust 信息。RFC 2603给出了设计与编码。本文采用的 stable 1.93.1 的默认值仍是 legacy,因此用同一个编译器分别省略与显式添加 -C symbol-mangling-version=v0,即可进行对照,不需要 nightly:
$ rustc --edition 2024 --target x86_64-unknown-linux-musl --crate-type rlib -O -C symbol-mangling-version=v0 geom.rs$ nm libgeom.rlib 2>/dev/null | grep ' T '0000000000000000 T _RNvCs9rhE2iFS63T_4geom4area$ rustc --edition 2024 --target x86_64-unknown-linux-musl --crate-type rlib -O geom.rs -o libgeom_legacy.rlib$ nm libgeom_legacy.rlib 2>/dev/null | grep ' T '0000000000000000 T _ZN4geom4area17h76b2d1f845cbc28eElegacy 名字是一个合法的 Itanium 修饰名:_ZN 4geom 4area 17h... E,路径的每一级照"长度加字符"编码,最后一级是一个 17 个字符的分量 h 加 16 位十六进制数。这个哈希是 legacy 区分同名实体的唯一手段,它由编译器内部的数据算出,覆盖了 crate 的身份、泛型实例的类型参数等信息。RFC 2603 列举的毛病里,最主要的一条是泛型参数在修饰过程中丢失:"One cannot extract the type arguments of a monomorphized function from its symbol name"。
v0 名字以 _R 开头,按 RFC 的语法逐个字符读 _RNvCs9rhE2iFS63T_4geom4area:
_R v0 前缀N v 嵌套路径,v 表示值命名空间(函数、静态变量) C s 9rhE2iFS63T_ crate 根,s<base62>_ 是 crate 的消歧值 4geom crate 名 4area 函数名crate 的消歧值(disambiguator)取代了 legacy 的哈希,它只和 crate 的身份有关,同一个依赖图里两个不同版本的 geom 能靠它区分开。泛型实例的类型参数直接编码进名字,另取一个固定的语法测试向量,assert_failed 的实例名是 _RINvNtCs806nzKq9KaB_4core9panicking13assert_failedllECsl1RqEF7rHWY_3std:I ... E 括住泛型参数,两个 l 是两个 i32(v0 的内建类型字母和 Itanium 不同,l 是 i32,x 是 i64,j 是 usize),最后的 Csl1RqEF7rHWY_3std 是"实例化它的 crate",这个名字编码的实例化 crate 是 std;这里只解码给定字符串,不把它称作本机标准库导出的符号。
解码工具有好几种。rustc 自己的文档用 rustfilt(cargo install rustfilt),这台机器上没装;LLVM 的 llvm-cxxfilt 和 binutils 2.46 的 c++filt 都能认出两种 Rust 名字:
$ for s in _ZN4geom4area17h76b2d1f845cbc28eE _RNvCs9rhE2iFS63T_4geom4area; do echo "== $s"; echo "$s" | llvm-cxxfilt; echo "$s" | c++filt; done== _ZN4geom4area17h76b2d1f845cbc28eEgeom::area::h76b2d1f845cbc28egeom::area::h76b2d1f845cbc28e== _RNvCs9rhE2iFS63T_4geom4areageom::areageom[6df4528c38c6272b]::arealegacy 名字被当成 C++ 名字解码,哈希成了最后一级路径;GNU 的 c++filt 把 v0 的 crate 消歧值以十六进制写在方括号里,geom[6df4528c38c6272b] 里的值和目标文件名 geom.geom.6df4528c38c6272b-cgu.0.rcgu.o 里的那串一样。RFC 2603 特意说明,v0 不是稳定 ABI 的一部分。
现在回到上一小节的问题:下游用到 biggest::<i64> 和 norm2,代码生成在哪里,会不会像 C++ 模板那样每个使用者一份、靠 COMDAT 去重?编译一个使用 geom 的二进制 crate app,只生成目标文件:
$ rustc --edition 2024 --target x86_64-unknown-linux-musl -C symbol-mangling-version=v0 -O --extern geom=libgeom.rlib app.rs --emit obj -o app.o -C codegen-units=1$ nm app.o | grep -v ' U '0000000000000000 r .Lanon.f2ce8d21ce0ff0a75c5b48f8ce03a450.10000000000000000 V DW.ref.rust_eh_personality0000000000000000 r GCC_except_table50000000000000000 t _RINvNtCs6nLojwqrxvg_4core3ptr13drop_in_placeNtNtCsjVrS1ivfjpm_3std3env4ArgsECs341ZQ2MzMSq_3app0000000000000000 T _RINvNtCsjVrS1ivfjpm_3std2rt10lang_startuECs341ZQ2MzMSq_3app0000000000000000 t _RINvNtNtCsjVrS1ivfjpm_3std3sys9backtrace28___rust_begin_short_backtraceFEuuECs341ZQ2MzMSq_3app0000000000000000 t _RNCINvNtCsjVrS1ivfjpm_3std2rt10lang_startuE0Cs341ZQ2MzMSq_3app0000000000000000 t _RNSNvYNCINvNtCsjVrS1ivfjpm_3std2rt10lang_startuE0INtNtNtCs6nLojwqrxvg_4core3ops8function6FnOnceuE9call_once6vtableCs341ZQ2MzMSq_3app0000000000000000 T _RNvCs341ZQ2MzMSq_3app4main0000000000000000 T main$ readelf -gW app.o | grep 'group section'COMDAT group section [ 20] `.group' [DW.ref.rust_eh_personality] contains 2 sections:biggest 和 norm2 在 -O 下都内联进了 main。没有内联的泛型实例大多数是小写的 t,LOCAL 符号,比如标准库的 drop_in_place::<std::env::Args>,名字末尾带着实例化它的 crate Cs341ZQ2MzMSq_3app。每个 crate 自己生成需要的实例,名字里写着"这是 app 的那份",放在本地,和别的 crate 生成的同一个实例互不冲突,链接器也就没有东西要去重。全文件唯一的 COMDAT 组是 DW.ref.rust_eh_personality,第 8 章见过它的 C++ 版本 DW.ref.__gxx_personality_v0:.eh_frame 通过这个数据槽间接引用 personality 函数,每个目标文件自带一份,由 COMDAT 合并。
本地副本的代价是代码重复。rustc 有一个不稳定选项 -Z share-generics,打开时下游 crate 复用上游已经导出的泛型实例。不写这个选项时,默认值取决于优化级别:opt-level 为 0、1、s、z 时打开,2、3 时关闭(rustc_session/src/config.rs 的 share_generics),不优化的构建更在乎编译速度和产物大小。generics/ 里分别用 0 和 2 编译:
== opt-level=00000000000000000 T _RINvCs9rhE2iFS63T_4geom7biggestxEB2_ (libgeom0.rlib) U _RINvCs9rhE2iFS63T_4geom7biggestxEB2_ (app0.o)== opt-level=2(两边都没有 biggest 的符号)generics/geom.rs 自己用过一次 biggest::<i64>,opt-level=0 时这个实例以全局符号 T 导出,名字末尾的实例化 crate 是 B2_,一个回指。v0 的 base-62 数字有一条加一的规则:_ 表示 0,0_ 表示 1,1_ 表示 2,所以 2_ 表示 3;偏移从 _R 之后开始算,INvCs... 的第 3 个字符正是 crate 根 C,B2_ 指的就是 geom 自己。下游 app 不再生成,直接引用上游这一份(U)。opt-level=2 时它在两边都被内联掉了。同一个实例全程序只生成一次,靠的是编译器在编译下游时读得到上游的元数据,知道上游已经导出了什么,链接器只做普通的符号解析。
自己控制符号:no_mangle、used、link_section
几个属性各管一件事:
#[no_mangle]关闭名字修饰,并使符号从产出的目标文件或库中公开导出;符号名就是源码里的函数名,相当于 C++ 的extern "C"里"不修饰"那一半。2024 版起它必须写成#[unsafe(no_mangle)],因为一个不修饰的名字可能和别处的同名符号冲突,第 3 章说过链接器只认名字,冲突的后果由写代码的人负责。extern "C"只管调用约定,参数和返回值按 C 的规则(这里是 x86-64 psABI)传递。rs_c_mangled是 C 调用约定,名字照样修饰;rs_plain不修饰,调用约定却是 Rust 自己的、不稳定的那一种,C 代码不能安全地调用它。要给 C 用,两个都要写,rs_area是标准写法。#[used]保证静态变量进入目标文件,即使没有源码引用;它不保证变量留在最终程序中。Rust Reference明确允许链接器移除它。编译保留与链接保留是两层决策:在 ELF 中,节成为根、有存活引用,或带有链接器支持的保留标志,都能使它通过节 GC。SHF_GNU_RETAIN是这种链接层标志,和语言属性不是同一份契约。归档提取又是独立一步,成员内部的保留标志并不会代替未定义符号触发成员提取。第 12 章的 Cused与retain也体现了这个分工。#[link_section]指定目标文件中的节名,对后续链接来说这是输入节;最终输出节仍由链接布局决定,TAG进了.note.mytag。LLVM 看到以.note开头的名字,把节类型设成了SHT_NOTE。这个属性也要写成unsafe(...),因为把数据放进错误的节(比如可执行的节)会破坏程序。这段八字节数据只是演示放置效果,并不是符合 ELF note 记录结构的描述符;真正的 note 要有第 2 章介绍的头部、名称、描述内容和对齐。普通注册表应使用合适的自定义数据节,配合第 5 章的边界符号或链接脚本收集,并分别处理编译保留、归档成员拉取和节 GC15。
要和 C 互相调用,或者要让链接器、加载器按名字找到某个符号,就得自己控制符号名和它的去留。attrs/attrs.rs:
#![crate_type = "rlib"]
#[unsafe(no_mangle)]pub extern "C" fn rs_area(w: i64, h: i64) -> i64 { w * h }
#[unsafe(no_mangle)]pub fn rs_plain(x: i64) -> i64 { x + 1 } // 不修饰,但仍是 Rust 调用约定
#[inline(never)]pub extern "C" fn rs_c_mangled(x: i64) -> i64 { x + 2 } // C 调用约定,名字照样修饰
fn helper(x: i64) -> i64 { x * 3 } // 私有函数
#[used]static KEEP_ME: [u8; 4] = *b"keep"; // 没人引用,也要留在目标文件里
static DROP_ME: [u8; 4] = *b"drop"; // 没人引用,编译器直接删掉
#[unsafe(link_section = ".note.mytag")]#[used]static TAG: [u8; 8] = *b"tag-v1\0\0";
#[inline(never)]pub fn uses_helper(x: i64) -> i64 { helper(x) }$ rustc --edition 2024 --target x86_64-unknown-linux-musl -C symbol-mangling-version=v0 -O -C codegen-units=1 attrs.rs --emit obj -o attrs.owarning: static `DROP_ME` is never used$ nm attrs.o0000000000000000 T _RNvCsa6tzDnAu7nc_5attrs11uses_helper0000000000000000 T _RNvCsa6tzDnAu7nc_5attrs12rs_c_mangled0000000000000000 R _RNvCsa6tzDnAu7nc_5attrs3TAG0000000000000000 R _RNvCsa6tzDnAu7nc_5attrs7KEEP_ME0000000000000000 T rs_area0000000000000000 T rs_plain$ readelf -SW attrs.o | grep -E 'rs_|note.mytag|KEEP' [ 4] .text._RNvCsa6tzDnAu7nc_5attrs12rs_c_mangled PROGBITS 0000000000000000 000050 000005 00 AX 0 0 16 [ 5] .text.rs_area PROGBITS 0000000000000000 000060 000008 00 AX 0 0 16 [ 6] .text.rs_plain PROGBITS 0000000000000000 000070 000005 00 AX 0 0 16 [ 7] .note.mytag NOTE 0000000000000000 000075 000008 00 AR 0 0 1 [ 8] .rodata._RNvCsa6tzDnAu7nc_5attrs7KEEP_ME PROGBITS 0000000000000000 00007d 000004 00 AR 0 0 1下面的节表中,KEEP_ME 的标志为 AR:A 表示分配内存,R 表示 GNU 保留标志。这个节被纳入链接后,R 使它通过节 GC。结果由节标志解释,并不意味着所有编译器都必须把 #[used] 编码成相同的 ELF 标志。
helper 是私有函数,内联进了 uses_helper,没有留下符号。KEEP_ME 和 TAG 也是私有的,nm 里却是大写的 R,GLOBAL:rustc 把 #[used] 静态变量导出为全局符号,这样链接时合成的 symbols.o 才引用得到它们。
rustc 怎样调用链接器
编译器驱动与链接器可执行文件接收的参数不是同一套语法。cc 负责组织工具调用,-Wl, 将逗号分隔的参数转交链接器:例如 cc -Wl,-z,now 最终向链接器传递两个参数 -z、now。直接调用 ld 风格的程序时,应传这两个参数本身;仅修改可执行文件路径,而保留驱动语法,会把正确的链接请求变成无法解析的命令。
rustc 的 -C linker=PATH 指定被调用的程序,-C linker-flavor=ld 指定使用 GNU ld 风格的协议。输入对象、归档、搜索目录、入口与输出路径构成这一协议的任务描述;它们仍需进入前面章节讲过的读取、符号解析、布局和重定位阶段。换一个链接器不意味着重新实现 Rust 编译器,也不意味着所有接受的选项都可以忽略。
参数过多时,调用者可以将它们编码在 response file 中,用 @FILE 引用。文件中的引号、空白和反斜线由接收程序的 tokenizer 解释,不是交给 shell 执行;展开只产生参数序列。Linux 文件名可以包含非 UTF-8 字节,参数与路径的处理也需要保留这些字节。这些接口问题与 rlib 的泛型实例化分别发生在链接器入口和编译器内部,不应混为一谈。
rustc 在生成目标文件后调用外部链接器,本例 musl 目标默认通过 C 编译器驱动程序 cc16 组织链接。在这台 Linux 上,默认 cc 就能接收 rustc 自带的 musl 启动文件和库,并生成可运行的 static PIE:
$ rustc --edition 2024 --target x86_64-unknown-linux-musl -C symbol-mangling-version=v0 -O hello.rs -o hello_cc$ file hello_cchello_cc: ELF 64-bit LSB pie executable, x86-64, version 1 (SYSV), static-pie linked, BuildID[sha1]=3f4f083719c9b8c0305bdd81179bde4f3686b5ce, with debug_info, not stripped$ ./hello_cchello from rust-C linker= 换一个驱动程序,-C link-arg= 往命令行里追加一个参数(-C link-args= 一次追加多个,按空格拆分),--print link-args 把 rustc 实际执行的命令打印出来。下面把一个 hello world 的完整命令拆成一行一个参数,sysroot 路径缩写成 $SYSROOT:
$ rustc --edition 2024 --target x86_64-unknown-linux-musl -C symbol-mangling-version=v0 -O -C linker=musl-gcc -C link-arg=-Wl,-Map=hello.map --print link-args hello.rs -o hello"musl-gcc""-m64""$SYSROOT/lib/rustlib/x86_64-unknown-linux-musl/lib/self-contained/rcrt1.o""$SYSROOT/lib/rustlib/x86_64-unknown-linux-musl/lib/self-contained/crti.o""$SYSROOT/lib/rustlib/x86_64-unknown-linux-musl/lib/self-contained/crtbeginS.o""<tmp>/symbols.o""hello.hello.9147ff074b2eabb7-cgu.0.rcgu.o""hello.ad2xtbupsynivepn4m1xa2e1j.rcgu.o""-Wl,--as-needed""-Wl,-Bstatic""$SYSROOT/lib/rustlib/x86_64-unknown-linux-musl/lib/libstd-634518e4795a2324.rlib""$SYSROOT/lib/rustlib/x86_64-unknown-linux-musl/lib/libpanic_unwind-11507e695b2b843d.rlib""$SYSROOT/lib/rustlib/x86_64-unknown-linux-musl/lib/libobject-dca24d1f0faddef7.rlib""$SYSROOT/lib/rustlib/x86_64-unknown-linux-musl/lib/libmemchr-9a53f1578a8f71d5.rlib""$SYSROOT/lib/rustlib/x86_64-unknown-linux-musl/lib/libaddr2line-2c123bd1b498fe61.rlib""$SYSROOT/lib/rustlib/x86_64-unknown-linux-musl/lib/libgimli-0238f1f66963a3ed.rlib""$SYSROOT/lib/rustlib/x86_64-unknown-linux-musl/lib/libcfg_if-5aab300aa628865b.rlib""$SYSROOT/lib/rustlib/x86_64-unknown-linux-musl/lib/librustc_demangle-724073041b57a6c5.rlib""$SYSROOT/lib/rustlib/x86_64-unknown-linux-musl/lib/libstd_detect-075b671e7641a49f.rlib""$SYSROOT/lib/rustlib/x86_64-unknown-linux-musl/lib/libhashbrown-5707c7f16b3346e3.rlib""$SYSROOT/lib/rustlib/x86_64-unknown-linux-musl/lib/librustc_std_workspace_alloc-9e38103f4bd196fd.rlib""$SYSROOT/lib/rustlib/x86_64-unknown-linux-musl/lib/libminiz_oxide-a8a8a653e72107be.rlib""$SYSROOT/lib/rustlib/x86_64-unknown-linux-musl/lib/libadler2-0b03fc5f4ee238a5.rlib""$SYSROOT/lib/rustlib/x86_64-unknown-linux-musl/lib/libunwind-47b4e79fe3947812.rlib""-lunwind""$SYSROOT/lib/rustlib/x86_64-unknown-linux-musl/lib/liblibc-320a9eda352b7dd4.rlib""-lc""$SYSROOT/lib/rustlib/x86_64-unknown-linux-musl/lib/librustc_std_workspace_core-7f77c942e80b7d20.rlib""$SYSROOT/lib/rustlib/x86_64-unknown-linux-musl/lib/liballoc-9ca90d62630d0c82.rlib""$SYSROOT/lib/rustlib/x86_64-unknown-linux-musl/lib/libcore-93f650a07d7b3333.rlib""$SYSROOT/lib/rustlib/x86_64-unknown-linux-musl/lib/libcompiler_builtins-cedbb9d1f1211435.rlib""-L""<tmp>/raw-dylibs""-Wl,-Bdynamic""-Wl,--eh-frame-hdr""-Wl,-z,noexecstack""-nostartfiles""-L""$SYSROOT/lib/rustlib/x86_64-unknown-linux-musl/lib/self-contained""-L""$SYSROOT/lib/rustlib/x86_64-unknown-linux-musl/lib""-o""hello""-Wl,--gc-sections""-static-pie""-Wl,-z,relro,-z,now""-Wl,-O1""-nodefaultlibs""-Wl,-Map=hello.map""$SYSROOT/lib/rustlib/x86_64-unknown-linux-musl/lib/self-contained/crtendS.o""$SYSROOT/lib/rustlib/x86_64-unknown-linux-musl/lib/self-contained/crtn.o"hello: ELF 64-bit LSB pie executable, x86-64, version 1 (SYSV), static-pie linked, with debug_info, not strippedhello from rust从头到尾读一遍,几乎每一项前面都讲过:
rcrt1.o、crti.o、crtbeginS.o开头,crtendS.o、crtn.o结尾,是第 6 章 static-pie 的那套启动文件,rcrt1.o负责在没有ld.so的情况下给自己做重定位。它们来自 Rust 工具链自带的self-contained目录,不是 GCC 的,所以 rustc 同时传了-nostartfiles和-nodefaultlibs,让 GCC 驱动程序别再加自己的启动文件和默认库。musl 目标默认打开这种"自带 C 运行时"的模式,-C link-self-contained=no可以关掉。symbols.o是 rustc 合成的符号引用对象,位于临时目录。它在归档之前引入编译器要求保留解析的名字,帮助抽取运行库成员;它不等价于把每个关联节设为 GC 根。这可与 rustc 1.93.1 的add_linked_symbol_object对照。--print link-args能证明它出现在真实链接命令中;-C save-temps后本实验列出保存的.rcgu.o,不假设当前目录一定存在一个名为symbols.o的文件。
在别的目标上,命令行的形状不一样。x86_64-unknown-linux-gnu 从 1.90 起默认用 LLD17 链接(Announcing Rust 1.90.0),驱动程序仍然是 cc,只是让它调用 rustc 自带的 rust-lld;后面 no_std 一节用的 x86_64-unknown-none 干脆不经过 C 驱动程序,直接调用 rust-lld -flavor gnu。-C linker-flavor 告诉 rustc 链接器是哪一类(gcc、ld18、ld.lld 等),决定参数是写成 -Wl,-z,now 还是 -z now。
rlib 与 native 库的顺序
第 3 章讲过,传统 Unix 链接器从左往右扫描,一个静态库只用来解决它左边留下的未定义符号,所以被依赖的库要放在右边。rustc 知道完整的 crate 依赖图,排序不用人操心。deps/ 里搭了一条链:app 依赖 util,util 依赖 geom,geom 用 #[link] 声明了两个 C 库,一个是自己编译的静态库 libcfoo.a,一个是 libm:
// deps/geom.rs#[link(name = "cfoo", kind = "static")]unsafe extern "C" { fn cfoo_twice(x: i64) -> i64; }#[link(name = "m")]unsafe extern "C" { fn cbrt(x: f64) -> f64; }#[inline(never)]pub fn twice_cube_root(x: f64) -> i64 { unsafe { cfoo_twice(cbrt(x) as i64) } }$ ar t libgeom.rlib; ar t libutil.rliblib.rmetageom.geom.6df4528c38c6272b-cgu.0.rcgu.ocfoo.olib.rmetautil.util.62cc8149a2355e59-cgu.0.rcgu.o7:"app.app.23b34b41e532b418-cgu.0.rcgu.o"8:"app.41x6plzhbt3n17pvcfz0zcwp0.rcgu.o"9:"-Wl,--as-needed"10:"-Wl,-Bstatic"11:"libutil.rlib"12:"./libgeom.rlib"13:"-lm"14:"$SYSROOT/lib/rustlib/x86_64-unknown-linux-musl/lib/libstd-634518e4795a2324.rlib"15:"$SYSROOT/lib/rustlib/x86_64-unknown-linux-musl/lib/libpanic_unwind-11507e695b2b843d.rlib"16:"$SYSROOT/lib/rustlib/x86_64-unknown-linux-musl/lib/libobject-dca24d1f0faddef7.rlib"17:"$SYSROOT/lib/rustlib/x86_64-unknown-linux-musl/lib/libmemchr-9a53f1578a8f71d5.rlib"18:"$SYSROOT/lib/rustlib/x86_64-unknown-linux-musl/lib/libaddr2line-2c123bd1b498fe61.rlib"19:"$SYSROOT/lib/rustlib/x86_64-unknown-linux-musl/lib/libgimli-0238f1f66963a3ed.rlib"20:"$SYSROOT/lib/rustlib/x86_64-unknown-linux-musl/lib/libcfg_if-5aab300aa628865b.rlib"21:"$SYSROOT/lib/rustlib/x86_64-unknown-linux-musl/lib/librustc_demangle-724073041b57a6c5.rlib"22:"$SYSROOT/lib/rustlib/x86_64-unknown-linux-musl/lib/libstd_detect-075b671e7641a49f.rlib"23:"$SYSROOT/lib/rustlib/x86_64-unknown-linux-musl/lib/libhashbrown-5707c7f16b3346e3.rlib"24:"$SYSROOT/lib/rustlib/x86_64-unknown-linux-musl/lib/librustc_std_workspace_alloc-9e38103f4bd196fd.rlib"25:"$SYSROOT/lib/rustlib/x86_64-unknown-linux-musl/lib/libminiz_oxide-a8a8a653e72107be.rlib"26:"$SYSROOT/lib/rustlib/x86_64-unknown-linux-musl/lib/libadler2-0b03fc5f4ee238a5.rlib"27:"$SYSROOT/lib/rustlib/x86_64-unknown-linux-musl/lib/libunwind-47b4e79fe3947812.rlib"28:"-lunwind"29:"$SYSROOT/lib/rustlib/x86_64-unknown-linux-musl/lib/liblibc-320a9eda352b7dd4.rlib"30:"-lc"31:"$SYSROOT/lib/rustlib/x86_64-unknown-linux-musl/lib/librustc_std_workspace_core-7f77c942e80b7d20.rlib"32:"$SYSROOT/lib/rustlib/x86_64-unknown-linux-musl/lib/liballoc-9ca90d62630d0c82.rlib"33:"$SYSROOT/lib/rustlib/x86_64-unknown-linux-musl/lib/libcore-93f650a07d7b3333.rlib"34:"$SYSROOT/lib/rustlib/x86_64-unknown-linux-musl/lib/libcompiler_builtins-cedbb9d1f1211435.rlib"37:"-Wl,-Bdynamic"7rlib 的排列是依赖图的一个拓扑序:util 在 geom 前面,geom 在 std 前面,std 内部各个 crate 也按同样的规则排,core 和 compiler_builtins 垫底,每个库都排在所有用到它的库右边。kind = "static" 的 libcfoo.a 没有出现在命令行上,它的成员 cfoo.o 在编译 geom 时就被打包(bundle)进了 libgeom.rlib。rlib 不包含上游 crate,但 crate 自己声明的 native 静态库默认要打包,下游拿到一个 rlib 就够了。没写 kind 的 libm 是普通的 -lm,插在 geom 之后、std 之前,紧跟声明它的 crate,这正好满足从左往右扫描的要求。
每个 crate 在依赖图里只出现一次。Reference 的说法是"A major goal of the compiler is to ensure that a library never appears more than once in any artifact":两个共享库各自静态链接了同一个 rlib,就不能再被同一个 crate 一起使用,否则程序里会有两份。
panic=unwind 与 panic=abort
本例 Linux musl 目标的默认 panic 策略是展开栈,一层层执行局部变量的析构(Drop),直到被 catch_unwind 接住或者线程结束。它走的就是第 8 章那套机制:.eh_frame 描述怎样退栈,LSDA(.gcc_except_table)记录每个调用点的清理代码在哪里,personality 函数换成了 rust_eh_personality。-C panic=abort 让 panic 直接终止进程,不展开。
panic/work.rs 里有一个函数构造了一个 Vec<String>,循环里每一次 format! 都可能 panic,panic 时已经构造好的字符串和向量都要析构。分别用两种策略编译成目标文件,把代码节、.eh_frame、.gcc_except_table 的大小各自加起来:
== work_unwind.otext 1805, .eh_frame 576, .gcc_except_table 60(drop_in_place 符号 2 个)== work_abort.otext 1387, .eh_frame 360, .gcc_except_table 0(drop_in_place 符号 0 个)panic=abort 下,LSDA 一个字节都没有了,代码少了 418 字节:展开时才会执行的清理块(landing pad)和它们调用的析构函数 drop_in_place::<Vec<String>>、drop_in_place::<Args> 都消失了。.eh_frame 还剩 360 字节,因为本例目标默认保留供回溯使用的展开表,给调试器和 backtrace 用,只是 FDE19 里不再有 LSDA 指针。
链接成完整程序再比,差别就小得多:
$ size hello_unwind_s hello_abort_s text data bss dec hex filename 403371 36800 6256 446427 6cfdb hello_unwind_s 400267 36408 6256 442931 6c233 hello_abort_s$ for f in hello_unwind_s hello_abort_s; do readelf -SW $f | grep -E 'eh_frame|gcc_except'; done [11] .eh_frame_hdr PROGBITS 0000000000061178 061178 001264 00 A 0 0 4 [12] .gcc_except_table PROGBITS 00000000000623dc 0623dc 0010b4 00 A 0 0 4 [13] .eh_frame PROGBITS 0000000000064b10 063b10 005eb4 00 WA 0 0 8 [11] .eh_frame_hdr PROGBITS 000000000005fe58 05fe58 00122c 00 A 0 0 4 [12] .gcc_except_table PROGBITS 0000000000061084 061084 00104c 00 A 0 0 4 [13] .eh_frame PROGBITS 0000000000063c98 062c98 005d2c 00 WA 0 0 8两份 strip 后程序的 size 汇总值相差 3496 字节(不到 1%;这不是文件磁盘长度的比较),.gcc_except_table 在 abort 版里还有 4172 字节。原因在命令行上:两次链接的 libstd 是同一个预编译的 rlib,它是按 panic=unwind 编译的,里面的 LSDA 和 landing pad 一个不少,这里单独调用 rustc 时,-C panic=abort 改变当前编译的 crate 的代码,不能重写已经编译好的依赖,再把 libpanic_unwind 换成 libpanic_abort(--print link-args 里能看到这一项的变化)。要让标准库也按 abort 编译,得用 nightly 的 -Z build-std 从源码重建。
两种策略不能随便混。Reference 规定,一个可能发生展开的产物里,所有 crate 都必须按 unwind 编译,"Otherwise, unwinding can cause undefined behavior";用 rustc 链接时这条规则会被自动检查,用别的方式(比如 dlopen)组合时,要自己保证。
no_std:最小的 Rust 程序
最小例子不使用 std,也不引入其他第三方依赖;它仍会用到 core 和提供基础运算支持的 compiler_builtins。#![no_std] 表示不链接 std,只用 core;#![no_main] 表示不要 rustc 生成的 main,入口自己写。core 不知道操作系统的存在,panic 时该做什么也得自己提供,#[panic_handler] 标记的函数就是 panic 的终点。nostd/tiny.rs 用内联汇编直接发 write 和 exit 两个系统调用:
#![no_std]#![no_main]
use core::arch::asm;use core::panic::PanicInfo;
fn write(fd: usize, buf: &[u8]) -> isize { let ret: isize; unsafe { asm!("syscall", inlateout("rax") 1isize => ret, in("rdi") fd, in("rsi") buf.as_ptr(), in("rdx") buf.len(), lateout("rcx") _, lateout("r11") _, options(nostack)); } ret}
fn exit(code: i32) -> ! { unsafe { asm!("syscall", in("rax") 60, in("rdi") code, options(noreturn, nostack)) }}
#[panic_handler]fn panic(_info: &PanicInfo) -> ! { exit(101) }
// Linux enters _start by a jump; establish a call frame before Rust code.#[unsafe(naked)]#[unsafe(no_mangle)]pub extern "C" fn _start() -> ! { core::arch::naked_asm!( "and rsp, -16", "call {entry}", "ud2", entry = sym rust_entry, );}
#[unsafe(no_mangle)]extern "C" fn rust_entry() -> ! { write(1, b"hello from no_std\n"); exit(42)}_start 必须不修饰,第 5 章讲过链接器默认的入口就是这个名字。ELF 加载器跳转到入口时没有像 call 那样自动压入返回地址,因此入口不能假定自己已经满足普通 Rust 函数的栈帧约定。这里用 naked 汇编对齐栈并 call rust_entry;rust_entry 才是按 extern "C" 调用约定生成的 Rust 函数,末尾不会返回。这里使用原生 x86-64 Linux 的系统 Rust 目标,直接调用 GNU ld 风格的链接器,显式选择固定地址的静态程序。no_std、自定义入口和无 C 启动文件是不同的决策:不链接 std 并不会自动提供操作系统入口,也不会自动完成 libc 初始化或 PIE 自重定位。
rustc --edition 2024 -C panic=abort -C opt-level=2 \ -C linker-flavor=ld -C link-arg=-static -C relocation-model=static \ tiny.rs -o tiny-staticreadelf -h tiny-staticreadelf -rW tiny-static./tiny-static本例 ELF 类型为 ET_EXEC,入口为 0x401000,没有遗留重定位;输出 hello from no_std 并以 42 退出。固定布局下,链接器已经填好了本例所需的地址,入口汇编只需建立函数调用约定。地址数值属于该产物,正确性依据是声明的装载模型与引用都被满足。
PIE 的地址修正仍需要执行者
位置相对指令可以直接使用运行时的 RIP,但静态指针表保存的是地址值。tiny_tbl.rs 通过 read_volatile 从静态表读取 write 的地址,避免编译器把表读取消去。将它输出为没有解释器的 PIE:
rustc --edition 2024 -C panic=abort -C opt-level=2 -C linker-flavor=ld \ -C link-arg=-static -C link-arg=-pie -C link-arg=--no-dynamic-linker \ tiny_tbl.rs -o tiny-table-piereadelf -rW tiny-table-pie本例留下 R_X86_64_RELATIVE:字段 RVA 为 0x3ed0,加数为 0x1010。文件中的指针槽已含 0x1010,但运行时所需值是 B + 0x1010,其中 B 是加载基址。Linux 内核映射 ELF 段,不会替这个无解释器程序应用动态重定位;入口也没有自重定位代码。因此它把未修正的值当函数地址调用,本次以信号退出,shell 报告状态 139。槽中是零还是加数取决于产物编码,关键问题都是加载偏移没有加入地址值。
这两份输入区分了两个验收层次:能运行 syscall-only 程序说明入口和这组引用成立;带函数指针的数据则进一步要求加载器或启动代码处理地址修正。可靠的 static PIE 必须提供该执行者,不能以一次无动态重定位的运行代替验证。链接器也不能擅自把请求的 PIE 改成 ET_EXEC。panic=abort 只改变 panic 策略,同样不承担这些启动职责。
语言支持最终要落实到哪些链接能力
tiny.rs 提供了一个很小的 Rust 输入集:普通目标文件、编译器合成的 symbols.o,以及 core、compiler_builtins 两个 rlib。尝试让自己的链接器接收它时,先用 --print link-args 保存当前目标的真实命令,再检查三类约定。
首先是归档语义。rlib 中没有定义的元数据成员不会因符号解析被抽取;如果使用 --whole-archive,还要正确处理 SHF_EXCLUDE。compiler_builtins 将底层运算辅助函数分散在多个归档成员中,链接器按尚未满足的符号需求抽取成员;成员总数取决于工具链和目标配置,不是归档语义的判据。symbols.o 提供的未定义符号参与抽取,但不能因此把每个抽取进来的节都当作 GC 根。
其次是命令行语义。--as-needed、-Bstatic、-Bdynamic、--eh-frame-hdr、-z noexecstack、-z relro、-z now、-O1、-pie、--gc-sections 各自影响库选择、文件结构或运行时约定。最小实现可以明确拒绝尚未支持的选项,再用受控命令验证已有能力;某个选项在当前输入上没有实际作用,也应说明条件,不能把“接受后忽略”当作已经兼容。使用 -C linker=tinylink -C linker-flavor=ld 之前,还须确认 rustc 为该 flavor 生成的参数确实被实现。
最后是装载与执行的契约。tiny-static 输出文字并以 42 退出,只证明没有遗留动态重定位的这份输入可运行。tiny_tbl.rs 则要求启动代码或加载器处理 R_X86_64_RELATIVE。通用链接器不能仅凭不存在某个熟悉的启动文件名就断定程序缺少自重定位代码,也不能擅自把用户要求的 PIE 改成 ET_EXEC。针对已知的最小启动例子,可以检查并拒绝遗留动态重定位;要改用固定地址,则显式选择静态重定位模型、非 PIE 链接和适合该装载环境的地址布局,再验证产物。
支持带 std 的程序还要接上更完整的运行时:musl 的 rcrt1.o 参与 static PIE 的启动,.init_array 调度初始化,COMDAT、.eh_frame 与 .eh_frame_hdr 支持相关代码和展开记录,thread_local!、errno 又牵涉 PT_TLS 与 TLS20 重定位。它们分别沿用了前面各章的机制;一个可运行的 println! 只是其中一项观察,还需要独立验证 panic 展开、线程局部状态和初始化。这里给出的是实现与验证的依赖关系,并非已有完整 Rust 支持的宣告。
这些语言需求也存在于其他文件格式中。上述主要实验使用 ELF,所以看到的是 STB_WEAK、STB_GNU_UNIQUE、节组和 .init_array;名字修饰对照里,Linux 上生成并解析的 Mach-O 已经展示了另一种承载方式。Itanium C++ ABI 可以被不同平台采用并加以调整,并不等同于 ELF。Mach-O 没有 ELF 节组,却仍要合并 inline 函数;PE/COFF 的 COMDAT 则提供不同的选择规则。同一个语言实体换一套文件格式后如何保持身份,正好可以用来检验哪些规则来自语言、哪些来自 ABI、哪些属于格式本身。
练习
本章练习沿用正文中的输入与命令;虚表观察需要先生成 shape.o,Rust 练习直接使用本节给出的源码和原生工具链。
练习一,观察。
(1) 正文用 Greeter 讲过虚表的布局。换成 key function 一节的 shape.o,读 readelf -SW、readelf -rW、readelf -gW 和 nm,回答:_ZTV5Shape 有多大,从虚表指针指向的位置数起,0 到 3 号槽各是什么?Shape 有三个析构函数符号 D0、D1、D2,为什么虚表里只有 D1 和 D0,没有 D2?D1 和 D2 是同一段代码吗?
(2) 当前原生 Rust 工具链预编译的 libstd-*.rlib、libcore-*.rlib 和 libcompiler_builtins-*.rlib 各有几个成员?后者的成员为什么比前两者多两个数量级?找到定义 __udivti3 的成员并检查其绑定;再查找 __popcountdi2,若不存在,说明为什么不能仅凭某个辅助函数缺失就判定归档损坏。成员粒度如何影响链接时的抽取?
练习二,手算或预测。
(1) 不看工具,手工解码 _ZN5shape6circle6resizeERKS0_d。先列出替换字典(S_、S0_ 各是什么),再写出结果。
(2) 写出 void geo::scale(geo::Point *, const geo::Point *, double) 的修饰名(geo::Point 是一个类)。同样先列出你的替换字典,再交给编译器核对。
(3) RFC 2603 里的示例符号是 _RNvNtCs1234_7mycrate3foo3bar。和正文的 _RNvCs9rhE2iFS63T_4geom4area 比,多出来的 Nt 是什么意思?写出它的路径。
练习三,改坏。
(1) 在正文的 shape.h 里,area() 前面加一行 virtual void draw() const;,不定义它,程序里也没有任何地方调用它。shape.cpp 照旧定义 area(),两个文件一起链接。先预测:能链接吗?如果报错,报的是哪个符号,为什么一个没人调用的函数会影响链接?然后修好它。
(2) 把 tiny.rs 里 _start 上面的 #[unsafe(no_mangle)] 删掉,用正文生成 tiny-static 的命令编译。先预测:编译和链接各会怎样,程序运行时会怎样?
名字解码器的输入格式见本节说明。
参考
- Itanium C++ ABI:第 5.1 节 External Names (a.k.a. Mangling)、第 5.2 节 Vague Linkage、第 2.8 节与第 3.3.3 节 One-time Construction API
- Ian Lance Taylor:Linkers part 14(2007-09-17,初始化代码)、Linkers part 15(2007-09-18,COMDAT)、Linkers part 16(2007-09-19,模板实例化与异常帧)
- gABI: Section Groups
- GCC: C++ Attributes(init_priority)、GCC: Code Gen Options(-fno-gnu-unique)、GCC: Installing GCC: Configuration(--enable-gnu-unique-object)
- ld 手册:Options(--sort-section)
- LLVM 21.1.8 源码:lld/ELF/OutputSections.cpp(
sortInitFini、getPriority) - cppreference:Initialization、Storage class specifiers
- Rust Reference: Linkage
- rustc 1.93.1 源码:rustc_codegen_ssa/src/back/link.rs(
add_linked_symbol_object)、rustc_session/src/config.rs(share_generics) - RFC 2603: Rust Symbol Mangling (v0)(2018-11-27)、rustc book: v0 Symbol Format、rustc book: Symbol Mangling
- Rust 博客:Switching to Rust's own mangling scheme on nightly(2025-11-20)、Announcing Rust 1.90.0
- rustc book: Codegen Options(
-C linker、-C link-arg、-C link-self-contained、-C panic、-C symbol-mangling-version)
答案
每题的答案都折叠着,先自己做再展开。
练习一答案
(1) 前文命令序列的输出:
[16] .rodata._ZTV5Shape PROGBITS 0000000000000000 0000f8 000030 00 AG 0 0 8 [17] .rela.rodata._ZTV5Shape RELA 0000000000000000 0004e8 000078 18 IG 26 16 8Relocation section '.rela.rodata._ZTV5Shape' at offset 0x4e8 contains 5 entries: Offset Info Type Symbol's Value Symbol's Name + Addend0000000000000008 0000000f00000001 R_X86_64_64 0000000000000000 _ZTI5Shape + 00000000000000010 0000000e00000001 R_X86_64_64 0000000000000000 _ZNK5Shape4areaEv + 00000000000000018 0000000800000001 R_X86_64_64 0000000000000000 _ZNK5Shape4nameEv + 00000000000000020 0000000b00000001 R_X86_64_64 0000000000000000 _ZN5ShapeD1Ev + 00000000000000028 0000000c00000001 R_X86_64_64 0000000000000000 _ZN5ShapeD0Ev + 0
0000000000000000 W _ZN5ShapeD0Ev0000000000000000 W _ZN5ShapeD1Ev0000000000000000 W _ZN5ShapeD2Ev0000000000000000 n _ZN5ShapeD5EvCOMDAT group section [ 2] `.group' [_ZN5ShapeD5Ev] contains 4 sections: [Index] Name [ 12] .text._ZN5ShapeD2Ev [ 13] .rela.text._ZN5ShapeD2Ev [ 14] .text._ZN5ShapeD0Ev [ 15] .rela.text._ZN5ShapeD0Ev虚表 48 字节,6 项:offset-to-top(0,没有重定位)、typeinfo,然后是虚表指针指向的 0 号槽 area、1 号槽 name、2 号槽 D1、3 号槽 D0,顺序是类定义里的声明顺序,一个虚析构函数占两个槽。虚函数调用只会以完整对象的身份析构(p->~Shape() 用 D1,delete p 用 D0,D0 析构完再调用 operator delete),D2 只在派生类的析构函数析构它的基类部分时直接调用,那时类型已知,不经过虚表。D1 和 D2 对没有虚基类的 Shape 完全相同,组里只有 .text._ZN5ShapeD2Ev 一个代码节,D1 是定义在同一位置的别名;D0 有自己的代码节,三者共用签名为 _ZN5ShapeD5Ev 的一个组。
(2) 成员数量来自工具链的构建方式,并不是 Rust 或 ELF 规定的常量。原生 GNU 目标的一组结果为:
libstd: 17 个成员,其中 .rcgu.o 16 个libcore: 17 个成员,其中 .rcgu.o 16 个libcompiler_builtins: 265 个成员,其中 .rcgu.o 264 个__udivti3: Wlib.rmeta 承载编译器元数据,.rcgu.o 承载 codegen unit 生成的目标代码。归档抽取以成员为单位;细分成员可以减少为一个辅助函数引入的无关代码,节 GC 则在成员抽取后进一步删除不可达节。这是两个不同阶段。
compiler_builtins 提供编译器可能生成调用的低层辅助函数,例如 128 位无符号除法 __udivti3。这里的 W 表示弱定义:存在兼容的强定义时,符号解析选择强定义。当前归档没有 __popcountdi2 定义;目标指令、编译器 lowering 和运行库配置决定某种运算是否需要独立辅助函数。诊断缺失应从实际未满足的引用出发,不能要求所有工具链提供相同的成员名单。
练习二答案
(1) 读法:_Z 后面是 N...E 嵌套名字,5shape 进字典成为 S_,6circle 和前缀合成 shape::circle,成为 S0_,6resize 是函数名,不进字典,遇到 E 结束名字。参数部分:R K S0_,S0_ 是 shape::circle,外面包一层 const 成为 S1_,再包一层引用成为 S2_;d 是 double。结果:
shape::circle::resize(shape::circle const&, double)和 c++filt 的输出一致。注意 resize 可以是类 circle 的成员函数,也可以是命名空间 shape::circle 里的普通函数,修饰名里看不出区别(非 const 成员函数没有 K,this 参数也不写出来)。handcalc.cpp 里它是成员函数。
(2) 字典:S_ = geo,S0_ = geo::Point,S1_ = geo::Point*;第二个参数里 geo::Point 已经是 S0_,K S0_ = geo::Point const 成为 S2_,P 再包一层成为 S3_;double 是 d。修饰名是 _ZN3geo5scaleEPNS_5PointEPKS0_d,编译器的输出:
0000000000000000 T _ZN3geo5scaleEPNS_5PointEPKS0_d(3) N 后面那个字母是命名空间:v 是值命名空间(函数、静态变量),t 是类型命名空间,模块也算在里面。_RNvNtCs1234_7mycrate3foo3bar 读作:值 bar,属于类型命名空间里的 foo,foo 属于 crate mycrate(消歧值的 base-62 编码是 1234)。路径是 mycrate::foo::bar,foo 是一个模块。llvm-cxxfilt 输出 mycrate::foo::bar,GNU c++filt 输出 mycrate[3c1c0]::foo::bar,方括号里是十六进制的消歧值。0x3c1c0 是 246208,比 base-62 的 1234(1×62³+2×62²+3×62+4 = 246206)多 2,两次加一:v0 的 base-62 数字规定 _ 表示 0,非空数字串表示它的值加一;crate 消歧值 s<base-62-number> 又在这个数上再加一,留出"没有消歧值"的 0。
练习三答案
(1) 链接失败:
0000000000000000 T Shape::area() const 2 undefined reference to `vtable for Shape'key function 是"类定义里第一个既不是纯虚、也不是 inline 的虚函数",加了 draw() 之后,key function 从 area() 变成了 draw()。shape.cpp 定义了 area(),但没有定义 draw(),于是没有任何一个翻译单元负责生成虚表,shape.o 里也不再有 vtable for Shape。draw() 有没有人调用无关紧要:只要创建了 Shape 对象,构造函数就要引用虚表,虚表里有 draw 的槽位,它属于整个类。报错里依然只有 vtable for Shape,看不到 draw。
修法是在 shape.cpp 里定义 draw()(-DFIX),虚表又回到了 shape.o:
0000000000000012 T Shape::draw() const0000000000000000 V vtable for Shape U vtable for __cxxabiv1::__class_type_infoshape 0另一种修法是写成纯虚函数 = 0,纯虚函数不参与 key function 的选择;可那样 Shape 就成了抽象类,use_shape.cpp 里的 Shape s; 编译不过(cannot declare variable 's' to be of abstract type 'Shape'),要改成派生类。
(2) 只删除 _start 上的 #[unsafe(no_mangle)],保留 rust_entry 上的属性。源代码中的函数名不再提供链接器约定的 _start 符号;没有入口根,相关代码也可能被 section GC 删除。编译器接受源码并不意味着文件具有有效入口。
对照原生固定地址命令,产物中的关键结果为:
U _start Entry point address: 0x0exit=139U 表示未定义符号;e_entry = 0 没有指向本例的可执行代码,运行时因 SIGSEGV 终止。GNU ld 如何报告缺失入口,以及是否选择默认地址,取决于链接选项和可用节,不能把本例的零地址当成所有入口错误的固定结果。检查应同时回答三个问题:要求的入口符号是否定义,e_entry 是否指向可执行映射,入口是否履行启动约定。脚本禁用 core 文件并为执行设置超时。
附录:术语与工具
-
ODR — ODR(One Definition Rule)是 C++ 对定义一致性的要求。链接器选择了一个同名实例,并不能证明不同翻译单元中的定义满足语言规则。 官方文档。 ↩
-
COMDAT — COMDAT 让工具链表示可供择一保留的重复定义组。ELF 通过 section group 与签名表达相关关系;选择副本时,组内关联内容需要一致处理。 官方文档。 ↩
-
nm —
nm列出目标文件的符号。字母标记概括符号所在节或绑定等属性;需要判断准确语义时,应继续对照 ELF 符号表字段。 官方文档。 ↩ -
Clang — Clang 是 LLVM 项目中的 C、C++ 等语言前端及驱动程序。它通常使用集成汇编器,但仍需调用链接器;最终使用哪个链接器取决于目标平台和配置。 官方文档。 ↩
-
readelf —
readelf检查 ELF 头、节、段、符号及重定位等结构;它读取文件而不执行其中的程序。GNUreadelf与 LLVMllvm-readelf的显示格式可能不同。 官方文档。 ↩ -
ELF — ELF(Executable and Linkable Format)规定目标文件、可执行文件与共享对象的结构。通用规则见 gABI,架构相关的调用约定和重定位规则见对应 psABI。 官方文档。 ↩
-
ABI — ABI(Application Binary Interface)规定二进制组件如何协作,包括调用约定、数据布局和文件格式等。它约束编译结果之间的交接,比源码层面的 API 更靠近机器。 官方文档。 ↩
-
LSDA — LSDA(Language-Specific Data Area)保存语言异常处理所需的额外信息,例如异常区域和处理动作。展开器与语言 personality 函数分工使用这些数据。 官方文档。 ↩
-
LLVM — LLVM 是一组编译器与工具链项目的名称,包括优化基础设施、目标代码生成和相关工具。Clang、LLD 与 LLVM IR 各有职责,不能互作同义词。 官方文档。 ↩
-
COFF — COFF(Common Object File Format)是一族目标文件格式的名称。Windows 的 COFF 对象与 PE 映像有各自的头和表,不能直接套用 ELF 的节与段规则。 官方文档。 ↩
-
psABI — psABI(processor-specific ABI)是特定处理器架构的二进制接口约定。不同架构可以共用 ELF 文件结构,同时拥有不同的指令、调用约定和重定位公式。 官方文档。 ↩
-
gABI — gABI 是通用 System V ABI,规定 ELF 等跨架构规则;psABI 是处理器相关补充,进一步规定寄存器约定、重定位编号与 TLS 等细节。 官方文档。 ↩
-
RELRO — RELRO(RELocation Read-Only)将需要重定位、但之后不应继续写入的区域转为只读。ELF 的
PT_GNU_RELRO描述该范围,实际保护由启动路径实施。 官方文档。 ↩ -
PE — PE(Portable Executable)是 Windows 使用的映像格式,与 COFF 目标文件格式相关。它与 ELF 在导入导出、加载及重定位组织上各有约定。 官方文档。 ↩
-
GC — 本文 GC 指 section garbage collection,即链接器从入口和其他根出发保留可达节、删除无用节。它发生在构建阶段,与运行时堆内存的垃圾回收不同。 官方文档。 ↩
-
cc —
cc是系统约定的 C 编译命令入口,具体实现可能是 GCC 或 Clang。检查cc --version可以确认当前环境;复现实验时,显式指定实现更容易对齐行为。 官方文档。 ↩ -
LLD — LLD 是 LLVM 项目的链接器。ELF 平台通常通过
ld.lld调用;lld-link则提供兼容 Windows 工具链的接口。它与负责处理源码的 Clang 是不同组件。 官方文档。 ↩ -
ld —
ld是常见的链接器命令名;本系列写 GNU ld 时特指 GNU binutils 的链接器。它读取目标文件、库与链接选项,完成符号解析、布局和重定位。 官方文档。 ↩ -
FDE — FDE(Frame Description Entry)关联一段代码的地址范围与栈展开指令。移动代码或重新组织
.eh_frame时,链接器必须同步更新相关地址和记录间的引用。 官方文档。 ↩ -
TLS — TLS(Thread-Local Storage)让不同线程拥有同一变量的独立实例。链接器描述初始化模板并处理寻址模型,运行时负责为线程建立实例。这里不是网络协议 Transport Layer Security。 官方文档。 ↩