

[链接器的世界-原理篇09] TLS:同一个变量,每个线程各有一份
本章要回答的是:同一个变量名,怎样在两个线程中得到两块不同的存储?理解主线只需掌握原理篇 02的节、符号和重定位,以及原理篇 06的文件映像与零填充。这里的线程指针是定位当前线程数据的基准,不是普通全局变量的地址;线程块是模板的一份实例,不是文件中的另一个节。
先沿着“文件里的 TLS 模板 → 每个线程的副本 → 一条访问指令”读到静态布局和 LE/IE 模型。动态加载会使模块数量和位置变化,DTV、GD/LD 与 TLSDESC 随后解释这种变化怎样影响定位;初读不需要先背四套指令序列。每次遇到偏移,先确认它相对于模板、模块还是线程指针。
一个进程可以有多个线程:它们在同一片进程地址空间里执行,各自保留当前执行位置、寄存器和调用栈。普通全局变量因而会被这些线程共同访问。但有些状态必须各存各的。上一章的异常处理就是一例:线程 A 正在处理的异常,不能被线程 B 当成自己的异常重抛。
把变量放进函数的局部栈帧,只能让它跟随那次函数调用;异常运行时却需要在同一线程的许多函数之间找到同一份状态。线程局部存储(Thread-Local Storage,TLS1)提供了这样的对象:源码里只有一个变量名,每个线程访问的却是自己的实例,实例随线程存续。C11 用 _Thread_local 声明它,C++11 用 thread_local,GCC2 更早提供的扩展写法是 __thread。
先观察这个区别。下面的 counter 初值是 42。主线程把它加到 43 后创建工作线程,工作线程把自己那份加 10,最后主线程再次读取。代码通过 POSIX 线程接口操作线程:pthread_create 启动一个执行 worker 的线程,pthread_join 等待它结束。等待完成后才打印最后一行,因此这里的输出次序是确定的。
#include <pthread.h>#include <stdio.h>
static _Thread_local int counter = 42;
static void *worker(void *unused) { (void)unused; printf("worker starts: %d\n", counter); counter += 10; printf("worker changes: %d\n", counter); return NULL;}
int main(void) { pthread_t thread; ++counter; printf("main before: %d\n", counter); if (pthread_create(&thread, NULL, worker, NULL) != 0) return 1; if (pthread_join(thread, NULL) != 0) return 1; printf("main after: %d\n", counter); return 0;}在 Linux 中,把源码保存为 thread_identity.c 后运行。-std=c11 选择 C11 语言规则,-pthread 要求工具链启用构建 POSIX 线程程序所需的选项和库支持。
$ cc -std=c11 -O1 -pthread thread_identity.c -o thread_identity$ ./thread_identitymain before: 43worker starts: 42worker changes: 52main after: 43新线程从 42 开始,并没有继承创建它时主线程里的 43;它写入 52,也没有改变主线程的值。同一处变量访问因此不能只对应一个进程内固定地址。运行时既要从某处取得每份实例的初值,也要让访问代码找到当前线程的实例。
下面用 ELF3 的初始化模板与 x86-64 的访问指令展开这条地址计算路径。AArch64 的对照用于说明另一种线程指针布局;两种布局都要把模块内位置转换为当前线程中的实际地址。
先看没有编译器帮忙的做法
在编译器支持这种关键字之前,POSIX 线程接口(pthreads)就提供了线程私有数据:先用 pthread_key_create 申请一个"键",然后每个线程用 pthread_setspecific(key, p) 存一个 void *,用 pthread_getspecific(key) 取回自己存的那个。
这套接口让库在运行时申请线程私有数据,不要求提前声明语言层面的 TLS 变量;代价是键和对象的生命周期需要显式管理。Ulrich Drepper 在后来成为事实标准的文档《ELF Handling For Thread-Local Storage》开头列了它的毛病:键要在运行时动态申请,不用了还要释放,既费事又容易出错;和动态加载的代码搭在一起时,问题就更大了(Drepper, tls.pdf, §1)。这里的动态加载指第 7 章讲过的 dlopen,即程序运行到中途再按需装入一个共享库。设想一个被 dlopen 进来的插件想要一个线程局部变量:谁来申请键,什么时候申请,插件卸载时谁来释放,已经在跑的线程怎么拿到它的那一份?每次访问还都是一次函数调用加一次查表。
语言层面的 TLS 让编译器知道哪些变量需要每个线程一份,链接器记录它们的存储需求,运行时负责建立实例。程序不再为每个变量显式申请键,但这些工作并没有消失。
沿着刚才的运行结果,可以逐步追踪这些工作:每个线程那一份的初始内容从哪里来;运行时怎么找到"当前线程的那一份";机器码里该填什么,才能在每个线程里都算出正确的地址。
模板:.tdata、.tbss 与 PT_TLS
先写一个小文件 tls.c,后面的访问模型都用它:
_Thread_local int counter = 42; /* 有初值 -> .tdata */_Thread_local int scratch[256]; /* 无初值 -> .tbss */extern _Thread_local int ext_var; /* 别的模块定义的 TLS */
int bump(void) { return ++counter; }int *scratch_at(int i) { return &scratch[i]; }int read_ext(void) { return ext_var; }另有一个只有一行的 ext.c:_Thread_local int ext_var = 7;。先编译 tls.c,看节头和符号表:
$ clang -O1 -fPIC -c tls.c -o pic.o$ readelf -SW pic.o | grep -E 'Nr|tdata|tbss' [Nr] Name Type Address Off Size ES Flg Lk Inf Al [ 4] .tdata PROGBITS 0000000000000000 000098 000004 00 WAT 0 0 4 [ 5] .tbss NOBITS 0000000000000000 0000a0 000400 00 WAT 0 0 16$ readelf -sW pic.o | grep TLS 4: 0000000000000000 4 TLS GLOBAL DEFAULT 4 counter 7: 0000000000000000 1024 TLS GLOBAL DEFAULT 5 scratch 9: 0000000000000000 0 TLS GLOBAL DEFAULT UND ext_var两个新的节。.tdata 对应 .data:放有初值的线程局部变量,这里是 4 字节的 counter,文件里存着它的初值 42。.tbss 对应 .bss:放初值为零的线程局部变量,这里是 1024 字节的 scratch,类型是 NOBITS,在文件里不占空间,只记一个大小。
区别在标志列:除了 W(SHF_WRITE)和 A(SHF_ALLOC,运行时要装入内存),还多了一个 T,即 SHF_TLS(0x400)。符号的类型也不是普通变量的 OBJECT,而是 TLS(STT_TLS)。连只声明为 extern、还没有定义的 ext_var 也是 STT_TLS,链接器据此知道对它的引用要按 TLS 的规则处理。
还有一个细节:counter 和 scratch 的值都是 0。普通符号的值是"在所在节里的偏移",链接后变成虚拟地址;TLS 符号的值最终表示"在本模块 TLS 块里的偏移",拿它没法直接访问内存。原因后面就会清楚。
这里的“模块”指最终加载的一个可执行文件或共享库,不是每个输入 .o 文件。tls.o 和 ext.o 链接进同一个可执行文件后,它们的 TLS 数据属于同一个模块、共用一份模板;如果把 ext.o 链接成单独的共享库,这个库就有自己的 TLS 模板。
链接时,链接器把输入文件的已初始化 TLS 节合并、零初始化 TLS 节合并,并让它们紧挨着:.tdata 在前,.tbss 在后。判定依据是 SHF_TLS 和节类型,节名不必恰好等于 .tdata 或 .tbss。然后为这一段生成一个专门的程序头 PT_TLS。第 5 章讲过,PT_LOAD 告诉加载器"把文件这一段映射到内存这个位置";PT_TLS 的含义不同,它描述的是一份模板:p_offset/p_vaddr 指向初始化映像(也就是 .tdata 的内容),p_filesz 是映像长度,p_memsz 是每个线程那一份的总大小,p_align 是这一份要求的对齐。
把 tls.c 和 ext.c 一起链接成 PIE4:
$ ld.lld -pie start.o pic.o ext.o -o gd2le$ readelf -lW gd2le | grep -E 'Type|LOAD|TLS|DYNAMIC|RELRO' Type Offset VirtAddr PhysAddr FileSiz MemSiz Flg Align LOAD 0x000000 0x0000000000000000 0x0000000000000000 0x0002b4 0x0002b4 R 0x1000 LOAD 0x0002c0 0x00000000000012c0 0x00000000000012c0 0x000068 0x000068 R E 0x1000 LOAD 0x000330 0x0000000000002330 0x0000000000002330 0x000098 0x000cd0 RW 0x1000 TLS 0x000330 0x0000000000002330 0x0000000000002330 0x000008 0x000410 R 0x10 DYNAMIC 0x000338 0x0000000000002338 0x0000000000002338 0x000090 0x000090 RW 0x8 GNU_RELRO 0x000330 0x0000000000002330 0x0000000000002330 0x000098 0x000cd0 R 0x1$ readelf -sW gd2le | grep TLS 6: 0000000000000000 4 TLS GLOBAL DEFAULT 7 counter 9: 0000000000000010 1024 TLS GLOBAL DEFAULT 8 scratch 11: 0000000000000004 4 TLS GLOBAL DEFAULT 7 ext_varFileSiz 是 8:两个输入的 .tdata 合并后,counter 在偏移 0,ext_var 在偏移 4。MemSiz 0x410 由三部分组成:8 字节的 .tdata,补到 .tbss 要求的 16 字节对齐所留的 8 字节空隙,再加 0x400 字节的 .tbss,所以 scratch 的块内偏移是 0x10。注意链接后符号表里的 TLS 符号值仍然是块内偏移,而不是虚拟地址。
.tdata 同时被那个可写的 PT_LOAD 覆盖,初始化映像会随普通数据一起映射进内存;它还落在 PT_GNU_RELRO(第 7 章讲的"填完就锁上"的区域)里,因为程序从不直接写这份模板。每创建一个线程,运行时按 p_memsz 分配一块内存,把 p_filesz 字节的映像复制进去,其余清零。所有线程用的是同一份初始化映像,新线程不会继承父线程当时的值(Drepper §3.1)。
.tbss 在布局上还有个怪癖,看节头就能发现:
$ readelf -SW gd2le | grep -E 'tdata|tbss|dynamic' [ 7] .tdata PROGBITS 0000000000002330 000330 000008 00 WAT 0 0 4 [ 8] .tbss NOBITS 0000000000002340 000338 000400 00 WAT 0 0 16 [ 9] .dynamic DYNAMIC 0000000000002338 000338 000090 10 WA 4 0 8.tbss 的地址区间是 0x2340 到 0x2740,紧随其后的 .dynamic 却从 0x2338 开始,两者重叠。.bss 虽然不占文件空间,但要占进程的地址空间,后面的节只能排在它之后;.tbss 在进程地址空间里根本没有"自己的那份",链接器给它的地址只是用来算偏移的记账值,后面的普通节可以照常排在 .tdata 之后。这是布局阶段对 TLS 的特殊处理之一。
第一个问题有了答案:每个线程那一份的初始内容来自 PT_TLS 描述的模板。这一份在每个线程里放在哪里,又回到"当前是哪个线程"。
线程指针:每个线程手里的一把钥匙
CPU 执行指令时并不知道"线程"这个概念,它只认寄存器和内存。要让同一条指令在不同线程里访问不同地址,最直接的办法是给每个线程一个寄存器,里面放一个只属于它的指针,操作系统切换线程时连同这个寄存器一起切换。这个指针叫线程指针(thread pointer,TP)。
AArch64 为此准备了一个系统寄存器 TPIDR_EL0。系统寄存器是存放处理器状态和配置的专用寄存器,不能像通用寄存器那样直接参与运算,要用 mrs(读到通用寄存器)和 msr(从通用寄存器写入)两条指令访问;TPIDR_EL0 在用户态可读,mrs x8, TPIDR_EL0 就把线程指针读进 x8(AArch64 System V ABI)。
x86-64 沿用了 i386 的做法,借用段寄存器。i386 上 Drepper 的理由是这个架构寄存器太少(§3.4.2),于是把线程指针间接地放在 %gs 的段基址里;x86-64 换成了 %fs(§3.4.6)。64 位模式下段寄存器的分段功能基本废弃,但 %fs 和 %gs 还保留着段基址:一条带 %fs: 前缀的访存指令,实际访问的是"%fs 基址 + 指令算出的地址"。Linux 上,主线程的 %fs 基址由 C 库通过 arch_prctl(ARCH_SET_FS, ...) 系统调用设置,新线程则在 clone 时带上 CLONE_SETTLS 标志、由内核一并设好,之后内核切换线程时保存和恢复它。
基址藏在 CPU 内部,一条普通的 mov 读不出它。GNU 系统上的约定是:线程指针所指的那个字,存的就是线程指针自己。于是 movq %fs:0, %rax 读的是"基址 + 0"处的字,恰好得到线程指针的值。这个约定 Drepper 在 §3.4.2 为 IA-32 的 GNU 变体写下,§3.4.6 说明 x86-64 与 IA-32 的 GNU 变体基本一致,§4.3.6 的代码序列直接用到了它。
线程指针指向的那块内存叫 TCB(Thread Control Block,线程控制块),是线程库为每个线程维护的描述结构。各线程那一份 TLS 数据就放在 TCB 旁边,放在哪一边有两种约定。
两种布局:TLS 在线程指针的哪一边
Drepper 文档定义了两种布局(§3,图 1、图 2),各架构二选一。
Variant I 是为 IA-64 新定的,当时没有兼容包袱。TCB 开头保存一张按模块查找 TLS 块的表的指针,这张表叫 DTV,下一节展开它的查找过程。可执行文件的 TLS 块排在 TCB 之后,后面依次是启动时就加载的各共享库的块,变量地址是线程指针加一个正偏移。AArch64 用的就是 Variant I:线程指针指向一个固定 16 字节的 TCB,前 8 字节是 DTV 指针,后 8 字节留给实现,可执行文件的 TLS 块从线程指针之后 16 字节(再按 p_align 补齐)开始(AArch64 System V ABI)。并非所有 Variant I 架构都让线程指针恰好指向 TCB:RISC-V5 的线程指针指向 TCB 之后、TLS 块的起点,PowerPC 则在此基础上再往后偏 0x7000 字节,好让有符号 16 位位移能覆盖更大的范围。
Variant II 用于 i386、x86-64、s390 等。线程指针同样指向 TCB,但 TLS 块放在 TCB 下方:可执行文件的块紧贴线程指针之下,启动时加载的共享库依次往更低的地址排,变量地址是线程指针减一个偏移。Drepper 在脚注里给的理由是兼容:这些架构上线程指针所指内存的布局由来已久,和 Variant I 不兼容。
先看本例使用的简单对齐情形:TLS 模板起点满足 p_align,没有需要保留的非零起始对齐余数。Variant II 下第 m 个模块的块离线程指针多远,可以按下面的公式计算(Drepper §3.4.2 与 §3.4.6)。一般 ELF 文件还可能需要考虑模板起点的对齐余数,不能仅凭这两行实现所有输入的布局。
tlsoffset_1 = round(tlssize_1, align_1)tlsoffset_m+1 = round(tlsoffset_m + tlssize_m+1, align_m+1)round(x, y) 把 x 向上取整到 y 的倍数,这里沿用 Drepper 的编号,把带有 TLS 的主可执行文件记为模块 1;公式描述启动时的静态 TLS 布局。代入上面的 gd2le:p_memsz 0x410,p_align 0x10,所以 tlsoffset_1 = 0x410,块占据 [TP − 0x410, TP)。三个变量相对线程指针的偏移是块内偏移减 0x410:counter 是 −0x410,ext_var 是 −0x40c,scratch 是 −0x400。
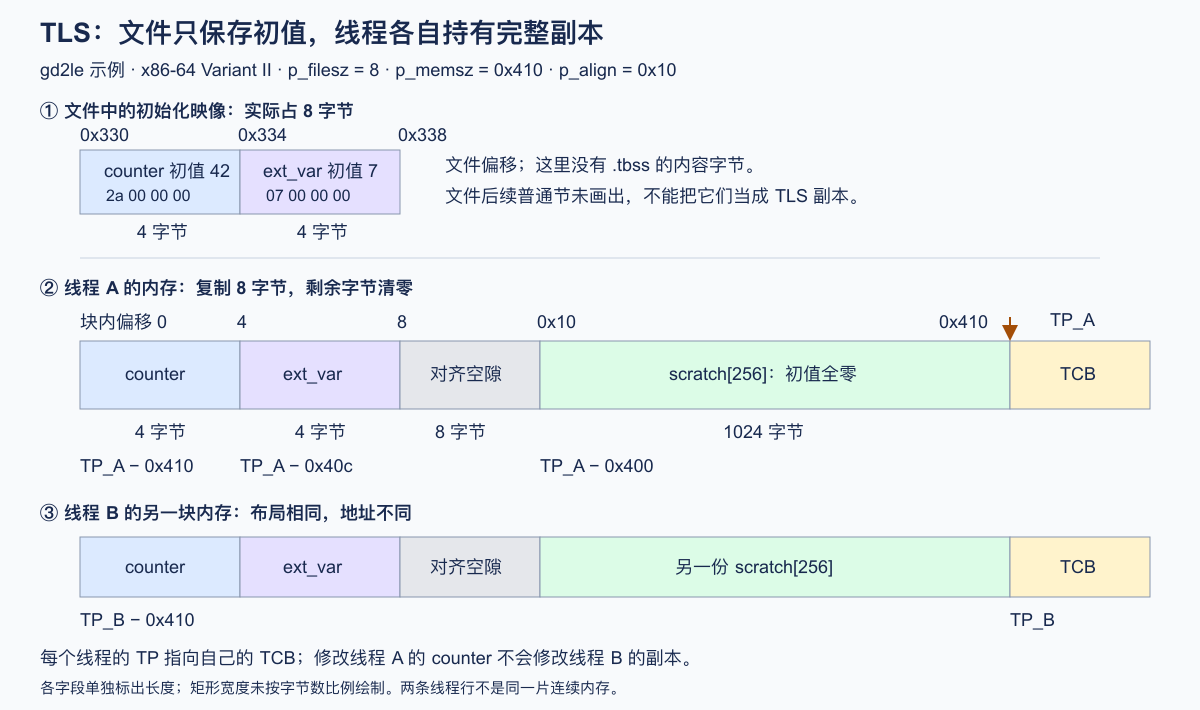
图中的三行使用不同的坐标。第一行标的是文件偏移:input[0x330..0x338] 只有两个整数的初值,不含 1024 字节的 scratch。下面两行标的是各线程 TLS 块内的偏移:运行时复制这 8 字节,并把剩余 0x408 字节清零。scratch 从块内偏移 0x10 开始,所需的内存由运行时提供,不是从文件中读取出来的。
同一个 counter 在两个线程中都位于各自块的偏移 0,但两块内存的起点不同。x86-64 的访问代码以当前线程的 TP 为基准,所以地址写成 TP − 0x410;这个负数是从 TP 向低地址走的距离,不是负的文件偏移。两个线程执行同样的指令,会因为 TP 不同而读写不同地址。
本例中这些 TP 相对偏移在链接可执行文件时就能算出:块的大小和对齐已知,启动时共享库的 TLS 块排在它的低地址一侧,不会改变这几个变量相对于 TP 的位置。
共享库就没有这么好的运气。一个共享库被哪个程序加载、排在第几个、前面有多大的块,链接它时一概不知;如果是被 dlopen 进来的,更是在进程已经跑了很久、已经有很多线程之后才出现。编译器不能保证运行时已为它保留一个相对线程指针固定的块。某些运行时会预留静态 TLS 余量,稍后会看到这种兼容措施及其容量限制;通用访问路径仍需要在不能依赖这份余量时成立,因此还需要一张表。
DTV 与 __tls_get_addr:给动态加载留的路
这张表叫 DTV(Dynamic Thread Vector,动态线程向量)。每个线程有自己的一张 DTV,TCB 里有指针指向它。DTV 按模块编号索引:第 m 项指向"当前线程的模块 m 的 TLS 块"。模块编号由 ld.so 在加载模块时分配,Drepper §3.1 的模型把主可执行文件记为 1;真正的查找应使用加载器给出的编号,不能把所有输入模块的编号写死。
有了 DTV,任何一个 TLS 变量都能用一对数表示:模块编号,加上变量在该模块 TLS 块里的偏移。这就是 STT_TLS 符号的值只是块内偏移的原因。从这对数到地址,由运行时提供的函数 __tls_get_addr 完成。x86-64 上它只接受一个参数,指向这样一个结构(§3.4.6):
typedef struct { unsigned long int ti_module; /* 模块编号 */ unsigned long int ti_offset; /* 块内偏移 */} tls_index;extern void *__tls_get_addr (tls_index *ti);Drepper §3.1 用下面的伪代码说明按需分配的实现方式。这里改写成单参数形式;thread_id 表示当前线程,dtv 和 allocate_tls 是解释算法的记号,不是可直接链接的 C 库接口:
void *__tls_get_addr (tls_index *ti) { char *block = dtv[thread_id][ti->ti_module]; if (block == UNALLOCATED_TLS_BLOCK) block = dtv[thread_id][ti->ti_module] = allocate_tls (ti->ti_module); return block + ti->ti_offset;}中间那个判断就是给 dlopen 留的路。新模块被 dlopen 进来时,ld.so 给它分配编号,但不必立刻为所有已有线程分配 TLS 块,DTV 里对应的项先填一个"未分配"的特殊值;哪个线程第一次访问这个模块的 TLS 变量,__tls_get_addr 就在那时按 PT_TLS 模板为它分配并初始化。DTV 本身也可能需要变长,所以它开头还有一个代数(generation)计数,用来发现"这张表比全局的模块列表旧了,需要扩容"(§3.2)。
按首次访问分配是一种运行时策略,不是 DTV 这个结构强制要求的行为。glibc 使用按需分配路径;musl6 则在 dlopen 和创建线程时预先准备所需的 TLS 与 DTV 存储,使后续 TLS 访问不再因为临时分配失败而出错。模块编号加块内偏移的寻址接口仍然成立,分配发生的时间却不同,不能把两种实现的步骤混成一条通用加载流程。musl 的设计说明专门解释了这个选择。
到这里,地址的算法有了两条路:要么"线程指针加减一个常数",要么"调 __tls_get_addr 查 DTV"。前者要求变量在静态 TLS 区域里取得固定偏移,通常由启动时布局满足;后者通过运行时查找,也允许编译器复用已经取得的地址。在这两者之间怎么选,就是 TLS 访问模型。
同一个变量的四种坐标
分析 TLS 重定位时,先确定一个数属于哪套坐标。ELF 文件的位置、模板内的位置、线程内的位移和实际地址可以同时出现在一份工具输出中,却不能互相替代。以 counter 为例:
| 数值 | 所属坐标 | 用途 |
|---|---|---|
0x330 | 文件偏移 | 找到模板中初值 42 的四个字节 |
0 | 模块 TLS 块内偏移 | 链接后 STT_TLS 的 st_value;供模块内寻址使用 |
−0x410 | TP 相对位移 | 在本例 Variant II 布局中从 TP 找到 counter |
TP − 0x410 | 当前线程的实际地址 | 运行时读写变量;随着线程的 TP 改变 |
块内偏移为 t、块起点到 TP 的距离为 D 时,TP 相对位移是 t − D。LE 把该位移写进指令字段;IE 把该位移放进 GOT 槽,再用当前 TP 访问。两者最终都计算 TP + (t − D)。GOT 槽自己的地址不是变量地址:找到槽位的 RIP 相对位移,与槽位里保存的 TP 相对位移,是两次不同的计算。
例如 counter 的位移是 −0x410。四字节有符号字段的小端编码为 f0 fb ff ff;若用八字节 GOT 槽保存,编码为 f0 fb ff ff ff ff ff ff。读取后仍按有符号位移参与地址计算。不能把这个位模式当作等待加上 ELF 加载基址的普通指针:整个映像的 load bias 描述进程中的映像位置,TP 描述当前线程的 TLS 位置,两者独立。
GD 和 LD 使用的模块块内偏移也不等于 TP 相对位移。它们先取得当前线程中相应模块的块起点,再加 t;模块的动态分配位置无需满足本例 LE 的固定距离 D。这正是不同 TLS 重定位不能仅凭字段宽度相同就交给普通地址补丁处理的原因。
四种访问模型
先从“哪些信息还没确定”理解模型,再看它们的名字。变量在所属模块里的偏移,可以在链接该模块时确定;但哪个模块提供定义,以及模块的块相对 TP 放在哪里,可能要等到加载时才知道。
| 地址计算方式 | 代码中已经固定的部分 | 运行时还需要取得的部分 |
|---|---|---|
LE:TP + 常数 | 可执行文件中变量的 TP 相对偏移 | 当前线程的 TP |
IE:TP + GOT 中的偏移 | 存放偏移的 GOT 项位置 | 当前 TP,以及加载器填入的偏移 |
LD:本模块块起点 + 常数 | 变量在本模块的块内偏移 | 当前线程中本模块块的起点 |
| GD:解析“模块 + 块内偏移” | 参数对所在的 GOT 项位置 | 定义所属模块、块内偏移,以及当前线程中的块起点 |
这里的“常数”指链接相应产物时能够确定的值,编译 .o 时仍可能需要重定位。模型允许编译器作出的假设如下(Drepper §4):
- General Dynamic(GD,通用动态):什么都不假设。代码可能在被
dlopen的库里,变量可能在任何模块里。使用__tls_get_addr取得地址,编译器可复用求地址结果。 - Local Dynamic(LD,局部动态):代码可能在任何模块,但变量定义在当前模块里(比如
static __thread,或可见性为 hidden 的变量)。调一次__tls_get_addr拿到本模块 TLS 块的起点,之后每个变量只是"起点 + 常数偏移"。 - Initial Exec(IE,初始可执行):要求变量能分配在静态 TLS 区域,通常由启动时加载满足。运行中加载时能否借助预留余量,是运行时的额外限制,IE 代码无法自行补救。变量相对线程指针的偏移由
ld.so布局时确定,存在 GOT7(第 7 章的全局偏移表)里,用时读出来。 - Local Exec(LE,局部可执行):代码在可执行文件里,变量也定义在可执行文件里。偏移在链接时就能算出,直接作为立即数写进指令。
GD:两条指令,一次调用
-fPIC 编译出来的 bump:
$ llvm-objdump -d -r pic.opic.o: file format elf64-x86-64
Disassembly of section .text:
0000000000000000 <bump>: 0: 50 pushq %rax 1: 66 48 8d 3d 00 00 00 00 leaq (%rip), %rdi # 0x9 <bump+0x9> 0000000000000005: R_X86_64_TLSGD counter-0x4 9: 66 66 48 e8 00 00 00 00 callq 0x11 <bump+0x11> 000000000000000d: R_X86_64_PLT32 __tls_get_addr-0x4 11: 8b 08 movl (%rax), %ecx 13: ff c1 incl %ecx 15: 89 08 movl %ecx, (%rax) 17: 89 c8 movl %ecx, %eax 19: 59 popq %rcx 1a: c3 retq 1b: 0f 1f 44 00 00 nopl (%rax,%rax)
0000000000000020 <scratch_at>: 20: 53 pushq %rbx 21: 89 fb movl %edi, %ebx 23: 66 48 8d 3d 00 00 00 00 leaq (%rip), %rdi # 0x2b <scratch_at+0xb> 0000000000000027: R_X86_64_TLSGD scratch-0x4 2b: 66 66 48 e8 00 00 00 00 callq 0x33 <scratch_at+0x13> 000000000000002f: R_X86_64_PLT32 __tls_get_addr-0x4 33: 48 63 cb movslq %ebx, %rcx 36: 48 8d 04 88 leaq (%rax,%rcx,4), %rax 3a: 5b popq %rbx 3b: c3 retq 3c: 0f 1f 40 00 nopl (%rax)
0000000000000040 <read_ext>: 40: 50 pushq %rax 41: 66 48 8d 3d 00 00 00 00 leaq (%rip), %rdi # 0x49 <read_ext+0x9> 0000000000000045: R_X86_64_TLSGD ext_var-0x4 49: 66 66 48 e8 00 00 00 00 callq 0x51 <read_ext+0x11> 000000000000004d: R_X86_64_PLT32 __tls_get_addr-0x4 51: 8b 00 movl (%rax), %eax 53: 59 popq %rcx 54: c3 retq写成汇编源码,这两条是 leaq counter@tlsgd(%rip), %rdi 和 call __tls_get_addr@PLT。@tlsgd、@PLT,以及后面会出现的 @gottpoff、@tpoff、@dtpoff、@tlsld,都是汇编器的操作符:写在符号后面,告诉汇编器这里该生成哪种重定位。counter@tlsgd 生成的就是 R_X86_64_TLSGD。
R_X86_64_TLSGD 要求链接器在 GOT 里分配两个连续的 8 字节 GOT 项,组成一个 tls_index,然后把这个结构相对当前 PC 的偏移填进 leaq;-0x4 加数的来历和第 4 章的 PC32 一样。这两个 GOT 项要等 ld.so 来填,所以链接器还要为它们各生成一条动态重定位:R_X86_64_DTPMOD64 填"定义 counter 的模块的编号",R_X86_64_DTPOFF64 填"counter 在该模块 TLS 块里的偏移"(Drepper §4.1.6)。call 时 %rdi 就是那个 tls_index 的地址,返回值 %rax 是当前线程的 counter 的地址,后面是普通的读、加一、写回。
奇怪的是那几个多出来的字节:leaq 前面有个 66,call 前面有 66 66 48(llvm-objdump 的反汇编不显示它们,只能从字节里看)。0x66 是操作数大小前缀,汇编里写作 data16;0x48 是 REX.W 前缀,写作 rex64。Drepper §4.1.6 规定 GD 序列必须带这些前缀,把整组凑成 16 字节(这里是 0x1 到 0x11),并且说明用前缀而不用空操作指令,是因为前缀对执行没有负面影响。凑成 16 字节的用处,到链接器改写时就会看到。
scratch_at 和 read_ext 用的是同样的序列。在 -fPIC 下,counter 和 scratch 虽然就定义在本文件里,但它们是默认可见性的全局符号,第 7 章讲过的符号插入允许别的模块提供同名定义来顶替它们,编译器不能假设引用一定落在本模块,只能用 GD。
LD:多个本地变量共用一次调用
换一个文件 ld.c,变量改成 static:
static _Thread_local int a = 1;static _Thread_local int b;int touch(int x) { a += x; b -= x; return a + b; }$ clang -O1 -fPIC -c ld.c -o ld.o$ llvm-objdump -d -r ld.old.o: file format elf64-x86-64
Disassembly of section .text:
0000000000000000 <touch>: 0: 53 pushq %rbx 1: 89 fb movl %edi, %ebx 3: 48 8d 3d 00 00 00 00 leaq (%rip), %rdi # 0xa <touch+0xa> 0000000000000006: R_X86_64_TLSLD a-0x4 a: e8 00 00 00 00 callq 0xf <touch+0xf> 000000000000000b: R_X86_64_PLT32 __tls_get_addr-0x4 f: 8b 90 00 00 00 00 movl (%rax), %edx 0000000000000011: R_X86_64_DTPOFF32 a 15: 8d 34 1a leal (%rdx,%rbx), %esi 18: 89 b0 00 00 00 00 movl %esi, (%rax) 000000000000001a: R_X86_64_DTPOFF32 a 1e: 8b 88 00 00 00 00 movl (%rax), %ecx 0000000000000020: R_X86_64_DTPOFF32 b 24: 89 ce movl %ecx, %esi 26: 29 de subl %ebx, %esi 28: 89 b0 00 00 00 00 movl %esi, (%rax) 000000000000002a: R_X86_64_DTPOFF32 b 2e: 01 d1 addl %edx, %ecx 30: 89 c8 movl %ecx, %eax 32: 5b popq %rbx 33: c3 retq(如果两个变量从来没被写过,clang 会直接把 a + b 折叠成常数 1,一条 TLS 访问都不留,所以这里让函数去改它们。)
R_X86_64_TLSLD(汇编里是 a@tlsld)也要求在 GOT 里放一个 tls_index,但它代表"本模块、偏移 0",即本模块 TLS 块的起点,只需要一条 DTPMOD64,偏移那一格链接器直接写 0。__tls_get_addr 返回块的起点,之后对 a、b 的每次访问都是 (%rax) 加一个 32 位位移,位移由 R_X86_64_DTPOFF32(a@dtpoff)填成变量在块内的偏移,链接时就能确定(Drepper §4.2.6)。这里的 leaq 和 call 前面没有前缀,一共 12 字节,后面同样会用到这个长度。
一个函数里访问多个本地 TLS 变量时,LD 的好处最明显。只访问一个变量时,Drepper 一方面说它在 x86-64 上对 GD 没有优势,一方面又补了一句:每多一个变量只多几条指令,不增加 GOT 项和动态重定位,所以即使只有一个变量,如果能省下运行时处理动态重定位的开销,也可能值得用 LD(§4.2.6)。GD 每个变量要两条动态重定位,LD 整个模块只要一条 DTPMOD64。
IE:从 GOT 读出偏移
不加 -fPIC 再编译一次。这个 clang 对 Linux 目标默认按 PIE 编译(-### 能看到它传给前端的是 -pic-level ... -pic-is-pie),所以下面是"代码会进可执行文件"的情形:
$ clang -O1 -c tls.c -o nopic.o$ llvm-objdump -d -r nopic.onopic.o: file format elf64-x86-64
Disassembly of section .text:
0000000000000000 <bump>: 0: 64 8b 04 25 00 00 00 00 movl %fs:0x0, %eax 0000000000000004: R_X86_64_TPOFF32 counter 8: ff c0 incl %eax a: 64 89 04 25 00 00 00 00 movl %eax, %fs:0x0 000000000000000e: R_X86_64_TPOFF32 counter 12: c3 retq 13: 66 66 66 66 2e 0f 1f 84 00 00 00 00 00 nopw %cs:(%rax,%rax)
0000000000000020 <scratch_at>: 20: 64 48 8b 04 25 00 00 00 00 movq %fs:0x0, %rax 29: 48 63 cf movslq %edi, %rcx 2c: 48 8d 04 88 leaq (%rax,%rcx,4), %rax 30: 48 05 00 00 00 00 addq $0x0, %rax 0000000000000032: R_X86_64_TPOFF32 scratch 36: c3 retq 37: 66 0f 1f 84 00 00 00 00 00 nopw (%rax,%rax)
0000000000000040 <read_ext>: 40: 48 8b 05 00 00 00 00 movq (%rip), %rax # 0x47 <read_ext+0x7> 0000000000000043: R_X86_64_GOTTPOFF ext_var-0x4 47: 64 8b 00 movl %fs:(%rax), %eax 4a: c3 retqext_var 定义在别的模块里,可能是某个共享库,编译器不知道它离线程指针多远。但这段代码会进可执行文件,可执行文件依赖的库都在启动时加载,所以 ext_var 的块在线程指针下方有一个固定位置。于是用 IE:movq ext_var@gottpoff(%rip), %rax 生成 R_X86_64_GOTTPOFF,要求链接器在 GOT 里分配一项,把这一项相对 PC 的偏移填进 movq;这个 GOT 项带一条动态重定位 R_X86_64_TPOFF64,由 ld.so 在启动时填入"ext_var 相对线程指针的偏移"。运行时 movq 把偏移读进 %rax,第二条 movl %fs:(%rax), %eax 以线程指针为基址访问,第一个字节 64 就是 %fs 段前缀。没有函数调用。
Drepper §4.3.6 给了两种等长的 IE 序列:一种是先 movq %fs:0, %rax 取线程指针,再 addq x@gottpoff(%rip), %rax 加上偏移,得到地址;另一种就是上面这种 movq x@gottpoff(%rip), %rax 加 %fs: 访存,直接取值。
LE:偏移写在指令里
同一个文件里的 bump:
0000000000000000 <bump>: 0: 64 8b 04 25 00 00 00 00 movl %fs:0x0, %eax 0000000000000004: R_X86_64_TPOFF32 counter 8: ff c0 incl %eax a: 64 89 04 25 00 00 00 00 movl %eax, %fs:0x0 000000000000000e: R_X86_64_TPOFF32 counter 12: c3 retqcounter 定义在本文件,代码又在可执行文件里,它离线程指针的距离是链接时常数,连 GOT 都不需要。64 8b 04 25 是 %fs 前缀、mov 的操作码,加上两个描述寻址方式的字节:04 是 ModRM 字节(x86 指令里紧跟操作码、说明操作数是寄存器还是内存、用哪种寻址方式的那个字节),25 是它要求的附加寻址字节,两者合起来表示"无基址、只有 32 位位移"。位移由 R_X86_64_TPOFF32(汇编里是 counter@tpoff)填成相对线程指针的偏移。把 nopic.o 和 ext.o 链接成 PIE,就能看到填好的值:
$ ld.lld -pie start.o nopic.o ext.o -o ie2le$ llvm-objdump -d ie2leie2le: file format elf64-x86-64
Disassembly of section .text:
00000000000012b0 <_start>: 12b0: c3 retq 12b1: cc int3 12b2: cc int3 12b3: cc int3 12b4: cc int3 12b5: cc int3 12b6: cc int3 12b7: cc int3 12b8: cc int3 12b9: cc int3 12ba: cc int3 12bb: cc int3 12bc: cc int3 12bd: cc int3 12be: cc int3 12bf: cc int3
00000000000012c0 <bump>: 12c0: 64 8b 04 25 f0 fb ff ff movl %fs:-0x410, %eax 12c8: ff c0 incl %eax 12ca: 64 89 04 25 f0 fb ff ff movl %eax, %fs:-0x410 12d2: c3 retq 12d3: 66 66 66 66 2e 0f 1f 84 00 00 00 00 00 nopw %cs:(%rax,%rax)
00000000000012e0 <scratch_at>: 12e0: 64 48 8b 04 25 00 00 00 00 movq %fs:0x0, %rax 12e9: 48 63 cf movslq %edi, %rcx 12ec: 48 8d 04 88 leaq (%rax,%rcx,4), %rax 12f0: 48 05 00 fc ff ff addq $-0x400, %rax # imm = 0xFC00 12f6: c3 retq 12f7: 66 0f 1f 84 00 00 00 00 00 nopw (%rax,%rax)
0000000000001300 <read_ext>: 1300: 48 c7 c0 f4 fb ff ff movq $-0x40c, %rax # imm = 0xFBF4 1307: 64 8b 00 movl %fs:(%rax), %eax 130a: c3 retq 130b: cc int3f0 fb ff ff 就是 −0x410,和前面按公式算出的 counter 偏移一致。++counter 成了三条指令,和访问一个普通全局变量几乎一样快。scratch_at 要取地址,所以先 movq %fs:0, %rax 拿到线程指针本身,再 addq $scratch@tpoff, %rax,链接后是 addq $-0x400, %rax。
LE 的前提是"代码在可执行文件里"。如果把这样编译出来的目标文件拿去链接共享库,链接器会直接拒绝。两个链接器的报错如下:
$ ld.lld -shared nopic.o -o x.sold.lld: error: relocation R_X86_64_TPOFF32 against counter cannot be used with -shared>>> defined in nopic.o>>> referenced by tls.c>>> nopic.o:(bump)
ld.lld: error: relocation R_X86_64_TPOFF32 against counter cannot be used with -shared>>> defined in nopic.o>>> referenced by tls.c>>> nopic.o:(bump)
ld.lld: error: relocation R_X86_64_TPOFF32 against scratch cannot be used with -shared>>> defined in nopic.o>>> referenced by tls.c>>> nopic.o:(scratch_at)$ ld.bfd -shared nopic.o -o y.so/usr/bin/x86_64-linux-gnu-ld.bfd: nopic.o: relocation R_X86_64_TPOFF32 against symbol `counter' can not be used when making a shared object; local-exec is incompatible with -shared/usr/bin/x86_64-linux-gnu-ld.bfd: failed to set dynamic section sizes: bad value原因和第 7 章非 PIC8 代码进共享库时的报错相同:TPOFF32 要求链接器把"相对线程指针的偏移"写成立即数,而共享库的块离线程指针多远,链接时无从知道。看到 TPOFF32 出现在这类报错里,就说明某个本该用 -fPIC 编译的目标文件混进了共享库。
对这里展示的指令序列,GD 经过求地址调用;LD 取得模块 TLS 块起点后,可以让后续多个访问共用这个结果;IE 需要读取 GOT 中的偏移;LE 把偏移直接放进指令。实际调用次数还取决于编译器是否复用或外提求地址结果,LE 也仍需要完成普通的地址计算和访存。能在链接时确定的信息越多,运行时需要补做的工作通常越少。
| 模型 | 代码可以在 | 变量可以在 | 偏移何时确定 | 运行时代价 |
|---|---|---|---|---|
| GD | 任何模块,含 dlopen 的库 | 任何模块 | 运行时(__tls_get_addr) | 求地址调用,可被复用 |
| LD | 任何模块 | 同一模块 | 块起点运行时,块内偏移链接时 | 取得模块基址的调用,可供多个访问共用 |
| IE | 能满足静态 TLS 约束的模块 | 静态 TLS 区域中的模块 | ld.so 布局时(GOT) | 读取 GOT 偏移,再访问对象 |
| LE | 可执行文件 | 可执行文件 | 链接时(立即数) | 直接使用已知偏移 |
编译器怎么选,以及 -ftls-model
编译器默认按它知道的情况选:-fPIC(可能进共享库)下,外部或可被插入的变量用 GD,本模块的用 LD;PIE 或非 PIC(一定进可执行文件)下,外部变量用 IE,本文件定义的用 LE。
程序员也可以用 -ftls-model=global-dynamic|local-dynamic|initial-exec|local-exec 或变量属性 __attribute__((tls_model("initial-exec"))) 指定模型。GCC 文档有一句限定:选择会被优化覆盖,对翻译单元(第 3 章讲过)之外不可见的符号,或者没有给 -fpic 时,编译器可能用更高效的模型(GCC Code Gen Options)。clang 的行为一致。实测在默认 PIE 下指定 -ftls-model=global-dynamic,输出和上面的 nopic.o 一字不差;反过来,在 -fPIC 下指定 -ftls-model=initial-exec,bump 就从 GD 序列变成了:
$ clang -O1 -fPIC -ftls-model=initial-exec -c tls.c -o ie.o$ llvm-objdump -d -r ie.oie.o: file format elf64-x86-64
Disassembly of section .text:
0000000000000000 <bump>: 0: 48 8b 0d 00 00 00 00 movq (%rip), %rcx # 0x7 <bump+0x7> 0000000000000003: R_X86_64_GOTTPOFF counter-0x4 7: 64 8b 01 movl %fs:(%rcx), %eax a: ff c0 incl %eax c: 64 89 01 movl %eax, %fs:(%rcx) f: c3 retq
0000000000000010 <scratch_at>: 10: 64 48 8b 04 25 00 00 00 00 movq %fs:0x0, %rax 19: 48 03 05 00 00 00 00 addq (%rip), %rax # 0x20 <scratch_at+0x10> 000000000000001c: R_X86_64_GOTTPOFF scratch-0x4 20: 48 63 cf movslq %edi, %rcx 23: 48 8d 04 88 leaq (%rax,%rcx,4), %rax 27: c3 retq 28: 0f 1f 84 00 00 00 00 00 nopl (%rax,%rax)
0000000000000030 <read_ext>: 30: 48 8b 05 00 00 00 00 movq (%rip), %rax # 0x37 <read_ext+0x7> 0000000000000033: R_X86_64_GOTTPOFF ext_var-0x4 37: 64 8b 00 movl %fs:(%rax), %eax 3a: c3 retq这个选项只能把模型往更快、更受限的方向推,编译器不会因为它而用比自己能证明的更慢的模型。往快的方向推有代价:用 IE 编译的共享库放弃了"可以被 dlopen"这个保证,这一点留到本章最后。
链接器的模型降级
前面陆续出现的 TLS 重定位(定义见 x86-64 psABI 的 TLS 重定位表和 Drepper §4),按链接器怎么对待它们,可以分成两类。
一类是链接器当场就能算掉的。R_X86_64_TPOFF32 在可执行文件里填相对线程指针的偏移,R_X86_64_DTPOFF32 填变量在本模块块内的偏移,都是链接时常数,填完就没有了。R_X86_64_TLSGD、R_X86_64_TLSLD、R_X86_64_GOTTPOFF 填的是 GOT 项相对 PC 的偏移,这个偏移链接器也算得出来;但它们让链接器建出来的 GOT 项,内容往往只有运行时才知道。
另一类由链接器在输出中生成,留给 ld.so 执行。例如输入的 TLSGD 请求一组 GOT 参数,链接器为相应输出位置生成动态重定位,并非把输入的 TLSGD 原样搬过去。其中,R_X86_64_DTPMOD64 填模块编号,R_X86_64_DTPOFF64 填块内偏移,R_X86_64_TPOFF64 填相对线程指针的偏移。模块编号和模块之间的排列只有在进程启动或 dlopen 时才确定,这是第 7 章"有些地址链接时根本不知道"的 TLS 版本。把 pic.o 链接成共享库,看到的就是这一类:
$ ld.lld -shared pic.o -o libtls.so$ readelf -rW libtls.soRelocation section '.rela.dyn' at offset 0x3b8 contains 6 entries: Offset Info Type Symbol's Value Symbol's Name + Addend0000000000002658 0000000200000010 R_X86_64_DTPMOD64 0000000000000000 ext_var + 00000000000002660 0000000200000011 R_X86_64_DTPOFF64 0000000000000000 ext_var + 00000000000002638 0000000400000010 R_X86_64_DTPMOD64 0000000000000000 counter + 00000000000002640 0000000400000011 R_X86_64_DTPOFF64 0000000000000000 counter + 00000000000002648 0000000600000010 R_X86_64_DTPMOD64 0000000000000010 scratch + 00000000000002650 0000000600000011 R_X86_64_DTPOFF64 0000000000000010 scratch + 0
Relocation section '.rela.plt' at offset 0x448 contains 1 entry: Offset Info Type Symbol's Value Symbol's Name + Addend0000000000003680 0000000100000007 R_X86_64_JUMP_SLOT 0000000000000000 __tls_get_addr + 0三个变量各占两个相邻的 GOT 项(0x2638/0x2640 是 counter 的 tls_index),各带一对 DTPMOD64 + DTPOFF64;__tls_get_addr 本身是一个普通的外部函数,走第 7 章的 PLT9 和 JUMP_SLOT。同样的方式链接 ld.o,.rela.dyn 里只有一条不带符号的 DTPMOD64,这就是 LD 省下的那部分。
共享库里这些重定位只能留着。但编译器选模型时只看得到一个翻译单元:pic.o 的 bump 用 GD,是因为编译器不知道这个 .o 最后会进共享库还是可执行文件。如果它最后被链接进可执行文件(有些项目的静态库统一用 -fPIC 编译),链接器知道的就比编译器多得多:产物是可执行文件;counter 定义在这个可执行文件里,可执行文件总是符号查找的第一站,没人能顶替它;它在 TLS 块里的偏移也已经排好。这时还去调 __tls_get_addr 就纯属浪费。
于是链接器做和第 4 章 GOTPCRELX relaxation 同一类的事:不改变指令总长度,把慢的指令序列原地改写成快的。Drepper 第 5 章的标题是 Linker Optimizations,正文里也称之为 code relaxation,各家链接器的源码多叫 relaxation,中文里也常说"模型降级"。能做的改写构成一个层级(§5 的示意图):GD 可以降到 IE 或 LE,LD 可以降到 LE,IE 可以降到 LE。条件是:
- 产物是可执行文件(包括 PIE)时,被引用的变量定义在可执行文件本身:GD→LE、LD→LE、IE→LE;定义在启动时加载的共享库里:GD→IE。
- 产物是共享库时,GD 和 LD 都不能降级,因为这个库可能被
dlopen,它自己的块位置也不固定。
GD → LE
前面用 ld.lld 链接 gd2le 时,pic.o 和定义 ext_var 的 ext.o 都进了可执行文件。bump 那 16 字节的 GD 序列变成了:
$ llvm-objdump -d gd2legd2le: file format elf64-x86-64
Disassembly of section .text:
00000000000012c0 <_start>: 12c0: c3 retq 12c1: cc int3 12c2: cc int3 12c3: cc int3 12c4: cc int3 12c5: cc int3 12c6: cc int3 12c7: cc int3 12c8: cc int3 12c9: cc int3 12ca: cc int3 12cb: cc int3 12cc: cc int3 12cd: cc int3 12ce: cc int3 12cf: cc int3
00000000000012d0 <bump>: 12d0: 50 pushq %rax 12d1: 64 48 8b 04 25 00 00 00 00 movq %fs:0x0, %rax 12da: 48 8d 80 f0 fb ff ff leaq -0x410(%rax), %rax 12e1: 8b 08 movl (%rax), %ecx 12e3: ff c1 incl %ecx 12e5: 89 08 movl %ecx, (%rax) 12e7: 89 c8 movl %ecx, %eax 12e9: 59 popq %rcx 12ea: c3 retq 12eb: 0f 1f 44 00 00 nopl (%rax,%rax)
00000000000012f0 <scratch_at>: 12f0: 53 pushq %rbx 12f1: 89 fb movl %edi, %ebx 12f3: 64 48 8b 04 25 00 00 00 00 movq %fs:0x0, %rax 12fc: 48 8d 80 00 fc ff ff leaq -0x400(%rax), %rax 1303: 48 63 cb movslq %ebx, %rcx 1306: 48 8d 04 88 leaq (%rax,%rcx,4), %rax 130a: 5b popq %rbx 130b: c3 retq 130c: 0f 1f 40 00 nopl (%rax)
0000000000001310 <read_ext>: 1310: 50 pushq %rax 1311: 64 48 8b 04 25 00 00 00 00 movq %fs:0x0, %rax 131a: 48 8d 80 f4 fb ff ff leaq -0x40c(%rax), %rax 1321: 8b 00 movl (%rax), %eax 1323: 59 popq %rcx 1324: c3 retq 1325: cc int3 1326: cc int3 1327: cc int3改写前是 66 48 8d 3d xx xx xx xx 加 66 66 48 e8 xx xx xx xx,改写后是 9 字节的 movq %fs:0, %rax 加 7 字节的 leaq -0x410(%rax), %rax,9 + 7 = 16,一个字节都不多,正是 Drepper §5.5 给出的目标序列。执行完 %rax 里正好是当前线程的 counter 的地址,和原来 call 返回时一样,所以后面的 movl (%rax), %ecx 不用动。scratch_at 和 read_ext 也被改写,立即数分别是 −0x400 和 −0x40c。readelf -r gd2le 输出 There are no relocations in this file.,节头里也没有 .got:tls_index 和那几条动态重定位一并取消了。
这里能看出链接器为什么对这类序列格外挑剔:它要识别的是一整组固定形状的指令,单看一条重定位不够。R_X86_64_TLSGD 后面必须紧跟 call __tls_get_addr,寄存器必须是 %rdi 和 %rax,前缀字节必须恰好在那里。编译器如果在两条指令中间插了别的东西,链接器就无从改写,所以 psABI10 连整段代码序列一起规定。
GD → IE
把 ext.c 单独链接成共享库 libext.so,再让可执行文件依赖它。counter 仍在可执行文件里,走 GD→LE;ext_var 来自共享库,偏移链接时未知,但模块一定在启动时加载,于是 read_ext 降到 IE:
$ ld.lld -shared -soname libext.so ext.o -o libext.so$ ld.lld -pie start.o pic.o libext.so -o gd2ie$ llvm-objdump -d gd2iegd2ie: file format elf64-x86-64
Disassembly of section .text:
0000000000001330 <_start>: 1330: c3 retq 1331: cc int3 1332: cc int3 1333: cc int3 1334: cc int3 1335: cc int3 1336: cc int3 1337: cc int3 1338: cc int3 1339: cc int3 133a: cc int3 133b: cc int3 133c: cc int3 133d: cc int3 133e: cc int3 133f: cc int3
0000000000001340 <bump>: 1340: 50 pushq %rax 1341: 64 48 8b 04 25 00 00 00 00 movq %fs:0x0, %rax 134a: 48 8d 80 f0 fb ff ff leaq -0x410(%rax), %rax 1351: 8b 08 movl (%rax), %ecx 1353: ff c1 incl %ecx 1355: 89 08 movl %ecx, (%rax) 1357: 89 c8 movl %ecx, %eax 1359: 59 popq %rcx 135a: c3 retq 135b: 0f 1f 44 00 00 nopl (%rax,%rax)
0000000000001360 <scratch_at>: 1360: 53 pushq %rbx 1361: 89 fb movl %edi, %ebx 1363: 64 48 8b 04 25 00 00 00 00 movq %fs:0x0, %rax 136c: 48 8d 80 00 fc ff ff leaq -0x400(%rax), %rax 1373: 48 63 cb movslq %ebx, %rcx 1376: 48 8d 04 88 leaq (%rax,%rcx,4), %rax 137a: 5b popq %rbx 137b: c3 retq 137c: 0f 1f 40 00 nopl (%rax)
0000000000001380 <read_ext>: 1380: 50 pushq %rax 1381: 64 48 8b 04 25 00 00 00 00 movq %fs:0x0, %rax 138a: 48 03 05 e7 10 00 00 addq 0x10e7(%rip), %rax # 0x2478 <ext_var+0x2478> 1391: 8b 00 movl (%rax), %eax 1393: 59 popq %rcx 1394: c3 retq$ readelf -rW gd2ieRelocation section '.rela.dyn' at offset 0x2a8 contains 1 entry: Offset Info Type Symbol's Value Symbol's Name + Addend0000000000002478 0000000200000012 R_X86_64_TPOFF64 0000000000000000 ext_var + 0同样 16 字节:9 字节取线程指针,7 字节的 addq 从 0x2478 的 GOT 项读出偏移加上去。GOT 从两格的 tls_index 换成一格,动态重定位从 DTPMOD64 + DTPOFF64 换成一条 TPOFF64,__tls_get_addr 的 JUMP_SLOT 也没有了。Drepper 在 §5.5 开头就是用这个转换来解释 GD 序列里那 4 字节前缀的:IE 序列比不加前缀的 GD 序列长 4 个字节。
LD → LE
ld.o 单独链接成 PIE,它的块只有 a、b 两个 4 字节变量,p_memsz 为 8:
$ ld.lld -pie start.o ld.o -o ld2le$ llvm-objdump -d ld2leld2le: file format elf64-x86-64
Disassembly of section .text:
0000000000001290 <_start>: 1290: c3 retq 1291: cc int3 1292: cc int3 1293: cc int3 1294: cc int3 1295: cc int3 1296: cc int3 1297: cc int3 1298: cc int3 1299: cc int3 129a: cc int3 129b: cc int3 129c: cc int3 129d: cc int3 129e: cc int3 129f: cc int3
00000000000012a0 <touch>: 12a0: 53 pushq %rbx 12a1: 89 fb movl %edi, %ebx 12a3: 66 66 66 64 48 8b 04 25 00 00 00 00 movq %fs:0x0, %rax 12af: 8b 90 f8 ff ff ff movl -0x8(%rax), %edx 12b5: 8d 34 1a leal (%rdx,%rbx), %esi 12b8: 89 b0 f8 ff ff ff movl %esi, -0x8(%rax) 12be: 8b 88 fc ff ff ff movl -0x4(%rax), %ecx 12c4: 89 ce movl %ecx, %esi 12c6: 29 de subl %ebx, %esi 12c8: 89 b0 fc ff ff ff movl %esi, -0x4(%rax) 12ce: 01 d1 addl %edx, %ecx 12d0: 89 c8 movl %ecx, %eax 12d2: 5b popq %rbx 12d3: c3 retq原来 12 字节的 leaq + call 变成 movq %fs:0, %rax:本身 9 字节,前面垫三个无用的 0x66 凑满 12 字节(Drepper §5.5 写作 .word 0x6666; .byte 0x66)。之后 %rax 是线程指针而不是块起点,所以每一处 DTPOFF32 的位移也要从"块内偏移"改成"相对线程指针的偏移",即 Drepper 写的把 x1@dtpoff 换成 x1@tpoff。指令本身不变,a 的位移从 0 变成 −8,b 的从 4 变成 −4。
IE → LE
ie2le 里的 read_ext:
1300: 48 c7 c0 f4 fb ff ff movq $-0x40c, %rax # imm = 0xFBF4 1307: 64 8b 00 movl %fs:(%rax), %eax改写前是 48 8b 05 xx xx xx xx(movq ext_var@gottpoff(%rip), %rax)。两边都是 7 字节:操作码从 8b(从内存读)换成 c7(装入立即数),ModRM 从 05(RIP 相对寻址)换成 c0(目标是寄存器 %rax),后面 4 字节从 GOT 项的 PC 相对偏移换成 ext_var 相对线程指针的偏移。−0x40c 就是前面算过的那个数:ext_var 在块内偏移 4,块顶在 TP − 0x410。后面那条 movl %fs:(%rax), %eax 照旧。
Drepper §5.5 只列出了 addq 形式的 IE→LE,即把 addq x@gottpoff(%rip), %rax 改成 leaq x@tpoff(%rax), %rax;§4.3.6 里另一种 movq 形式的 IE 序列,在 §5.5 没有对应条目。lld 的 relaxTlsIeToLe(lld/ELF/Arch/X86_64.cpp)两种都处理:addq 改成 leaq(%rsp 和 %r12 例外,改成 addq $imm,因为它们的 leaq 编码多一个字节,放不下),movq 改成 movq $imm。
TLSDESC:让那次调用本身便宜一点
对于不能改成固定偏移的通用动态访问,前面的 GD 序列仍需要通过 __tls_get_addr 求地址。编译器可以复用已经取得的地址,因此一次源码访问不一定对应一次调用;但保留下来的调用使用普通 C 调用约定,调用方要保护仍然需要的寄存器值,解析器也需要处理 DTV 和模块列表的更新。除了减少调用次数,还能让这次求地址本身便宜一点吗?
TLS 描述符(TLSDESC)就是这个思路。它由 Alexandre Oliva 和 Guido Araújo 在 2006 年 GCC 开发者峰会的论文里提出(Speeding Up Thread-Local Storage Access in Dynamic Libraries)。GOT 里放的不再是 tls_index,而是一个"函数指针 + 参数"的描述符,代码间接调用这个函数,得到的是变量相对线程指针的偏移。ld.so 根据模块的实际情况填入不同的函数:模块的块恰好落在静态区域时,函数只是把参数里预先算好的偏移原样返回,几条指令就结束;块是动态分配的,才走类似 __tls_get_addr 的慢路径。这个函数约定保存几乎所有寄存器,调用方不必为它腾寄存器。
x86-64 上默认配置的 GCC 和 clang 都不生成它,要加 -mtls-dialect=gnu2(GCC 也可以在构建编译器时用 --with-tls=gnu2 改掉默认值):
$ clang -O1 -fPIC -mtls-dialect=gnu2 -c tls.c -o desc.o$ llvm-objdump -d -r desc.odesc.o: file format elf64-x86-64
Disassembly of section .text:
0000000000000000 <bump>: 0: 50 pushq %rax 1: 48 8d 05 00 00 00 00 leaq (%rip), %rax # 0x8 <bump+0x8> 0000000000000004: R_X86_64_GOTPC32_TLSDESC counter-0x4 8: ff 10 callq *(%rax) 0000000000000008: R_X86_64_TLSDESC_CALL counter a: 64 8b 08 movl %fs:(%rax), %ecx d: ff c1 incl %ecx f: 64 89 08 movl %ecx, %fs:(%rax) 12: 89 c8 movl %ecx, %eax 14: 59 popq %rcx 15: c3 retq 16: 66 2e 0f 1f 84 00 00 00 00 00 nopw %cs:(%rax,%rax)
0000000000000020 <scratch_at>: 20: 50 pushq %rax 21: 48 8d 05 00 00 00 00 leaq (%rip), %rax # 0x28 <scratch_at+0x8> 0000000000000024: R_X86_64_GOTPC32_TLSDESC scratch-0x4 28: ff 10 callq *(%rax) 0000000000000028: R_X86_64_TLSDESC_CALL scratch 2a: 64 48 03 04 25 00 00 00 00 addq %fs:0x0, %rax 33: 48 63 cf movslq %edi, %rcx 36: 48 8d 04 88 leaq (%rax,%rcx,4), %rax 3a: 59 popq %rcx 3b: c3 retq 3c: 0f 1f 40 00 nopl (%rax)
0000000000000040 <read_ext>: 40: 50 pushq %rax 41: 48 8d 05 00 00 00 00 leaq (%rip), %rax # 0x48 <read_ext+0x8> 0000000000000044: R_X86_64_GOTPC32_TLSDESC ext_var-0x4 48: ff 10 callq *(%rax) 0000000000000048: R_X86_64_TLSDESC_CALL ext_var 4a: 64 8b 00 movl %fs:(%rax), %eax 4d: 59 popq %rcx 4e: c3 retq$ ld.lld -shared desc.o -o libdesc.so$ readelf -rW libdesc.so | grep TLSDESC0000000000002518 0000000100000024 R_X86_64_TLSDESC 0000000000000000 ext_var + 000000000000024f8 0000000300000024 R_X86_64_TLSDESC 0000000000000000 counter + 00000000000002508 0000000500000024 R_X86_64_TLSDESC 0000000000000010 scratch + 0leaq 取描述符地址,call *(%rax) 调用描述符里的函数,返回的是偏移,所以下一条就是 %fs:(%rax)。每个变量只有一条 R_X86_64_TLSDESC 动态重定位,由 ld.so 填写描述符的两个字。
AArch64 上 GCC 和 clang 默认就用 TLSDESC:
$ clang --target=aarch64-unknown-linux-gnu -O1 -fPIC -c tls.c -o a64pic.o$ llvm-objdump -d -r a64pic.oa64pic.o: file format elf64-littleaarch64
Disassembly of section .text:
0000000000000000 <bump>: 0: a9bf7bfd stp x29, x30, [sp, #-0x10]! 4: 910003fd mov x29, sp 8: 90000000 adrp x0, 0x0 <bump> 0000000000000008: R_AARCH64_TLSDESC_ADR_PAGE21 counter c: f9400001 ldr x1, [x0] 000000000000000c: R_AARCH64_TLSDESC_LD64_LO12 counter 10: 91000000 add x0, x0, #0x0 0000000000000010: R_AARCH64_TLSDESC_ADD_LO12 counter 14: d63f0020 blr x1 0000000000000014: R_AARCH64_TLSDESC_CALL counter 18: d53bd049 mrs x9, TPIDR_EL0 1c: aa0003e8 mov x8, x0 20: b860692a ldr w10, [x9, x0] 24: 11000540 add w0, w10, #0x1 28: b8286920 str w0, [x9, x8] 2c: a8c17bfd ldp x29, x30, [sp], #0x10 30: d65f03c0 ret
0000000000000034 <scratch_at>: 34: a9bf7bfd stp x29, x30, [sp, #-0x10]! 38: 910003fd mov x29, sp 3c: 2a0003e8 mov w8, w0 40: 90000000 adrp x0, 0x0 <bump> 0000000000000040: R_AARCH64_TLSDESC_ADR_PAGE21 scratch 44: f9400001 ldr x1, [x0] 0000000000000044: R_AARCH64_TLSDESC_LD64_LO12 scratch 48: 91000000 add x0, x0, #0x0 0000000000000048: R_AARCH64_TLSDESC_ADD_LO12 scratch 4c: d63f0020 blr x1 000000000000004c: R_AARCH64_TLSDESC_CALL scratch 50: d53bd049 mrs x9, TPIDR_EL0 54: 8b000129 add x9, x9, x0 58: 8b28c920 add x0, x9, w8, sxtw #2 5c: a8c17bfd ldp x29, x30, [sp], #0x10 60: d65f03c0 ret
0000000000000064 <read_ext>: 64: a9bf7bfd stp x29, x30, [sp, #-0x10]! 68: 910003fd mov x29, sp 6c: 90000000 adrp x0, 0x0 <bump> 000000000000006c: R_AARCH64_TLSDESC_ADR_PAGE21 ext_var 70: f9400001 ldr x1, [x0] 0000000000000070: R_AARCH64_TLSDESC_LD64_LO12 ext_var 74: 91000000 add x0, x0, #0x0 0000000000000074: R_AARCH64_TLSDESC_ADD_LO12 ext_var 78: d63f0020 blr x1 0000000000000078: R_AARCH64_TLSDESC_CALL ext_var 7c: d53bd048 mrs x8, TPIDR_EL0 80: b8606900 ldr w0, [x8, x0] 84: a8c17bfd ldp x29, x30, [sp], #0x10 88: d65f03c0 retadrp + ldr + add 是第 4 章讲过的页寻址:算出描述符地址放进 x0,把描述符里的函数指针读进 x1;blr x1 调用它,返回的偏移在 x0;mrs 读线程指针,ldr w10, [x9, x0] 用"线程指针 + 偏移"取值。AArch64 ABI11 要求这四条指令严格按规定的形状生成,中间不能插别的指令,寄存器也必须一致,就是为了让链接器能认出整组并改写(AArch64 System V ABI)。
链接器同样可以把 TLSDESC 降到 IE 或 LE。把它链接进 PIE:
$ ld.lld -pie a64start.o a64pic.o a64ext.o -o a64exe$ llvm-objdump -d a64exea64exe: file format elf64-littleaarch64
Disassembly of section .text:
00000000000102dc <_start>: 102dc: d65f03c0 ret
00000000000102e0 <bump>: 102e0: a9bf7bfd stp x29, x30, [sp, #-0x10]! 102e4: 910003fd mov x29, sp 102e8: d2a00000 movz x0, #0x0, lsl #16 102ec: f2800200 movk x0, #0x10 102f0: d503201f nop 102f4: d503201f nop 102f8: d53bd049 mrs x9, TPIDR_EL0 102fc: aa0003e8 mov x8, x0 10300: b860692a ldr w10, [x9, x0] 10304: 11000540 add w0, w10, #0x1 10308: b8286920 str w0, [x9, x8] 1030c: a8c17bfd ldp x29, x30, [sp], #0x10 10310: d65f03c0 ret
0000000000010314 <scratch_at>: 10314: a9bf7bfd stp x29, x30, [sp, #-0x10]! 10318: 910003fd mov x29, sp 1031c: 2a0003e8 mov w8, w0 10320: d2a00000 movz x0, #0x0, lsl #16 10324: f2800300 movk x0, #0x18 10328: d503201f nop 1032c: d503201f nop 10330: d53bd049 mrs x9, TPIDR_EL0 10334: 8b000129 add x9, x9, x0 10338: 8b28c920 add x0, x9, w8, sxtw #2 1033c: a8c17bfd ldp x29, x30, [sp], #0x10 10340: d65f03c0 ret
0000000000010344 <read_ext>: 10344: a9bf7bfd stp x29, x30, [sp, #-0x10]! 10348: 910003fd mov x29, sp 1034c: d2a00000 movz x0, #0x0, lsl #16 10350: f2800280 movk x0, #0x14 10354: d503201f nop 10358: d503201f nop 1035c: d53bd048 mrs x8, TPIDR_EL0 10360: b8606900 ldr w0, [x8, x0] 10364: a8c17bfd ldp x29, x30, [sp], #0x10 10368: d65f03c0 ret四条定长 4 字节的指令换成另外四条:movz 和 movk 分两次把 32 位偏移装进 x0(高 16 位为 0,低 16 位为 0x10),剩下两个位置填 nop。readelf -r 同样显示没有重定位。偏移 +0x10 正是 Variant I 的样子:16 字节 TCB 之后就是可执行文件的块,counter 在块内偏移 0,所以相对线程指针是正的 16。和 x86-64 的 −0x410 对照,两种布局的差别在这一个数上就看得见。
"cannot allocate memory in static TLS block"
现在回到讲 -ftls-model 时留下的那个代价。
IE 访问把变量的位置表示为 TP 加一个固定偏移。该偏移必须对进程中的每个线程都有效,因此相应模块的 TLS 块必须进入静态 TLS 区域。启动时加载的模块可以在分配线程存储之前一起参与布局;运行中才加载的模块,则需要运行时为它保留的位置。
这个要求来自寻址方式:已有代码可能已经把线程指针或 TLS 变量地址保存在寄存器、栈或其他对象中,运行时不能任意移动各线程的实例。通用动态访问可以查表得到另行分配的块,IE 指令却没有这种查找或回退路径。因此晚加载 IE 是否成功,取决于运行时能否在所有线程里提供同一个 TP-relative 位置,而不是 ELF 规定了一个固定的字节上限。
DF_STATIC_TLS 表示模块使用了要求静态 TLS 的访问方式。x86-64 的 IE 共享库还通过 R_X86_64_TPOFF64 请求加载器填写 TP-relative 偏移。前面的 ie.o 可以用来查看这些信息怎样写入 ELF:
$ ld.lld -shared ie.o -o libie.so$ readelf -dW libie.so | grep FLAGS 0x000000000000001e (FLAGS) STATIC_TLS$ ld.bfd -shared ie.o -o libie_bfd.so$ readelf -dW libie_bfd.so | grep FLAGS 0x000000000000001e (FLAGS) STATIC_TLS它的 .rela.dyn 里是三条 R_X86_64_TPOFF64,每个变量一条。Drepper 的文档明确说,这样的模块不能被动态加载(§3.1:"remember, such modules cannot be loaded dynamically")。dlopen 发生时,进程里可能已经有几十个线程,每个线程的静态 TLS 区域都已分配好,就在各自的线程指针旁边,没法挪动也没法变大;而新库的 IE 代码要求自己的块离线程指针有一个固定距离,并且所有线程里这个距离都一样。
glibc 在进程启动时预留一部分静态 TLS 空间。必需的 IE 分配与可选优化要分开理解:IE 没有回退路径,空间不足就不能完成装载;TLSDESC 若能取得静态位置,可以使用返回固定偏移的快路径,否则仍可走动态解析。余量由多个装载请求共享,对齐也会消耗空间。
glibc 的可调参数手册说明了这种启动期预留,以及每个线程需要承担的内存成本。一个历史版本的预算计算放在实现附录;理解上述机制不需要记住它的默认数字。
必需的静态 TLS 分配失败时,glibc 的 dlopen 会报告 cannot allocate memory in static TLS block。诊断应围绕分配要求展开:先用 LD_DEBUG=files 找出正在加载的库,再检查 STATIC_TLS 标志、R_X86_64_TPOFF64 等要求固定 TP 偏移的动态重定位,以及 PT_TLS 描述的大小和对齐。仅缺少标志不足以排除问题,加载器还会处理具体重定位。
解决办法也来自这个机制:改用 GD 或 TLSDESC,使访问不再强制依赖静态位置;让库成为启动依赖,使它在初次布局时就被计入;或者减小 TLS 需求。增大 optional_static_tls 可以增加预留空间,但每个线程都要承担这份额外存储。能否满足某个库,要按实际布局判断,不能把某次探测到的容量当成接口保证。
几个边角
静态链接(-static)时,整个程序只有一个模块、一个 TLS 块,偏移全在链接时确定,因此具备将受支持的访问序列松弛为 LE 的条件(Drepper §3.3);是否改写还取决于具体重定位、指令形式和链接器实现。在 Linux 上用 musl 工具链的 gcc -static 链接同样的 pic.o,read_ext 里就是 leaq -0x40c(%rax), %rax,readelf -r 显示没有重定位。这时没有 ld.so,主线程的 TLS 块由 C 库的启动代码建立(glibc 里是 csu/libc-tls.c 的 __libc_setup_tls),之后的线程由线程库照模板分配。
C++ 的 thread_local 可以有构造函数和析构函数,而 Drepper 文档 §1 还写着"C++ 程序里的线程局部变量不能要求静态构造"。今天的做法是编译器为这样的变量生成一个 TLS wrapper 函数(名字以 _ZTW 开头,放在 COMDAT12 组里),每次访问先经过它:第一次访问时运行构造函数,并通过 __cxa_thread_atexit 登记线程退出时要调用的析构函数。对链接器来说,这些只是普通函数和普通符号,TLS 的部分还是本章讲的那些。
不是所有平台都用 ELF TLS。macOS 的 Mach-O 用一套叫 TLV(thread-local variables)的机制,访问时经过一个描述符调用;没有原生 TLS 支持的平台可以用 -femulated-tls,编译器把每次访问变成对 __emutls_get_address 的调用,底下正是本章开头那套 pthread 键,链接器无从优化。
从访问模型到实现验证
布局建立模板,GOT 保存需要运行时补足的参数,松弛利用链接时新增的信息简化指令。这三部分必须共同满足同一份线程布局约定。
以链接 musl 的 libc.a、输出静态可执行文件为例,可以先实现一条明确的路径:合并 .tdata 和 .tbss、生成 PT_TLS,用前文线程指针布局的公式算出每个符号的 TPOFF 填进 TPOFF32,并用示例核对;遇到 GOTTPOFF 就做 IE→LE 改写,把 movq 换成装立即数。第 4 章的 GOTPCRELX 在静态链接里也是同样的处境,GOT 项里要放的地址链接时已知,可以把 movq x@GOTPCREL(%rip) 改成 leaq x(%rip),那一个 GOT 项就不用建了。
验证至少覆盖两类程序。第一类是多线程 C 程序,_Thread_local 变量定义在另一个文件里,通过 extern 引用。对本例工具链的默认非 PIC 编译方式,同一文件内的定义通常直接使用 LE,产生 TPOFF32,无法检验 IE→LE;换成 extern 之后,用 musl 工具链编译,llvm-objdump -dr 里就是 R_X86_64_GOTTPOFF,ld.lld 静态链接后改写成 movq $-0x4, %rax。每个线程改自己的那一份,再故意让一次系统调用失败、读 errno。errno 检验的是另一件事。errno 也不是 ELF TLS 变量:__errno_location 只有 movq %fs:0, %rax 和 addq $0x34, %rax,取的是线程描述结构里的一个字段(src/errno/__errno_location.c,结构定义在 src/internal/pthread_impl.h)。这个结构和主线程的 TLS 块,是启动代码 __init_tls 从程序头里找到 PT_TLS、按它的大小和对齐一起分配的(src/env/__init_tls.c),PT_TLS 写错,errno 也会跟着错。
第二个是第 8 章留下的静态链接 C++ 异常。Linux 上从源码构建的 musl 目标 GCC 15.2 所提供的 libstdc++.a 里,eh_globals.o 的 __cxa_get_globals 用 LD 序列访问一个 16 字节的 __thread 变量,即 R_X86_64_TLSLD、call __tls_get_addr 和 R_X86_64_DTPOFF32,可见这个静态库是按 PIC 编译的。支持这份库的静态链接路径需要识别这组序列并将其改写为 LE,或提供满足其调用约定的其他实现。另有两处细节。这个变量所在的节叫 .tbss._ZZN12_GLOBAL__N_1L10get_globalEvE6global,要按 .tbss. 前缀并进输出的 .tbss。对 __tls_get_addr 的引用会从 libc.a 里拉进 __tls_get_addr.o,LD→LE 改写之后已经没有指令调用它,但用一个只含 LD 序列的小程序实测,BFD 和 ld.lld 都照样拉进了这个成员:静态链接的输出里有 __tls_get_addr,对它的 call 一条也没有。这反映了归档提取与指令松弛的先后关系:先因未定义引用提取成员,后消除调用,并不会自动撤销此前的提取。是否进一步删除相关代码,还取决于节 GC13 等机制;归档提取策略和最终代码存活是两件事。这两类程序的编译、静态链接与运行都在 Linux 上完成,再和 ld.lld 的产物比较段、符号偏移和改写后的指令字节;输入与命令沿用本节前面给出的形式。
从线程的实例到机器的启动
TLS 使链接器和运行时的分工更加具体。链接器写下模板及访问规则,运行时为每个线程分配实例、设好线程指针,指令才会访问正确的数据。仅仅把 ELF 文件的字节放进内存,并不会自动完成后面这些工作。
普通应用可以依靠内核、动态链接器和 C 库建立这些条件。操作系统内核启动时却不能调用另一个已经运行的自身来准备环境;它要接受固件或引导程序交来的机器状态,再执行自己的启动代码。在 QEMU14 中,模拟器也承担了一部分装载工作。链接地址、实际装入的位置和接到控制权时的地址必须与这条启动路径一致,链接器脚本因此成了程序与机器启动方式之间的具体约定。
练习
答案对应上述 x86-64 Linux 环境的实测。按前述命令在独立临时目录中执行,打印 GCC、binutils、glibc 版本,并完成线程运行、偏移计算、静态 TLS 余量探测与三种修复方法的验收。AArch64 的题目只做静态指令对照,明确不把它算作本机运行结果。
观察
-
下面的
rt.c让主线程和两个同时存活的线程各打印一次线程指针、一个栈上变量的地址、tag的地址,以及四个 TLS 变量相对线程指针的差值。#include <pthread.h>#include <stdio.h>#include <stdint.h>_Thread_local char tag[6] = "hello";_Thread_local long seq = 1;_Thread_local int hits;_Thread_local _Alignas(32) char slab[40];static char *tp(void) {#if defined(__x86_64__)char *p; __asm__("movq %%fs:0, %0" : "=r"(p)); return p;#elsereturn __builtin_thread_pointer(); /* 读 TPIDR_EL0 的内建函数 */#endif}static pthread_barrier_t bar;static void *show(void *name) {if (((char *)name)[0] == 't') pthread_barrier_wait(&bar);char *t = tp();int local;hits++;printf("%-4s tp=%p &local=%p &tag=%p tag%+ld seq%+ld hits%+ld slab%+ld hits=%d\n",(char *)name, (void *)t, (void *)&local, (void *)tag,(long)((intptr_t)tag - (intptr_t)t), (long)((intptr_t)&seq - (intptr_t)t),(long)((intptr_t)&hits - (intptr_t)t), (long)((intptr_t)slab - (intptr_t)t), hits);return 0;}int main(void) {pthread_t a, b;pthread_barrier_init(&bar, 0, 2);show("main");pthread_create(&a, 0, show, "t1");pthread_create(&b, 0, show, "t2");pthread_join(a, 0); pthread_join(b, 0);return 0;}在 x86-64 Linux 上用
gcc -O1 rt.c -o rt-x86 -pthread编译,再直接运行./rt-x86。先写下预测:三行的&tag是否相同,四个差值是否相同,每个线程都执行了hits++,打印出的hits各是几。再看tp和&local的距离,说说新线程的 TLS 块放在哪里,主线程的又在哪里。
手算与预测
-
把
rt.c里的四个变量和四个小函数单独放进q.c:char *tag_p(void) { return tag; }long get_seq(void) { return seq; }int get_hits(void){ return hits; }char *slab_p(void) { return slab; }用
clang -O1 -c q.c编译,和start.o一起ld.lld -pie链接成q-x86_64。readelf给出:TLS 0x000340 0x0000000000002340 0x0000000000002340 0x000010 0x000068 R 0x20[ 7] .tdata PROGBITS 0000000000002340 000340 000010 00 WAT 0 0 8[ 8] .tbss NOBITS 0000000000002360 000350 000048 00 WAT 0 0 325: 0000000000000000 6 TLS GLOBAL DEFAULT 7 tag7: 0000000000000008 8 TLS GLOBAL DEFAULT 7 seq9: 0000000000000020 4 TLS GLOBAL DEFAULT 8 hits11: 0000000000000040 40 TLS GLOBAL DEFAULT 8 slab(a) 列出变量清单,用 Variant II 的公式算出四个变量各自的
%fs:-N,再用llvm-objdump -d q-x86_64核对。(b).tdata只有 0x10 字节,hits的st_value为什么是 0x20 而不是 0x10?(c) 运行时保证线程指针本身按p_align对齐。如果把p_memsz0x68 直接当成块的大小,哪个变量会出问题? -
同一个
q.c换成--target=aarch64-unknown-linux-gnu,链接出的PT_TLS的大小和对齐与上题相同,四个st_value也相同。AArch64 是 Variant I,TCB 固定 16 字节,Drepper §3.4.1 给 IA-64 写的公式是tlsoffset_1 = round(16, align_1),AArch64 照用。预测tag_p和slab_p里add x0, x8, #imm的立即数,再反汇编核对。
改坏
-
共享库
big.c里只有一个强制 IE 模型的大数组,host.c在运行时dlopen它:/* big.c */__attribute__((tls_model("initial-exec"))) __thread char buf[N];char *buf_at(int i) { return &buf[i]; }/* host.c */#include <dlfcn.h>#include <stdio.h>int main(int argc, char **argv) {void *h = dlopen(argv[1], RTLD_NOW);if (!h) { printf("dlopen: %s\n", dlerror()); return 1; }char *(*at)(int) = (char *(*)(int))dlsym(h, "buf_at");printf("ok, buf at %p\n", (void *)at(0));return 0;}在 x86-64 Linux 上先
gcc -O1 host.c -o host -ldl,再用gcc -O1 -fPIC -shared -DN=... big.c -o libbigN.so编出不同大小的库,逐个交给./host。(a) 预测 N 到多大时dlopen开始失败,再找出确切的边界。(b) 用readelf -dW看库的FLAGS,再用readelf -rW查动态 TLS 重定位。这两个视图分别告诉我们什么,为什么排查不能只看其中一个?(c) 用三种办法让 N = 2048 的库能用。
写代码
本章示例用于核对 TLS 符号相对线程指针的偏移。
答案
练习一
$ ./rt-x86main tp=0x75a7da1897c0 &local=0x7ffe12995c54 &tag=0x75a7da189768 tag-88 seq-96 hits-24 slab-64 hits=1t2 tp=0x75a7d95fe6c0 &local=0x75a7d95fde04 &tag=0x75a7d95fe668 tag-88 seq-96 hits-24 slab-64 hits=1t1 tp=0x75a7d9dff6c0 &local=0x75a7d9dfee04 &tag=0x75a7d9dff668 tag-88 seq-96 hits-24 slab-64 hits=1t1 和 t2 的先后每次运行可能不同。三行的 &tag 各不相同,四个差值却完全一样:rt-x86 是 PIE,四个变量都定义在可执行文件里,编译器用的是 LE,差值在链接时就定了,写在指令里,所有线程共用。
三个 hits 都是 1。主线程先加过一次,新线程拿到的仍是按 PT_TLS 模板新建的一份,.tbss 部分清零,不继承父线程当时的值。
t1 的 tp 比 &local 高 0x8bc 字节,两者在同一块映射里:glibc 的 pthread_create 把新线程的线程描述结构和静态 TLS 放在这个线程自己的栈映射顶端(nptl/allocatestack.c)。主线程的栈是内核在 execve 时建的,在本次输出的 0x7ffe1299 一带;它的 TLS 块是 ld.so 启动时另外分配的,和栈不在一处。
练习二
(a)
p_memsz = 0x68p_align = 0x20tlsoffset_1 = round(0x68, 0x20) = 0x80 块占 [TP − 0x80, TP)tag st_value = 0x00 0x00 − 0x80 = −0x80seq st_value = 0x08 0x08 − 0x80 = −0x78hits st_value = 0x20 0x20 − 0x80 = −0x60slab st_value = 0x40 0x40 − 0x80 = −0x40$ llvm-objdump -d q-x86_64q-x86_64: file format elf64-x86-64
Disassembly of section .text:
00000000000012c0 <_start>: 12c0: c3 retq 12c1: cc int3 12c2: cc int3 12c3: cc int3 12c4: cc int3 12c5: cc int3 12c6: cc int3 12c7: cc int3 12c8: cc int3 12c9: cc int3 12ca: cc int3 12cb: cc int3 12cc: cc int3 12cd: cc int3 12ce: cc int3 12cf: cc int3
00000000000012d0 <tag_p>: 12d0: 64 48 8b 04 25 00 00 00 00 movq %fs:0x0, %rax 12d9: 48 8d 80 80 ff ff ff leaq -0x80(%rax), %rax 12e0: c3 retq 12e1: 66 66 66 66 66 66 2e 0f 1f 84 00 00 00 00 00 nopw %cs:(%rax,%rax)
00000000000012f0 <get_seq>: 12f0: 64 48 8b 04 25 88 ff ff ff movq %fs:-0x78, %rax 12f9: c3 retq 12fa: 66 0f 1f 44 00 00 nopw (%rax,%rax)
0000000000001300 <get_hits>: 1300: 64 8b 04 25 a0 ff ff ff movl %fs:-0x60, %eax 1308: c3 retq 1309: 0f 1f 80 00 00 00 00 nopl (%rax)
0000000000001310 <slab_p>: 1310: 64 48 8b 04 25 00 00 00 00 movq %fs:0x0, %rax 1319: 48 8d 80 c0 ff ff ff leaq -0x40(%rax), %rax 1320: c3 retq(b) 输出节 .tbss 的对齐取自其中最严格的输入,即 slab 的 32(节头最后一列)。.tdata 结束在块内 0x10,.tbss 只能从 round(0x10, 0x20) = 0x20 开始,节头里 .tbss 的地址 0x2360 也正好是 0x2340 + 0x20。
(c) 块顶如果放在 TP − 0x68,slab 就落在 TP − 0x28,不是 32 的倍数,_Alignas(32) 被破坏。向上取整到 0x80 多出的 0x18 字节,就是为对齐垫的空隙。
运行对照就是练习一的原生 rt-x86。GCC 15.2 把 slab 排在 hits 前面,seq 的块内偏移为 0、tag 为 8、slab 为 0x20、hits 为 0x48;p_memsz 为 0x4c,所以 round(0x4c, 0x20) = 0x60。实际运行的每个线程都打印 tag-88 seq-96 hits-24 slab-64,即 −0x58、−0x60、−0x18、−0x40,与从 ELF 独立计算的结果一致。
练习三
tlsoffset_1 = round(16, 0x20) = 0x20tag 0x20 + 0x00 = +0x20 seq 0x20 + 0x08 = +0x28hits 0x20 + 0x20 = +0x40 slab 0x20 + 0x40 = +0x60$ llvm-objdump -d q-aarch64q-aarch64: file format elf64-littleaarch64
Disassembly of section .text:
00000000000102b4 <_start>: 102b4: d65f03c0 ret
00000000000102b8 <tag_p>: 102b8: d53bd048 mrs x8, TPIDR_EL0 102bc: 91400108 add x8, x8, #0x0, lsl #12 // =0x0 102c0: 91008100 add x0, x8, #0x20 102c4: d65f03c0 ret
00000000000102c8 <get_seq>: 102c8: d53bd048 mrs x8, TPIDR_EL0 102cc: 91400108 add x8, x8, #0x0, lsl #12 // =0x0 102d0: 9100a108 add x8, x8, #0x28 102d4: f9400100 ldr x0, [x8] 102d8: d65f03c0 ret
00000000000102dc <get_hits>: 102dc: d53bd048 mrs x8, TPIDR_EL0 102e0: 91400108 add x8, x8, #0x0, lsl #12 // =0x0 102e4: 91010108 add x8, x8, #0x40 102e8: b9400100 ldr w0, [x8] 102ec: d65f03c0 ret
00000000000102f0 <slab_p>: 102f0: d53bd048 mrs x8, TPIDR_EL0 102f4: 91400108 add x8, x8, #0x0, lsl #12 // =0x0 102f8: 91018100 add x0, x8, #0x60 102fc: d65f03c0 ret容易写成 16 + st_value,得到 0x10 和 0x50。正文的 a64exe 里 p_align 是 4,不超过 16 时两种算法结果相同;这里 p_align 是 0x20,16 字节的 TCB 后面要再空 16 字节,块才能从 32 的倍数开始。两条 add 来自目标文件里的 R_AARCH64_TLSLE_ADD_TPREL_HI12 和 R_AARCH64_TLSLE_ADD_TPREL_LO12_NC:偏移拆成高 12 位(lsl #12)和低 12 位,这里偏移小于 4096,高位那条加的是 0。
这道题验证 AArch64 文件中的指令立即数与 ABI 公式一致;它没有启动 AArch64 程序。练习一是 x86-64 的 Variant II 运行结果,不能拿两种布局的正负偏移混作一次运行证据。
练习四
(a)
1024: ok, buf at 0x7e0661baf280 1664: ok, buf at 0x776979c67000 1665: dlopen: ./libbig1665.so: cannot allocate memory in static TLS block 2048: dlopen: ./libbig2048.so: cannot allocate memory in static TLS block在 glibc 2.43、默认 tunable、单库新进程的条件下,边界是 1664 字节;1665 开始失败。这个数字取决于加载顺序、运行库、对齐与配置,脚本用新进程逐步搜索,不能把它当作所有 Linux 的固定上限。
(b) GNU ld 2.46 生成的 x86-64 库有 FLAGS STATIC_TLS,动态重定位里还有一条针对 buf 的 R_X86_64_TPOFF64:
0x000000000000001e (FLAGS) STATIC_TLS0000000000003fd8 0000000600000012 R_X86_64_TPOFF64 0000000000000000 buf + 0标志说明库要求静态 TLS,重定位则给出哪个符号需要由加载器填写相对线程指针的偏移。诊断时要同时查看两者:不同目标后端的标志处理可能不同,但处理 IE 动态重定位时仍需要一个实际的静态 TLS 位置。找不到位置,加载器就无法填出该指令所需的固定偏移。
(c) 三种办法,实测都能加载:
- 去掉
tls_model属性重新编译。x86-64 GCC 默认 PIC 代码使用 GD 序列,允许动态分配 TLS;本例big_gd.c中 N = 4096 的库直接加载成功。 GLIBC_TUNABLES=glibc.rtld.optional_static_tls=1024 ./host ./libbig2048.so。余量变成 1664 − 512 + 1024 = 2176,实测 2176 能加载,2177 失败。- 让库在启动时加载。直接
gcc host.c ./libbig2048.so -o host_dep没用,readelf -d host_dep里没有它的NEEDED:Debian 的 gcc 默认给链接器传--as-needed(gcc -dumpspecs里是%{!fsanitize=*:--as-needed}),host.c不引用库里任何符号,它就被丢掉了。加上-Wl,--no-as-needed之后 N = 8192 也能用,启动时加载的模块的块在建静态区域时就算进去,不占余量。
ELF TLS 的设计来源
在 2000 年代初,编译器、链接器和运行时一起接手了这件事。最早的两份设计是 Intel 的 IA-64 处理器专用 ABI(2001 年 5 月)和 Sun 的一份 TLS 文档(0.68 版,2001 年 9 月,由 Mike Walker 撰写,描述 Sun 在 SPARC 和 IA-32 上的实现)。Drepper 在 2002 年 1 月 27 日写出第一版文档,把这两份整合成一份跨架构的规范;此后陆续并入 SH、Alpha、s390 等架构,x86-64 部分是 2002 年 10 月 21 日由 Jakub Jelínek 加入的;本文引用的是 2013 年 8 月的 0.21 版(见该文档首页与第 7 节修订记录)。这套机制叫 ELF TLS(Thread-Local Storage,线程局部存储)。程序员只要写 __thread int x;,剩下的全由工具链负责。
参考
实现示例:glibc 的静态 TLS 预留预算
glibc 2.36 的 _dl_tls_static_surplus_init 给出了一个具体的预留策略:每个线程的静态 TLS 区域带有额外余量(surplus),大小在进程启动时算定,之后不能再变(elf/dl-tls.c)。算法是 (nns − 1) × 144 + nns × 144 + optional_static_tls,再加一个凑数的常量:nns 是可调参数(tunable,ld.so 启动时从环境变量 GLIBC_TUNABLES 读入的运行时设置)glibc.rtld.nns,即支持的 dlmopen 命名空间个数,默认 4;两个 144 分别是为每个额外命名空间里 libc.so 自己的 IE TLS、以及其他运行时库(如 libgomp)的 IE TLS 预留的;glibc.rtld.optional_static_tls 默认 512。源码注释写明,这个常量的作用是让默认参数下的总量恰好等于历史值 1664 字节。
这 1664 字节里有两种用法。optional_static_tls 那 512 字节是留给"能放进静态区就放"的优化的,典型就是前文的 TLSDESC:放得进,描述符函数直接返回常数偏移;放不进,就退回动态分配,功能不受影响(glibc 手册:Dynamic Linking Tunables)。带 DF_STATIC_TLS 的库则是必需的分配,没有退路,elf/dl-reloc.c 里的 _dl_try_allocate_static_tls 对这种请求检查的是全部剩余余量,不受 512 字节的限制(elf/dl-reloc.c)。
附录:术语与工具
-
TLS — TLS(Thread-Local Storage)让不同线程拥有同一变量的独立实例。链接器描述初始化模板并处理寻址模型,运行时负责为线程建立实例。这里不是网络协议 Transport Layer Security。 官方文档。 ↩
-
GCC — GCC(GNU Compiler Collection)是一组语言编译器。命令
gcc是驱动入口,会组织编译、汇编和链接;在终端调用它,并不意味着后续工作都在同一个进程里完成。 官方文档。 ↩ -
ELF — ELF(Executable and Linkable Format)规定目标文件、可执行文件与共享对象的结构。通用规则见 gABI,架构相关的调用约定和重定位规则见对应 psABI。 官方文档。 ↩
-
PIE — PIE(position-independent executable)是可以在不同加载基址运行的可执行文件。生成 PIE 需要编译与链接选项配合;static-PIE 还需要自身的启动路径完成必要重定位。 官方文档。 ↩
-
RISC-V — RISC-V 是开放的指令集架构。本系列主线是在原生 x86-64 Linux 上构建链接器;RV64 用于架构对照与内核案例。相关例子的编码、寄存器约定和重定位规则见 RISC-V psABI,不能直接套用 x86-64 的规则。 ↩
-
musl — musl 是 Linux 的一种 C 标准库实现,提供
printf等库函数及运行时支持。本系列在需要分析或链接较小的静态运行库时使用它;普通 Linux 服务器不一定预装 musl。 官方文档。 ↩ -
GOT — GOT(Global Offset Table)保存供代码间接访问的地址或相关偏移。它让部分地址修补集中到数据表中;表项的具体用途由重定位类型与 ABI 决定。 官方文档。 ↩
-
PIC — PIC(position-independent code)使用适合位置变化的寻址方式。它常用于共享库;具体通过 PC 相对寻址还是表项间接访问,取决于架构与符号绑定。 官方文档。 ↩
-
PLT — PLT(Procedure Linkage Table)是一组函数调用跳板,常与 GOT 和动态符号绑定配合。PLT 存放指令,不能简单理解成另一张纯地址表。 官方文档。 ↩
-
psABI — psABI(processor-specific ABI)是特定处理器架构的二进制接口约定。不同架构可以共用 ELF 文件结构,同时拥有不同的指令、调用约定和重定位公式。 官方文档。 ↩
-
ABI — ABI(Application Binary Interface)规定二进制组件如何协作,包括调用约定、数据布局和文件格式等。它约束编译结果之间的交接,比源码层面的 API 更靠近机器。 官方文档。 ↩
-
COMDAT — COMDAT 让工具链表示可供择一保留的重复定义组。ELF 通过 section group 与签名表达相关关系;选择副本时,组内关联内容需要一致处理。 官方文档。 ↩
-
GC — 本文 GC 指 section garbage collection,即链接器从入口和其他根出发保留可达节、删除无用节。它发生在构建阶段,与运行时堆内存的垃圾回收不同。 官方文档。 ↩
-
QEMU — QEMU 可模拟处理器和系统。用户态模式运行另一架构的用户程序,系统模式则连同机器设备一起模拟;本系列 xv6 实验使用后者启动完整内核。 官方文档。 ↩